結合演算子と set 演算子を使用してデータを変換する
データ エンジニアリング ワークフローでは、多くの場合、複数のデータセットからの情報を組み合わせる必要があります。 結合では 、関連する列の行を照合してテーブルを水平方向に結合します。一方、 set 演算子 は行の追加、交差、または除外によってテーブルを垂直方向に結合します。 各アプローチを使用するタイミングを理解することは、効率的な変換パイプラインを構築するのに役立ちます。
このユニットでは、リレーションシップに基づいてテーブルを結合し、セット演算子を適用して、データセットと一致するスキーマを組み合わせる方法について説明します。
テーブルを結合してジョインを行う
関連する列に基づいて、2 つのテーブルの行を結合します。 結合の種類によって、結果に表示される行と、一致しない行の処理方法が決まります。
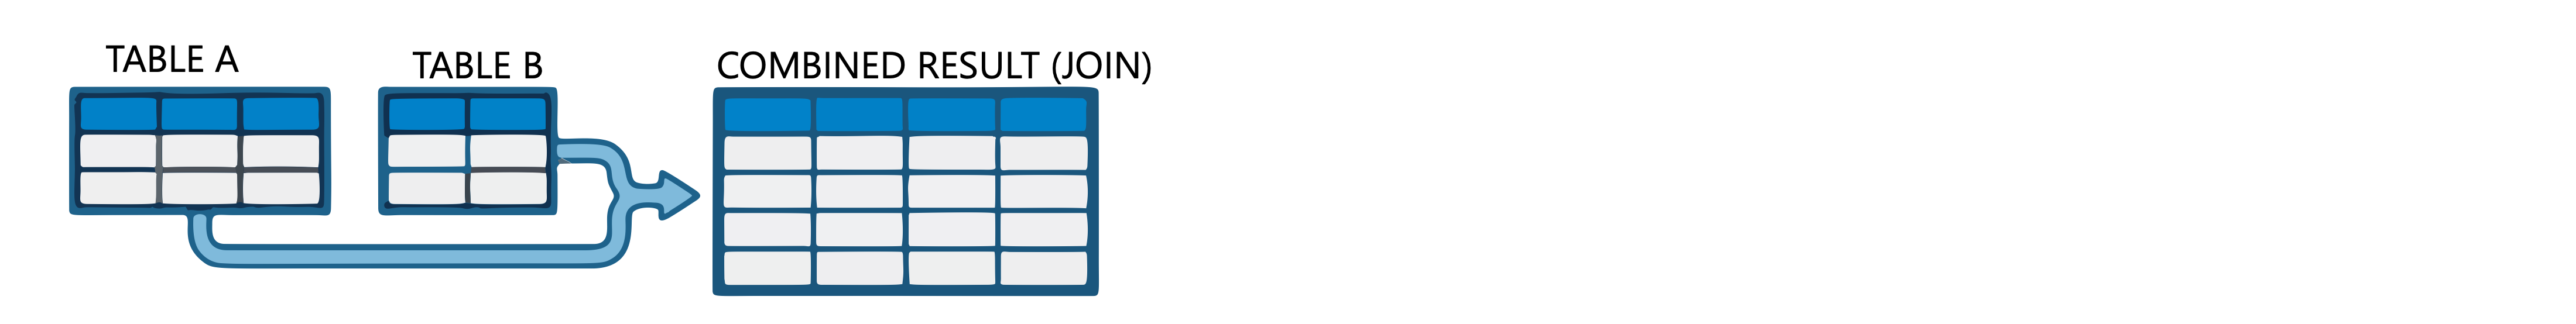
結合の種類について
各結合の種類は、データ変換で特定の目的を果たします。

| 結合タイプ | Description | 利用シーン |
|---|---|---|
INNER |
両方のテーブルから一致する行のみを返します | 有効な顧客と注文をリンクする |
LEFT |
左のすべてのテーブル行を返します。一致しない場合は、右のテーブルの NULL を追加します | 注文がなくても、すべての顧客を含める |
RIGHT |
すべての右のテーブル行を返します。一致しない場合に左のテーブルに NULL を追加する | 従業員がいなくても、すべての部門を含める |
FULL |
両方のテーブルからすべての行を返します。一致しない場合は NULL を追加します | データセットを結合して両側のギャップを見つける |
SEMI |
右側のテーブルと一致している左側のテーブルの行を返します。 | 注文した顧客をフィルター処理する |
ANTI |
右のテーブルに対応する行がない左のテーブルの行を返します。 | 注文を行ったことのない顧客を見つける |
CROSS |
すべての行のデカルト積を返します。 | 可能なすべての組み合わせを生成する |
SQL を使用してテーブルを結合する
JOIN句は、ONまたはUSINGで指定された条件に基づいてテーブルを結合します。 次の例では、従業員テーブルと部署テーブルを使用します。
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
従業員を部署と照合するには、内部結合を使用します。
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
内部結合では、部署テーブルに部署番号が存在する従業員の 3 つの行のみが返されます。 部署 4、5、6 の従業員は、部門テーブルに含まれていないため、表示されません。
部署の一致に関係なくすべての従業員を含める必要がある場合は、左結合を使用します。
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
これにより、6 人の従業員がすべて返されます。 部署が一致しない場合、 deptname 列に NULL が表示されます。
PySpark で DataFrames を結合する
PySpark の join() メソッドは、同じ機能を提供します。
how パラメーターは、結合の種類を指定します。
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
左結合、右結合、または完全外部結合の場合は、 how パラメーターを変更します。
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
結合列が両方の DataFrame で同じ名前である場合は、列名を文字列として渡します。 この方法では、結果の列が重複しないようにします。
半結合と反結合を使用してデータをフィルター処理する
半結合と反結合では、別のテーブル内の存在に基づいてデータがフィルター処理されます。 半結合では、右のテーブルの列を含めずに、一致する行が左のテーブルから返されます。
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
逆結合では、一致しない行が返されます。
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
PySpark で、 how="semi" または how="anti"を使用します。
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
セット演算子で行を組み合わせる
Set 演算子は垂直方向に機能し、クエリの行を同じ列構造で結合します。 結合とは異なり、セット演算子は条件に一致せず、結果セット全体をスタックまたは比較します。
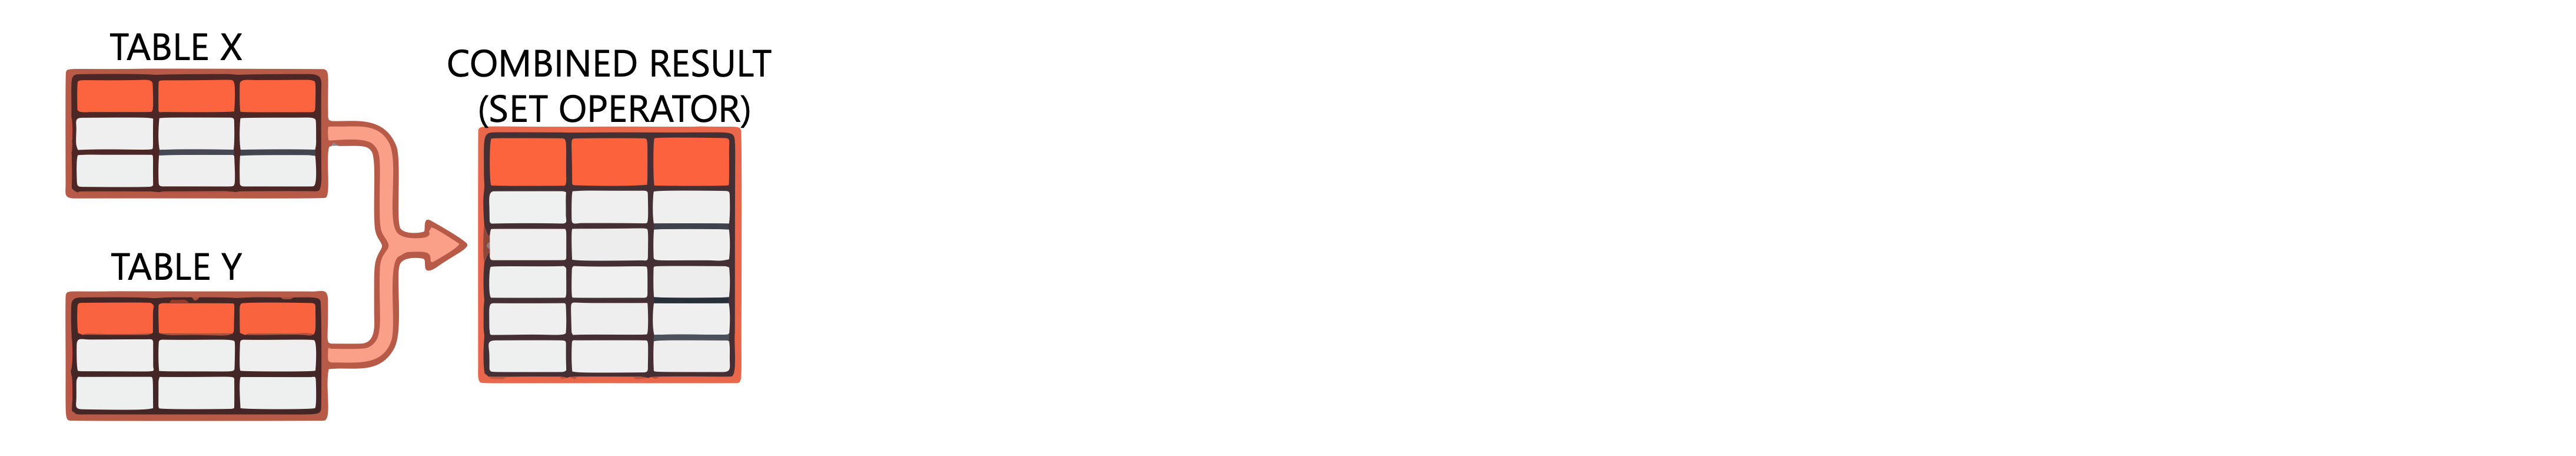
set 演算子を理解する
Azure Databricks では、次の 3 つのセット演算子がサポートされています。
| Operator | Description | 行動 |
|---|---|---|
UNION |
両方のクエリの行を結合します | 既定で重複を削除しますが、重複を保持するにはALLを使用します。 |
INTERSECT |
両方のクエリに存在する行を返します。 | 一致する行のみが表示されます |
EXCEPT |
第1のクエリから第2のクエリに存在しない行を返します。 | 既定で重複を削除します |
どちらのクエリも、互換性のあるデータ型を持つ同じ数の列を持つ必要があります。
データセットを UNION とマージする
UNION は、あるクエリから別のクエリに行を追加します。 既定では、重複が削除されます。
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
重複を含むすべての行を保持するには、 UNION ALLを使用します。
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
重複がないことがわかっている場合、または重複が意味を持つ場合は、 UNION ALL を使用します。 重複除去の手順をスキップするため、パフォーマンスが向上します。
PySpark では、DataFrame を組み合わせるための union() を使用します。 PySpark の union() は UNION ALLと同様に動作し、重複が保持されることに注意してください。
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
INTERSECT を使用して一般的な行を検索する
INTERSECT は、両方のクエリに表示される行のみを返します。 これは、重複するデータを識別するのに役立ちます。
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
このクエリは、データ品質チェックや調整が必要なレコードの識別に役立つ、何らかの方法で両方のテーブルに表示される顧客を識別します。
EXCEPT を含む行を除外する
EXCEPT は、2 番目のクエリに存在しない最初のクエリの行を返します。 これは、ギャップまたは一意のレコードを識別するのに役立ちます。
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
MINUSのシノニムとしてEXCEPTを使用することもできます。
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
UNIONと同様に、INTERSECTとEXCEPTの両方で重複が既定で削除されます。 必要に応じて重複を保持する ALL を追加します。
ヒント
セット操作をチェーンする場合、 INTERSECT は UNION と EXCEPTよりも優先順位が高いことを覚えておいてください。 評価順序を制御するには、括弧を使用します。
結合演算子と set 演算子のどちらかを選択する
結合演算子と set 演算子のどちらを選択するかは、変換の目標によって異なります。 結合は関連テーブルの列を水平方向に結合し、set 演算子は行を垂直方向に結合します。
必要がある場合は、次のように 結合 を使用します。
- 関連テーブルから列を追加してレコードを強化する
- キーリレーションシップに基づいてレコードを照合する
- 別のテーブル内の存在に基づいてデータをフィルター処理する (半結合/反結合)
次の操作を行う必要がある場合は 、set 演算子 を使用します。
- 同じスキーマを持つ複数のソースからレコードを追加する
- データセット間で共通レコードを検索する
- 1 つのデータセットに固有のレコードを識別する
どちらの方法も、効果的なデータ変換パイプラインの基盤となります。 次のユニットでは、変換されたデータを Unity カタログ内のターゲット テーブルに読み込む方法について説明します。