クラウド以前
- 17 分
クラウド コンピューティングの定義を完了したので、次は、クラウド コンピューティングが登場する前に、ビジネス コンピューティング、科学的コンピューティング、パーソナル コンピューティングなど、さまざまな分野でコンピューティングがどのように利用されたかについて例を見てみましょう。
ビジネス コンピューティング:ビジネス コンピューティングには、物流と運用を推進する管理情報システム、エンタープライズ リソース プランニング (ERP)、顧客関係管理 (CRM)、オフィスの生産性、ビジネス インテリジェンス (BI) がよく使用されます。 このようなツールにより、プロセスが合理化され、さまざまな企業で生産性が向上し、コストが削減されました。
たとえば、企業は CRM ソフトウェアを使用して、過去、現在、および将来の顧客に関するさまざまなデータを収集、保存、管理、および解釈することができます。 CRM ソフトウェアには、組織の顧客とのあらゆるやり取りについて、統合されたビュー (リアルタイムまたはほぼリアルタイム) が用意されています。 製造会社の場合、営業チームが CRM ソフトウェアを使用して、クライアントとの会議、タスク、およびフォローアップをスケジュールできます。 マーケティング チームは、特定のパターンに基づいたキャンペーンを使用して顧客をターゲットにすることができます。 請求チームは、見積もりと請求書を追跡できます。 そのため、この情報を格納するための一元的なリポジトリです。 この機能を有効にするために、組織および営業チームは、さまざまなデータベースと分析システムを使用して格納および分析する必要があるデータの収集に、さまざまなハードウェアおよびソフトウェア テクノロジを利用します。
科学的コンピューティング:科学的コンピューティングでは、コンピューターに実装されている数学モデルと分析手法を使用して、科学的な問題の解決を試みます。 一般的な例として、物理現象のコンピューター シミュレーションがあります。たとえば、気候モデルを使用した気象の予測です。 この分野によって、科学者やエンジニアは、さまざまな状況下でさまざまなシステムをシミュレートおよび研究するプログラムを開発して、既知のイベントの再構築や将来の状況の予測を実行できるようになったため、従来の理論上や実験室の実験方法は使用されなくなりました。 このようなシミュレーションには、通常、非常に多くの計算が必要であり、多くの場合、高価なスーパー コンピューターまたは分散コンピューティング プラットフォーム上で実行されます。
パーソナル コンピューティング:パーソナル コンピューティングでは、ユーザーが汎用パーソナル コンピューター (PC) 上でさまざまなアプリケーションを実行します。 このようなアプリケーションの例としては、ワード プロセッサやその他のオフィスの生産性向上ソフトウェア、メール クライアントなどの通信アプリ、ビデオ ゲームやメディア プレーヤーなどのエンターテインメント ソフトウェアなどがあります。 PC ユーザーは、通常、このようなタスクを実行するために利用されるソフトウェアとハードウェアを所有し、インストールし、保守します。
スケールへの対応
IT における長年の課題の 1 つは、需要に合わせてコンピューティング リソースをスケールすることです。たとえば、増加する顧客ベースのニーズを満たすために Web サイトの容量を増やす場合や、ピーク営業時間中の "バースト" 負荷や、多数の視聴者が集まる特別なイベントを処理する場合などです。
CRM でキャプチャ、監視、および分析する顧客とイベントの数を増やしたり、科学的コンピューティングの数値シミュレーションの精度やビデオ ゲーム アプリケーションのリアリズムを高めたりするなど、コンピューティングのスケールの拡大は継続的なプロセスです。 さらに、スケール拡大のニーズは、さまざまな分野でのテクノロジの採用の増加、ビジネスと市場の拡大、およびユーザー数とそのニーズの継続的な増加によって推進されています。 組織は、ソリューションの展開の計画と予算に応じて、スケールの拡大を考慮する必要があります。
組織は、通常、キャパシティ プランニングと呼ばれるプロセスで IT インフラストラクチャを計画します。 キャパシティ プランニング プロセスでは、さまざまな IT サービスの使用量の増加は、将来の拡張に備えたベンチマークとして評価され、使用されます。 組織は、より新しく優れたサーバー、ストレージ デバイス、およびネットワーク機器の調達、設定、保守を事前に計画する必要があります。 組織によっては、ソフトウェアによって制限される場合があります。これは、限られた数のライセンスを入手しており、より多数のユーザーに対応するためにインフラストラクチャの拡張が必要になることがあるためです。
スケールの最も基本的な形式は垂直スケーリングと呼ばれます。これにより、古いシステムは、より高速な CPU と、より多くのメモリとディスク容量を備えたより高パフォーマンスの新しいシステムに置き換えられます。 多くの場合、垂直スケーリングは、サーバーのアップグレードまたは交換と、ストレージ アレイへの容量の追加で構成されます。 このプロセスは計画と実行に何か月もかかることがあります。また、多くの場合、アップグレードがロールアウトされるときに短時間のダウンタイムが必要になります。
また、スケールは、システム専用のリソース数を増減することによって水平的に行うこともできます。 この例としては、高パフォーマンスのコンピューティング環境で、追加のサーバーとストレージ容量を既存のクラスターに追加して、1 秒あたりに実行できる計算の数を増やすことができる場合があります。 もう 1 つの例として Web ファーム (Web サイトと Web アプリケーションをホストするサーバーのクラスター) があります。この場合、増加したトラフィックに対応するために追加のサーバーをオンラインにすることができます。 垂直スケーリングと同様に、このプロセスは計画と実行に何か月もかかることがあります。また、ダウンタイムも考えられます。
企業は IT 機器を所有および保守していたので、スケールに対処するコストが上昇すると、企業はコストを削減する他の方法を特定しました。 大企業では、さまざまな部門のコンピューティング ニーズを 1 つの大規模なデータ センターに統合し、コストを削減するために不動産、電力、冷却、およびネットワークを統合しました。 一方、中小企業では、自社の IT 機器を共有データ センターに設置することによって、不動産、ネットワーク、電力、冷却、物理的なセキュリティをリースすることができました。 通常、これはコロケーション サービスと呼ばれ、社内で独自のデータ センターを構築したくない中小企業で採用されていました。 コロケーション サービスは、運用コストを削減するためのコスト効率に優れた方法として、さまざまな分野で継続的に採用されています。
ビジネス コンピューティングは、垂直スケーリングと水平スケーリングと、IT リソースのデータ センターへの統合とコロケーションによってスケールに対応しています。 科学的コンピューティングでは、問題の規模と数値シミュレーションの精度をスケールアップするために、並列および分散システムが採用されています。 並列処理の定義の 1 つは、大規模または高精度の計算を実行するために、1 つの大規模なコンピューターとして状態と機能を共有する複数の同種のコンピューターを使用することです。 分散コンピューティングは、大きな問題を同時に実行されるサブタスクに分割し、ネットワーク経由でメッセージを介して通信するために、ネットワークで接続された複数の自律コンピューティング システムを使用することです。 科学コミュニティでは、スケールに対処するために、これらの分野でイノベーションを続けています。 パーソナル コンピューティングでは、より豊富なコンテンツやメモリを大量に消費するアプリケーションによって需要が高まり、スケールが影響を受けています。 ユーザーは、PC を新しい高速なモデルに置き換えるか、既存のモデルをアップグレードして、このような需要に対応することができます。
インターネット サービスの増加
1990 年代後半には、このようなコンピューティング アプリケーションとプラットフォームのドメイン全体での採用が着実に増加しました。 すぐに、ソフトウェアは、単に機能するだけでなく、ビジネスと個人の要件に対して価値と分析情報を生み出す機能が期待されるようになりました。 こうしたアプリケーションの使用は連携するようになりました。情報を相互にフィードするために、アプリケーションは混合され、対応付けられました。 IT 部門はもはや単なる企業のコスト センターではなく、イノベーションと効率の源になりました。
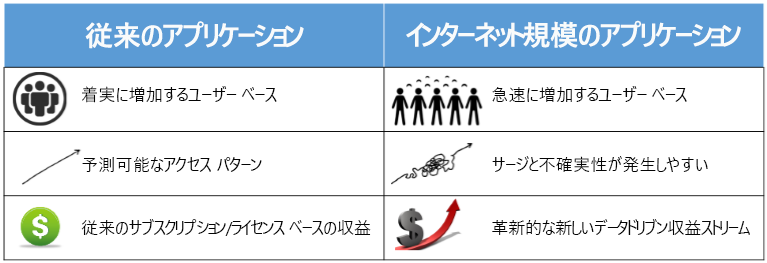
図 1.2:従来のコンピューティングとインターネットスケールのコンピューティングの比較。
21 世紀は、ワイヤレス通信、World Wide Web、およびインターネットのボリュームと容量の急増が際立っています。 これらの変化は、デジタル化された情報の生成、伝達、およびアクセスが簡易な、ネットワークおよびデータ主導の社会につながっています。 インターネットにより、40 億人を超えるユーザーの世界的な市場が作られました。 データと接続の増加は、ビジネスにとって重要です。 データは、実験の有効化、母集団の分割、自動化による意思決定のサポートなど、複数の方法で価値を生み出します1。 デジタル テクノロジを採用することにより、世界の上位 10 社の企業は、2015 年から 2020 年の間に生産高の増加が 1 兆ドルを超えると予想されました。
また、インターネットによって可能になった接続数の増加もその価値を高めてきました。 調査会社は、ネットワークの価値がユーザー数の関数として超線形的に変化すると仮定しています。 そのため、インターネット スケールでは、顧客の獲得と維持が優先事項です。これは、信頼性と応答性の高いサービスを構築し、観察されたデータ パターンに基づいて変更を加えることで実現します。
インターネットスケールのシステムの例としては、次のようなものがあります。
- 検索エンジン。大規模な (最大ペタバイトサイズの) データ セットをクロール、格納、インデックス作成、および検索します。 たとえば、Google は、数日に 1 回、Web トラフィックをクロールして分析し、それらのインデックスをキーワードに対応付ける巨大な Web インデックスとして始まりました。 現在では、ほぼリアルタイムでインデックスが更新されており、インターネット上の情報にアクセスするための最も一般的な方法の 1 つになっています。 インデックスには、数兆ものページが含まれ、そのサイズは数千テラバイト規模にもなります3。
- ソーシャル ネットワーク。ユーザーが個人および職業のリレーションシップを作成し、似た関心に基づいてコミュニティを構築することができる Facebook や LinkedIn などです。 たとえば Facebook では、1 か月あたり 20 億を超えるアクティブ ユーザーを擁するようになりました。
- Amazon のようなオンライン小売サービスでは、何百万もの製品の在庫を維持し、グローバルなユーザー ベースにサービスを提供しています。 2017 年、Amazon のオンライン小売事業は、前年より 31% 増の 1,780 億ドルの純売上高を達成しました。
- 多機能なストリーミング マルチメディア アプリケーションにより、人々がビデオやその他の形式のリッチ コンテンツを視聴したり共有したりできるようになります。 その一例として、YouTube では、1 日あたり 50 億本の動画を提供しており、毎分 300 分の動画がアップロードされています。
- Skype のような音声、ビデオ、テキスト チャット用のリアルタイム通信システムでは、1 か月あたり 500 億分以上の通話を行うことができます。
- 多くの同時実行ユーザーに何百万ものドキュメントを提供する生産性とコラボレーションのスイートにより、リアルタイムの永続的な更新が可能になります。 たとえば、Microsoft 365 では、毎月 6,000 万のアクティブ ユーザーにサービスを提供しています。
- SalesForce のようなプロバイダーによる CRM アプリケーションは、10 万を超える組織に展開されています。 大規模な CRM では現在、将来の成長を予測するために、最も大きなビジネスと収益予測を生み出す顧客を見つけるため、状態を追跡し、分析するための直感的なダッシュボードを提供しています。
- データ マイニングとビジネス インテリジェンスアプリケーションでは、(上記のような) 他のサービスの使用状況を分析して、非効率性や収益化の機会を見つけます。
当然ながら、これらのシステムには、大量の同時ユーザーに対応することが求められます。 これには、大量のネットワーク トラフィックを処理し、データを生成して安全に保存し、これらを目立った遅延なく行える容量を備えたインフラストラクチャが必要です。 これらのサービスは、一定で信頼性できる基準の品質を提供することによってその価値を引き出します。 また、これらを簡単に使用できるようにするモバイル デバイスと Web ブラウザー用の豊富なユーザー インターフェイスも用意されていますが、ビルドと保守は困難になります。
インターネット規模のシステムの要件をいくつか以下にまとめます。
- 普遍性 --- さまざまなデバイスから、いつでもどこからでもアクセスできるようにします。 たとえば、営業担当者は、クライアントへの訪問を短時間で高速かつ効果的なものにするため、タイムリーな更新をモバイル デバイスに提供することを CRM サービスに求めます。 サービスは、さまざまなネットワーク接続でスムーズに機能する必要があります。
- 高可用性 --- サービスは "常に稼働" している必要があります。アップタイムは、9 の数で評価します。 スリー ナイン (99.9%) は、サービスが 1 年間で 9 時間利用できなくなることを意味します。 高可用性サービスの一般的なしきい値は、ファイブ ナイン (1 年間で約 6 分) です。 オンライン小売アプリケーションでは、数分間のダウンタイムであっても、売上に数百万ドルの影響を及ぼす可能性があります。
- 待ち時間の短縮 --- 高速で応答性の高いアクセス時間。 ページ読み込み時間がわずかに遅くなるだけで、影響を受けた Web ページの使用量が大幅に減少することが示されています。 たとえば、検索の待ち時間が 100 ミリ秒から 400 ミリ秒に増えると、ユーザーあたりの検索回数が 0.8% から 0.6% に減少します。待ち時間が元のレベルに回復してもこの変化は持続します。
- スケーラビリティ --- 長期的および短期的にトラフィックにピークと谷を発生させる、季節性と口コミの影響によって変化する負荷に対応することができます。 "ブラック フライデー" や "サイバー マンデー" といった日には、Amazon や Walmart などの小売業者は、平均の数倍ものネットワーク トラフィックを受信します。
- コスト効率 --- インターネット規模のサービスには、従来のアプリケーションよりもはるかに多くのインフラストラクチャと、より優れた管理が必要です[4]。 コストを効率化する 1 つの方法は、サービスを管理しやすくし、サービスを処理する管理者の数を減らすことです。 より小規模なサービスでは、サービスに対する管理者の比率を (2:1 などのように) 低く抑えることができます (2:1 は、1 人の管理者が 2 つのサービスを管理する必要があることを意味します)。 しかし、Microsoft Bing のようなサービスが収益性を維持するには、サービスに対する管理者の比率を (たとえば 2500:1 のように) 高くする必要があります (2500:1 は、1 人の管理者が 2,500 のサービスを管理することを意味します)。
- 相互運用性 --- 多くの場合、これらのサービスの多くは組み合わされて使用されるため、再利用とデータのインポートとエクスポートのための標準化されたメカニズムをサポートするための簡単なインターフェイスを提供する必要があります。 たとえば、Uber などのサービスでは、自社製品に Google Maps を統合して、簡略化された場所とナビゲーション情報をユーザーに提供することができます。
ここでは、上記のさまざまな問題に対する初期の解決策をいくつか紹介します。 最初に取り組んだ課題は、ほとんどが米国に配置されていた初期の Web サービスの長いラウンド トリップ時間でした。 (サーバーとの距離があるために生じる) 待ち時間の短縮とサーバー障害の問題に対処するための最初期のメカニズムは、冗長性だけに依存していました。 これを実現するための 1 つの手法が、コンテンツの "ミラーリング" でした。これにより、人気のある Web ページのコピーが世界中のさまざまな場所に格納されました。 これにより、中央サーバーの負荷の量が最小限に抑えられ、エンド ユーザーで発生する待ち時間が短縮され、障害が発生した場合に、トラフィックを別のサーバーに切り替えることができました。 欠点は、データのコピーが 1 つでも変更された場合、不整合を処理する複雑さが増すことでした。 したがって、この手法は、静的な読み取り負荷の高いワークロード (画像、ビデオ、音楽の提供など) には有用です。 この手法が有効であることから、インターネット規模のほとんどのサービスでは、コンテンツ配信ネットワーク (CDN) を使用して、人気のあるコンテンを分散されたグローバル キャッシュに格納しています。 たとえば、Cable News Network (CNN) では、自社のビデオのレプリカを世界各地のさまざまな場所にある複数の "エッジ" サーバー上で、場所ごとにパーソナライズされた広告を使用して、管理しています。
もちろん、個々の企業が世界中で多数のサーバーを購入することが必ずしも合理的とは限りませんでした。 多くの場合、コスト効率を向上させるために共有ホスティング サービスが使用されました。 ここでは、単一の Web サーバーを共有して、複数のテナントにリースし、サーバーのメンテナンス コストを償却します。 共有ホスティング サービスによりリソース効率が高くなる可能性があります。これは、すべてのサービスが同時にピーク時の容量で稼働しないという前提でリソースがオーバー プロビジョニングされる可能性があるためです (オーバー プロビジョニングされた物理サーバーとは、すべてのテナントの合計容量が、サーバーの実際の容量を超えているサーバーです)。欠点は、テナントのサービスを近隣ノードから分離することはほとんど不可能だということでした。 したがって、1 つのオーバーロードされたサービスまたはエラーが発生しやすいサービスが、すべての近隣ノードに悪影響を及ぼす可能性があります。 テナントが悪意を持っている可能性があり、そのコロケーションの利点を利用して、データを盗んだり、他のユーザーへのサービスを拒否しようとしたりすることが原因で、別の問題が発生しました。
これに対処するために、共有ホスティング モデルのバリエーションとして仮想プライベート サーバーが開発されました。 テナントには、共有サーバー上で仮想マシン (VM) が提供されます。 これらの VM の多くは、静的に割り当てられ、1 つの物理マシンにリンクされていました。つまり、スケーリングは困難で、多くの場合、障害から手動で回復する必要がありました。 これらはオーバー プロビジョニングすることはできませんでしたが、併置されたサービス間でのパフォーマンスとセキュリティ分離は、簡単なリソース共有よりも向上しました。
パブリック リソースの共有に関するもう 1 つの問題は、サードパーティのインフラストラクチャにプライベート データを格納する必要があることでした。 上記で説明したインターネット規模のサービスの一部では、顧客の個人データが開示されることで多大な損害が生じる可能性があるため、データ ストレージの制御を失うわけにはいきませんでした。 そのため、これらの企業では、独自のグローバル インフラストラクチャを構築する必要がありました。 パブリック クラウドが登場する前は、このようなサービスを展開できたのは Google や Amazon などの大企業だけでした。 これらの各企業では、既製のコンポーネントを使用して大規模な同種データ センターを世界中に構築していました。データ センターは、1 つの大規模なウェアハウス規模のコンピューター (WSC) と考えることができます。 WSC により、所有権を維持したまま、アプリケーションとデータをグローバルに配布するための簡単な抽象化が提供されました。
規模の経済性により、データ センターの使用率を最適化してコストを削減することができました。 これは依然として、リソースをパブリックに共有する (クラウド) ほど効率的ではありませんでしたが、これらのウェアハウス規模のコンピューターには、インターネット規模のサービスを構築するための基礎として機能する多くの望ましいプロパティがありました。 コンピューティング アプリケーションの規模は、固定ユーザー ベースへのサービスの提供から、世界中の人々への動的なサービスの提供へと進化しました。 標準化された WSC により、このような大規模なユーザーにサービスを提供できるようになりました。 理想的なインフラストラクチャは、WSC のパフォーマンスと信頼性を共有ホスティング モデルと組み合わせることでした。 これにより、小規模な企業でも、大規模なデータ センター構築の多額なオーバーヘッドなしで、グローバルに競争力のあるアプリケーションを開発して立ち上げることができました。
リソースを共有するためのもう 1 つの方法が、複数の機関および地理的間で自律コンピューティング システムを共有できるようにする、グリッド コンピューティングでした。 複数の教育機関と科学機関が、共通の目標を達成するために共同作業を行い、自身のリソースをプールしていました。 その後、各教育機関は、明確に定義された共有ルールを通じて特定のセット リソースを割り当てることで、"仮想組織" に参加しました。 多くの場合、リソースは異種で疎結合であり、結合には複雑なプログラミング構成要素を必要としました。 グリッドは、非営利の研究および学術プロジェクトをサポートするために調整され、既存のオープン ソース テクノロジに依存していました。
クラウドは、上記のソリューションの多くの機能を組み合わせた論理的な後継でした。 たとえば、グリッドを使用してリソースのプールへのアクセスを提供および共有する大学の代わりに、クラウドでは、クラウド サービス プロバイダーによって一元的に管理されているコンピューティング インフラストラクチャをリースすることができます。 中央のプロバイダーがすべてのクライアントを満足させる大きなリソース プールを保持していたため、クラウドにより短時間で要求を動的にスケールアップおよびスケールダウンすることが容易になりました。 ただし、クラウド コンピューティングは、グリッドのようなオープン標準ではなく、専用プロトコルに依存しており、ユーザーは CSP にある程度の信頼を置く必要があります。
参照
- IBM (2017)。 「ビッグ データとは」https://www.ibm.com/analytics/hadoop/big-data-analytics
- Google Inc. (2015 年)。 「検索のしくみ」 https://www.google.com/insidesearch/howsearchworks/thestory/
- Hamilton, James R and others (2007)。 インターネット規模のサービスの設計と展開
自分の知識をチェックする
フィードバック
このページはお役に立ちましたか?
いいえ
このトピックについてサポートが必要ですか?
このトピックの意図を把握したり、理解を深めたりするために Ask Learn を使ってみませんか?