データ テーブルの形式を選択する
データ エンジニアは、すべてのデータ パイプラインの早い段階で重要な決定に直面します。データを格納する必要があるテーブル形式はどれですか? この選択は、クエリのパフォーマンス、トランザクションの信頼性、他のプラットフォームとの相互運用性、および Lakehouse アーキテクチャの長期的なメンテナンスに影響します。
Azure Databricks では複数のストレージ形式がサポートされており、それぞれ異なるシナリオ向けに設計されています。 それらの違いを理解することは、特定の要件に適した形式を選択するのに役立ちます。
ファイル形式とテーブル形式を理解する
オプションを比較する前に、ファイル形式とテーブル形式を区別することが重要です。 Parquet、CSV、JSON などの ファイル形式 は、データをディスクに物理的に格納する方法を定義します。 Delta Lake や Apache Iceberg などの テーブル形式 は、トランザクション、スキーマの変更、およびデータ ファイルの場所を追跡するメタデータ レイヤーを追加することで、ファイル形式の上に構築されます。
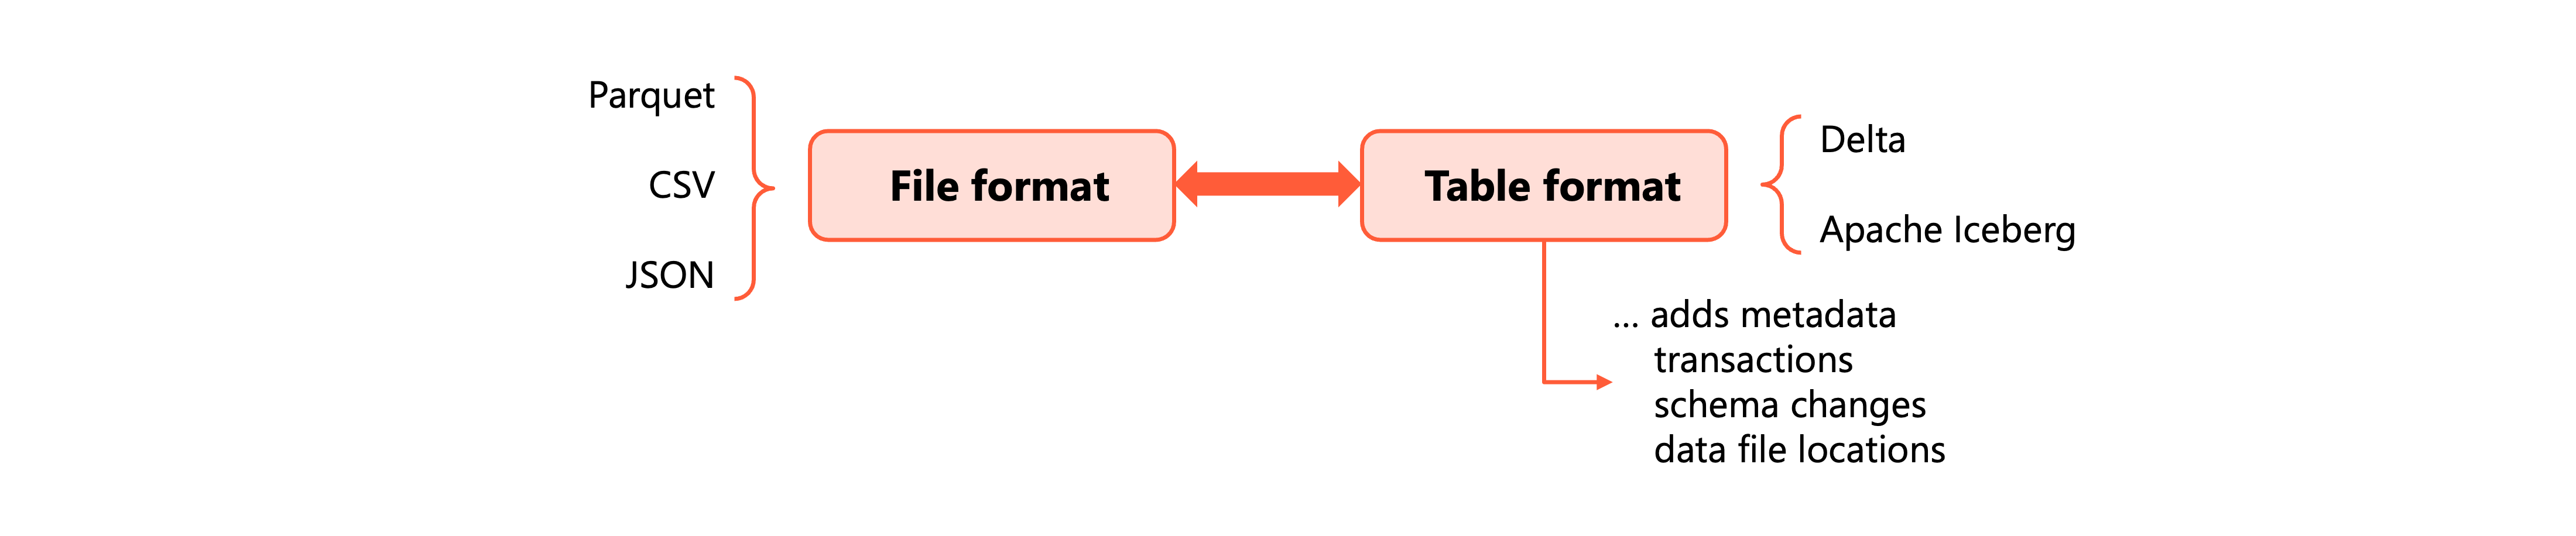
Delta Lake と Apache Iceberg はどちらも、基になるファイル形式として Parquet を使用します。 主な違いは、ACID トランザクション、タイム トラベル、スキーマの進化などの高度な機能を有効にするメタデータ レイヤーにあります。
Parquet によるデータの格納方法の違い
Parquet では、行ベースの ストレージではなく、列形式 のストレージが使用されます。 この根本的な違いは、分析クエリのパフォーマンスに大きく影響します。
CSV などの行ベースの形式では、データはレコードごとに整理されます。 1 つの列を読み取るには、ファイル内のすべての行をスキャンする必要があります。 Parquet などの列形式では、各列のデータが一緒に格納されます。 クエリに特定の列のみが必要な場合、Parquet はこれらの列のみを読み取り、残りは完全にスキップします。
Parquet では、データが 行グループに編成され、それぞれに 列チャンクが含まれています。 すべての列チャンクには、そのデータ セグメントの最小値と最大値を含む統計が格納されます。 フィルター条件を使用してクエリを実行すると、クエリ エンジンによって最初にこれらの統計がチェックされます。 フィルター値が行グループの最小/最大範囲の範囲外にある場合、エンジンはそのセクション全体の読み取りをスキップします。
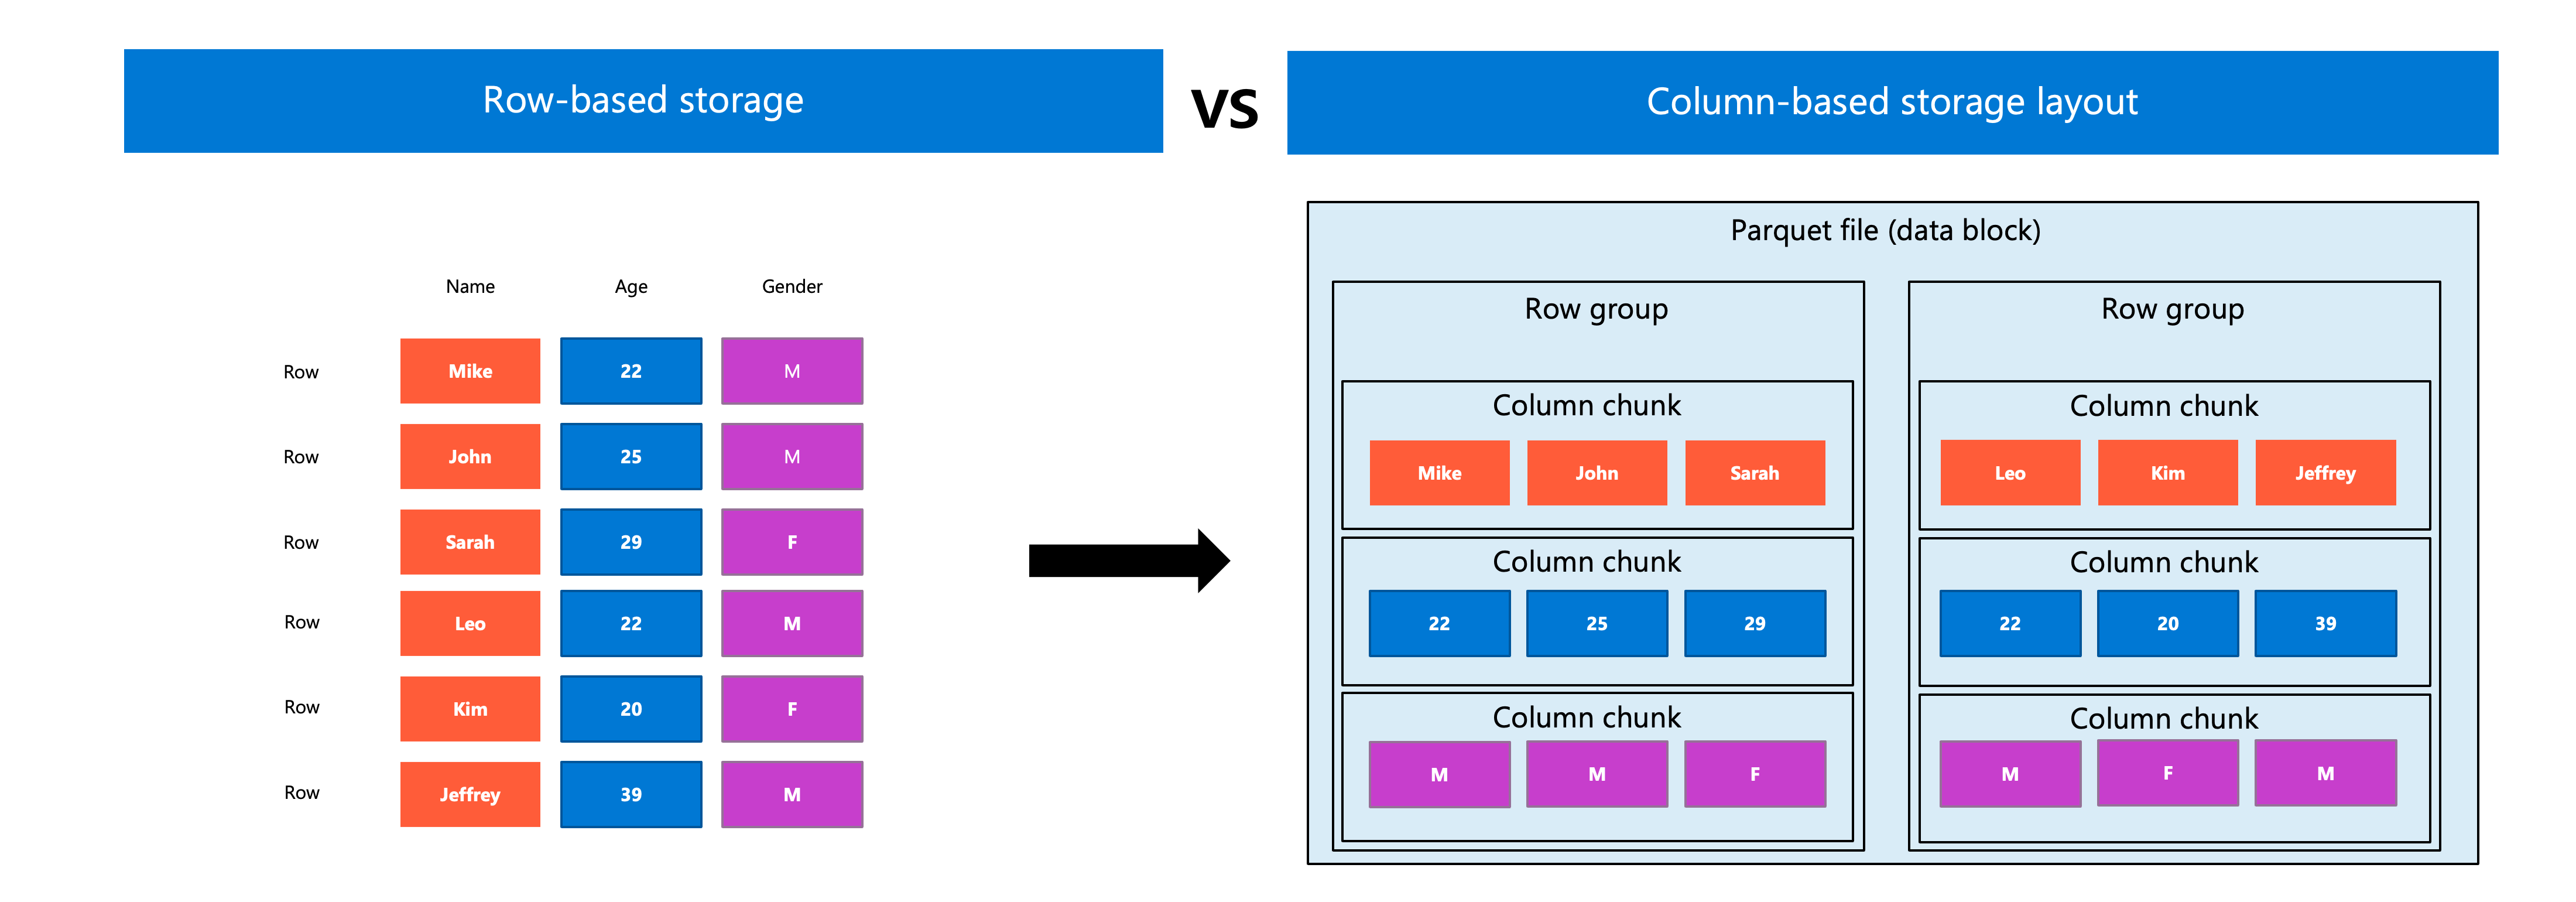
この列形式のアプローチでは、分析のパフォーマンスを大幅に向上させる 2 つの最適化手法が提供されます。
- 列の排除: エンジンはクエリが参照する列のみを読み取り、I/O を大幅に削減します。
- 述語プッシュダウン: フィルター条件は、まずデータを読み取る前に列統計に対して評価され、その結果、無関係な行グループが完全にスキップされます。
通常、多数の行の列のサブセットにアクセスする分析ワークロードの場合、Parquet は行ベースの形式を大幅に上回ります。
既定の形式としての Delta Lake
Delta Lake は、Azure Databricks のすべてのテーブルの既定のストレージ形式です。 形式を指定せずにテーブルを作成すると、Azure Databricks によって Delta Lake が自動的に使用されます。
Delta Lake は、テーブルに対するすべての変更を記録する トランザクション ログ で Parquet ファイルを拡張します。 このログにより、Parquet だけでは提供されないいくつかの機能が有効になります。
ACID トランザクション: 複数の同時リーダーとライターは、データが破損することなく同じテーブルにアクセスできます。 各トランザクションは完全に完了するか、全く影響を与えません。
タイム トラベル: タイムスタンプまたはバージョン番号を使用して、以前のバージョンのテーブルにクエリを実行します。 必要に応じて、変更をロールバックします。
スキーマの適用と進化: テーブルは、定義済みのスキーマに対して受信データを検証し、破損したデータや互換性のないデータが lakehouse に入らないようにします。 要件が変更された場合は、既存のデータを書き換えることなく、新しい列の追加、データ型の変更、列の名前の変更を行うことができます。
統合バッチとストリーミング: バッチ ソースとストリーミング ソースまたはシンクの両方と同じテーブルを使用します。
Delta Lake は、Azure Databricks プラットフォームと深く統合されています。 液体クラスタリングや予測最適化などの機能は、Unity カタログの Delta Lake テーブルとマネージド Apache Iceberg テーブルの両方で使用できます。 ただし、変更データ フィードは Delta Lake に固有であり、そのトランザクション ログに依存します。
Azure Databricks のほとんどのシナリオでは、Delta Lake が推奨される選択肢です。 運用データ システムに必要なトランザクション保証により、Parquet のパフォーマンス上の利点が得られます。
クロスプラットフォーム シナリオ用の Apache Iceberg
Apache Iceberg は、Azure Databricks がマネージド テーブルと外部テーブルに対してサポートする別のオープン テーブル形式です。 Delta Lake と同様に、Iceberg では、Parquet ファイル上に構築された ACID トランザクション、スキーマの進化、タイム トラベル機能が提供されます。
Iceberg の階層構造と明確に定義された論理構造により、柔軟性が高く、スケーラビリティと高度な最適化がサポートされます。 マニフェストのプルーニング、ファイルレベルの統計、隠しパーティション分割、パーティションの進化機能がサポートされています。
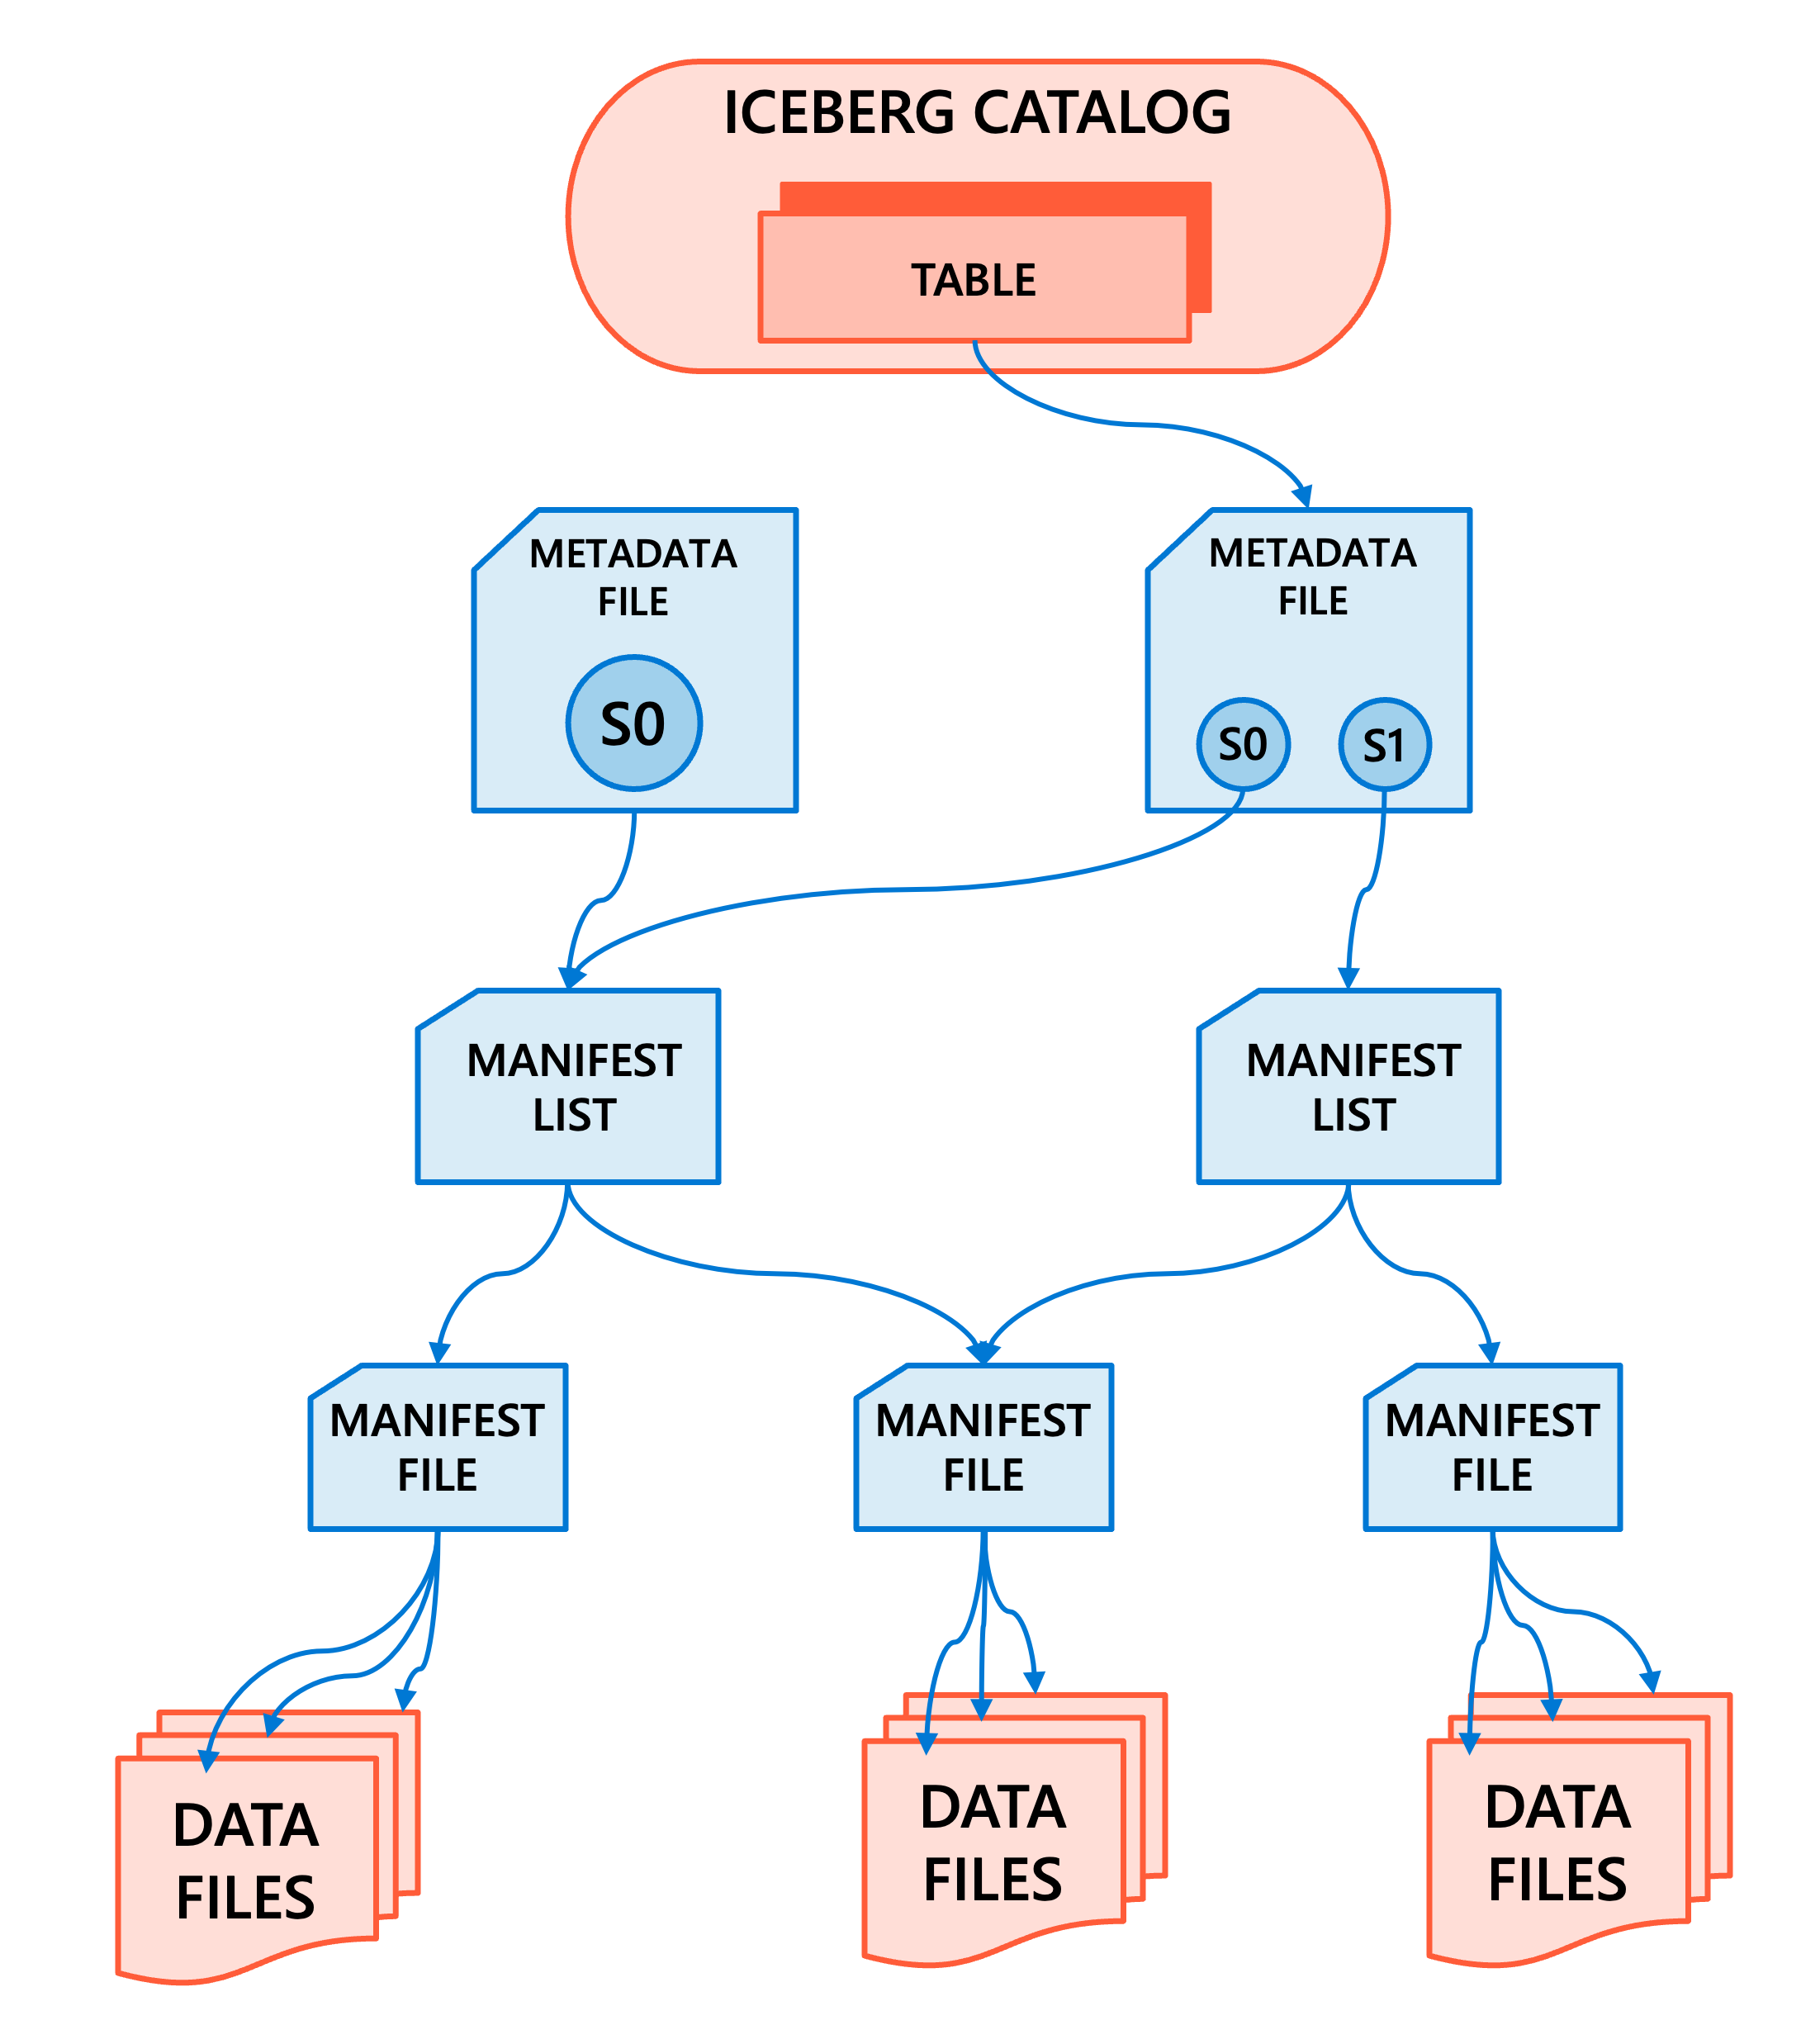
Iceberg を選択する主な理由は 相互運用性です。 Iceberg は、Snowflake、Amazon Athena、Trino、Apache Spark、Apache Flink などのプラットフォームなど、データ エコシステム全体で広く採用されています。 組織が同じテーブルの読み取りと書き込みを必要とする複数のプラットフォームでワークロードを実行している場合、Iceberg はすべてのプラットフォームが理解する共通の形式を提供します。
Unity Catalog では Iceberg テーブルを直接管理できるため、Azure Databricks は外部エンジン用の Iceberg カタログとして機能できます。 また、外部テーブル接続を使用して、AWS Glue や Snowflake Horizon Catalog などの他のカタログによって管理される Iceberg テーブルを読み取ることもできます。
次の場合に Iceberg を検討してください。
- データには、Azure Databricks の外部にある複数の処理エンジンからアクセスする必要があります。
- 組織は、クロスプラットフォームのデータ共有のために Iceberg を標準化しています。
- Delta Lake をサポートしていないシステムと統合している。
主に Azure Databricks 内で実行されるワークロードの場合、Delta Lake は、プラットフォームの統合と最適化の機能が深いため、推奨される形式のままです。
行ベースの形式が適用される場合
CSV と JSON は、大規模な分析では効率が低い場合でも、特定のシナリオに対して有効な選択肢のままです。
CSV または JSON は、次の場合に使用します。
- 初期ランディング ゾーンとして、これらの形式の外部システムからデータを受信しています。
- デバッグまたは迅速な検査には、人間が判読できるデータが必要です。
- テキストベースの形式のみをサポートするシステムと統合しています。
- データ ボリュームは十分に小さいので、パフォーマンスの違いはごくわずかです。
分析データを永続的に保存するには、インジェスト中に受信 CSV または JSON ファイルを Delta Lake テーブル に変換します。 この変換は、トランザクションの保証を追加しながら、列形式ストレージの効率向上をキャプチャします。
決定基準を適用する
テーブル形式の選択は、特定の要件によって異なります。 既定の選択肢として Delta Lake から始めて、特定の制約で必要な場合にのみ代替候補を評価します。
| 考慮事項 | Delta Lake | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| 分析のパフォーマンス | Excellent (非常に良い) | Excellent (非常に良い) | 貧しい |
| ACID トランザクション | イエス | イエス | いいえ |
| タイム トラベル | イエス | イエス | いいえ |
| Azure Databricks の統合 | ディープ | サポートされています | Basic |
| クロスプラットフォーム互換性 | Growing | Wide | ユニバーサル |
| 運用での推奨可否 | イエス | はい (相互運用が必要な場合) | いいえ (ランディング ゾーンのみ) |
選択も組織の標準によって異なります。 アーキテクチャ チームがテーブル形式の規則を確立している場合は、それらの決定に合わせて、データ プラットフォーム全体の一貫性を維持します。