SQL Server ベースのプラットフォームの選択肢を理解する
Microsoft の SQL プラットフォームはさまざまなシナリオに対応しており、設計するデータベース オブジェクトはプラットフォームの機能とユース ケースに合わせる必要があります。 サービスとしてのインフラストラクチャ (IaaS) とサービスとしてのプラットフォーム (PaaS) の間の制御と管理のトレードオフを理解することは、データベース設計要件を最も適切にサポートするプラットフォームを決定するのに役立ちます。
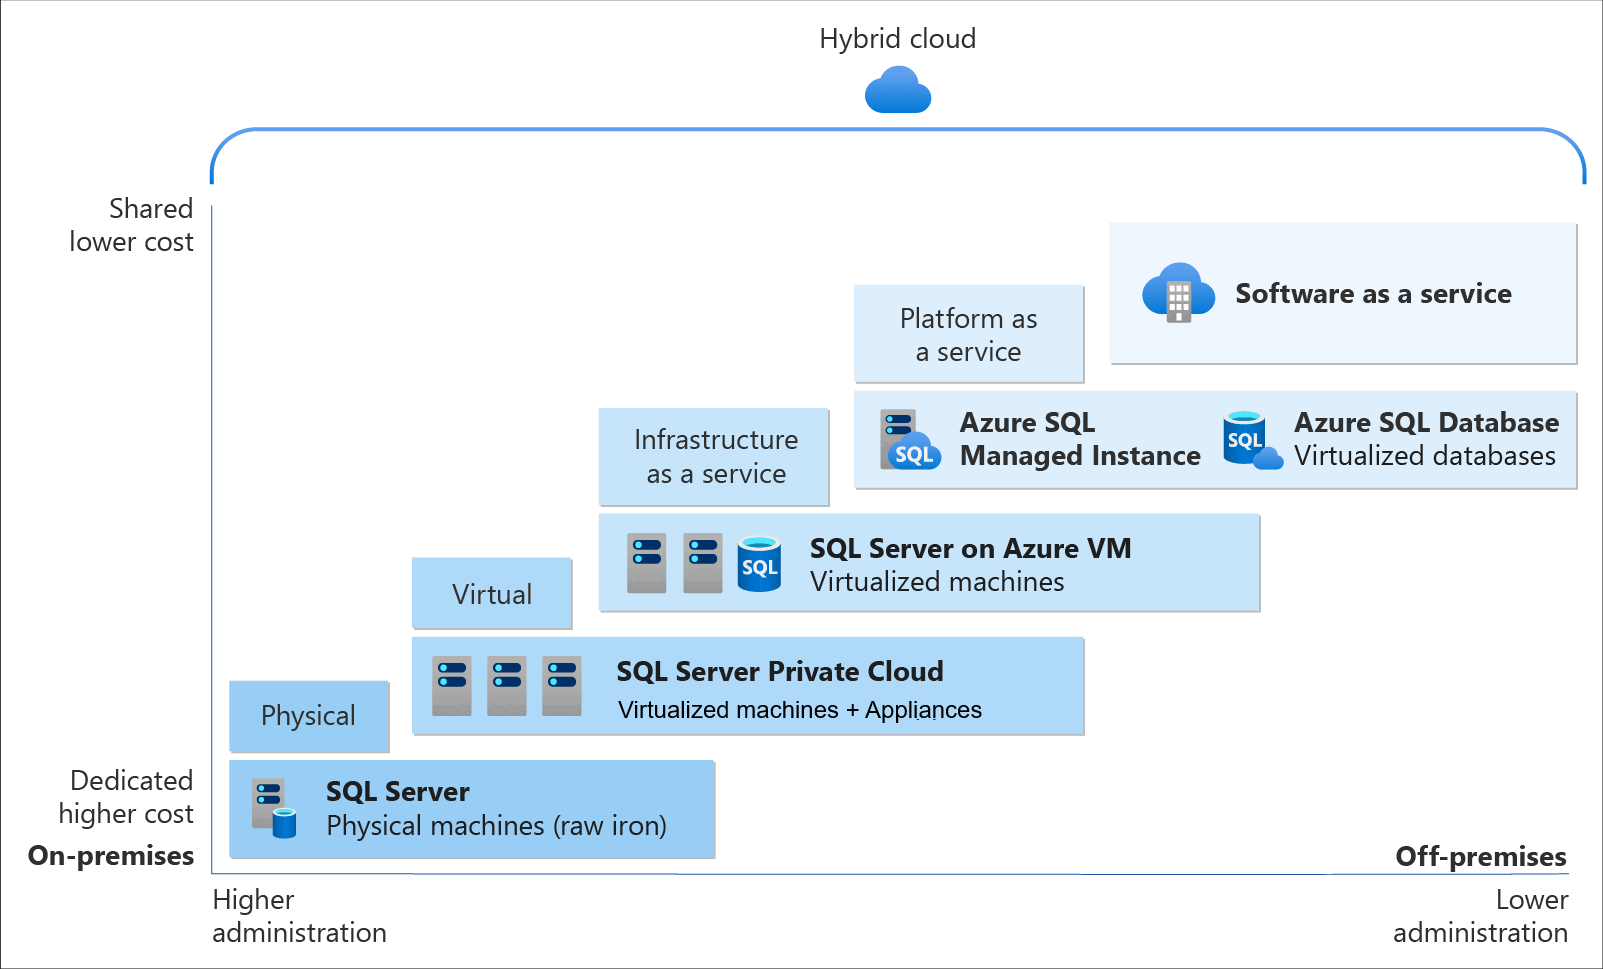
この図は、PaaS プラットフォームが責任を分割する方法を示しています。Azure では、データベース レイヤーの下にあるすべてのものを管理します。つまり、物理サーバー、ネットワーク、オペレーティング システムのパッチ、エンジンの更新など、アプリケーションにとって最も重要なもの (テーブル、インデックス、制約、データ) を制御します。 この分離により、インフラストラクチャのメンテナンスではなく、データベース設計に時間を費やすことができます。
Azure SQL Database を使用した開発
Azure SQL Database は、インフラストラクチャ管理なしでエンタープライズ レベルのパフォーマンスと可用性を提供する、フル マネージドの PaaS データベースです。 複数のサービス レベルが異なるワークロード パターンをサポートし、それぞれがデータ レイヤーの設計方法に影響を与える。
Hyperscale サービス レベルでは、従来、クラウド データベースに関連する実際的な制限の多くが排除されます。 単一ノードのリソースはほとんどのデータベースを制約しますが、Hyperscale データベースにはそのような制限はありません。 柔軟なストレージ アーキテクチャにより、ストレージは必要に応じて拡張され、定義済みの最大サイズはありません。 使用した容量に対してのみ課金されます。 読み取り負荷の高いワークロードの場合、Hyperscale では、読み取り操作を処理するためにレプリカを増やして迅速にスケールアウトできます。
サーバーレス コンピューティング レベルは、ワークロードの需要に基づいてコンピューティングを自動的にスケーリングし、アイドル状態の場合は一時停止します。非アクティブ期間中はストレージに対してのみ支払います。 接続要求が行われると、データベースは自動的に再開されます。
注
再開の遅延を処理し、自動一時停止を防ぐ実行時間の長いトランザクションを避けるために、接続再試行ロジックを使用してアプリケーションを設計することをお勧めします。
インテリジェントなクエリ処理 と 自動チューニング は、ワークロード パターンを分析して、インデックスを推奨または自動的に作成します。 プランの自動修正では、適切なインデックス作成と統計が設定されている場合に、クエリの回帰が検出され、修正されます。
99.99% アップタイム サービス レベル アグリーメント (SLA) を使用した組み込みの 高可用性 は、レプリケーション トポロジではなく、パフォーマンスとデータの整合性に集中できることを意味します。
Azure SQL Managed Instance の移行
Azure SQL Managed Instance では、最新の SQL Server Enterprise Edition と 100% の互換性が提供され、常に最新のデータベース エンジン バージョンと自動修正プログラムが適用されます。 ネイティブ 仮想ネットワーク統合 によりセキュリティが分離され、PaaS 機能はバックアップ、高可用性、メンテナンスを処理します。
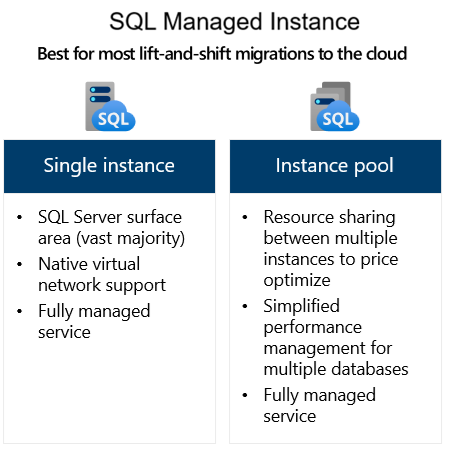
インスタンス レベルの機能には、SQL Server エージェント、Service Broker、リンク サーバー、3 部構成の名前付けによるデータベース間クエリ、およびデータベース メールが含まれます。 Managed Instance リンクでは、分散型可用性グループを使用して、ほぼリアルタイムで SQL Server から Azure にデータを同期します。ハイブリッド シナリオ、読み取りオフロード、ディザスター リカバリー、最小限のダウンタイムの移行が可能になります。
Business Critical レベルの In-Memory OLTP を使用すると、待機時間の影響を受けやすいワークロードに対して、メモリ最適化テーブルとネイティブ コンパイル ストアド プロシージャを使用できます。
Azure Virtual Machines で SQL Server を使用する
Azure Virtual Machines 上の SQL Server は、SQL Server インスタンス、データベース エンジンの構成、および基になる Windows または Linux オペレーティング システムを制御するサービスとしてのインフラストラクチャ (IaaS) デプロイを提供します。 この展開オプションは、特定の SQL Server バージョン、OS レベルのアクセス、または PaaS オファリングで使用できない構成を必要とするアプリケーションの最大互換性とカスタマイズを提供します。
SQL IaaS Agent 拡張機能を使用すると、自動バックアップ、メンテナンス期間中の自動修正、Azure Key Vault 統合、および Azure portal を使用した tempdb 構成などの管理機能のロックが解除されます。 SQL のベスト プラクティス評価では、推奨設定に照らして構成が検証されますが、I/O パフォーマンス分析はストレージのボトルネックを特定するのに役立ちます。 高可用性のために、レプリカの配置とフェールオーバーの動作を完全に制御して Always On 可用性グループ または フェールオーバー クラスター インスタンス を構成できます。
Microsoft Fabric での SQL Database の設計
Microsoft Fabric の SQL データベース は、Azure SQL Database テクノロジに基づいて構築された開発者向けのトランザクション データベースであり、Fabric の分析エコシステムと自動的に統合されます。 このプラットフォームでは、Azure SQL Database と同じ SQL Database エンジンを使用し、OLTP 機能と組み込みの分析統合を組み合わせ、運用データ ストアと分析データ ストアの従来の分離を排除します。
自動ミラーリング では、操作テーブルからの変更が Delta Parquet ファイルとして OneLake にレプリケートされます。 データの挿入、更新、削除を行うと、ETL パイプライン、トリガー、または追加の構成を必要とせずに、それらの変更が Fabric によって自動的に同期されます。 つまり、作成したすべてのテーブルは、データの読み取り専用分析ビューを提供する SQL 分析エンドポイントを介して分析にすぐに使用できるようになります。 使い慣れた 3 部構成の名前付け構文を使用して複数のデータ ソース間でクエリを実行し、SQL データベースを他の Fabric ウェアハウス、lakehouse、さらには他の SQL データベースと データベース間クエリで結合できます。 主な利点は、分析クエリは、ライブ操作テーブルではなく Delta Parquet コピーに対して実行されるため、大量のレポート ワークロードがトランザクション処理を遅くすることはありません。
インテリジェント なパフォーマンス機能は、クエリ パターンを監視し、手動で介入せずに インデックスを作成するインデックスの自動作成 など、バックグラウンドで自動的に動作します。 このプラットフォームでは、セマンティック検索と取得拡張生成 (RAG) を使用した AI 開発もサポートされています。 データベースの移植性は、.bacpac/.dacpac 操作用 の SqlPackage 、Git 統合用 の Fabric ソース管理 、および最新の API インターフェイス用 の GraphQL API を 通じてサポートされます。
このモジュールでは、プラットフォーム固有の機能の吹き出しを使用して、すべてのプラットフォームに適用できる手法について説明します。