ストリーム処理アーキテクチャの一般的な要素を調べる
ヒント
詳細については、「 テキストと画像 」タブを参照してください。
ストリーム処理ソリューションの実装に使用できるテクノロジは多数あり、具体的な実装の詳細は異なる場合がありますが、ほとんどのストリーミング アーキテクチャに共通する要素があります。
ストリーム処理の一般的なアーキテクチャ
ストリーム処理のアーキテクチャの概要を最も簡潔に表すと次のようになります。
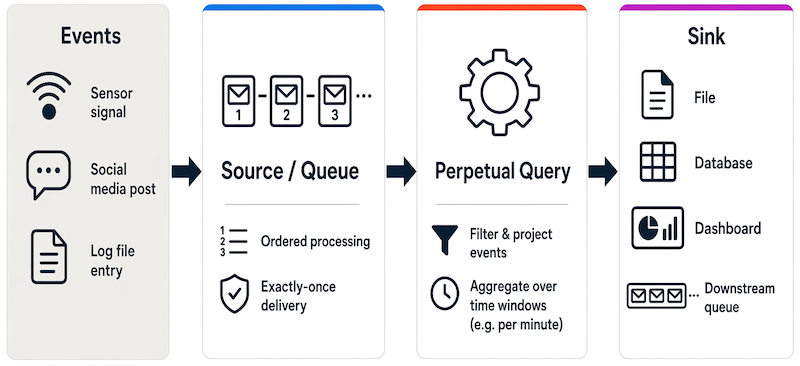
イベントによって何らかのデータが生成されます。 このようなものとしては、センサーによって出力された信号、投稿されたソーシャル メディア メッセージ、書き込まれたログ ファイル エントリ、何らかのデジタル データが発生するその他の出来事などがあります。
生成されたデータは、処理のためにストリーミング "ソース" にキャプチャされます。 単純なケースのソースは、クラウド データ ストア内のフォルダーやデータベース内のテーブルなどです。 より高度なストリーミング ソリューションでは、ソースは、イベント データが順番に処理され、各イベントが 1 回だけ処理されるようにロジックをカプセル化する キュー である可能性があります。
イベント データは、多くの場合、イベント データを操作する 永続的なクエリ によって処理され、特定の種類のイベント、プロジェクト データ値、または時間 (時間ベース) 期間 (または ウィンドウ) にわたってデータ値を集計するデータ値 (たとえば、1 分あたりのセンサーの放出数をカウントするなど) を選択します。
ストリーム処理操作の結果は、出力 ("シンク") に書き込まれます。出力先は、ファイル、データベース テーブル、リアルタイム ビジュアル ダッシュボード、または後続のダウンストリーム クエリでさらに処理するための別のキューなどです。
リアルタイム分析サービス
Microsoft は、ストリーミング データのリアルタイム分析を実装するために使用できる、以下のような複数のテクノロジをサポートしています。
Microsoft Fabric Real-Time インテリジェンス: Microsoft Fabricに組み込まれたリアルタイム データ用の統合されたツール セット。 これには 、Eventstreams (ストリーミング データの取り込み、ルーティング、変換)、 Eventhouse (時系列データとイベント データ用に最適化されたデータベース、KQL を使用してクエリを実行する Kusto クエリ言語、高速ログとテレメトリ分析用に設計されたクエリ言語)、 Real-Time ダッシュボード (ライブ データの視覚化用)、 アクティベーター (データのストリーミングが定義された条件を満たすときに自動アクションをトリガーする) が含まれます。 Fabric Real-Time インテリジェンスの AI 支援は、自然言語の質問から KQL クエリを生成するのに役立ちます。
Spark Structured Streaming: Azure DatabricksやMicrosoft Fabricなど、Apache Spark ベースのサービスで複雑なストリーミング ソリューションを開発できるオープンソース ライブラリです。
Azure Stream Analytics: ストリーミング ソースからデータを取り込み、継続クエリを適用し、その結果を出力先に書き込むストリーミング ジョブを定義するために使用できる Platform as a Service (PaaS) ソリューション。 Fabric以外のスタンドアロンまたはハイブリッド ストリーミング シナリオに使用できます。
ストリーム処理の "ソース"
Azure でのストリーム処理のためにデータを取り込むには、次のサービスが一般的に使用されます。
Azure Event Hubs: 大量のイベント データを取り込むのに使用できるデータ インジェスト サービス。 パーティション内のイベントは順番に配信され、Event Hubs では少なくとも 1 回の配信が保証されます。
Azure IoT Hub: Azure Event Hubs に似たデータ インジェスト サービスですが、 モノのインターネット (IoT) デバイスからのイベント データを管理するために最適化されています。
Azure Data Lake Storage Gen2: バッチ処理シナリオでよく使用されるスケーラブルなストレージ サービスですが、ストリーミング データのソースとしても使用できます。
Apache Kafka: Apache Spark と一緒に一般的に使用されるオープン ソースのデータ インジェスト ソリューション。
ストリーム処理の "シンク"
ストリーム処理からの出力は、多くの場合、次のサービスに送られます。
Azure Event Hubs: 処理されたデータをキューに入れ、さらにダウンストリーム処理するために使用します。
Azure Data Lake Storage Gen2、Microsoft OneLake、または Azure Blob Storage: 処理された結果をファイルとして保持するために使用されます。
Azure SQL Database、 Azure Databricks、または Microsoft Fabric: クエリと分析のために、処理された結果をテーブルに保持するために使用されます。
Microsoft Power BI: レポートとダッシュボードでリアルタイムのデータ視覚化を生成するために使用されます。