イメージ データの概要
- 10 分
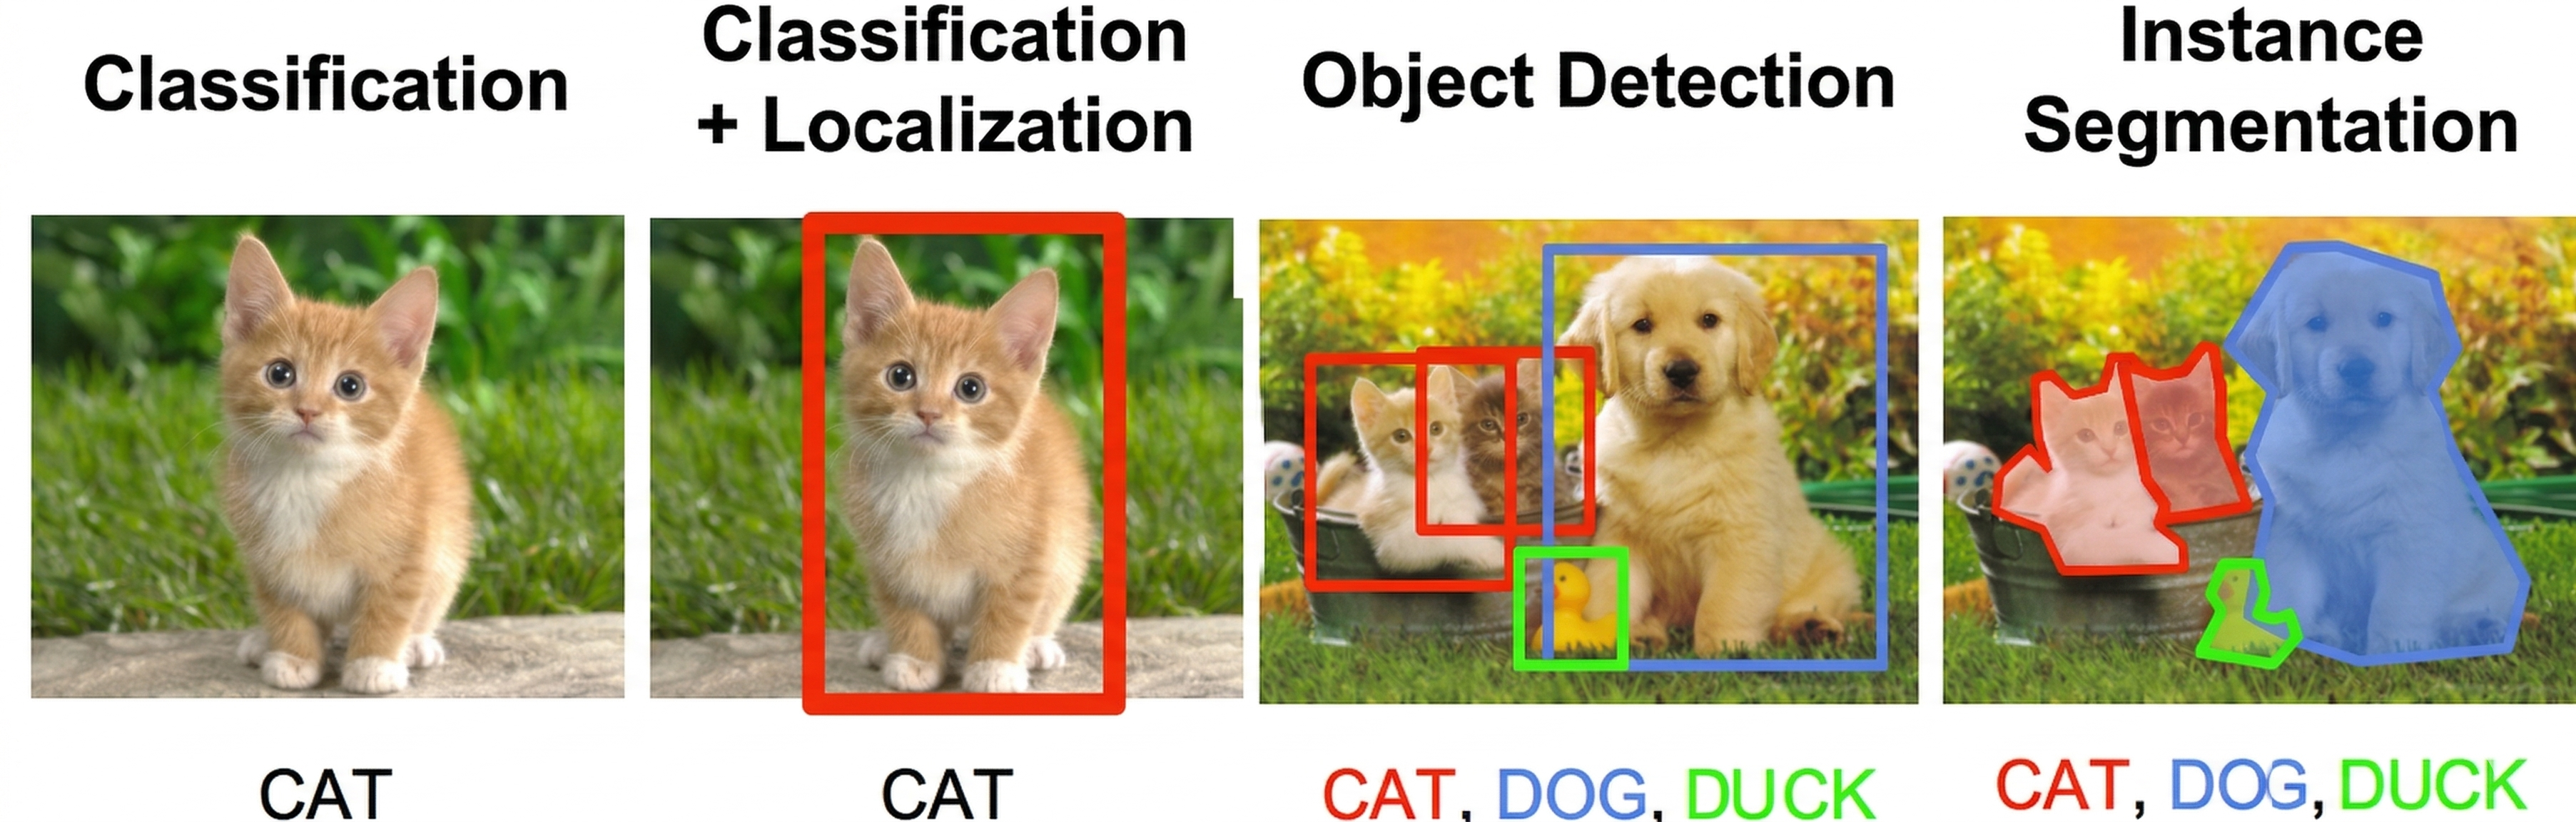
コンピューター ビジョンでは、通常、次のいずれかの問題を解決します。
- 画像分類 は、画像を多くの定義済みのカテゴリのいずれかに分類する必要がある場合に最も簡単なタスクです。たとえば、写真上で猫と犬を区別したり、手書きの数字を認識したりする必要があります。
- オブジェクト検出 はもう少し難しい作業です。ここでは、画像上の既知のオブジェクトを見つけてローカライズする必要があります。つまり、認識された各オブジェクトの 境界ボックスを 返す必要があります。
- セグメント化 はオブジェクト検出に似ていますが、境界ボックスを指定する代わりに、認識された各オブジェクトのアウトラインを示す正確なピクセル マップを返す必要があります。
テンソルとしての画像
Computer Vision は画像と連携します。 ご存知のように、画像はピクセルで構成されているため、ピクセルの長方形のコレクション (配列) と考えることができます。
このモジュールの最初の部分では、手書きの数字認識を扱います。 手書き数字のグレースケール 画像 (28 x 28 ピクセル) で構成される MNIST データセットを使用します。 各画像は 28 x 28 配列として表すことができます。この配列の要素は、対応するピクセルの強度を表します。0 ~ 1 の範囲 (この場合は浮動小数点数が使用されます)、または 0 から 255 (整数) のスケールで表されます。
numpyと呼ばれる一般的な Python ライブラリは、多次元配列を効果的に操作できるため、コンピューター ビジョン タスクでよく使用されます。
色の画像を処理するには、色を表す何らかの方法が必要です。 ほとんどの場合、各ピクセルは、赤 (R)、緑 (G)、青 (B) 成分に対応する 3 つの強度値で表されます。 このカラー エンコードは RGB と呼ばれ、サイズ W×H のカラー イメージはサイズ H×W×3 の配列として表されます (コンポーネントの順序が異なる場合もありますが、概念は同じです)。 配列表現では、幅 (列数) の前の高さ (行数) は、W×H の一般的なイメージ規則とは反対です。
多次元配列は テンソルとも呼ばれます。 テンソルを使用して画像を表す利点もあります。これは、追加のディメンションを使用して一連の画像を格納できるためです。 たとえば、800 x 600 ディメンション (幅×高さ) の 200 フレームで構成されるビデオ フラグメントを表すには、サイズ 200x600x800x3 のテンソルを使用できます。 テンソル ディメンションでは、イメージ エディターでよく見られる W×H 規則ではなく、H×W (行メジャー) の順序が使用されます。 ここでのフレーム×高さ (600) ×幅 (800) × チャネルの順序です。 この順序は channels_last と呼ばれ、TensorFlow では既定値です。他のフレームワークによっては、高さと幅 (channels_first) の前にチャネルを配置するものもあります。
import tensorflow as tf
import keras
import matplotlib.pyplot as plt
import numpy as np

# Prints the installed TensorFlow version
print(tf.__version__)
ここでは、 Keras フレームワークを実験に使用します。 このモジュール全体で、 import keras (スタンドアロン Keras 3 インポート スタイル) を使用します。 これには TensorFlow 2.16 以降 (または pip install keras>=3.0 経由でのスタンドアロン インストール) が必要です。 以前のバージョンの TensorFlow 2.x を使用している場合は、 import keras を from tensorflow import keras に置き換えます。
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()

# Output: (60000, 28, 28) (60000,)
print(x_train.shape, y_train.shape)
# Output: (10000, 28, 28) (10000,)
print(x_test.shape, y_test.shape)
数字データセットを視覚化する
データセットをダウンロードしたので、いくつかの数字を視覚化できます。
fig, ax = plt.subplots(1, 7)
for i in range(7):
    ax[i].imshow(x_train[i])
    ax[i].set_title(y_train[i])
    ax[i].axis('off')
# Displays a row of seven handwritten digit images with their labels
データセット構造
合計 60,000 個のトレーニング画像と 10,000 個のテスト 画像があり、各画像のサイズは 28×28 ピクセルです。
print('Training samples:', len(x_train))
print('Test samples:', len(x_test))
print('Tensor size:', x_train[0].shape)
print('First 10 digits are:', y_train[:10])
print('Type of data is ', type(x_train))
# Output:
# Training samples: 60000
# Test samples: 10000
# Tensor size: (28, 28)
# First 10 digits are: [5 0 4 1 9 2 1 3 1 4]
# Type of data is  <class 'numpy.ndarray'>
ご覧のように、データの型は配列 numpy 。 各ピクセルの強度は、0 ~ 255 の整数値で表されます。
print('Min intensity value: ', x_train.min())
print('Max intensity value: ', x_train.max())
# Output:
# Min intensity value:  0
# Max intensity value:  255
0 から 255 の間の理由は、各ピクセルが 8 ビット整数で表されるためです。 多くの場合、特にニューラル ネットワークを使用する場合は、すべての値を 255 で除算して [0, 1] の範囲にスケーリングする方が便利です。 このプロセスは 正規化と呼ばれます。
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
# Pixel values are now floating point numbers in the range [0, 1]
これでデータが完成し、最初のニューラル ネットワークのトレーニングを開始する準備ができました。
自分の知識をチェックする
フィードバック
このページはお役に立ちましたか?
いいえ
このトピックについてサポートが必要ですか?
このトピックの意図を把握したり、理解を深めたりするために Ask Learn を使ってみませんか?