畳み込みニューラルネットワーク
- 15 分
前のユニットでは、汎用の多層ニューラル ネットワークを定義する方法を学習しました。 このユニットでは、コンピューター ビジョン用に設計された 畳み込みニューラル ネットワーク (CNN) について説明します。
コンピューター ビジョンは一般的な分類とは異なります。画像内の特定のオブジェクトを検索しようとすると、画像をスキャンして特定の パターン とその組み合わせを探しているためです。 たとえば、猫を探すときは、最初にヒゲを形成できる水平線を探し、次に特定のひげの組み合わせが実際に猫の写真であることを示すことができます。 特定のパターンの位置と存在が重要です。 パターンを抽出するには、 畳み込みフィルターの概念を使用します。
ただし、まず、すべての依存関係を読み込み、使用するヘルパー関数を定義します。
import keras
import tensorflow as tf
import matplotlib.pyplot as plt
import numpy as np


def plot_convolution(data, t, title=''):
    t = tf.constant(t, dtype=tf.float32)
    t = tf.reshape(t, [*t.shape, 1, 1])
    fig, ax = plt.subplots(len(data), 2)
    fig.suptitle(title, fontsize=16)
    for i in range(len(data)):
        d = tf.reshape(tf.constant(data[i], dtype=tf.float32), [1, *data[i].shape, 1])
        ax[i][0].imshow(data[i])
        ax[i][1].imshow(tf.nn.conv2d(d, t, [1, 1, 1, 1], 'SAME')[0, ..., 0])


def plot_results(hist):
    plt.figure(figsize=(12, 4))
    plt.subplot(1, 2, 1)
    plt.plot(hist.history['accuracy'], label='Training acc')
    plt.plot(hist.history['val_accuracy'], label='Validation acc')
    plt.legend()
    plt.subplot(1, 2, 2)
    plt.plot(hist.history['loss'], label='Training loss')
    plt.plot(hist.history['val_loss'], label='Validation loss')
    plt.legend()


def display_dataset(dataset, labels=None, n=10, classes=None):
    fig, ax = plt.subplots(1, n)
    for i in range(n):
        ax[i].imshow(dataset[i])
        ax[i].axis('off')
        if labels is not None:
            # Handle both scalar labels (e.g. MNIST) and array labels (e.g. CIFAR-10)
            lbl = int(labels[i][0]) if np.ndim(labels[i]) > 0 else int(labels[i])
            ax[i].set_title(classes[lbl] if classes is not None else str(lbl))
次に、MNIST データセットを読み込みましょう。
(x_train, y_train), (x_test, y_test) = keras.datasets.mnist.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
畳み込みフィルター
畳み込みフィルターは、画像の各ピクセルに対して実行され、隣接するピクセルの加重平均を計算する小さなウィンドウです。 これらは重み係数の行列によって定義されます。 MNIST の手書き数字に対して 2 つの異なる畳み込みフィルターを適用する例を見てみましょう。
plot_convolution(x_train[:5], [[-1., 0., 1.], [-1., 0., 1.], [-1., 0., 1.]], 'Vertical edge filter')
plot_convolution(x_train[:5], [[-1., -1., -1.], [0., 0., 0.], [1., 1., 1.]], 'Horizontal edge filter')
# Expected output: Two sets of images showing original digits alongside the result of applying vertical and horizontal edge filters
最初のフィルターは 垂直エッジ フィルターと呼ばれ、$$ \left( \begin{matrix} -1 & 0 & 1 \ -1 & 0 & 1 \ -1 & 0 & 1 \ \end{matrix} \right) $$ によって定義されます。このフィルターがピクセルの比較的均一な領域をスライドすると、畳み込みによって生成される加重合計は 0 に近くなります。 正と負の重みが取り消されるためです。垂直エッジ (ピクセルの強度が左から右に急激に変化する) に遭遇すると、畳み込みによって大きな正または負の値が生成されます。 そのため、上の画像では、高い値と低い値で強調表示された垂直エッジが表示され、水平エッジはスムージングされます。
水平エッジ フィルターを適用すると、反対のことが起こります。水平線は増幅され、垂直線は平均化されます。
従来のコンピューター ビジョンでは、特徴を生成するために複数のフィルターが画像に適用され、その後、機械学習アルゴリズムによって分類子を構築するために使用されました。 ディープ ラーニングでは、分類の問題を単独で解決するための最適な畳み込みフィルターを 学習 するネットワークを構築します。
そのために畳み込み層を導入します。
畳み込み層
畳み込みレイヤーは、 Conv2D クラスを使用して定義されます。 次を指定する必要があります。
-
filters- 使用するフィルターの数。 9 つの異なるフィルターを使用します。このフィルターを使用すると、ネットワークで、シナリオに最適なフィルターを探索する機会が多数提供されます。 -
kernel_sizeはスライディング ウィンドウのサイズです。 通常、3 x 3 または 5 x 5 のフィルターが使用されます。
最も単純な CNN には、畳み込みレイヤーが 1 つだけ含まれています。 入力サイズが 28 x 28 の場合、9 個の 5 x 5 フィルターを適用すると、24 x 24 x 9 のテンソルが生成されます。 既定の padding='valid' はパディングが追加されていないことを意味し、サイズ 5 のスライディング ウィンドウが 28 ピクセル (28 - 5 + 1 = 24) 内に収まる位置が 24 個しかないため、空間ディメンションは小さくなります。
padding='same'を使用すると、入力の周囲にゼロパディングが追加されるため、空間的寸法が保持されます。
畳み込みの後、24×24×9 テンソルをサイズ 5184 の単一ベクトルにフラット化し、高密度レイヤーを追加して 10 個のクラスを生成します。
relu活性化関数は畳み込み層の後に適用され、非線形性が導入されます。
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=9, kernel_size=(5, 5), activation='relu'),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing a Conv2D layer, Flatten, and Dense(10) with ~52k parameters
このネットワークには、完全に接続された多層ネットワークでは約 80,000 個に対し、約 52k のトレーニング可能なパラメーター (畳み込み層では 234 個 + 高密度層では 51,850 個) が含まれていることがわかります。 畳み込みネットワークの一般化が優れているため、小さなデータセットで良好な結果を得ることができます。
注
ほとんどの実用的なケースでは、畳み込みレイヤーをカラー画像に適用したいと考えています。 したがって、 Conv2D レイヤーでは、入力が図形 $H\times W\times C$ である必要があります。ここで、$H$ と $W$ はイメージの高さと幅、$C$ はカラー チャネルの数です。 グレースケール イメージの場合、$C =1$ の同じ図形が必要です。
トレーニングを開始する前に、データの形状を変更する必要があります。
x_train_c = np.expand_dims(x_train, 3)
x_test_c = np.expand_dims(x_test, 3)
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
ご覧のように、前のユニットの完全に接続されたネットワークと比較して、エポックを少なくして、より高い精度を実現できます。 ただし、トレーニング自体にはより多くのリソースが必要であり、GPU 以外のコンピューターでは低速になる可能性があります。
畳み込みレイヤーの視覚化
また、トレーニング済みの畳み込みレイヤーの重みを視覚化して、何が起こっているかを理解することもできます。
fig, ax = plt.subplots(1, 9)
l = model.layers[0].weights[0]
for i in range(9):
    ax[i].imshow(l[..., 0, i])
    ax[i].axis('off')
# Expected output: 9 small images showing the learned 5x5 convolutional filter weights
これらのフィルターの一部は斜めのストロークを認識でき、他のフィルターはランダムに見えることがわかります。
多層 CNN とプール レイヤー
まず、畳み込みレイヤーは、水平線や垂直線などのプリミティブ パターンを探します。 さらに畳み込みレイヤーをその上に適用して、プリミティブシェイプなどの上位レベルのパターンを探すことができます。 その後、より多くの畳み込みレイヤーは、分類しようとしている最終的なオブジェクトまで、それらの図形を画像の一部に結合できます。
これを行うときは、画像の空間サイズを小さくする 1 つのトリックを適用することもできます。 スライディング 3x3 ウィンドウ内に水平ストロークがあることを検出した後、その正確なピクセル位置はそれほど気にする必要はありません。 したがって、イメージのサイズを "スケールダウン" できます。これは、 プール レイヤーのいずれかを使用して行われます。
- Average Pooling はスライディング ウィンドウ (2x2 ピクセルなど) を受け取り、ウィンドウ内の値の平均を計算します
- 最大プーリングは 、ウィンドウを最大値に置き換えます。 最大プーリングの背後にある考え方は、スライディング ウィンドウ内の特定のパターンの存在を検出することです。
したがって、一般的な CNN では、複数の畳み込みレイヤーがあり、その間にプール レイヤーが存在し、画像の寸法が小さくなります。 また、パターンが高度になるにつれて、検索する必要がある興味深い組み合わせが増えるため、フィルターの数も増えます。
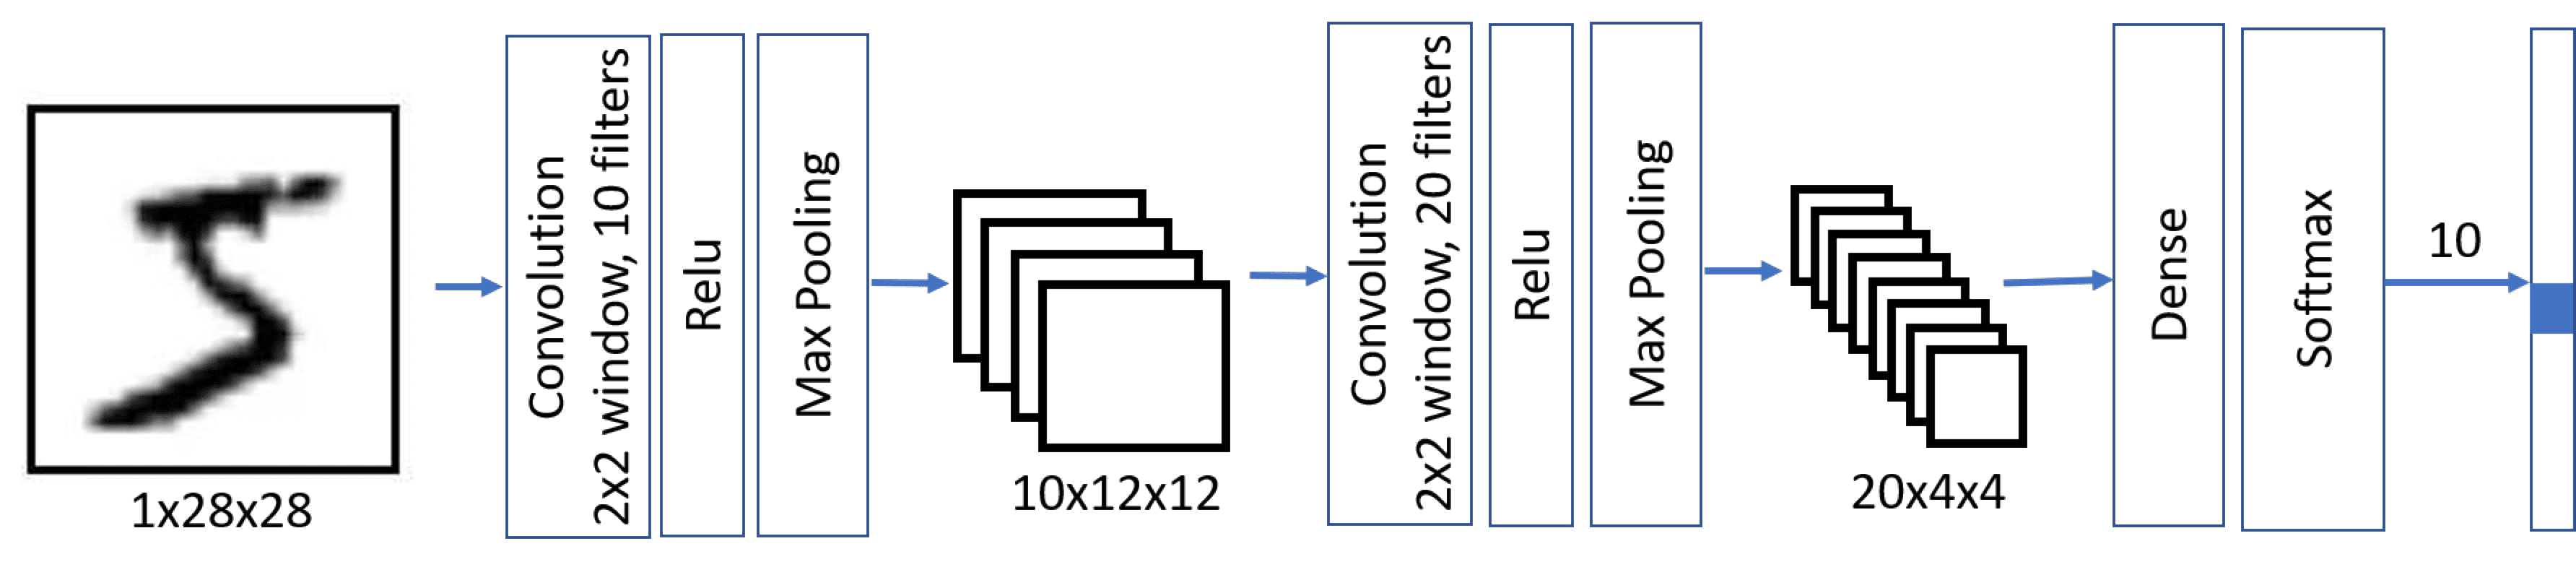
このアーキテクチャは、空間ディメンションが減少し、特徴/フィルターディメンションが増加するため、 ピラミッド アーキテクチャ とも呼ばれます。
model = keras.Sequential([
    keras.layers.Input(shape=(28, 28, 1)),
    keras.layers.Conv2D(filters=10, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Conv2D(filters=20, kernel_size=(5, 5), activation='relu'),
    keras.layers.MaxPooling2D(),
    keras.layers.Flatten(),
    keras.layers.Dense(10)
])

model.compile(loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])

model.summary()
# Expected output: Model summary showing Conv2D, MaxPooling, Conv2D, MaxPooling, Flatten, Dense with ~8.5k parameters
トレーニング可能なパラメーターの数 (約 8.5K) は、前のケースよりも大幅に小さいことに注意してください。 これは、一般に畳み込み層にはパラメーターが少なく、最終的な高密度レイヤーを適用する前の画像の次元が低下するためです。
hist = model.fit(x_train_c, y_train, validation_data=(x_test_c, y_test), epochs=3)
# Expected output: Training for 3 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 3 epochs
複数のレイヤーで高い精度を実現でき、必要なエポックの数が少ないことを確認します。 つまり、より高度なネットワーク アーキテクチャでは、何が起こっているかを把握し、画像から汎用パターンを抽出するために必要なデータが少なくなります。 ただし、各エポックでは、追加の畳み込み操作により、より多くの計算が必要になるため、GPU でのトレーニングが高速になります。
CIFAR-10 データセットから実際の画像を再生する
手書きの数字認識の問題はおもちゃの問題のように見えるかもしれませんが、より深刻な処理を行う準備ができました。 CIFAR-10 と呼ばれるさまざまなオブジェクトの画像のより高度なデータセットを調べてみましょう。 60k 32x32の画像が含まれています。10個のクラスに分かれています。
注
この時点から、CIFAR-10 データセットで x_train、 y_train、 x_test、 y_test を再読み込みし、このユニットで前に使用した MNIST データを置き換えます。 expanded-dims 変数の x_train_c と x_test_c は不要です。
(x_train, y_train), (x_test, y_test) = keras.datasets.cifar10.load_data()
x_train = x_train.astype(np.float32) / 255.0
x_test = x_test.astype(np.float32) / 255.0
classes = ('plane', 'car', 'bird', 'cat',
           'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
display_dataset(x_train, y_train, classes=classes)
# Expected output: A row of 10 CIFAR-10 images with their class labels
従来の CNN アーキテクチャは、元は手書きの数字認識のために Yann LeCun によって提案された LeNet です。 CIFAR-10 に合わせて調整しましょう。 上で説明したのと同じ原則に従います。主な違いは、1 ではなく 3 つの入力カラー チャネルです。
model = keras.Sequential([
    keras.layers.Input(shape=(32, 32, 3)),
    keras.layers.Conv2D(filters=6, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Conv2D(filters=16, kernel_size=5, strides=1, activation='relu'),
    keras.layers.MaxPooling2D(pool_size=2, strides=2),
    keras.layers.Flatten(),
    keras.layers.Dense(120, activation='relu'),
    keras.layers.Dense(84, activation='relu'),
    keras.layers.Dense(10)
])

model.summary()
# Expected output: Model summary showing the LeNet architecture with Conv2D, MaxPooling, Dense layers
このネットワークを適切にトレーニングするにはかなりの時間がかかり、GPU 対応コンピューティングで行う必要があります。
model.compile(optimizer='adam', loss=keras.losses.SparseCategoricalCrossentropy(from_logits=True), metrics=['accuracy'])
hist = model.fit(x_train, y_train, validation_data=(x_test, y_test), epochs=10)
# Expected output: Training for 10 epochs showing loss and accuracy for training and validation sets
plot_results(hist)
# Expected output: Plots showing training and validation accuracy and loss over 10 epochs
トレーニングのわずか数エポックで達成できた精度は問題ありません。 この問題は、MNIST 桁分類よりもかなり困難であることを覚えておいてください。 このような短いトレーニング時間で 60% 以上の精度を得ることは良い成果ですが、最新のモデルでは、より深いアーキテクチャ、データ拡張、より長いトレーニングを使用して CIFAR-10 で 95 以上の% を達成できます。
学んだこと
このユニットでは、コンピューター ビジョン ニューラル ネットワーク (畳み込みネットワーク) の背後にある主な概念について学習しました。 画像分類、物体検出、さらには画像生成ネットワークを強化する実際のアーキテクチャはすべて、より多くのレイヤーと追加のトレーニングテクニックを備えた CNN に基づいています。
自分の知識をチェックする
フィードバック
このページはお役に立ちましたか?
いいえ
このトピックについてサポートが必要ですか?
このトピックの意図を把握したり、理解を深めたりするために Ask Learn を使ってみませんか?