実行プランと DMV を使用してクエリのパフォーマンスを評価する
クエリの実行速度が予想よりも遅い場合、最初の手順は、データベース エンジンがクエリを実行 する方法 を理解することです。 実行プランには、オプティマイザーがクエリに対して選択した正確な演算子、データ アクセス方法、およびリソース コストが表示されます。 動的管理ビュー (DMV) は、データベース内のすべてのクエリにランタイム パフォーマンス データを公開することでこれを補完するため、単一のプランに進む前に最もコストの高いものを見つけることができます。
実行プランの読み取り
実行プランは、クエリ オプティマイザーがデータを取得して処理するために生成する一連の命令です。 最初にアクセスするテーブル、インデックスを使用するか、テーブルをスキャンするか、結果を結合、フィルター処理、並べ替え、集計する方法を定義します。 オプティマイザーは複数の候補プランを評価し、見積もりコストが最も低いプランを選択します。
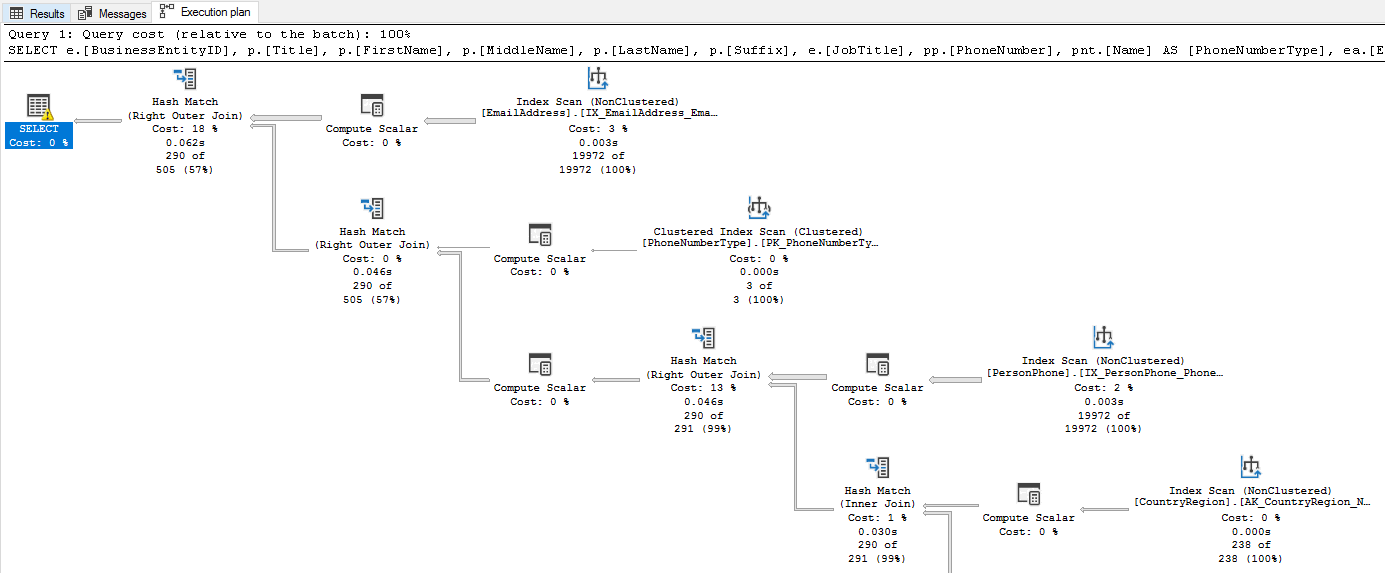
実行プランには、次の 2 種類があります。
- 推定実行プラン: クエリを実行せずに生成されます。 統計に基づいて、計画された演算子と推定行数が表示されます。 データベースに影響を与えずに、見積もり計画を使用して迅速な分析を行います。
- 実際の実行プラン: クエリの実行中にキャプチャされます。 これには、推定プランと実際の行数、実際の実行時間、メモリ許可、警告が含まれます。 実際の計画では、オプティマイザーが期待していたものと実際に何が起こったかの間の不一致が明らかになります。
推定プランを表示するには、クエリの前 SET SHOWPLAN_XML ON 実行するか、SQL Server Management Studio (SSMS) で [推定実行プランの表示 ] を選択します。 実際のプランをキャプチャするには、 SET STATISTICS XML ON 実行するか、クエリを実行する前に SSMS で [実際の実行プランを含める ] を選択します。
推定プランと実際のプランは似ていますが、実際のプランのランタイム メトリックは、パフォーマンスの問題を診断するために非常に重要です。 たとえば、テーブル スキャンの推定行数が 100 で、実際の行数が 10,000 の場合、古い統計が示され、プランの選択が不適切になる可能性があります。 オプティマイザーは、クエリが初めて検出された場合に統計に基づいてプランをコンパイルします。 これらの統計に現在のデータ分散が反映されていない場合、プランのパフォーマンスが低下する可能性があります。
実行プランの一般的な問題を特定する
実行プランは左から右、上から下に読み取られます。 最初の演算子はベース テーブルにアクセスし、最後の演算子はクエリ結果を生成します。 次の一般的な問題を探します。
演算子の種類 は、エンジンがデータにアクセスする方法を示します。 演算子の種類は多数あり、それぞれ異なる方法でデータを取得または処理します。 たとえば、 Index Seek 演算子は、インデックス キーを使用して特定の行を対象とする非常に効率的な方法を表します。 一方、 テーブル スキャン または インデックス スキャン 演算子は、すべての行を読み取る効率の低い方法を表します。 大きなテーブルでスキャンが表示される場合は、インデックスが必要になる可能性があります。 たとえば、eコマース アプリケーションが日付別に注文を照会し、プランに Orders テーブルにクラスター化インデックス スキャンが表示されている場合、 OrderDate 列に非クラスター化インデックスを追加すると、そのスキャンがシークに変更される可能性があります。 すべてのスキャンが悪いわけではないことに注意してください。 テーブルが小さい場合、または検索条件がテーブル内のほとんどの行を返す場合は、スキャンが最も効率的なアクセス方法である可能性があります。 常に、クエリのコンテキストとデータのサイズを考慮してください。 データを把握し、実行プランを使用して、アクセス方法が理にかなっているかどうかを確認します。
推定行数と実際の行数は、 オプティマイザーの前提条件が現実と一致するかどうかを明らかにします。 オプティマイザー は、統計、テーブル内のデータの分布と密度を記述するメタデータに基づいてプランを作成します。 これらの統計が古い場合は、推定行数と実際の行数が分岐します。 オプティマイザーは、行数を過小評価する場合、ハッシュ結合 (高速参照のためにメモリにハッシュ テーブルを構築する) の方が高速である場合や、並べ替え操作に割り当てるメモリが少なすぎる場合に、入れ子になったループ結合 (結合の内部テーブルから一度に 1 つの行を処理する) を選択する場合があります。 統計は重要なデータ変更後に古くなる可能性があるため、統計を UPDATE STATISTICS で更新したり、統計の自動更新を有効にしたりすると、オプティマイザーがより適切な意思決定を行うのに役立ちます。
キー参照演算子 は、エンジンが非クラスター化インデックスを介して行を検索するが、クラスター化インデックスから追加の列が必要な場合に表示されます。 一致する行ごとに、エンジンはクラスター化インデックスへの余分なラウンド トリップを実行して、それらの列を取得します。 フィルターが多数の行を返す場合、それらの余分な参照は高速に加算されます。 たとえば、eコマース アプリケーションが CustomerID で注文をフィルター処理するだけでなく、 OrderDate、 TotalAmount、 ShippingAddressも選択し、 CustomerID の非クラスター化インデックスにこれらの列が含まれていない場合、プランには一致する注文ごとにキー参照が表示されます。 不足している列をインデックスに含まれる列として追加することで、キー参照を排除できます。 含まれる列ではインデックス サイズが大きくなるため、書き込みが遅くなる可能性があるため、読み取りパフォーマンスのメリットと書き込みオーバーヘッドの比較に注意してください。
演算子間の太い矢印は、それらの間を流れる行の数を表します。 プランの初期段階で予期せずに太い矢印が現れる場合(左から右、上から下に読み取る)は、フィルターやインデックスが適用されていないために、処理される行が多すぎることを意味します。
不足しているインデックス候補は、 SSMS のグラフィカル実行プランの上部に緑色で強調表示されたテキストとして表示されます。 インデックスによってクエリのコストが大幅に削減される可能性があることをオプティマイザーが検出すると、推奨事項がプランに直接表示されます。 候補を右クリックし、[ 不足しているインデックスの詳細 ] を選択して、確認して実行できる CREATE INDEX ステートメントを生成します。 これらの提案は、実行プランを読むことで得られる最も簡単な成果の 1 つです。
警告 は、影響を受ける演算子に感嘆符 (⚠) が付いた黄色の三角形として表示されます。 各警告は、最適化の機会を示します。 一般的な警告は次のとおりです。
- 不足している統計: オプティマイザーは列の統計を見つけられなかったため、実際のデータ分散を使用する代わりに行数で推測しました。 この問題を解決するには、クエリで使用される列の統計を作成するか、既存の統計が古い場合は更新します。
- 過剰なメモリ許可: クエリは必要以上のメモリを要求し、他のクエリで使用できるリソースを無駄にしました。 この問題は、オプティマイザーが行数を過大評価する場合によく発生します。 統計を更新するか、以前に行をフィルター処理するようにクエリを書き換えることで、メモリ許可を減らすことができます。
-
結合述語なし: 適切な条件なしで 2 つのテーブルが結合され、可能なすべての行の組み合わせを返すデカルト積が生成されます。 クエリで、
ON句が見つからないか正しくないか確認します。 -
暗黙的な変換: データ型の不一致により、エンジンは実行時に値を変換し、インデックス シークをスキャンに変換できます。 たとえば、
WHERE句がnvarcharパラメーターをvarchar列と比較する場合、エンジンは比較する前に列のすべての行をnvarcharに変換します。 暗黙的な変換を修正するには、クエリ パラメーター内のデータ型を列定義と一致させます。 -
並べ替えまたはハッシュのスピル: 並べ替え操作またはハッシュ操作で許可されたメモリが不足し、中間結果が tempdb にスピルされました。 これらの操作は、スキャン後の CPU 使用率が高い 2 番目に一般的なドライバーです。 スピル警告が表示された場合、オプティマイザーは行数を過小評価し、要求されたメモリが少なすぎる可能性があります。
UPDATE STATISTICS実行してテーブルの統計を更新したり、クエリを書き換えたりして行数を減らしてから並べ替えを行うと、多くの場合、スピルが解消されます。
実行プランは、クエリのパフォーマンスを理解するための強力なツールです。 エンジンがクエリを実行する方法とボトルネックの場所を正確に示します。 実行プランを効果的に読み取る方法を学習することで、データベース クエリのパフォーマンスの問題をすばやく特定して修正できます。
ランタイム パフォーマンス データの DMV にクエリを実行する
DMV は、データベース エンジンからリアルタイムで蓄積されたパフォーマンス データを公開します。 Azure SQL Database には、クエリを実行するためにVIEW DATABASE STATE アクセス許可が必要です。 実行プランでは 1 つのクエリの実行方法が示されますが、DMV はすべてのクエリで何が起こっているかを示します。これは、最もコストの高いものを最初に見つけるのに役立ちます。
最もコストの高いクエリを見つける
CPU 時間、論理読み取り、実行数は、コストの高いクエリを識別するための最も一般的なメトリックです。 CPU 時間または論理読み取りが多い場合は、クエリがリソースを大量に消費している一方で、実行回数が多い場合は、中程度の負荷の高いクエリでも全体的なパフォーマンスに大きな影響を与える可能性があることを意味します。 まず、平均 CPU 時間または論理読み取りによって上位のクエリを確認し、最適化の候補を見つけます。
sys.dm_exec_query_stats は、キャッシュされたクエリ プランの集計パフォーマンス統計を返します。
sys.dm_exec_sql_text を使って結合し、クエリ テキストを確認し、sys.dm_exec_query_plan を使って実行計画を取得します。
次のクエリは、平均 CPU 時間で上位 10 個のクエリを検索します。
SELECT TOP 10
    qs.total_worker_time / qs.execution_count AS avg_cpu_time,
    qs.execution_count,
    qs.total_logical_reads / qs.execution_count AS avg_logical_reads,
    SUBSTRING(st.text, (qs.statement_start_offset / 2) + 1,
        ((CASE qs.statement_end_offset
            WHEN -1 THEN DATALENGTH(st.text)
            ELSE qs.statement_end_offset
        END - qs.statement_start_offset) / 2) + 1) AS query_text
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS st
ORDER BY avg_cpu_time DESC;
このスクリプトは、注意が必要なクエリを特定するのに役立ちます。 結果セットのサイズに対して高い avg_logical_reads は、多くの場合、インデックスの不足や非効率的なプランを指しています。 ただし、これらの結果を解釈するときは注意が必要です。 1 日に 1 回だけ実行される CPU 時間の平均が高いクエリは、1 時間あたり何千回も実行される中程度のクエリよりも小さい場合があります。 優先順位を付けるときは、常に平均コストと実行数の両方を考慮してください。 また、 avg_logical_reads して、I/O で負荷の高いクエリを検索することもできます。これは、インデックスの不足や非効率的なアクセス方法を示すことがよくあります。
現在実行中のクエリを確認する
前のクエリではプラン キャッシュ内で最もコストの高い履歴クエリが表示されますが、 sys.dm_exec_requests は現在実行中のすべての要求のスナップショットを提供します。 これには、CPU 時間、読み取り、書き込み、待機の種類、待機時間、およびブロック セッション ID の列が含まれます。 このビューを使用して、リソースの消費量が多すぎる、またはロックの待機中にスタックしているアクティブなクエリを特定します。 このビューは、リアルタイムのパフォーマンス監視とトラブルシューティングのための最も重要な DMV の 1 つです。
SELECT
    r.session_id,
    r.status,
    r.command,
    r.wait_type,
    r.wait_time,
    r.blocking_session_id,
    r.cpu_time,
    r.logical_reads,
    t.text AS query_text
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.session_id > 50
ORDER BY r.cpu_time DESC;
このクエリは、システム セッション (セッション ID 1 から 50) と注文を CPU 時間別に除外します。 I/O 負荷の高いクエリを検索するために、 logical_reads 順に並べ替えることもできます。
wait_type列とwait_time列は、クエリがロック、I/O、またはその他のリソースを待機しているかどうかを識別するのに役立ちます。
不足しているインデックスを検出する
前に、1 つのクエリに対して不足しているインデックス候補を実行プランで表示する方法について説明しました。 欠落しているインデックス DMV を使用すると、オプティマイザーがすべてのクエリで使用するインデックスが存在する場合にどのインデックスが使用されるのかを広く把握できます。 これらのビューは、複数のクエリに影響する最適化の機会を見つけるための優れた方法です。
sys.dm_db_missing_index_details には、テーブル、等値列と不等値列、および含まれる列が表示されます。
sys.dm_db_missing_index_group_stats は、コスト削減を見積もる改善策を提供します。
SELECT
    mid.statement AS table_name,
    mid.equality_columns,
    mid.inequality_columns,
    mid.included_columns,
    migs.avg_total_user_cost * migs.avg_user_impact *
        (migs.user_seeks + migs.user_scans) AS improvement_measure
FROM sys.dm_db_missing_index_groups AS mig
INNER JOIN sys.dm_db_missing_index_group_stats AS migs
    ON migs.group_handle = mig.index_group_handle
INNER JOIN sys.dm_db_missing_index_details AS mid
    ON mig.index_handle = mid.index_handle
ORDER BY improvement_measure DESC;
このクエリは、不足しているインデックスの推奨事項ごとに improvement_measure を計算します。これは、インデックスの恩恵を受けるクエリの平均コスト、平均改善率、およびそれらのクエリが実行された回数の積です。 この指標による並べ替えは、優先して作成する欠落しているインデックスを決定するのに役立ちます。 ただし、これらの結果は、プラン キャッシュ内の現在のクエリに基づく推奨事項に過ぎず注意してください。 推奨されるインデックス列を常に確認し、運用環境に追加する前に、クエリのパフォーマンスと書き込みのオーバーヘッドの両方に対する影響をテストしてください。
注
インデックスの推奨事項が見つからないのは、ディレクティブではなく、提案です。 運用環境に追加する前に、クエリのパフォーマンスと書き込みのオーバーヘッドの両方に対する新しいインデックスの影響を常にテストしてください。
アクティブなセッションと待機中のタスクを監視する
sys.dm_exec_sessions は、サインイン時間、ホスト名、プログラム名、累積 CPU と読み取りなど、認証されたすべてのセッションに関する情報を提供します。 それを sys.dm_os_waiting_tasks と組み合わせて、待機しているタスクと待機しているリソースを確認します。 これらのビューは、後のユニットでブロックとリソースの競合を診断するときに不可欠になります。
すべてをまとめる
実行プランと DMV を使用すると、クエリの動作の全体像を把握できます。 DMV から始めて、最もコストの高いクエリを特定します。 次に、実行プランを詳しく調べて、コストがかかる 理由 を理解します。 インデックスが見つからないためスキャンが発生していますか? 行の推定エラーの原因となっている古い統計 除外することができる Key Lookup システム全体のビューから個々のクエリ分析まで、この体系的なアプローチは、パフォーマンスのボトルネックを見つけて修正するための最も効率的な方法です。
重要なポイント
実行プランは、クエリに対するオプティマイザーの戦略を明らかにし、実際のプランには、推定行数と実際の行数の間の不一致を公開するランタイム メトリックが含まれます。 プランを読むときは、演算子の種類 (シークとスキャン)、行数の見積もり、警告、およびキー参照演算子に重点を置きます。 DMV はシステム全体のパフォーマンス データを提供します。 sys.dm_exec_query_stats を使用して最もコストの高いクエリを検索し、現在実行中のクエリの sys.dm_exec_requests 、最適化の機会に不足しているインデックス DMV を検索します。 DMV から始めて、最も大きな問題がどこにあるかを特定し、個々の実行計画を詳しく調べて理由を理解します。