ブロックとデッドロックを特定して解決する
ブロックは、ロックを使用するデータベースでは通常行われます。 1 つのトランザクションがロックを保持します。 別のトランザクションが待っています。 数ミリ秒続く短いブロックが予想されます。 ユーザーに影響を与えるのに十分な長さになると、問題になります。 デッドロックはより重大な形式です。2 つのトランザクションが互いを完全にブロックし、データベース エンジンはサイクルを中断するために 1 つを終了する必要があります。
ブロッキング
ブロックは、あるセッションがリソースのロックを保持し、別のセッションが同じリソースに対して競合するロックを要求したときに発生します。 要求中のセッションは、最初のセッションがそのロックを解放するまで待機します。
リソースには、行、ページ、またはテーブル全体を指定できます。 ロックは、共有 (読み取り用) または排他 (書き込み用) にすることができます。 セッションは、既存のロックと競合するロックを要求すると、最初のセッションがそのトランザクションをコミットまたはロールバックしてロックを解放するまでブロックされます。
ブロッキング チェーンを識別する
Azure SQL Database では、Read Committed Snapshot Isolation (RCSI) が既定で有効になっているため、読み取り操作では共有ロックではなく行のバージョン管理が使用されます。 この設定により、リーダーとライターの間のブロックが大幅に削減されます。 ただし、2 つのライター間のブロックや、分離レベルが高い明示的なトランザクションによって発生するブロックは引き続き発生します。
ブロック チェーンの上部にあるセッションは、 ヘッド ブロッカーと呼ばれます。 他のすべてのブロックされたセッションは、ヘッド ブロッカーがロックを解放するのを直接または間接的に待機しています。 ヘッド ブロッカーを見つけるには、 sys.dm_exec_requests クエリを実行し、 blocking_session_id が 0 以外のセッションを探します。
SELECT
    r.session_id,
    r.blocking_session_id,
    r.wait_type,
    r.wait_time,
    r.wait_resource,
    t.text AS query_text,
    r.status,
    r.command
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.blocking_session_id <> 0
ORDER BY r.wait_time DESC;
これらの結果でヘッド ブロッカーを見つけるには、他のユーザーをブロックするが、それ自体はブロックされていないセッション ID を探します。 たとえば、クエリから次の行が返されたとします。
| セッションID | ブロッキング・セッションID |
|---|---|
| 55 | 52 |
| 60 | 52 |
| 52 | 0 |
セッション 55 とセッション 60 はどちらもセッション 52 によってブロックされ、セッション 52 にはblocking_session_idの0があるため、何もブロックされていないことを意味します。 セッション 52 はヘッド ブロッカーです。 これを特定したら、sys.dm_exec_sessionsクエリを実行して、そのセッション ID にフィルタリングされたsys.dm_exec_requestsを確認し、何を実行しているか、およびなぜロックを保持しているかを確認します。
RCSI では、リーダーとライターの間のブロックは排除されますが、2 つのライター間ではブロックされないことに注意してください。 セッション 52 が明示的なトランザクション内でバッチ更新を実行するシナリオを考えてみましょう。
-- Session 52
BEGIN TRANSACTION;
UPDATE Orders SET Status = 'Processing' WHERE Region = 'West';
-- Transaction stays open while application does other work
このアップデートは、一致するすべての行の排他ロックを取得します。 セッション 55 は、同じ行の 1 つを更新しようとします。
-- Session 55
UPDATE Orders SET Priority = 1 WHERE OrderId = 4820;
セッション 55 は、セッション 52 が既にその行の排他ロックを保持していて、まだコミットされていないため、待機しています。 これらの行に対する SELECT クエリは、共有ロックを要求する代わりに行バージョンを読み取るため、RCSI では引き続き成功します。 RCSI でリーダー ライター のブロックを既定で削除する場合、Azure SQL Database で発生するブロックには、通常、両方が同じ行に書き込む必要がある 2 つのセッションが含まれます。
一般的なブロック シナリオを認識する
ブロックが発生 する理由 を理解することは、ブロックを防ぐのに役立ちます。 Azure SQL Database エンジンはロックを自動的に管理しますが、特定のパターンではブロックが長くなります。
長時間にわたってロックを保持する実行時間の長いクエリ。 クエリはアクティブに実行され、進行していますが、その間はロックが保持されます。 同じリソースに対して競合するロックを必要とする他のセッションは、クエリが完了するまで待機します。 この問題を解決するには、インデックスの追加や、より少ない行へのアクセスに対する書き換えなど、クエリを最適化する方法を探します。
コミットされていないトランザクションを含む休止中のセッション。 セッションは、明示的なトランザクション内でステートメントを実行した後、実行を停止しますが、コミットやロールバックは行わない。 トランザクションからのロックは無期限に保持されます。 この問題は、多くの場合、アプリケーションでクエリのタイムアウトまたは取り消しが発生しても、対応する ROLLBACKが発行されない場合に発生します。 ランタイム エラーによってトランザクションが自動的にロールバックされるように、 SET XACT_ABORT ON を使用します。
結果行をすべて取得しなかったセッション。 アプリケーションはクエリを送信しますが、結果セットからすべての行を取得するわけではありません。 まだフェッチされていない行にロックが保持されたままになることがあります。 アプリケーションがすべての結果行をフェッチして完了することを確認します。
ロールバック状態のセッション。 ( KILL またはデッドロックによって) 終了されたクエリは、その変更をロールバックしています。 ロールバックには大きな変更にかなりの時間がかかる場合があり、セッションはこのプロセス中もロックを保持し続けます。 ロールバックが完了するまで待ち、混雑している時間帯に大規模なバッチ変更を避けてください。
孤立した接続。 クライアント アプリケーションがクラッシュするか、データベース接続を正常に閉じずにワークステーションが再起動します。 サーバーはすぐに切断を検出しないため、そのセッションからのロックは保持されたままです。 孤立セッションを KILL <session_id>; で終了します。
注
これらの 2 つのシナリオは、既定で Azure SQL Database で軽減されます。 RCSI は、 SELECT クエリが行のバージョン管理の下で共有ロックを取得しないため、フェッチされていない結果行の影響を軽減します。そのため、フェッチされていない行はライターをブロックしません。 高速データベース復旧 (ADR) では、トランザクション サイズに関係なくほぼ瞬時に変更を元に戻すことができるため、長時間のロールバックはまれになります。 残りの 3 つのシナリオ (実行時間の長いクエリ、コミットされていないトランザクションを含むスリープ セッション、孤立した接続) は、RCSI と ADR が早期に解放できない排他的書き込みロックが含まれているため、完全に関連しています。
アクティブなブロックを解決する
アクティブなブロックが見つかると、次のようになります。
- 前に示した DMV クエリを使用して、ヘッド ブロッカーを特定します。
- ブロック セッションのトランザクションを単独で完了できるかどうか、または外部入力を待機しているかどうかを判断します。
- ブロッキング セッションが孤立した接続または切断された接続である場合は、
KILL <session_id>;を使用してそれを終了します。 - ブロック クエリの実行プランで、インデックスの不足などの最適化の機会を確認します。
ブロックが繰り返されないようにするには、トランザクションを短くします。 トランザクション内で最低限必要なステートメントのみを実行し、直ちにコミットします。 アプリケーション コードで SET XACT_ABORT ON を使用して、ランタイム エラーによってトランザクション全体が自動的にロールバックされるようにします。これにより、半完了トランザクションがロックを無期限に保持できなくなります。 すべてのユーザー向けロジックをトランザクション境界外に移動します。
デッドロック
2 つ以上のトランザクションが循環依存関係を形成すると 、デッドロック が発生します。 各トランザクションは、他のトランザクションが必要とするロックを保持し、どちらも続行できません。 具体的な例を次に示します。
- トランザクション A は行 1 を更新し、排他ロックを取得します。
- トランザクション B は行 2 を更新し、排他ロックを取得します。
- トランザクション A は行 2 の更新を試み、トランザクション B によってブロックされます。
- トランザクション B は行 1 の更新を試み、トランザクション A によってブロックされます。
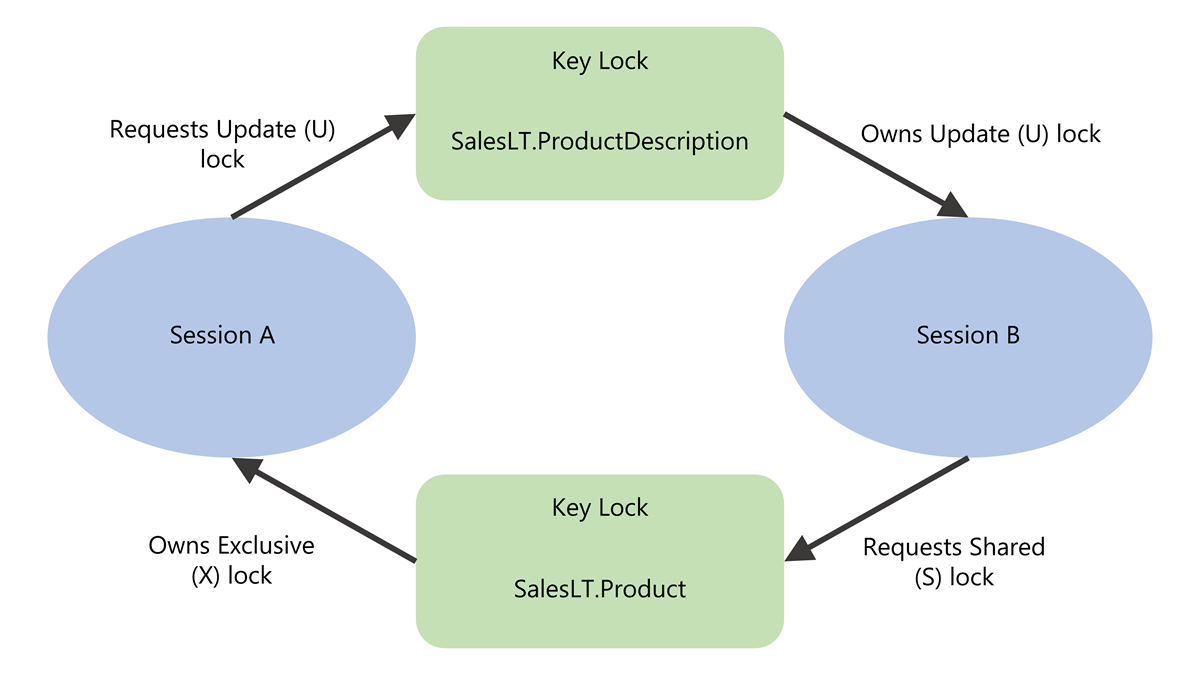
どちらのトランザクションも完了できません。 データベース エンジンの デッドロック モニター は、これらのサイクルを定期的にチェックします。既定の間隔は 5 秒で、デッドロックが頻繁に発生する場合は 100 ミリ秒まで低下します。 サイクルを検出すると、最もコストの低いトランザクションを 対象ユーザーとして選択し、ロールバックして、エラー 1205 をアプリケーションに返します。 このロールバックにより、他のトランザクションを完了できます。
デッドロック情報をキャプチャする
SQL Server と Azure SQL Managed Instance では、 system_health 拡張イベント セッションによって、デッドロック イベントが既定でキャプチャされます。
sys.dm_xe_session_targetsとsys.dm_xe_sessionsを使用して、リング バッファーからデッドロック レポートに対してクエリを実行できます。
Azure SQL Database では、アプローチが異なります。
sqlserver.database_xml_deadlock_report イベントをキャプチャするカスタム拡張イベント セッションを作成し、データベース スコープの DMV sys.dm_xe_database_sessionsとsys.dm_xe_database_session_targetsを使用してクエリを実行します。 次の例では、デッドロック キャプチャ セッションを作成し、そのリング バッファーに対してクエリを実行します。
-- Create and start the session
CREATE EVENT SESSION [deadlocks] ON DATABASE
ADD EVENT sqlserver.database_xml_deadlock_report
ADD TARGET package0.ring_buffer
WITH (STARTUP_STATE = ON, MAX_MEMORY = 4 MB);
GO

ALTER EVENT SESSION [deadlocks] ON DATABASE STATE = START;
GO

-- Query deadlock events from the ring buffer
DECLARE @tracename sysname = N'deadlocks';

SELECT
    d.value('(/event/@timestamp)[1]', 'datetime2') AS deadlock_time,
    d.query('/event/data[@name=''xml_report'']/value/deadlock') AS deadlock_xml
FROM (
    SELECT CAST(target_data AS XML) AS rb
    FROM sys.dm_xe_database_sessions AS s
    INNER JOIN sys.dm_xe_database_session_targets AS t
        ON CAST(t.event_session_address AS BINARY(8)) = CAST(s.address AS BINARY(8))
    WHERE s.name = @tracename
        AND t.target_name = N'ring_buffer'
) AS ring_buffer
CROSS APPLY rb.nodes(
    '/RingBufferTarget/event[@name=''database_xml_deadlock_report'']'
) AS xevent(d)
ORDER BY deadlock_time DESC;
デッドロック グラフには、3 つのセクションが含まれています。 被害者リストは、どのトランザクションが終了されたかを識別します。 プロセス一覧には、クエリ テキスト、分離レベル、ロック モードなど、関連する各プロセスが表示されます。 リソース一覧には、ロックされたリソースと、各リソースを所有して待機するプロセスが表示されます。
Azure SQL Database では、デッドロックが発生したときに通知を受信するように Azure portal を介してデッドロック アラートを構成することもできます。
デッドロックを防ぐ
すべてのデッドロックを排除することはできませんが、発生頻度を大幅に減らすことができます。
- 一貫した順序でオブジェクトにアクセスする: すべてのトランザクションがテーブル B の前にテーブル A を変更した場合、循環依存関係を形成できません。 ストアド プロシージャを使用してアクセス パターンを標準化します。
- トランザクションを短くする: トランザクションが短いほどロックが保持され、循環依存関係の期間が短縮されます。
- 行バージョン管理の分離レベルを使用する: RCSI は読み取り操作の共有ロックを排除し、デッドロック サイクルの一般的なソースを 1 つ削除します。 Azure SQL Database でのロックの最適化により、デッドロックの可能性がさらに軽減されます。
- 適切なインデックスを追加する: クエリが多数の行をスキャンすると、さまざまなデータにわたってロックが取得されます。 スキャン対象の行数を減らすためのインデックスを追加すると、ロックの競合が軽減されます。
- クエリ ストアでプラン強制を使用する: プランの変更により、クエリがより多くの行をスキャンし、より多くのロックを取得した場合、以前のプランを強制すると、調査中にデッドロックが軽減される可能性があります。
アプリケーション コードでデッドロックを処理する
アプリケーションには、デッドロック エラーの再試行ロジックを常に含める必要があります。 トランザクションがデッドロックの対象として選択されると、データベース エンジンはそれをロールバックし、エラー 1205 を返します。 アプリケーションでこのエラーをキャッチし、少し一時停止して、トランザクションを再送信する必要があります。
BEGIN TRY
    BEGIN TRANSACTION;
    -- Your data modification statements
    COMMIT TRANSACTION;
END TRY
BEGIN CATCH
    IF ERROR_NUMBER() = 1205
    BEGIN
        ROLLBACK TRANSACTION;
        WAITFOR DELAY '00:00:01';  -- Brief pause before retry
        -- Retry logic here
    END
    ELSE
    BEGIN
        ROLLBACK TRANSACTION;
        THROW;
    END
END CATCH;
ヒント
同じ 2 つのトランザクションが直ちに互いにデッドロックするのを防ぐために、試行間の再試行遅延をランダム化します。 一般的なパターンは、ランダムなコンポーネントで 1 秒から 3 秒の間待機することです。
重要なポイント
ブロックは正常ですが、長時間のブロックはユーザーに影響するため、sys.dm_exec_requests を使用して主要なブロッカーを見つけ、その動作を理解します。 一般的なシナリオには、実行時間の長いクエリ、コミットされていないトランザクションを含むスリープ 状態のセッション、孤立した接続などがあります。これらはすべて、トランザクションを短くし、 SET XACT_ABORT ONを使用し、アプリケーションが接続と結果セットを適切に管理できるようにすることで対処します。 トランザクションが循環ロック依存関係を作成し、データベース エンジンが最もコストの低いトランザクションを終了し、エラー 1205 を返すことによって自動的に解決されると、デッドロックが発生します。 オブジェクトに一貫した順序でアクセスし、トランザクションを短くし、行のバージョン管理分離レベルを使用し、適切なインデックスを追加することで、デッドロックの頻度を減らします。 アプリケーション コードには、デッドロックの対象として選択されたときに自動的に回復できるように、エラー 1205 の再試行ロジックを常に含める必要があります。