Azure Data Explorer의 다중 테넌트 개념은 서로 다른 테넌트에 서비스를 제공하고 단일 클러스터에 데이터를 저장하는 것을 의미합니다.
Important
다중 테넌트 솔루션은 Microsoft Fabric Real-Time Intelligence 워크로드에서 Eventhouse 내의 KQL 데이터베이스를 사용하여 설계할 수도 있습니다.
테넌트는 테넌트 경계를 따라 데이터를 분리해야 하는 고객, 사용자 그룹 또는 사용자 분류를 나타낼 수 있습니다. 각 테넌트가 여러 개 있는 여러 애플리케이션과 같은 다단계 다중 테넌트 시나리오를 사용할 수도 있습니다. 이 문서에서는 이 시나리오를 다루지 않지만 유사한 원칙이 적용됩니다.
중요한 요소는 최종 사용자가 테넌트 데이터에 액세스하는 방법입니다. 최종 사용자가 Azure Data Explorer에 직접 액세스하는 경우 사용자 보기를 자신의 데이터로 격리하려면 Azure Data Explorer에서 액세스 제어를 구성해야 합니다. 프록시 애플리케이션이 Azure Data Explorer에서 데이터에 액세스하는 경우 애플리케이션은 격리를 수행할 수 있습니다.
이 문서에서는 일부 배포 아키텍처를 설명하고 각각에 대한 특성을 제공합니다. 특성을 사용하여 솔루션에 가장 적합한 아키텍처를 결정할 수 있습니다.
시끄러운 이웃
일반적으로 사용되는 아키텍처에 관계없이 많은 테넌트 간에 클러스터를 공유한다는 것은 서로 다른 테넌트가 클러스터의 리소스를 공유한다는 것을 의미합니다. 이 시끄러운 이웃 안티패턴으로 이어질 수 있습니다.
예를 들어 테넌트가 컴퓨팅 집약적 쿼리 또는 수집을 많이 수행하는 경우 다른 테넌트는 리소스 부족의 영향을 받을 수 있습니다. 워크로드 그룹을 사용하여 완화할 수 있습니다. 정책을 사용하여 캐싱 및 전체 스토리지를 제어할 수도 있습니다.
아키텍처 개요
다음 섹션에서는 배포 아키텍처를 자세히 살펴봅니다. 이 섹션에서는 의사 결정을 용이하게 하기 위해 아키텍처를 대조합니다.
| Architecture | Strengths |
|---|---|
| 데이터베이스당 하나의 테넌트 | - 테넌트 격리: 프록시 필요 없음 - 테넌트당 보존 정책과 같은 다른 정책을 가질 수 있습니다. - 테넌트당 스키마 진화의 유연성 - 테넌트 데이터를 쉽고 빠르게 제거 |
| 여러 테넌트에 대한 하나의 테이블 | - 효율적인 데이터 통합 및 범위 관리 - 간소화된 스키마 진화 - 구체화된 뷰에 가장 적합 - 분할에 이상적 |
| 단일 데이터베이스의 테이블당 하나의 테넌트 | 권장되지 않음 |
아키텍처: 데이터베이스당 하나의 테넌트
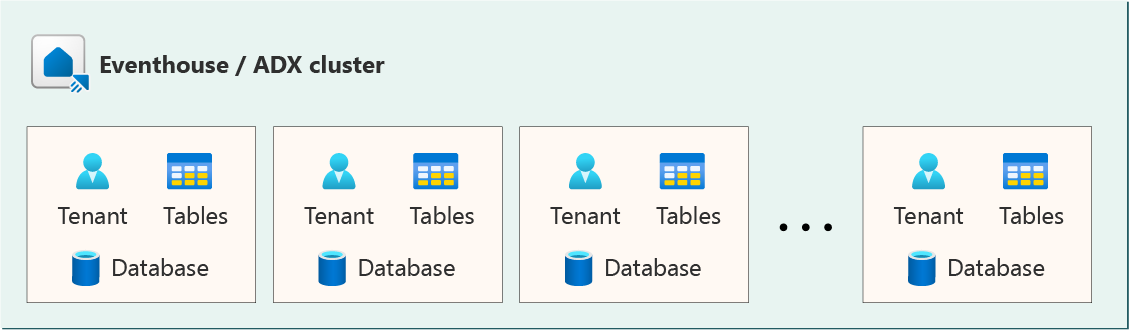
이것은 인기 있고 직선적인 아키텍처입니다. 각 테넌트는 자체 데이터베이스를 가져옵니다. 각 데이터베이스에는 동일한 스키마가 있습니다.
이 아키텍처의 특징은 다음과 같습니다.
새 테넌트 프로비전: 새 데이터베이스를 만들고 해당 데이터베이스 에 스키마 엔터티 를 배포해야 합니다.
테넌트 제거: 데이터베이스를 삭제해야 합니다. 데이터베이스 삭제는 몇 초 안에 수행할 수 있습니다. 테넌트의 데이터 볼륨과 선형적이지 않게 적은 양의 일정한 리소스를 소비합니다.
데이터베이스 스키마 업데이트: 각 테넌트는 서로 다른 시간에 독립적으로 업데이트할 수 있습니다. 데이터베이스에 액세스하는 애플리케이션은 상호 작용하는 각 데이터베이스의 버전을 알고 있어야 합니다.
보존 및 캐싱 정책: 각 테넌트에는 고유한 정책이 있을 수 있으므로 고객에게 사용자 지정 보존 및 캐싱 정책을 제공할 수 있습니다.
테넌트당 보안 경계:
대규모로 여러 테넌트의 데이터 집계: 통합 연산자를 사용하여 데이터베이스 간에 데이터를 집계합니다. 그러나 이 메서드는 테넌트 수가 증가함에 따라 번거로울 수 있습니다. 여러 테넌트의 데이터를 집계하는 것이 테넌트의 관점에서 디자인 목표가 될 수 있지만 솔루션 소유자가 모든 테넌트의 데이터를 집계하여 통계를 수집하는 것이 중요할 수 있습니다.
익스텐트 조각화: 데이터베이스 테이블당 몇 개의 레코드를 수집하는 각 테넌트는 나중에 병합해야 하는 작은 익스텐트를 만듭니다. 이로 인해 익스텐트 관리 비용이 높아질 수 있습니다. 따라서 스트리밍 수집을 강력히 권장하며, Event Hubs 또는 Event Grid 수집과 같은 방법을 사용할 것을 권장합니다. 스트리밍 수집을 사용하려면 클러스터 및 테이블에서 사용하도록 설정되어 있는지 확인해야 합니다.
구체화된 뷰 및 분할 정책. 테넌트 수가 증가함에 따라 클러스터가 효율적으로 실행할 수 있는 구체화된 뷰 및 파티션 정책의 수에는 제한이 있다는 점을 기억해야 합니다.
Event Grid 및 Event Hubs 데이터 연결: 이러한 데이터 연결은 데이터베이스별로 만들어집니다. 따라서 이 아키텍처에는 테넌트당 데이터 연결 및 Event Grid 또는 Event Hubs 인스턴스가 필요하므로 관리 복잡성이 추가됩니다. Event Hubs 및 Event Grid에 이벤트 라우팅을 사용하는 것이 좋습니다.
아키텍처: 여러 테넌트에 대한 하나의 테이블
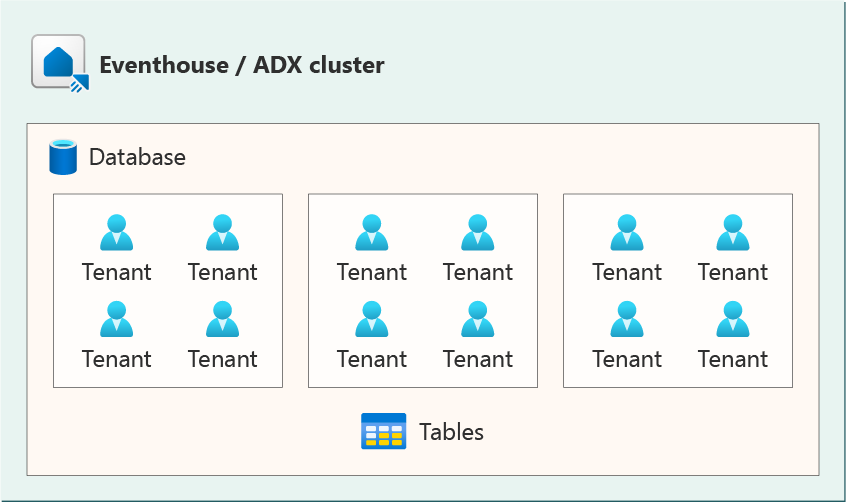
이 아키텍처는 모든 테넌트에 단일 데이터베이스를 사용하여 통합에서 더욱 공격적입니다. 데이터베이스의 각 테이블에는 단일 테넌트의 데이터를 필터링할 수 있는 테넌트 ID 열 또는 해당 열이 있습니다. 대부분의 쿼리가 테넌트별로 필터링될 가능성이 높기 때문에 테넌트별로 테이블을 분할하여 쿼리 성능을 향상시킬 수 있습니다. 가능하다면 복합 파티션 키를 사용하여 다른 열과 함께 파티션 하는 것을 고려해야 합니다. 예를 들어 테넌트 ID와 다른 열의 값을 연결하는 복합 파티션 키를 만들 수 있습니다.
이 아키텍처의 특징은 다음과 같습니다.
새 테넌트 프로비전: 새 테넌트를 프로비전하는 경우 데이터베이스를 만들거나 스키마를 조정할 필요가 없습니다. 새 테넌트 ID 는 새 레코드에 사용됩니다.
테넌트 제거: 테넌트의 데이터를 일시 삭제하거나 완전 삭제해야 합니다. 예를 들어, 주말에 여러 제거를 함께 일괄 처리하여 리소스 소비에 미치는 영향을 제한할 수 있습니다.
데이터베이스 스키마 업데이트: 모든 테넌트의 스키마가 동시에 업그레이드됩니다. 모든 테넌트가 테이블을 공유하므로 테이블 스키마를 변경하면 모든 테넌트가 한 번에 변경됩니다.
보존 및 캐싱 정책: 정책은 모두 동일한 테이블을 공유하기 때문에 모든 테넌트에 대해 동일합니다.
테넌트당 보안 경계:
- 다중 테넌트 애플리케이션(프록시): Restrict 문을 사용합니다.
- 직접 액세스 권한이 있는 사용자의 경우: 행 수준 보안 정책을 사용하고 해당 제한 사항을 숙지합니다. 사용자에게 데이터베이스에 대한 직접 액세스 권한을 부여하면 구현 세부 정보에 대한 종속성이 만들어지므로 구현을 변경하기가 어렵습니다. 따라서 데이터베이스에 액세스하기 위해 프록시 접근 방식을 사용하는 것이 좋습니다.
대규모로 여러 테넌트의 데이터 집계: 액세스 권한이 충분한 사용자는 여러 테넌트의 데이터에 대한 표준 집계 쿼리를 실행할 수 있습니다.
익스텐트 분할: 모든 테넌트가 동일한 테이블에 데이터를 수집하므로 데이터를 일반적으로 통합하여 하나 또는 몇 개의 익스텐트에서 효율적으로 흡수할 수 있습니다.
구체화된 뷰 및 분할 정책: 다중 테넌트 테이블에서 사용할 수 있습니다. 테넌트 ID 또는 이에 상응하는 열을 분할하여 성능을 향상시킬 수 있습니다. 자세한 내용은 파티션 정책에 대한 시나리오를 참조하세요.
Event Grid 및 Event Hubs 데이터 연결: 모든 테넌트에 대한 데이터가 하나의 테이블로 끝나기 때문에 데이터 연결을 통합했습니다.
아키텍처: 단일 데이터베이스의 테이블당 하나의 테넌트
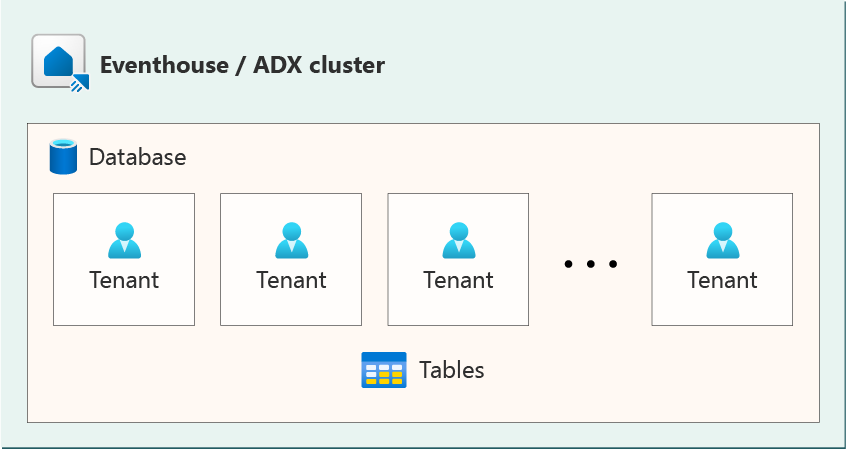
이 아키텍처는 모든 테넌트 데이터가 단일 데이터베이스에 있지만 별도의 테이블로 끝나는 이전 아키텍처의 조합입니다. 이 아키텍처는 다른 아키텍처의 모든 장점을 포착하지 못합니다.
각 테넌트의 데이터는 분리되어 있지만 모두 동일한 데이터베이스의 동일한 보안 컨텍스트에 상주합니다. 다중 데이터베이스 아키텍처와 마찬가지로 이 아키텍처는 익스텐트 조각화로 이어질 수 있습니다. 테이블 이름은 각 테넌트에 대해 다르므로 각 테넌트에 대해 쿼리를 사용자 지정해야 합니다.