Important
이 기능은 베타 버전으로 제공됩니다. 사용하려면 작업 공간 관리자가 Previews 페이지에서 에이전트 메모리 세션을 켜야 합니다. Azure Databricks 미리 보기 관리를 참조하세요.
에이전트 기억은 여러 대화에 걸쳐 지속되는 장기 기억을 에이전트에게 제공합니다. Azure Databricks는 Lakebase에 메모리를 저장하고 저장, 인덱싱, 검색을 대신 관리하므로 에이전트가 사용자 선호도, 과거 결정, 누적된 맥락을 데이터베이스 조작 없이도 기억할 수 있습니다.
메모
미리보기 중에는 메모리 항목을 저장하는 Lakebase 인스턴스에 대한 요금이 청구됩니다. 에이전트 메모리 자체에 대해서는 추가 요금이 부과되지 않습니다. 가격은 미리보기 진행에 따라 변경될 수 있습니다.
에이전트가 다음을 수행하도록 하려면 에이전트 메모리를 사용하세요:
- 사용자 선호도, 사실, 그리고 각기 다른 대화에서 결정들을 기억하세요.
- 상담원이 이전 세션에서 배운 내용을 바탕으로 응답을 개인화하세요.
- 에이전트와 프로젝트 간에 축적된 지식을 공유하세요.
- 시간이 지남에 따라 정확도와 효율성을 향상시킵니다.
에이전트 메모리는 어떤 프레임워크로 구축된 에이전트와도 작동합니다. 단일 상호작용 내 단기 대화 기록을 위해서는 에이전트 세션을 사용하세요.
Requirements
- AgentKit SDK를 사용하려면 Python 3.10 이상 버전을 설치하세요. AgentKit SDK는 아래 예시들이 사용하는 에이전트 API용 Databricks Python 클라이언트입니다. 또한 Python 요구사항 없이 어떤 언어에서든 REST API를 직접 호출할 수 있습니다.
-
memory_store.put()또는memory_store.list(path=...)를 사용하려면databricks-agentbricks0.6.0 이상을 설치하세요.
에이전트 메모리의 작동 원리
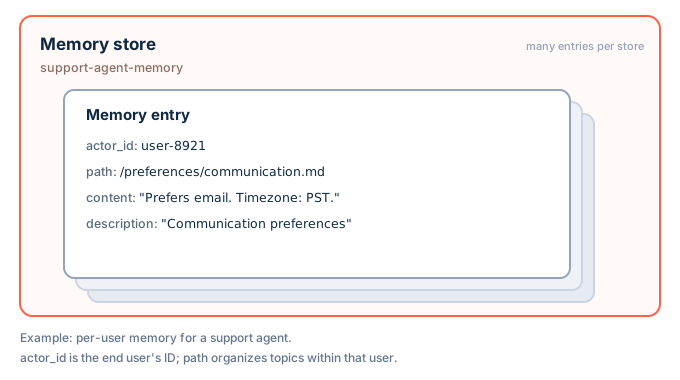
에이전트 메모리는 두 가지 수준으로 나뉩니다:
- 메모리 저장소는 에이전트의 메모리를 위한 작업 공간 범위 컨테이너입니다. 저장소를 생성하면 백업 Lakebase 저장소가 자동으로 프로비저딩됩니다. 스토어를 생성할 때 선택한 스토어 ID로 스토어를 지정합니다.
-
메모리 항목은 저장소 내의 개별 콘텐츠 조각입니다. 각 항목은 자유 형식의 텍스트, 검색에 사용되는 짧은 텍스트
contentdescription, 그리고 그것을 조직하고 분할하는 필드 집합을 가지고 있습니다:-
actor_id(필수): 메모리가 누구의 것인지, 예를 들어 최종 사용자 또는 다른 에이전트. -
session_id(선택적으로): 메모리가 속한 세션. 액터의 세션 전반에 걸쳐 적용되는 메모리의 경우 설정하지 않은 상태로 두세요. -
path(필수): 액터 내 항목을 조직하는 파일 시스템과 유사한 경로, 예를 들어/preferences/response-style.md.
-
한 항목은 session_id, path, actor_id의 조합으로 고유하게 식별됩니다. 두 개의 서로 다른 세션 하에서의 동일한 경로, 또는 한 세션 하에서와 세션 없이의 동일한 경로는 두 개의 별도 항목을 갖습니다.
항목은 두 가지 방식으로 저장소에 들어가는데, 에이전트나 애플리케이션이 직접 작성하거나, 메모리 파이프라인이 세션 저장소의 대화에서 항목을 추려냅니다.
검색
메모리를 두 가지 방법으로 검색합니다:
- actor의 목록 항목을 나열하며, 선택적으로
path,path접두사 또는 정확한session_id로 필터링할 수 있습니다. 이를 사용해 에이전트가 아는 내용을 탐색하거나 인덱스를 렌더링하세요. - 자연어 쿼리가 포함된 배우 항목을 검색하세요. 검색은 관련성 점수별로 순위를 매긴 가장 관련성 높은 항목을 반환합니다.
두 작업 중 하나에 대한 필터는 session_id 해당 세션에 저장된 항목만 반환합니다. 세션 없이 저장된 항목은 반환하지 않습니다.
Get started
AgentKit SDK와 REST API 예시는 지원용 에이전트의 에이전트 메모리를 설정합니다: 메모리 저장소를 생성하고 사용자의 선호도를 저장한 후 나중에 대화에서 다시 불러옵니다. Agent Bricks CLI 예시는 CLI로 빌드하고 배포하는 에이전트에 메모리 저장소를 연결합니다. 프로젝트에 맞는 클라이언트를 선택하세요. 메모리 저장소 ID는 3자에서 56자까지여야 하며, 소문자로 시작해 글자 또는 숫자로 끝나야 하며, 소문자, 숫자, 하이픈만 포함해야 합니다.
AgentKit SDK
AgentKit SDK는 패키지에 배포 databricks-agentbricks 된 Databricks Python 클라이언트로, 에이전트 API를 지원합니다. Databricks SDK로 인증합니다 WorkspaceClient.
AgentKit SDK 설치:
pip install databricks-agentbricks에이전트를 위한 메모리 저장소를 만드세요.
AgentKitClient이(가) 회원님의WorkspaceClient자격 증명으로 인증합니다:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")에이전트가 사용자에 대해 지속 가능한 정보를 알게 된 후 기억을 저장하세요.
actor_id이 메모리가 누구의 것인지 를 사용하며,path해당 액터description내에서 이를 조직하고 검색을 향상시킵니다:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()해당 경로에 이미 항목이 있으면ALREADY_EXISTS실패합니다. 항목을 생성하거나 기존 항목을 업데이트하려면memory_store.put()를 동일한 인수로 호출하세요.자연어 검색으로 이후 대화에서 사용자의 기억을 떠올리세요:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
클라이언트는 /api/2.0/agents/memory-stores 아래의 REST API를 호출합니다. Python 외의 언어에 대해 직접 호출하세요.
Databricks CLI로 OAuth 토큰을 생성하세요:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
에이전트를 위한 메모리 저장소를 만드세요:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
사용자를 위한 메모리 항목을 저장하세요.
actor_id는 이것이 누구의 기억인지 나타내고,path는 이를 정리하며,description는 검색을 향상합니다:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'해당 경로에 이미 존재하는 항목이 있다면, 요청이
ALREADY_EXISTS(HTTP 409)와 함께 실패합니다. 기존 항목을 업데이트하려면 경로로 검색하세요. 조회는 각 세션의 경로 항목을 반환하므로,session_id가 일치하는 항목을 선택하세요.name의 마지막 구간은 항목 ID입니다:curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md"그 다음 ID로 해당 항목을 찾아 내용을 업데이트하세요:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/<entry-id>?update_mask=content" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"content": "Prefers email over phone. Timezone: PST."}'
자연어 검색으로 사용자의 기억을 되살리세요:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
에이전트 브릭스
에이전트를 Agent Bricks CLI로 빌드하면, agentbricks init에서 agent.toml에 메모리 저장소를 선언합니다.
agentbricks deploy 아직 없으면 스토어를 생성하고 배포된 에이전트에게 그 스토어에 대한 접근 권한을 부여합니다.
경로를 선택하세요:
빈 상태로 시작(대부분의 에이전트): 에이전트를 배치합니다.
agentbricks deployagentbricks init에서 선언한 메모리 저장소를 생성합니다.my-agent라는 이름의 에이전트를 배포하려면 다음을 실행하세요:agentbricks deploy my-agent저장소에 이미 있는 메모리부터 시작하세요: 먼저 저장소를 만들고, 항목을 추가한 뒤 저장소를 에이전트에 바인딩하고 배포하세요.
라고 이름 붙인
my-agent-memory스토어를 만들려면 다음을 실행하세요. 출력에는 스토어 이름과 별개의 생성 식별자인 스토어 ID가 포함됩니다:agentbricks memory stores create --name my-agent-memory항목을 추가하려면 다음 작업을 실행하며,
<store-id>를 이전 단계에서 사용한 스토어 ID로 대체하세요:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."스토어를 바인딩하고 에이전트를 배포하려면 다음을 실행하세요.
agentbricks memory bindagent.toml의 매장 이름을 교체하고,agentbricks deploy기존 매장을 이름으로 찾아 새 매장을 생성하지 않고 대신 사용합니다:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path는 저장소 내 해당 항목의 키이며, 컴퓨터에 있는 파일이 아닙니다.
--actor-id 는 메모리가 속한 사용자입니다. 배포된 에이전트는 로그인한 사용자의 이메일을 액터 ID로 사용하므로, 각 항목을 에이전트와 채팅하는 사용자의 이메일로 미리 채워 두세요.
에이전트 브릭스 CLI에서 memory bind와 agentbricks deploy는 이름으로 스토어를 가리킵니다. 단일 저장소에 작용하는 명령어(예: memory entries create)는 생성된 저장소 ID를 사용합니다.
에이전트에게 메모리 도구를 주세요
에이전트가 언제 저장하고 메모리를 호출할지 결정할 수 있도록 하기 위해, 클라이언트 작업을 도구로 감싸고 시스템 프롬프트에서 언제 사용할지 에이전트에게 지시합니다. 검증된 최종 사용자 신원을 기반으로 신뢰할 수 있는 애플리케이션 코드에서 actor_id를 설정하세요. 모델이 누구의 메모리를 읽거나 쓸지 선택하게 하지 마세요.
다음 예시는 Get started의 AgentKit SDK memory_store 를 OpenAI 에이전트 SDK용 도구로 포장하고 있습니다.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() 항목을 생성하거나, 이미 해당 경로에 있는 항목의 내용을 대체합니다. 대신 내용을 새 줄로 추가하려면 append=True를 전달하세요.
put()는 원자적이지 않기 때문에 같은 경로에 대한 동시 쓰기가 서로를 덮어쓸 수 있습니다.
list(path=...) 각 세션에서 해당 경로에 있는 항목을 반환하므로, forget_memory 세션별로 해당 경로에 저장된 항목도 삭제합니다.
같은 패턴이 Claude Agent SDK와 다른 프레임워크에서도 작동합니다: 저장소의 검색, 저장, 목록 조회, 삭제 작업을 프레임워크의 도구 유형으로 랩합니다.
같은 메모리 저장소에서 메모리 파이프라인도 실행하면, 파이프라인은 에이전트가 처리하는 각 액터에 대해 저장한 항목을 다시 쓰거나, 병합하거나, 분할하거나, 삭제할 수 있습니다.
파티션 및 보안 메모리
가게 안에서 actor_id로 각 기억이 누구의 것인지 구분합니다. 모든 목록과 검색은 단일 actor_id, 에 맞게 조정되므로, 에이전트가 기억해야 할 사항에 맞는 전략을 선택하세요:
-
각 사용자별 개인 메모리: 검증된 최종 사용자 신원으로 설정
actor_id. 각 사용자는 자신만의 파티션을 가지고 있으며, 에이전트는 해당 사용자의 항목만 호출합니다.- 예시: 지원 상담원은 한 사용자의 통신 선호도와 과거 티켓을 기억합니다.
-
그룹의 공유 메모리: 팀, 프로젝트, 조직 ID 등 원하는 고정 키로 설정
actor_id하세요. 모두가 같은 기억을 읽고 씁니다.- 예시: 팀 에이전트가 회사 용어와 내부 관례의 공유 용어집을 기억합니다.
-
다른 기준으로 분할한 메모리: 테넌트 ID나
actor_id복합체와 같은 자체 값을 사용해user:project를 빌드하세요.-
예시: 멀티 테넌트 앱은 각 고객의 사용자가 서로 격리되도록 설정
actor_id{tenant}:{user}합니다.
-
예시: 멀티 테넌트 앱은 각 고객의 사용자가 서로 격리되도록 설정
애플리케이션 코드에서 신뢰할 수 있는 호출자 컨텍스트를 사용해 actor_id를 설정하세요. 사용자별 메모리에는 검증된 최종 사용자 ID를, 공유 메모리에는 신뢰할 수 있는 팀 또는 프로젝트 키를 사용하세요. 모델이 선택하게 두지 마세요. 전략이 최종 사용자 ID에 의존하는 경우, 해당 ID가 없는 요청은 공유 actor_id로 대체하지 말고 거부하세요.
Warning
actor_id 기억을 분리하지만, 접근 제어는 아닙니다. 메모리 저장소는 작업 공간 범위가 지정되어 있어, 저장소에 도달할 수 있는 모든 주체가 모든 액터의 모든 항목을 읽고 쓸 수 있습니다. 가게가 보안 경계이지, 배우가 아니에요. 테넌트나 사용자 간 엄격한 격리를 위해 경계별로 별도의 메모리 저장소를 생성하세요.
에이전트의 서비스 프린시펄과 같은 다른 프린시펄이 스토어를 사용할 수 있게 하려면, 스토어의 grant-permission 연산(memory_store.grant_permission(principal_id) AgentKit SDK에서)으로 스토어에 접근을 부여하세요. 스토어의 생성자나 워크스페이스 관리자만 접근 권한을 부여할 수 있습니다. 권한 수준, 지원되는 연산 및 예제에 대해서는 에이전트 메모리 및 세션 저장소에 대한 권한 관리 문서를 참조하세요.
Limitations
- 에이전트 메모리는 장기 기억만 제공합니다. 단기 대화 기록은 에이전트 세션을 참조하세요.
- 검색은 관련 성에 따라 항목을 순위 매기며, 각 항목의 내용과 설명에 대해 전체 텍스트(BM25)와 의미 매칭을 결합합니다. 최대 100개의 항목을 반환하며 페이지 매김을 지원하지 않습니다.
- 출입 통제는 매장 단위에서 시행됩니다. 항목별 및 액터별 접근 제어는 제공되지 않습니다.
- 매장 출입 통제는 매장의 출입구를 포함합니다. 모든 작업 공간 사용자는 ID와 설명을 포함한 메모리 저장소를 목록화하고 조회할 수 있습니다.
- 상점을 만든 후에는 상점의 ID를 변경할 수 없습니다.
description업데이트만 가능합니다.