Important
이 기능은 베타 버전으로 제공됩니다.
관리형 에이전트 세션은 에이전트에게 지속 가능하고 프레임워크에 구애받지 않는 세션 상태를 저장할 수 있게 해줍니다: 즉, 에이전트나 프레임워크가 한 번의 상호작용에 대해 유지하는 상태를 의미합니다. 대개 이는 대화 이력, 즉 에이전트가 턴 시작 시 읽고 실행되는 동안 계속 추가하는 메시지, 도구 호출, 결과를 순서대로 기록한 대화록입니다. 또한 랭 그래프 그래프와 같이 프레임워크가 상호작용에 지속되는 다른 상태일 수도 있습니다. Azure Databricks는 Lakebase에 저장하고 저장 공간을 대신 관리하기 때문에 데이터베이스를 직접 구축하거나 운영하지 않습니다.
메모
미리보기 기간에는 세션을 저장하는 기본 Lakebase 인스턴스에 대한 요금이 청구됩니다. 관리 에이전트 세션 자체에 대해 추가 요금이 부과되지 않습니다. 가격은 미리보기 진행에 따라 변경될 수 있습니다.
관리 세션은 원하는 때 다음과 같이 사용하세요:
- 상담원의 대화 기록을 보존하여 재시작을 견디고 나중에 재개할 수 있도록 하세요.
- 후속 메시지에 대한 전체 맥락(도구 호출과 추론 포함)을 재구성하세요.
- 자체 UI에서 지난 대화를 나열하고, 다시 이어가고, 분기하세요.
관리되는 세션은 단일 상호작용 상태(단기 세션 중) 상태를 유지합니다. 대화 전반 에 걸쳐 지속되는 지속적이고 장기 기억을 위해서는 관리 에이전트 메모리를 사용하세요.
요구 사항
- AgentKit SDK를 사용하려면 Python 3.10 이상 버전을 설치하세요. AgentKit SDK는 아래 예시들이 사용하는 에이전트 API용 Databricks Python 클라이언트입니다. 또한 Python 요구사항 없이 어떤 언어에서든 REST API를 직접 호출할 수 있습니다.
관리 세션의 작동 원리
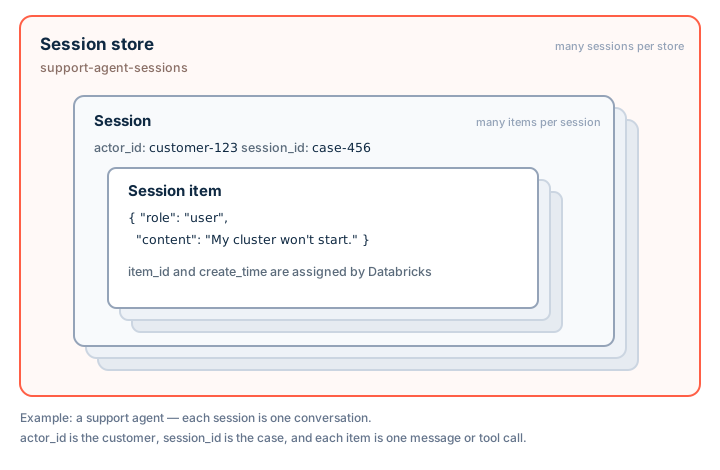
관리된 세션은 세 가지 수준으로 나뉩니다:
-
세션 스토어는 에이전트의 세션을 위한 작업 공간 범위가 지정된 컨테이너입니다. 저장소를 생성하면 백업 Lakebase 저장소가 자동으로 프로비저딩됩니다. 당신은 고유한
session_store_name작업 공간을 선택합니다. -
세션은 매장 내에서 지속되는 하나의 상호작용(일반적으로 대화 스레드)입니다. 세션은 다음과 같이 식별됩니다:
-
actor_id(필수): 세션이 누구에게 속하는지, 예를 들어 최종 사용자 또는 다른 에이전트. 한 주제의 모든 세션을 그룹화해서 함께 나열하고 필터링할 수 있습니다. 사용자별 앱을 만들 때는 사용자 ID(예: 앱 인증에서 확인된 최종 사용자 신원)로 설정actor_id하여 각 사용자의 세션이 그룹으로 유지되도록 하세요. 모델이나 사용자가 제공한 값은 절대 입력하지 말고, 신뢰할 수 있는 애플리케이션 컨텍스트에서 설정하세요. -
session_id(선택 사항): 상호작용을 위한 발신자 선택 ID. 이를 생략하면 서비스가 하나 생성합니다. -
parent_session_id(선택 사항): 분기된 대화를 나타내기 위해 세션을 분기된 원본 세션에 연결하는 데 사용됩니다.
-
-
세션 항목은 세션의 순서 히스토리 중 하나의 항목입니다. 각 항목은 메시지, 도구 호출, 도구 결과, 추론 블록과 같은 불투명한 JSON 호환
data값을 담고 있습니다. Azure Databricks는 각 항목에 anitem_id과 acreate_time를 할당하며, 그 내용을 검사하거나 검증하지 않습니다. 항목은 덧붙인 후에는 불변이 됩니다.
이 서비스는 세션의 항목에 대해 결정론적 순서를 유지하며, 세션 저장소에 대한 모든 작업을 승인합니다.
Get started
이 예시들은 지원 상담원을 위한 관리 세션을 설정합니다: 세션 저장소를 만들고, 한 대화의 세션을 시작하며, 대화의 순서를 추가한 뒤, 이후 요청에 대해 기록을 읽습니다. 프로젝트에 맞는 클라이언트를 선택하세요.
AgentKit SDK
AgentKit SDK는 패키지에 배포 databricks-agentbricks 된 Databricks Python 클라이언트로, 에이전트 API를 지원합니다. Databricks SDK로 인증합니다 WorkspaceClient.
AgentKit SDK 설치:
pip install databricks-agentbricks세션 저장소를 만들고 한 번의 대화를 위한 세션을 시작하세요.
actor_id는 대화가 속한 사람이며; 선택적session_id옵션은 이 대화를 고유하게 식별합니다:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")요원이 달리는 동안 대화의 순서를 덧붙이세요. 각 항목은 JSON 호환 값입니다:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
후속 요청이 있을 때, 세션을 다시 불러와서 전체 기록을 읽어 맥락을 재구성하세요:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
REST API
클라이언트는 /api/2.0/agents/session-stores 아래의 REST API를 호출합니다. Python 외의 언어에 대해 직접 호출하세요.
Databricks CLI로 OAuth 토큰을 생성하세요:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
에이전트를 위한 세션 스토어를 만드세요:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
한 번의 대화를 위한 세션을 시작하세요.
actor_id이 대화의 소유자가 누구인지;session_id이 대화를 고유하게 식별한다:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'에이전트가 실행되는 동안 대화 차례를 추가하세요:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
역사를 시간 순서대로 다시 읽어보며 맥락을 재구성하려 합니다:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
클라이언트는 또한 가장 최근 항목을 삭제하고, 세션의 항목을 삭제하며, 대화를 독립적인 복사본으로 포크하는 기능도 지원합니다(선택적으로 특정 항목까지). 자식 세션이 있는 세션을 삭제하려면 삭제를 그들로 연속 전달하는 강제 옵션이 필요합니다(예: session.delete(force=True)).
관리된 세션으로 에이전트 프레임워크의 세션을 백업하세요
OpenAI Agents SDK와 Claude Agent SDK와 같은 에이전트 프레임워크는 실행 시작 시 대화 기록을 읽고 종료 시 새 항목을 추가합니다. 세션 스토어는 그 패턴에 직접 매핑됩니다:
| 프레임워크 작동 | 세션 스토어 호출 |
|---|---|
| 역사 읽기 |
list_items 연대순으로 (order_by="create_time asc") |
| 턴 아이템 추가 |
append 새로운 아이템들 |
| 마지막 항목 되돌리기 |
pop 가장 최근 항목 |
| 스레드 지워 |
clear 세션 항목 |
범위 및 접근
관리형 세션은 세션의 항목을 불투명한 JSON 호환 값 형태로 저장합니다. 서비스는 에이전트나 프레임워크가 추가한 내용은 무엇이든 해석하지 않고 그대로 저장한 뒤 반환합니다. 런, 체크포인트, 승인과 같은 실행 제어 자원을 1등급 개념으로 추가하지는 않지만, 이러한 상태를 직렬화하는 프레임워크가 아이템으로 지속할 수 있습니다.
세션 스토어는 작업 공간 범위가 지정되어 있으며, 접근 권한은 스토어 수준에서 승인됩니다. and metadata 필드는 actor_id 그룹화와 필터링만 지원하며, 접근 권한을 부여하거나 제한하지 않습니다. 모델 또는 사용자가 제공한 값이 아니라 신뢰할 수 있는 애플리케이션 컨텍스트에서 actor_id를 설정하세요.
에이전트의 서비스 프린시펄과 같은 다른 프린시펄이 스토어를 사용할 수 있게 하려면, 스토어의 grant-permission 연산(session_store.grant_permission(principal_id) AgentKit SDK에서)으로 스토어에 접근을 부여하세요.
관리 세션과 관리 메모리 는 독립적입니다. 세션이나 세션 저장소를 삭제해도 메모리 저장소에 저장된 메모리는 삭제되지 않습니다.