Important
이 기능은 공개 미리보기 단계에 있습니다. 작업 영역 관리자는 미리 보기 페이지에서 이 기능에 대한 액세스를 제어할 수 있습니다. Azure Databricks 미리 보기 관리를 참조하세요.
액세스 제어
기능은 관리 가능한 Unity 카탈로그 개체입니다. 기능에 대한 액세스는 , CREATE FEATURE및 READ FEATURE Unity 카탈로그 권한에 의해 MANAGE제어됩니다. 자세한 내용은 Unity 카탈로그 권한 참조를 참조하세요.
-
CREATE FEATURE: 스키마에서 특징을 생성하는 데 필요합니다.create_feature및register_feature부모 스키마에 필요합니다CREATE FEATURE. 최소 권한 원칙에 따라 스키마 수준에서 부여CREATE FEATURE합니다. 카탈로그에 부여하여 해당 카탈로그의 모든 스키마에서 기능을 만들 수 있도록 허용할 수도 있습니다. -
READ FEATURE: 특징 메타데이터를 읽기 위해 필수입니다.get_featurecreate_training_set, , 그리고list_materialized_features특징에 대한 요구READ FEATURE사항. 이 권한은 소스 또는 물질화된 출력 테이블의 특징 데이터에 대한 접근을 허용하지 않습니다. 교육이나 봉사를 위해 데이터를 읽으려면, 해당 표에 포함SELECT되어야 합니다.READ FEATURE스키마 또는 카탈로그에 부여된 내용은 해당 스키마 또는 카탈로그에 포함된 모든 현재 및 미래의 기능에 적용됩니다. -
MANAGE: 기능의 수명 주기 및 보조금을 관리하는 데 필요합니다. 와 가 있는delete_feature특징을 삭제하고 로 된materialize_features특징을 물질화하려면 해당 특징에 대해 요구MANAGE합니다. Materializeddelete_materialized_featurefeature를 삭제하는 것은 : 에 의해MANAGE지배되지 않으며, 해당 Materialized Feature의 창작자만이 삭제할 수 있습니다.
모든 기능 작업에는 부모 카탈로그 및 USE CATALOG 부모 스키마에도 필요합니다USE SCHEMA. 구체화 방법 MANAGE 및 READ FEATURE 적용 방법은 사용 권한을 참조하세요.
기능 보기 API
Feature 생성자 및 register_feature()
권장되는 방법은 개체를 로컬로 Feature 생성하고 Unity 카탈로그에 유지하는 데 사용하는 register_feature 것입니다. 이 2단계 워크플로를 사용하면 기능을 등록하기 전에 기능(포함 create_training_set)을 실험할 수 있습니다.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() 는 Unity 카탈로그에서 로컬로 생성된 Feature 등록합니다.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() 단일 단계에서 Unity 카탈로그에서 기능의 유효성을 검사하고, 생성하고, 즉시 등록합니다. 이 기능은 먼저 로컬에서 실험할 필요가 없는 경우에 사용합니다.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, RequestSource, or FeatureViewSource
    function: Union[AggregationFunction, ColumnSelection, CustomUDF], # Required for all features
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for DeltaTableSource and StreamSource
    timeseries_column: Optional[str] = None,               # Required for DeltaTableSource and StreamSource
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
매개 변수:
-
source: 특징 계산에 사용되는 데이터 소스(DeltaTableSource, ,StreamSourceRequestSource, , 또는FeatureViewSource). -
function:AggregationFunction연산자와 시간 창ColumnSelection("column_name")을 묶어 패스스루 특징CustomUDF이나 행별 변환을 위한 값. 호환 가능한 소스 유형에 대해서는 지원 함수 를 참조하세요. -
catalog_name: 기능의 Unity 카탈로그 이름입니다. -
schema_name: 기능의 Unity 카탈로그 스키마 이름입니다. -
entity: 집계 또는 조회 키(기본 키)를 정의하는 열 이름 목록입니다.DeltaTableSource및StreamSource에 필요합니다. 예를 들어["user_id"]사용자별로 집계 또는 조회합니다. 와FeatureViewSource를RequestSource생략한다. -
timeseries_column: 시간 창 집계 또는 최신 값 선택에 사용되는 타임스탬프 열입니다.DeltaTableSource및StreamSource에 필요합니다. 와FeatureViewSource를RequestSource생략한다. -
name: 선택적 기능 이름입니다. 생략하면 입력 열, 함수 및 창에서 자동으로 생성됩니다(예:amount_avg_rolling_7d). -
description: 기능에 대한 선택적 설명입니다.
반환: 유효성이 검사된 기능 인스턴스
발생 시킵니다: 유효성 검사에 실패하는 경우 ValueError
delete_feature()
정규화된 이름으로 Unity 카탈로그에서 기능을 삭제합니다.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
기능을 삭제하기 전에 해당 기능을 참조하는 모델 또는 기능 사양을 제거하거나 업데이트합니다. 특징이 아직 구체화된 특징이 있는 한 삭제할 수 없습니다. 먼저 물질화된 특징을 삭제한 다음, 그 기능을 삭제하세요. 구체화된 기능을 삭제하는 방법을 참조하세요.
자동 생성된 이름
name 생략하면 이름이 자동으로 생성됩니다. 생성된 이름은 다음과 같은 패턴을 {column}_{function}_{window}따릅니다. 다음은 그 예입니다.
-
price_avg_rolling_1h(1시간 평균 가격) -
transaction_count_rolling_30d_1d(이벤트 타임스탬프에서 1d 지연이 있는 30일 트랜잭션 수)
지원되는 함수
집계 함수
| 기능 | Description | 예제 사용 사례 |
|---|---|---|
Sum(input="column") |
값의 합계 | 사용자별 일일 앱 사용량(분) |
Avg(input="column") |
값의 평균 | 평균 트랜잭션 금액 |
Count(input="column") |
레코드 수 | 사용자당 로그인 수 |
Min(input="column") |
최소값 | 웨어러블 디바이스에서 기록한 가장 낮은 심박수 |
Max(input="column") |
최대값 | 세션당 가장 높은 트랜잭션 양 |
StddevPop(input="column") |
모집단 표준 편차 | 모든 고객에 대한 일일 트랜잭션 금액 가변성 |
StddevSamp(input="column") |
샘플 표준 편차 | 광고 캠페인 클릭률의 가변성 |
VarPop(input="column") |
모집단 분산 | 팩터리에서 IoT 디바이스에 대한 센서 판독값 분산 |
VarSamp(input="column") |
샘플 분산 | 샘플링된 그룹에 대한 영화 등급 분산 |
ApproxCountDistinct(input="column", relativeSD=0.05) |
대략적인 고유 개수 | 구매한 항목의 고유 개수 |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
근사치 백분위수 | p95 응답 대기 시간 |
First(input="column") |
첫 번째 값 | 첫 번째 로그인 타임스탬프 |
Last(input="column") |
마지막 값 | 가장 최근 구매 금액 |
FirstN(input="column", n=3) |
첫 번째 n 값들을 배열로 보기 |
세션에서 처음 본 세 가지 제품 |
LastN(input="column", n=3) |
배열로서의 마지막 n 값들 |
최근 세 가지 지원 사례 상태 |
FirstDistinct(input="column", n=3) |
배열로서의 첫 번째 n 구별되는 값들 |
처음 세 가지 뚜렷한 제품 카테고리를 살펴보았습니다 |
LastDistinct(input="column", n=3) |
배열로서의 마지막 n 구별되는 값들 |
가장 최근에 등장한 세 가지 뚜렷한 상인 카테고리 |
메모
First, , Last, FirstNLastNFirstDistinct기본적으로 LastDistinct null 값을 포함합니다. null을 건너뛰려면 null인 filter_condition 입력 열을 명시적으로 제외하는 열을 추가합니다.
FirstN
LastN
FirstDistinct, 그리고 LastDistinct 특징을 timeseries_column 사용하여 입력 행을 정렬하고 최대 값을 n 포함하는 배열을 반환합니다. 매개변수는 n 양의 정수여야 합니다.
FirstN
FirstDistinct 그리고 가장 오래된 값부터 최신 값까지 선택합니다.
LastN
LastDistinct 그리고 가장 늦은 순서대로 값을 선택한 후, 선택한 값을 타임스탬프 순서대로 반환합니다.
FirstDistinct
LastDistinct 그리고 그 방향으로 값을 선택할 때 중복된 값을 제거하세요.
예를 들어, 엔터티의 소스 행이 로 정렬 event_time["A", "A", "B", "C", "B", "B"]되어 있으면 다음 함수들이 반환됩니다:
| 기능 | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN
LastN, , FirstDistinct, 그리고 LastDistinct 0.17.0 이상의 버전을 요구 databricks-feature-engineering 합니다.
커스텀UDF
CustomUDF각 행에 등록된 Unity 카탈로그 Python 사용자 정의 함수(UDF)를 적용합니다. 요청 입력을 변환하거나 특징 값을 결합하는 데 사용하세요. 행을 집계하거나 시간 창을 정의하지 않습니다.
CustomUDF(
    function_name="main.ecommerce.log_amount_udf",
    input_bindings={"amount": "transaction_amount"},
)
input_bindings 각 UDF 매개변수 이름을 입력에 매핑합니다. 에 대해 RequestSource입력은 소스 열 이름입니다. 에 대해서는 FeatureViewSource상류 특징 참조입니다. 모든 UDF 매개변수를 기본 매개변수까지 바인딩하세요. 입력 타입은 암묵적인 수치 캐스트가 없어야 UDF 파라미터 타입과 정확히 일치해야 합니다. 스칼라 입력과 반환 타입을 사용하세요.
| Source | 작동 방식 |
|---|---|
RequestSource |
학습 데이터프레임이나 추론 요청에서 열을 변환합니다. |
FeatureViewSource |
상류 특징 값을 결합합니다. FeatureViewSource를 참조하세요. |
델타 지원 CustomUDF 기능은 온라인으로 구현되거나 제공될 수 없습니다. 학습 및 서빙을 위해 테이블 기반 특징 값을 변환하려면, 델타 기반 집계 또는 열 선택 특징을 정의하고 이를 참조 FeatureViewSource하여 참조합니다.
CustomUDF 는 로 StreamSource지원되지 않습니다. 스트리밍 기능의 출력을 변환하려면 해당 기능을 로 FeatureViewSource참조하세요.
CustomUDF
RequestSource 필요 databricks-feature-engineering 버전 0.17.0 이상이어야 합니다.
를 사용하려면 CustomUDFUDF에 대한 권한, USE CATALOG 그 부모 카탈로그에 대한 권한, USE SCHEMA 그리고 부모 스키마에 대한 권한이 필요합니다EXECUTE.
다음 예시는 NumPy를 사용하여 대량 거래 금액의 규모를 줄이기 위해 계산 log(1 + amount)합니다. 서버리스 컴퓨트에서 커스텀 UDF 의존성을 활성화한 상태로 실행하세요. 도식이 main.ecommerce 존재해야 합니다.
spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.log_amount_udf(amount DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["numpy==1.26.4"]',
  environment_version = '5'
)
AS $$
import numpy as np

if amount is None or not np.isfinite(amount) or amount < 0:
    return None
return float(np.log1p(amount))
$$
""")
요청 열 transaction_amount 을 UDF 매개변수 amount에 바인딩하는 기능을 등록하세요:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    CustomUDF, FieldDefinition, RequestSource, ScalarDataType,
)

fe = FeatureEngineeringClient()

log_transaction_amount = fe.create_feature(
    source=RequestSource(
        schema=[
            FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        ]
    ),
    function=CustomUDF(
        function_name="main.ecommerce.log_amount_udf",
        input_bindings={"amount": "transaction_amount"},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="log_transaction_amount",
)
UDF는 ENVIRONMENT 오프라인 계산을 위한 의존성을 구성합니다. 온라인 서빙의 경우, 패키지 create_feature_spec(extra_pip_requirements=...) 를 또는 log_model(extra_pip_requirements=...). UDF에서 자동으로 복사되는 것은 아닙니다. 특징 서빙 의존 성과 모델 의존성을 참조하세요.
CustomUDF 기능을 구체화할 수 없습니다. 요청 지원 및 기능 지원 UDF는 교육과 서비스 중 주문형 진행됩니다. 종속 체인의 각 UDF는 계산을 더하므로 함수와 체인을 작게 유지하세요. UDF는 오프라인 또는 NaN 온라인일 수 None 있는 누락된 입력을 처리해야 합니다.
누락 값 처리에 대한 안내는 누 락 특징 값 처리 방법을 참조하세요.
ColumnSelection (통과 소리)
ColumnSelection 는 집계를 적용하지 않고 원본에서 단일 열을 선택합니다. 내부가 아닌 function매개 변수에 AggregationFunction 직접 래핑됩니다. 반환 형식은 원본 스키마에서 유추됩니다.
| 기능 | Description | 예제 사용 사례 |
|---|---|---|
ColumnSelection("col") |
열의 최신 값(집계 없음) | 가장 최근의 공급업체 범주, 요청 필드의 통과 |
ColumnSelection 다음 데이터 소스를 지원합니다:
-
DeltaTableSource: 지정 시간 조인을 통해 엔터티 키당 최신 값을 반환합니다(조회 창 집계 없음). -
StreamSource: 스트림에서 엔터티별 키별 최신 값을 반환합니다(룩백 윈도우 집계 없음). -
RequestSource: 유추 시간에 제공되거나 학습 시 레이블이 지정된 DataFrame에서 추출된 값을 전달합니다.
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
예: 집계 및 열 선택 기능
다음 예제에서는 동일한 데이터 원본에 대해 정의된 기능을 보여줍니다.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
필터 조건이 있는 기능
이 filter_condition 매개 변수를 사용하면 집계를 계산 하기 전에 원본 테이블의 행을 필터링할 수 있습니다. 이 함수는 데이터를 그룹화하고 집계하기 전에 적용되는 SQL WHERE 절로 작동합니다.
메모
filter_condition는 이전에 적용WHERE된 SQL GROUP BY 절처럼 집계 전에 행을 필터링합니다. 기능 정의에서 항상 정의 entity 되는 세분성은 변경되지 않습니다.
필터는 기능 계산에 필요한 데이터의 상위 집합을 포함하는 큰 원본 테이블로 작업할 때 유용하며 이러한 테이블 위에 별도의 뷰를 만들 필요가 최소화됩니다.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
데이터 원본
DeltaTableSource
DeltaTableSource는 원본 테이블에서 기능을 계산하는 방법을 정의하는 데 사용되는 임시 Python 개체입니다. 새 테이블을 만들지 않습니다. 데이터를 읽고 기능을 집계하기 위한 구성을 지정합니다.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
매개 변수:
-
catalog_name,schema_nametable_name: Unity 카탈로그에서 원본 델타 테이블을 식별합니다. -
filter_condition: 집계 전에 적용된 SQLWHERE절입니다. 예:"status = 'completed'". -
transformation_sql: 원본 테이블에 적용되는 SQLSELECT식입니다. 집계 전에 열, 캐스트 형식 또는 컴퓨팅 파생 열의 이름을 바꾸는 데 사용합니다. 생략하면 모든 열이 선택됩니다(*). 예:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: 변환 후 Spark StructType JSON 형식(원본df.schema.json())의 결과 DataFrame 스키마입니다. 가 제공된 경우transformation_sql필요합니다. 이렇게 하면 변환으로 인해 발생하는 열 이름과 형식이 시스템에 표시됩니다. -
lateness:SourceLateness사건 시간 내에 소스가 보통 완성되는 데 걸리는 시간을 설명하는 객체입니다. 생략되면 소스는 즉시 완전하다고 간주됩니다.
둘 다 filter_conditiontransformation_sql 설정되면 결과 쿼리는 다음과 SELECT {transformation_sql} FROM {table} WHERE {filter_condition}같습니다.
SourceLateness.settling_delay 온라인 물질화에 영향을 미치는 일관된 ETL 지연을 훈련 중에 시뮬레이션하는 권장 방법입니다. Azure Databricks는 자격 있는 교육 평가 시간을 이 기간만큼 뒤로 이동시켜 교육 예제가 온라인 전송 중일 데이터를 사용하지 않도록 합니다. 물질화 기간 동안 Azure Databricks는 완료된 창을 게시하기 전에 같은 기간을 기다렸으며, 그 사이에 마지막 완료된 창을 서비스합니다.
예를 들어, 일일 ETL 작업이 자정 8시간 후에 완료된다고 가정해 봅시다. 자정이 07:00 UTC에 해당하는 현지 시간대에서 말이죠. 정착 지연 8시간과 창 오프셋을 7시간으로 설정하세요:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
메모
는 timeseries_column 반드시 타입 TimestampType 또는 TimestampNTZType이어야 합니다.
DateType 는 시계열에 지원되지 않습니다; 열을 첫 번째로 TimestampType 캐스팅합니다(예: 와 함께 transformation_sql).
예제: 열 변환에 사용 transformation_sql
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
예: PySpark DataFrame에서 파생 transformation_sql 및 dataframe_schema 파생
변환을 PySpark 쿼리로 작성한 다음 결과 DataFrame에서 스키마를 추출할 수 있습니다.
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
지원되는 transformation_sql 표현
와 에 DeltaTableSourceStreamSource대한 동일한 규칙이 transformation_sql 적용됩니다.
transformation_sql 모든 행별 표현식을 지원합니다; 각 행에 대해 독립적으로 평가되는 연산들. 이들은 행 수나 소스와의 일대일 대응을 변경하지 않습니다. 행별 표현식에는 열 이름 변경, 캐스트, 산술 연산 등이 포함됩니다.
형태나 행 수를 바꾸는 연산은 지원되지 않으며, 예를 들어 집계(예: SUM()COUNT())는 지원되지 않습니다. 대신 기능 정의에 사용합니다 AggregationFunction .
DeltaTableSource.from_sql()
편의를 위해 SQL 쿼리에서 만들 DeltaTableSource 수 있습니다. 이 메서드는 쿼리를 구문 분석하여 테이블 이름을 transformation_sql자동으로 추출합니다 filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
간단한 SELECT ... FROM ... [WHERE ...] 쿼리만 지원됩니다. 복합 SQL(JOIN, 하위 쿼리, CTE, UNION)이 거부됩니다. 복잡한 쿼리의 경우 다음을 사용하여 직접 DeltaTableSource 생성 transformation_sql 합니다filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
다음을 사용하여 반복 to_dataframe()
기능 계산에 사용할 데이터를 미리 보는 데 사용합니다 source.to_dataframe() . 이는 예상된 결과를 생성할 때까지 반복하는 filter_conditiontransformation_sql 데 유용합니다.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
엔터티 이해
엔터티 열은 기능에 대한 집계 수준을 정의합니다. 정의에는 Feature 지정되지 않고 .DeltaTableSource 엔터티는 다음을 결정합니다.
-
데이터 그룹화 방법: 기능은 엔터티 값의 고유한 조합별로 집계됩니다(SQL과 유사
GROUP BY). - 기본 키 구조: 각 고유 엔터티 조합은 계산된 기능의 한 행을 생성합니다.
예: 고객 수준 기능
다음 코드는 고객 수준에서 기능을 집계합니다(고객당 한 행).
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
예: 고객 스토어 수준 기능
더 자세한 수준(고객 저장소 조합당 하나의 행)에서 기능을 집계하려면 여러 엔터티 열을 사용합니다.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
다양한 집계 수준(예: 고객 수준 및 고객 저장소 수준)의 기능이 필요한 경우 기능 정의에서 다른 entity 값을 사용합니다. 엔터티 구성이 서로 다른 기능 간에 동일한 DeltaTableSource 것을 공유할 수 있습니다.
StreamSource
StreamSource 는 Stream을 참조합니다. Stream에는 스트리밍 원본에 대한 연결, 인증, 스키마 및 수집 구성이 포함됩니다. Kafka의 경우 기능 정의의 열 참조 앞에 읽거나 읽을 메시지의 일부를 나타내야 합니다 value.key. .
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
매개 변수:
-
full_name: 스트림의 전체 세 부분으로 구성된 이름입니다(예:"my_catalog.my_schema.my_stream"). -
filter_condition(선택 사항): 점 접두사 열 참조(예WHERE: )를 사용하여 집계 전에 데이터를 스트리밍하는 데 적용되는 SQL"value.event_type = 'purchase'"절입니다. -
transformation_sql(선택): 집계나 열 선택 전에 적용되는 SQLSELECT표현식으로, 그리고value와 구조체에key점이 접두사가 붙은 참조를 사용합니다. 와 동일한 행별 표현DeltaTableSource식을 지원합니다. 생략하면 소스는 모든 열(*)을 사용합니다. -
dataframe_schema: 투영된 출력의 SparkStructTypeJSON 스키마입니다. 설정하면transformation_sql필수입니다. -
lateness:SourceLateness스트림이 이벤트 시간에 대해 보통 완성되는 데 걸리는 시간을 설명하는 객체입니다.SourceLateness.settling_delay을(를) 참조하세요.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Stream의 인제스팅 테이블에 대해 투영을 실행하여 와 구조체를 노출 keyvalue 시켜 도출합니다dataframe_schema.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource 는 미리 구체화된 테이블에서 조회하지 않고 요청 페이로드에서 유추 시간에 제공되는 데이터에 대한 스키마를 정의합니다. 학습 중에 이러한 열은 전달된 레이블이 지정된 DataFrame에서 추출됩니다 create_training_set. 모델을 제공하는 동안 호출자는 HTTP 요청 페이로드에 포함해야 합니다.
RequestSource
CustomUDF 또는 ColumnSelection 기능 뷰 기능과 함께 사용할 수 있습니다. 집계 함수 또는 시간 창은 지원하지 않습니다.
스키마 정의
스키마를 각각 열 이름과 FieldDefinition다음을 지정하는 개체 목록 ScalarDataType 으로 정의합니다.
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
지원되는 데이터 형식
RequestSource는 다음ScalarDataTypeINTEGERFLOATBOOLEANSTRINGDOUBLELONGTIMESTAMPDATE에서 정의된 SHORT스칼라 형식을 지원합니다. 배열, 맵 및 구조체와 같은 복합 형식은 지원되지 않습니다.
요청 데이터의 수화 방법
| 컨텍스트 | 작동 방식 |
|---|---|
교육 (create_training_set) |
열은 레이블이 지정된 DataFrame에서 추출됩니다. 형식은 선언된 스키마에 대해 유효성을 검사합니다. 불일치는 오류를 발생합니다(암시적 캐스팅 없음). |
| 서비스 (모델 엔드포인트) | 열은 HTTP 요청에서 또는 dataframe_records HTTP 요청에서 dataframe_split 가져옵니다. JSON 값은 선언된 형식(예: JSON 번호 → DOUBLE)으로 캐스팅됩니다. |
모델 서명
기능을 log_model 포함하는 RequestSource 학습 집합을 사용하여 RequestSource 모델을 기록하면 필요한 입력으로 MLflow 모델 서명에 열이 추가됩니다. 즉, 서비스 엔드포인트의 API 스키마는 호출자가 유추 시간에 제공해야 하는 필드를 반영합니다.
FeatureViewSource
FeatureViewSource 다른 특징 뷰의 출력을 입력으로 CustomUDF사용합니다. 특징 체인은 방향 비순환 그래프(DAG)를 생성합니다. 예를 들어, 마진 기능은 수익과 비용 집계를 결합할 수 있고, 또 다른 기능은 마진을 변환할 수 있습니다.
.0.18.0 버전 이상FeatureViewSource을 사용 databricks-feature-engineering 하세요.
객체 features리스트 Feature 를 에 전달하세요. 특징명 문자열이 아닙니다. 등록된 특징을 .로 get_feature검색하세요. 에서 input_bindings각 등록된 특징의 full_name. 로컬 미등록 기능이라면 대신 그 name 기능을 사용하세요.
다음 예시는 두 개의 등록된 특징 revenue_sum_7d 와 cost_sum_7d를 가정하는데, 이 특징들은 시 customer_id 점 계산에 대해 event_time 값을 반환 DOUBLE 합니다:
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import CustomUDF, FeatureViewSource

fe = FeatureEngineeringClient()
revenue = fe.get_feature(full_name="main.ecommerce.revenue_sum_7d")
cost = fe.get_feature(full_name="main.ecommerce.cost_sum_7d")

spark.sql("""
CREATE OR REPLACE FUNCTION main.ecommerce.margin_udf(revenue DOUBLE, cost DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import math

if revenue is None or cost is None:
    return None
if not math.isfinite(revenue) or not math.isfinite(cost) or revenue <= 0:
    return None
return (revenue - cost) / revenue
$$
""")

margin = fe.create_feature(
    source=FeatureViewSource(features=[revenue, cost]),
    function=CustomUDF(
        function_name="main.ecommerce.margin_udf",
        input_bindings={"revenue": revenue.full_name, "cost": cost.full_name},
    ),
    catalog_name="main",
    schema_name="ecommerce",
    name="margin",
)
다음 제한 사항이 적용됩니다.
- 함수로만
CustomUDF지원됩니다. 상류 기능은 집계, 열 선택 또는 기타CustomUDF기능일 수 있습니다. - 생략
entity및timeseries_column파생 특징에 대한 설명. 각 업스트림 기능은 고유한 엔티티, 타임스탬프, 윈도우 정의를 유지합니다. - 특징은 한 가지 출처를 가집니다. 요청 값과 테이블 기반 기능을 결합하려면 기능을 정의
RequestSource하고 두 기능을 모두 참조하세요FeatureViewSource. - 선언된 모든 상류 특징은 반드시 에서
input_bindings사용해야 합니다. 자전거 타는 것은 허용되지 않습니다. - 파생 특징을 등록하기 전에 상류 특징을 등록하세요. 국소적이고 등록되지 않은 그래프는 실험에 사용할 수 있습니다
create_training_set. - 훈련이나 서빙을 위해서는 파생 특징과 그 전이적 상류 특징에 대한 OR
MANAGE권한이 필요합니다READ FEATURE. 카탈로그나 스키마 간에도, 등록과 서비스에 대해 그래프 전반에 걸쳐 서로 다른 특징 이름을 사용하세요. - 한 특징은 최대 20개의 직접 상류 특징을 참조할 수 있습니다. 등록된 그래프는 기본 기능을 포함해 의존성 경로를 따라 최대 5개의 깊이를 지원합니다.
-
FeatureViewSource특징은 로 물질화하거나 평가할compute_features수 없다. 오프라인에서 평가하는 데 사용create_training_set하세요. 온라인 서빙의 경우, 지원되는 테이블 기반 업스트림 기능을 구체화하세요.
의존성 평가 및 출력 선택에 대해서는 FeatureViewSource 특징으로 학습하기를 참조하세요. 배포에 대해서는 Serve 파생 기능을 참조하세요.
학습 및 유추 API
create_training_set 및 score_batch 원본 데이터에서 요청 시 지정 시간 올바른 기능 값을 계산합니다. 델타 테이블 원본의 슬라이딩 윈도우 집계와 같이 오프라인 구체화를 지원하는 기능의 경우 먼저 오프라인 저장소로 기능을 구체화하면 두 작업의 성능이 향상됩니다. 구체화된 오프라인 기능을 사용할 수 있는 경우 작업은 원본에서 기능 값을 다시 계산하는 대신 미리 계산된 오프라인 데이터를 읽습니다. 오프라인 저장소에 기능을 구체화하려면 기능 뷰 구체화 를 참조하세요.
create_training_set()
특정 시점의 올바른 기능 계산을 사용하여 학습 데이터 세트를 만듭니다. 자세한 내용은 기능 보기를 사용하여 모델 학습을 참조하세요.
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
유추 중에 계보 추적 및 자동 기능 조회를 위한 기능 메타데이터를 사용하여 모델을 기록합니다. 자세한 내용은 기능 보기를 사용하여 모델 학습을 참조하세요.
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
자동 기능 조회를 사용하여 오프라인 일괄 처리 유추를 수행합니다. 모델과 함께 저장된 기능 메타데이터를 사용하여 특정 시점의 올바른 기능을 계산하여 학습과의 일관성을 보장합니다.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
입력 DataFrame은 학습 중에 사용되는 엔터티 및 타임스레터리 열을 포함해야 합니다. 기능은 원본 데이터에서 자동으로 계산됩니다.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
기간
Feature View는 시간 창 기반 집계의 룩백 동작을 제어하기 위해 네 가지 창 유형을 지원합니다. 사용 가능한 창 유형은 기능의 소스에 따라 다릅니다: 스트리밍 소스 기능은 롤링 윈도우와 톱슬투스 윈도우를 사용할 수 있고, 배치 소스 기능은 롤링, 텀블링, 슬라이딩 윈도우를 사용할 수 있습니다.
- 롤링 창은 이벤트 시간에서 되돌아봅니다. 기간 및 지연은 명시적으로 정의됩니다.
- 텀블링 창은 고정되고 겹치지 않는 시간 창입니다. 각 데이터 포인트는 정확히 하나의 창에 속합니다.
- 슬라이딩 윈도우는 구성 가능한 슬라이드 간격으로 겹치는 회전형 시간 창입니다.
- Sawtooth 창은 하이브리드 배치와 스트리밍 경로를 사용하여 스트리밍 소스에 대한 긴 룩백 윈도우를 신선하게 유지합니다. 톱니 창문을 보세요.
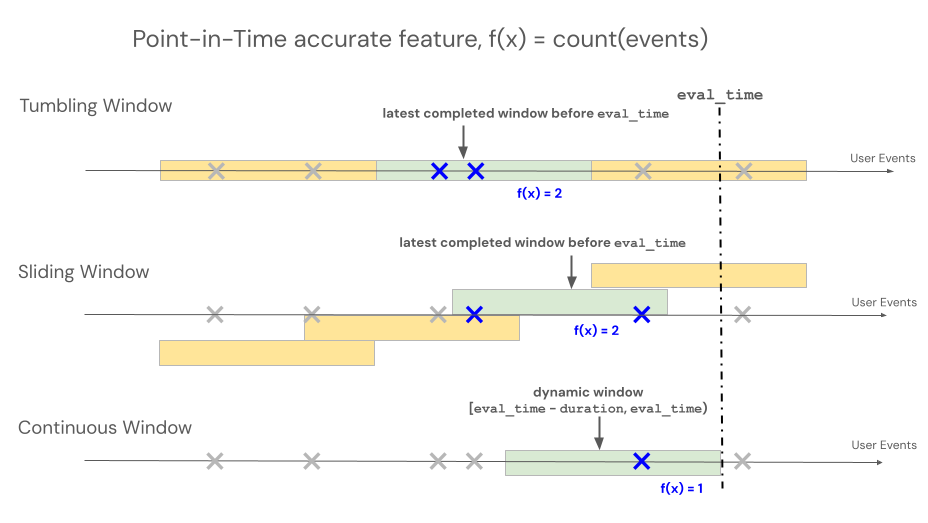
다음 그림은 회전, 슬라이딩, 롤링, 톱니파 창문 유형을 보여줍니다.
시간 창 타이밍
이전 분석 시점의 창을 평가하는 데 사용 delay 하세요. 예를 들어, 7일 지연이 있는 30일 창은 평가 시간 1주일 전 기준 30일 값을 계산합니다.
delay 는 소스 도착 시간과 독립적입니다. 원본 데이터가 도착하는 데 걸리는 시간을 모델링하려면 대신 구성을 SourceLateness.settling_delay 하세요.
두 가지 상황이 모두 있을 때 그들은 작곡합니다. Azure Databricks는 소스 정산 지연 후 창을 완료된 것으로 간주하고 분석적 지연을 사용하여 이를 평가합니다.
고정된 창 경계의 정렬을 변경하는 데 사용됩니다 offset . 기본적으로 텀블링 윈도우와 슬라이딩 윈도우는 자정 UTC에 맞춰져 있습니다. 예를 들어, 22시간의 오프셋은 일일 경계를 22:00 UTC에 맞추는 것입니다. 현지 시간대의 경계를 근사하려면 UTC에 대해 정적 오프셋을 설정하세요. 오프셋은 일광 절약 시간을 조정하거나 평가 시간을 이동시키거나 늦게 도착한 데이터를 모델링하지 않습니다.
다음 표는 이 필드들에 대한 지원 범위를 요약합니다:
| Field | 지원되는 윈도우 | 제약 조건 |
|---|---|---|
delay |
구르고, 구르고, 미끄러지다 | 음수가 아니어야 합니다 datetime.timedelta |
offset |
구르고 미끄러지다 | 음수가 아니어야 하며 마침표보다 짧아야 합니다* |
SourceLateness.settling_delay |
롤링, 텀블링, 슬라이딩 기능 | 음수가 아니어야 합니다 datetime.timedelta |
start_time |
구르고, 구르고, 미끄러지다 | 분명 datetime.datetime |
*마침표: 텀블링 윈도우의 경우 오프셋은 보다 짧 window_duration아야 합니다. 슬라이딩 윈도우의 경우, 보다 짧 slide_duration아야 합니다.
시작 시간
특징이 출력을 방출할 수 있는 가장 이른 이벤트-시간 경계를 UTC에서 설정하는 데 사용 start_time 하세요. 경계는 포괄적입니다.
start_time 게이트 출력. 창이 읽을 수 있는 과거 소스 행을 제한하지 않으며, 창 정렬도 변경하지 않습니다.
start_time 만약 가 두 정렬된 경계 사이에 위치한다면, 첫 번째 적격 고정 창 출력이 다음 경계가 됩니다.
를 사용하면 start_time고정 지속 시간의 창은 소스에서 완전한 창 시간이 지나기 전에 방출할 수 있습니다. 이 초기 출력물들은 이용 가능한 소스 히력을 사용합니다. 예를 들어, 2024년 1월 1일에 데이터가 시작되는 소스에 대해 1년 window_duration 과 1일 slide_duration의 슬라이딩 윈도우를 고려해 보십시오:
- 가 없으면
start_time1년 창이 완전히 형성되면 2025년 1월 1일에 처음으로 공개됩니다. -
start_time2024년 8월 21일로 예정되어 있으며, 이 특집은 2024년 8월 21일에 처음 공개됩니다. 이 결과물은 2024년 1월 1일부터 현재까지 이용 가능한 소스 역사만을 다룹니다. 창은 2025년 1월 1일에 1년의 전체 기간을 맞이하며, 그때부터 완전한 출력물을 생산합니다.
창 정렬을 변경하지 않으므로 start_time , 정렬된 두 경계 사이의 값을 생성하지 않습니다. 자정 UTC에 일일 경계가 있는 텀블링 윈도우의 경우, 06:00 UTC의 A start_time 는 다음 자정 경계에서 먼저 방출됩니다. 정확히 어떤 경계에 착지한 A start_time 는 그 경계에서 방출되는데, 그 경계는 포괄적이기 때문이다.
가 설정되지 않은 경우 start_time , 턴블링 윈도우와 고정 지속 시간 슬라이딩 윈도우는 완전한 윈도우가 형성된 후 정렬된 경계에서 먼저 방출됩니다. Lifetime 슬라이딩 윈도우와 롤링 윈도우는 자격 있는 소스 데이터가 존재하는 즉시 출력됩니다.
메모
start_time 롤링, 텀블링, 슬라이딩 윈도우와 함께 사용하는 DeltaTableSource 배치 기능에 지원됩니다. 또는 로 StreamSourceSawtoothWindow지원되지 않습니다.
다음은 그 예입니다.
from datetime import datetime, timedelta
from databricks.feature_engineering.entities import SlidingWindow

window = SlidingWindow(
    window_duration=timedelta(days=365),
    slide_duration=timedelta(days=1),
    start_time=datetime(2024, 8, 21),
)
롤링 윈도우
메모
RollingWindow 은 이전에 이름이 지정되었습니다 ContinuousWindow. 이전 SDK 버전에서 마이그레이션하는 경우 그에 따라 가져오기를 업데이트합니다.
롤링 창은 up-to-date 및 실시간 집계이며 일반적으로 스트리밍 데이터에 사용됩니다. 스트리밍 파이프라인에서 롤링 창은 이벤트가 들어오거나 나가는 경우와 같이 고정 길이 창의 내용이 변경되는 경우에만 새 행을 내보낸다. 학습 파이프라인에서 롤링 창 기능을 사용하는 경우 특정 이벤트의 타임스탬프 바로 앞에 있는 고정 길이 기간 기간을 사용하여 원본 데이터에 대해 정확한 지정 시간 기능 계산이 수행됩니다. 이렇게 하면 온라인 오프라인 오차 또는 데이터 유출을 방지할 수 있습니다. [T - duration, T)에서 이벤트를 집계할 때 T 의 기능입니다.
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
다음 표에서는 롤링 창에 대한 매개 변수를 나열합니다. 창 시작 및 종료 시간은 다음과 같은 매개 변수를 기반으로 합니다.
- 시작 시간:
evaluation_time - window_duration - delay(포함) - 종료 시간:
evaluation_time - delay(전용)
| 매개 변수 | Constraints |
|---|---|
delay(선택 사항) |
0≥ 틀림없어. 분석 창을 평가 타임스탬프에서 뒤로 이동시킵니다. 스트림 내 소스 도착 지연의 일관된 기준선을 모델링하는 데 사용 SourceLateness.settling_delay 하세요. |
window_duration |
> 0이어야 합니다. |
start_time(선택 사항) |
특징이 출력을 내놓을 수 있는 가장 이른 이벤트 시간 경계입니다. |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
아래 코드를 사용하여 지연된 롤링 창을 정의합니다.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
롤링 창 예제
window_duration=timedelta(days=7): 현재 평가 시간에 끝나는 7일의 조회 창을 만듭니다. 7일의 오후 2:00 이벤트의 경우 0일 오후 2:00부터 7일 오후 2:00까지, 7일 오후 2:00을 제외한 모든 이벤트가 포함됩니다.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): 평가 시간 30분 전에 끝나는 1시간 조회 창을 만듭니다. 오후 3시 이벤트인 경우 오후 1시 30분부터 오후 2시 30분까지의 모든 이벤트가 포함됩니다.
최신 값의 신선도를 바인딩하는 데 사용 Last 하세요
최신 값이 제한된 시간만 유효할 때와 RollingWindow 결합 Last 하세요. 평가 시점에 특징은 이 구간 내 가장 늦은 타임스탬프를 가진 행의 값을 반환합니다:
[evaluation_time - delay - window_duration, evaluation_time - delay)
구간의 최신 행에 null 값이 있으면 특징은 null을 반환합니다. null 입력 값을 제외하고 싶다면, 소스에서 a filter_condition 를 설정하세요.
이 조합은 와 ColumnSelection다릅니다.
ColumnSelection 나이에 따라 만료되지 않고 가장 최근에 관찰된 비-null 값을 반환합니다.
배치 기능의 경우, 이 조합은 온라인 전용 특별 물질화 모드를 제공합니다. 이 장치는 오직 DeltaTableSource, Last, RollingWindow, TableTrigger그리고 . 만을 지원합니다. 신 선도 한계 최신 가치 물질화(Materialize)를 참조하세요.
연속 창
고정 창을 사용하여 정의된 기능을 집계하는 경우, 집계는 미리 결정된 고정 길이의 창을 통해 계산되며, 슬라이드 간격으로 진행되어 시간을 완전히 분할하는 겹치지 않는 창을 생성합니다. 결과적으로 원본의 각 이벤트는 정확히 하나의 창에 기여합니다. 특정 시간t에서 기능은 t (배타적으로) 또는 그 이전에 끝나는 창의 데이터를 집계합니다. Windows는 Unix Epoch에서 시작합니다.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
다음 표에서는 텀블링 윈도우에 대한 매개 변수를 나열합니다.
| 매개 변수 | Constraints |
|---|---|
window_duration |
> 0이어야 합니다. |
delay(선택 사항) |
0≥ 틀림없어. 분석 창을 평가 타임스탬프에서 뒤로 이동시킵니다. |
offset(선택 사항) |
≥ 0이어야 하고 보다 짧 window_duration아야 합니다. 자정 UTC에서 경계 창을 이동시킵니다. |
start_time(선택 사항) |
특징이 출력을 내놓을 수 있는 가장 이른 이벤트 시간 경계입니다. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
구르는 창 예제
-
window_duration=timedelta(days=5): 사전에 설정된 고정된 길이의 시간 창이 각각 5일로 만들어집니다. 예: 창 #1은 0일에서 4일차까지, 창 #2는 5일차부터 9일차까지, 창 #3은 10일차부터 14일차까지입니다. 특히 Window #1에는 0일차의00:00:00.00부터 5일째의00:00:00.00이전의 타임스탬프가 있는 모든 이벤트가 포함됩니다. 각 이벤트는 정확히 하나의 창에 속합니다.
슬라이딩 윈도우
슬라이딩 윈도우를 사용해 정의된 특징의 경우, 슬라이드 구간만큼 진행되는 윈도우 위에서 집계가 계산됩니다. 슬라이딩 윈도우는 고정된 지속 시간과 평생 지속 시간 중 하나를 가질 수 있습니다. 고정 지속 시간 창은 겹치기 때문에 각 소스 이벤트가 여러 창에 대한 기능 집계에 기여할 수 있습니다. 생애 창은 창이 끝나기 전의 모든 소스 이벤트를 포함합니다. 특정 시간t에서 기능은 t (배타적으로) 또는 그 이전에 끝나는 창의 데이터를 집계합니다. Windows는 Unix 시대에 맞춰져 있습니다.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
    start_time: Optional[datetime.datetime] = None
다음 표에서는 슬라이딩 윈도우에 대한 매개 변수를 나열합니다.
| 매개 변수 | Constraints |
|---|---|
window_duration |
고정 기간 창은 양성이어야 합니다. 평생 창으로 설정 None 해두세요. |
slide_duration |
양수여야 합니다. 고정 지속 시간의 창이라면, 이 창은 보다 짧 window_duration아야 한다. |
delay(선택 사항) |
0≥ 틀림없어. 분석 창을 평가 타임스탬프에서 뒤로 이동시킵니다. |
offset(선택 사항) |
≥ 0이어야 하고 보다 짧 slide_duration아야 합니다. 자정 UTC에서 경계 창을 이동시킵니다. |
start_time(선택 사항) |
특징이 출력을 내놓을 수 있는 가장 이른 이벤트 시간 경계입니다. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
슬라이딩 윈도우 예제
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): 겹치는 5일 창을 만들어 매번 1일씩 진행합니다. 예: 창 #1은 0일차부터 4일차까지, 창 #2는 1일차부터 5일차까지, 창 #3은 2일차부터 6일차까지입니다. 각 창에는 시작 날짜부터00:00:00.00종료일(포함 안 됨)00:00:00.00까지의 이벤트가 포함됩니다. 창이 겹치므로 단일 이벤트가 여러 창에 속할 수 있습니다(이 예제에서는 각 이벤트가 최대 5개의 서로 다른 창에 속).
평생 창
평생 창을 생성하도록 설정 window_duration=None 하세요. 각 슬라이드 경계에서 이 기능은 해당 엔터티의 모든 소스 이벤트를 그 경계보다 앞선 타임스탬프를 집계합니다. 예를 들어, 하루짜리 슬라이드는 하루에 한 번 누적 값을 생성합니다.
생애 창은 오직 SlidingWindow.
RollingWindow그리고 유한window_duration한 를 요구한다TumblingWindow.
메모
Lifetime Windows는 Workspace 활성화를 지원하는 window_duration=None 클라이언트 버전이 databricks-feature-engineering 필요합니다. 이전 클라이언트 버전은 이 문법을 지원하지 않습니다.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
톱니 창문
Important
SawtoothWindow 베타 버전입니다.
톱니파 창은 최근 사건에 대한 매우 신선한 업데이트를 지원하며, 과거 데이터의 일일 압축을 지원하는 집계 시스템입니다. 그 뒤쪽(오래된 쪽) 가장자리는 고정된 일일 단계로 진행되고, 앞쪽(최근) 가장자리는 최신 사건과 함께 유지되므로, 유효 창 길이는 매일 동안 '톱질'됩니다. 대부분의 창은 스트림의 인제스팅 테이블 내 데이터에서 제공되며, 라이브 스트림에서 가장 최근 이틀만 제공됩니다. 이는 장기 기간(수년으로 확장)을 효율적으로 계산하면서도 최신 업데이트에 신속하게 대응할 수 있는 타협안입니다.
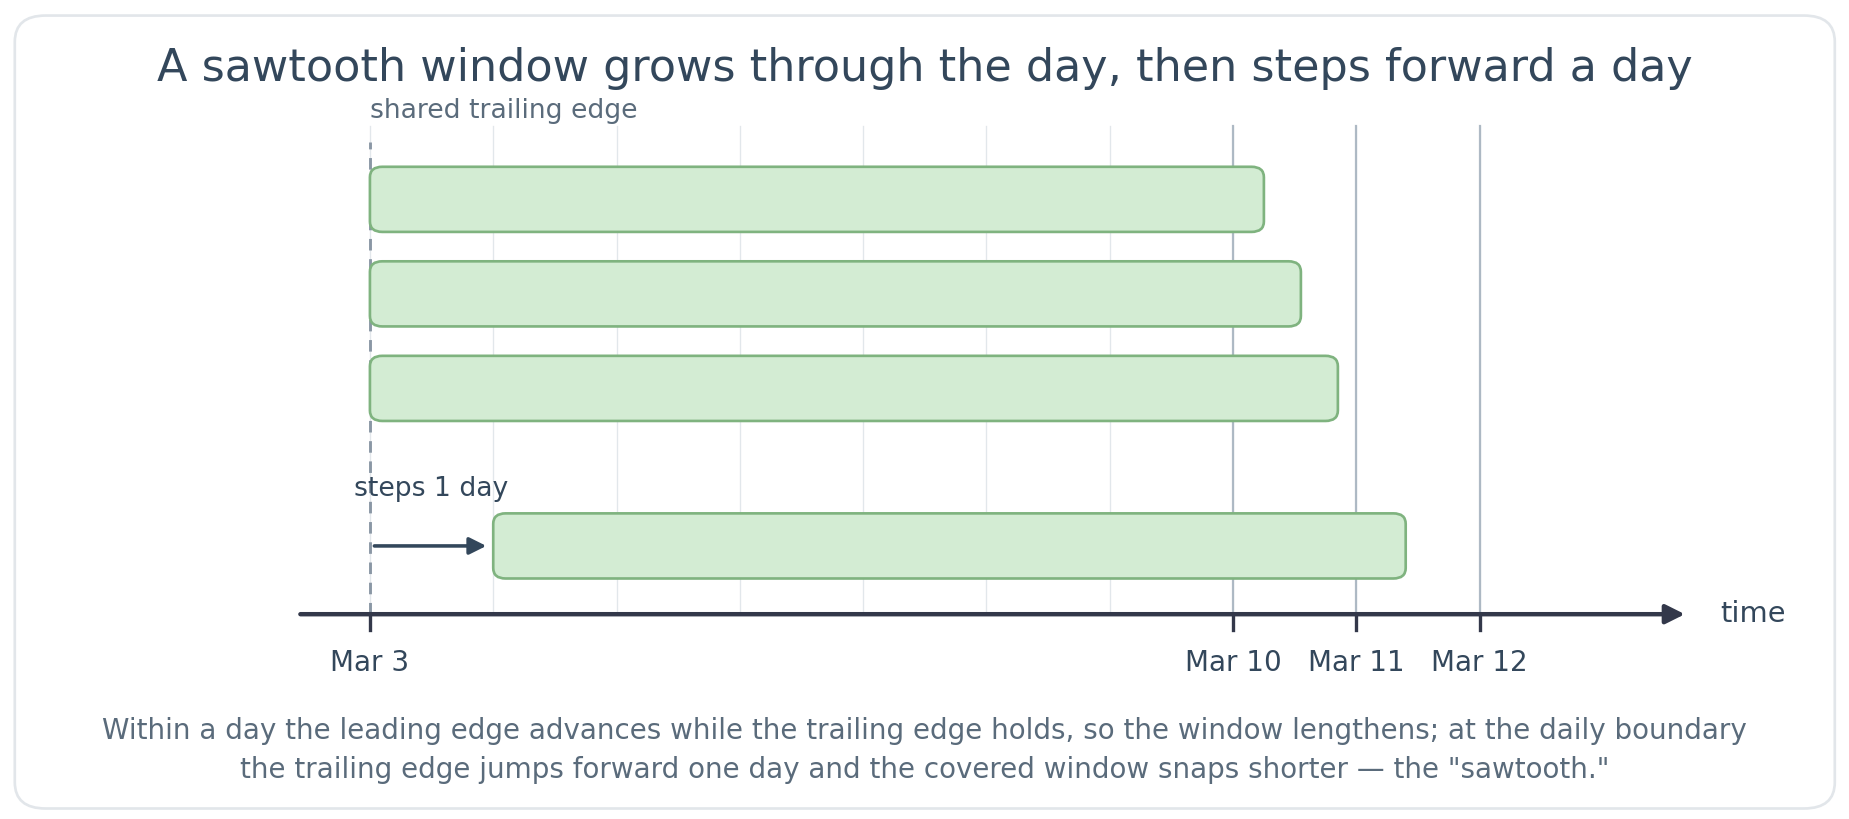
톱니 창은 하이브리드 배치와 스트리밍 경로에 구체화됩니다. 배치 파이프라인은 창의 대부분을 유지하고, 스트리밍 파이프라인은 최신 데이터를 실시간으로 신선하게 유지합니다. 두 기능은 읽을 때 합쳐지므로, 모델이나 서비스 소비자에게는 하나의 기능으로 간주됩니다.
창의 역사적 부분은 배치 파이프라인에 의해 계산되기 때문에, 창이 몇 달 또는 몇 년에 걸쳐 있어도 물질화가 시작된 직후 톱니파 특징이 즉시 즉시 사용할 준비가 되어 있습니다. 롤링 윈도우는 전체 윈도우 기간이 지나야만 완료됩니다. 최소 window_duration 기간은 2일 이상이어야 합니다(강제 하한선). Databricks는 7일 이상 지속되는 경우 톱니 창을 권장합니다. 2일 이상 연장, 최대 7일까지의 창문은 롤링 윈도 우의 고정 길이 정밀도와 톱슬톱 창문의 빠른 생산 준비 중 하나를 선택하세요.
메모
톱니파 특징은 이미 존재하는 역사에 의존합니다. 스트림의 인제스 테이블은 최소 전체 윈도우 시간을 포함하는 데이터를 포함해야 하며, 그렇지 않으면 계산된 윈도우가 불완전합니다. 2일이 완전히 지나기 전에 이 기능은 지금까지 나타난 데이터만 반영합니다. 이 기능을 제작 중에는 2일이 완전히 지나기 전까지는 권장되지 않습니다. 빈 창에 대한 집계는 와 에 대해 Sum 0을 반환하고, , MaxVarPopMinStddevPopFirstVarSampLast에 StddevSamp대해 nullAvg을 반환한다.Count
톱니 모양 기능이 준비되었는지 확인하려면 카탈로그 탐색기에서 기능 뷰를 열어보세요. 물질화된 특징 섹션에서는 특징의 마지막 물질화 시간이 진행되고 상태가 성공으로 표시되면 배치 백필이 완료됩니다. 스트리밍 부분은 Lakeflow 선언형 파이프라인을 통해 구현됩니다. 기능 뷰가 검증을 통과하면 물질화된 기능이 해당 파이프라인에 연결되어, 실행 상태를 모니터링할 수 있습니다.
톱니 창은 a StreamSource 가 필요하며, 와 함께 StreamingMode물질화됩니다.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
톱니 모양 창의 가장자리는 롤링 윈도우와 다르게 움직인다: 앞쪽 가장자리는 최신 사건을 추적하고, 후쪽 가장자리는 연속적으로 움직이지 않고 하루에 한 번 이동한다. 매일 고정된 18:00 UTC 컷오프에서, 후행 가장자리는 그날의 UTC-자정 경계까지 앞으로 나아갑니다. 그 결과, 유효 창은 하루 동안 약간 길 window_duration 어지고, 하루 동안 커지다가 다음 컷오프에 다시 돌아옵니다. 교육과 봉사는 동일한 18:00 UTC 마감일을 사용하므로 오프라인 교육과 온라인 서비스가 일관됩니다.
| 매개 변수 | Constraints |
|---|---|
window_duration |
이틀 이상 걸려야 해. 정수 수가 아닌 기간(예: timedelta(days=3, minutes=15))도 허용되지만, 창은 여전히 일일 단위로 갱신됩니다. |
톱니 창은 , Avg, LastMinStddevPopMaxFirstVarPopCountVarSamp그리고StddevSamp 집계 기능을 지원합니다.Sum
톱니 창문 예시
다음 예시는 사용자의 거래 내역을 7일 동안 집계한 것입니다. 선행 가장자리는 현재 사건을 추적하고, 후방 가장자리는 하루하루 앞으로 나아갑니다. 3월 10일 사건의 경우, 창은 3월 3일경으로 거슬러 올라갑니다. 3월 10일이 지나면서 선두는 계속 전진하고 후간은 버티므로 덮개가 확장됩니다. 그리고 3월 11일 초에는 후방 가장자리가 약 3월 4일까지 이어집니다. 유효 기간은 항상 7일 조금 넘습니다. 가장 최근 이틀은 라이브 스트림에서 제공되며, 이전 요일은 스트림의 인데스팅 테이블에서 제공됩니다.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
톱니 창의 한계
- 매개 변수는
delay지원되지 않습니다. -
SourceLateness.settling_delay은 지원되지 않습니다. - , , , ,
ApproxPercentileMaxFirstDistinctVarSampStddevPopStddevSampVarPopFirstNLastDistinctApproxCountDistinctFirstLastLastNMinCountAvgSum - 톱니 창문
StreamSource은 . ADeltaTableSource는 지원되지 않습니다.
구체화 트리거
구체화 파이프라인이 실행되는 경우 제어를 트리거합니다. 트리거 유형은 기능 유형에 따라 달라집니다.
CronSchedule
배치 집계 기능에 사용됩니다 CronSchedule . 기본적으로 Azure Databricks는 집계 창에서 일정을 파생합니다. 파생 스케줄은 윈도우 기간, 윈도우 delay , offset, 소스 settling_delay 를 고려하여 실행이 소스 데이터가 완료되기 전에 윈도우를 게시하지 않도록 합니다. 파생 스케줄은 턴블링 윈도우와 슬라이딩 윈도우를 지원합니다.
파생 스케줄을 요청하려면 cron 표현식을 생략하세요.
CronSchedule() 명시적 CronSchedule(mode=CronScheduleMode.DERIVED) 형태는 동등하다:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
로 설정 quartz_cron_expressionCronScheduleMode.DERIVED하지 마세요. 물질화된 기능을 불러올 때, 반환된 일정에는 Azure Databricks가 계산한 cron 표현식이 포함될 수 있습니다.
스케줄을 직접 제어하려면 쿼츠 크론 표현식을 제공하세요.
CronScheduleMode.MANUAL 다음과 같은 식을 제공하면 추론됩니다:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
특징 또는 집계 특징()에 사용 TableTriggerColumnSelection 되며, AggregationFunction.DeltaTableSource 파이프라인은 업스트림 델타 테이블이 새 커밋을 받을 때마다 실행됩니다.
집계 기능의 경우, 파이프라인이 제한되어 모든 커밋에서 실행되지 않습니다. 파이프라인은 기능 창 길이의 절반마다 최대 한 번씩 실행되며, 5분 간격 이상은 없습니다. 예를 들어, 1시간 동안 펼쳐지는 장편은 최대 30분에 한 번, 8시간 창을 가진 장편은 최대 4시간에 한 번 방영됩니다. 5분 바닥은 창의 절반이 그보다 작을 때 적용되므로, 10분 이하의 창은 최대 5분마다 한 번씩 실행됩니다. 5분 미만의 집계 기능은 사용할 TableTrigger수 없으니, 대신 스트리밍 트리거를 사용하세요.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
에서 지원되는 StreamingMode기능에 사용합니다StreamSource. 파이프라인은 연속 스트리밍 파이프라인으로 실행됩니다.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
트리거 선택
각 기능은 하나의 트리거를 사용합니다; 기능 유형별 옵션은 다음과 같습니다:
| 기능 유형 | Trigger | 실행 시 |
|---|---|---|
다음의 집계(AggregationFunction) DeltaTableSource |
CronSchedule |
파생 또는 수동 일정에 따라 |
다음의 집계(AggregationFunction) DeltaTableSource |
TableTrigger |
각 원본 테이블 커밋에서 |
ColumnSelection (DeltaTableSource에서) |
TableTrigger |
각 원본 테이블 커밋에서 |
다음의 기능 StreamSource |
StreamingMode |
연속 스트리밍 |
단일 materialize_features 호출에서 다른 트리거 유형이 필요한 기능을 구체화할 수 없습니다. 대신 별도의 호출을 실행합니다.