Flex 처리(미리보기)는 느린 응답 시간과 간헐적인 리소스 사용 불가를 감수할 수 있는 워크로드에 대해 표준 처리 대비 50% 할인된 가격에 추론을 제공합니다.
service_tier를 flex로 설정하여 개별 Responses API 또는 Chat Completions API 요청에 대해 Flex 처리를 선택합니다.
모델 평가, 데이터 보강, 문서 분석 및 비동기 애플리케이션 워크플로와 같은 비동기 및 우선 순위가 낮은 작업에 Flex 처리를 사용합니다. 대기 시간이 중요하거나 용량이 중요한 워크로드의 경우 표준 처리, 우선 순위 처리 또는 프로비전된 처리량을 대신 사용합니다.
Important
Flex 처리가 도입되면서 service_tier를 flex로 설정한 요청은 선택한 모델이 Flex 처리를 지원하는 경우에만 처리됩니다. 지원되지 않는 모델은 HTTP 400 invalid_request_error 을 반환하며 표준 처리로 대체되지 않습니다. Flex 처리에는 대기 시간 SLA 또는 서비스 SLA가 없습니다.
사전 요구 사항
Azure 구독입니다. 체험 계정 만들기
Global Standard 배포 유형을 사용하여 배포된 지원되는 모델이 있는 Azure OpenAI 리소스입니다.
리소스 엔드포인트 및 API 키 또는 Microsoft Entra ID 자격 증명입니다. 이 문서의 예제에서는 환경 변수에
AZURE_OPENAI_API_KEY저장된 API 키를 사용합니다.가변 대기 시간 및 일시적인 리소스를 사용할 수 없는 응답을 허용할 수 있는 워크로드입니다.
Python 3.10 이상 및 Python 예제에 대한 OpenAI Python 패키지:
pip install --upgrade openai
Flex 요청 보내기
Flex 처리를 사용해야 하는 각 요청마다 flex을(를) service_tier(으)로 설정합니다.
model 값은 사용자의 Azure 모델 배포 이름입니다.
Python
다음 예제에서는 응답 API를 사용하여 Flex 요청을 보냅니다.
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
응답에는 생성된 분석 및 요청을 처리하는 서비스 계층이 포함됩니다.
참조:응답 API
REST
다음 예제에서는 동일한 요청을 응답 API에 직접 보냅니다.
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
요청을 처리하는 티어를 확인하려면 성공 응답에서 service_tier 필드를 확인하세요.
처리 옵션 선택
Flex, Standard 및 우선 순위 처리는 온라인 API 요청에 대한 서비스 계층 선택 사항입니다. 일괄 처리 및 프로비전된 처리량은 별도의 배포 및 구매 옵션입니다.
| Option | 선택하는 방법 | 대기 시간 및 가용성 | 비용 모델 | 적합한 대상 |
|---|---|---|---|---|
| Flex 처리 | 요청 수준을 service_tier .로 flex설정합니다. |
가변 대기 시간. Flex 용량을 사용할 수 없는 경우 요청은 HTTP 429를 반환할 수 있습니다. | 표준 토큰 요금에 비해 50% 할인. 캐시된 토큰 할인도 적용됩니다. | 평가, 보강, 오프라인 분석 및 지연에 관대한 백그라운드 작업. |
| 표준 처리 | 요청 수준의 service_tier를 default(으)로 설정하거나, 배포에 대해 구성된 표준 계층을 사용합니다. |
일반 워크로드에 대한 최상의 온라인 처리 | 토큰당 표준 종량제 비율입니다. | 가변 트래픽을 사용하는 개발, 테스트 및 프로덕션 워크로드. |
| 우선 순위 처리 | 배포에서 우선 순위를 구성하거나 요청 수준을 service_tier .로 priority설정합니다. |
지원되는 모델에 대해 정의된 대상을 사용하여 더 낮고 일관된 대기 시간. | 우선 적용되는 토큰당 지불 요금 | 예약된 용량 약정이 없는 대기 시간에 민감한 온라인 애플리케이션 |
| Batch | Batch 배포에 비동기 일괄 처리 작업을 제출합니다. | 결과는 24시간 이내 완료를 목표로 합니다. 실시간 지연 시간 목표는 없습니다. | 할인된 일괄 요금. | 즉각적인 응답이 필요하지 않은 대규모 오프라인 작업입니다. |
| 프로비전된 처리량 | 프로비전된 배포를 만들고 프로비전된 처리량 단위(PTU)를 구매하거나 예약합니다. | 예측 가능한 처리량 및 대기 시간을 가진 예약된 용량입니다. | 시간당 PTU 청구 또는 Azure 예약. | 중요 업무용 대량 프로덕션 워크로드. |
다음 조건이 모두 적용되는 경우 Flex 처리를 선택합니다.
- 워크로드는 더 길고 가변적인 처리 시간을 허용할 수 있습니다.
- 예측 가능한 대기 시간보다 낮은 비용을 선호합니다.
- 애플리케이션은 일시적인 오류를 다시 시도하거나 실패한 요청을 표준 처리로 라우팅할 수 있습니다.
- 선택한 모델 및 요청 컨텍스트가 지원됩니다.
다음 조건이 적용되는 경우 Flex 처리를 사용하지 마세요.
- 사용자가 대화형 응답을 기다리고 있습니다.
- 요청은 엄격한 대기 시간 대상 내에서 완료되어야 합니다.
- 애플리케이션은 일시적인 HTTP 429 응답을 허용하거나 다시 시도할 수 없습니다.
- 예약된 처리 용량 또는 예측 가능한 처리량이 필요합니다.
Flex 처리의 특징은 다음과 같습니다.
-
요청 수준 선택: Flex 처리를 사용해야 하는 각 요청에서
flex을(를)service_tier(으)로 설정합니다. - 별도의 배포 없음: 표준 및 Flex 요청을 동일한 글로벌 표준 배포로 보내고 요청당 계층을 선택합니다.
- 지원되는 API: 응답 API 또는 채팅 완료 API를 사용합니다.
- 동기 응답: 워크로드를 완료하는 데 시간이 더 오래 걸릴 수 있더라도 API 호출은 동기 상태로 유지됩니다. Flex 처리는 Batch API와 동일하지 않습니다.
- 용량 종속 가용성: Flex 용량을 사용할 수 없는 경우 요청이 HTTP 429를 반환할 수 있습니다.
-
자동으로 Standard로 대체되지 않음: Standard 처리가 허용되는 경우 애플리케이션은
default를service_tier로 설정하여 명시적으로 다시 시도해야 합니다. - 공유 할당량: Flex 및 Standard 요청은 글로벌 표준 배포에 할당된 할당량을 사용합니다.
- 동일한 모델 출력 품질: Flex는 표준과 동일한 기본 모델을 사용합니다. 처리 계층은 모델 품질이 아니라 대기 시간, 가용성 및 가격을 변경합니다.
메모
Flex 입력 및 출력 토큰에는 해당 Standard 토큰 요금 대비 50% 할인된 요금이 적용됩니다. 할인 대상인 캐시된 입력 토큰에도 해당 캐시 토큰 할인이 적용됩니다. 현재 요금은 Azure OpenAI 가격을 참조하세요.
지원되는 모델 검토
Flex 처리는 출시 시 모델 가용성이 제한됩니다.
gpt-5.6-sol 는 지원되는 첫 번째 모델입니다. 다음 표에서는 지원되는 모델을 나열합니다. Microsoft 지원이 제공되면 더 많은 모델을 추가합니다.
| 모델 | Version | 배포 유형 | 지역별 가용성 |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
gpt-6-sol |
2026-09-22 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
gpt-6-luna |
2026-09-22 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
gpt-6-astra |
2026-09-03 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
gpt-5.6-sol |
2026-07-09 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
gpt-5.6-luna |
2026-07-09 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
gpt-5.6-terra |
2026-07-09 |
글로벌 표준 | Global Standard를 사용할 수 있는 모든 Azure 지역 |
Flex 요청을 보내기 전에 이 테이블을 확인합니다. 모델 또는 새 모델 버전이 표준 또는 우선 순위 처리를 지원하므로 Flex 처리를 지원한다고 가정하지 마세요. 지원되지 않는 모델은 HTTP 400을 반환합니다. 애플리케이션이 중단되지 않도록 하려면 표준 가격 책정 및 성능이 허용되는 경우 표준 처리로 애플리케이션 수준 대체를 구현합니다.
표준 처리로 대체
Flex 용량을 사용할 수 없는 경우 Flex 처리는 자동으로 요청을 표준으로 라우팅하지 않습니다. 요청을 완료하는 것이 Flex 가격 책정을 유지하는 것보다 더 중요하다면, service_tier를 default로 설정하여 요청을 다시 시도하세요.
다음 예제에서는 완료 우선 정책을 사용합니다. 먼저 플렉스 처리를 시도하고 HTTP 429 응답 후에 표준 처리로 한 번 다시 시도합니다.
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
표준으로 대체하면 요청의 가격 책정 및 성능 특성이 변경됩니다. 워크로드가 표준 가격을 수락할 수 있는 경우에만 이 패턴을 사용합니다.
HTTP 429 응답은 사용할 수 없는 Flex 용량 또는 할당량 제한을 나타낼 수 있습니다. Flex 처리와 Standard 처리는 할당량을 공유하므로, 원래 응답이 할당량 문제로 인해 발생한 경우 Standard 요청도 실패할 수 있습니다. 재시도 제한을 적용하고 애플리케이션에서 두 번째 RateLimitError를 처리하세요. 서비스에서 Flex 관련 오류 식별자를 반환하는 경우 이를 사용하여 용량 관련 응답으로 대체를 제한합니다.
가장 낮은 비용의 우선 순위를 지정하는 워크로드의 경우 뒤로 물러나기 전에 지수 백오프를 사용하여 Flex 처리를 다시 시도합니다. 완료 시간의 우선 순위를 지정하는 워크로드의 경우 첫 번째 Flex 용량 오류 후 표준으로 대체합니다.
참고자료:RateLimitError
Flex 오류 처리
영구 요청 오류를 일시적인 용량 오류와 구분합니다.
| HTTP 상태 | 오류 | 원인 | 권장 처리 |
|---|---|---|---|
| 400 | invalid_request_error |
선택한 모델, 모델 버전, 컨텍스트 길이, API 또는 요청 구성은 Flex 처리를 지원하지 않습니다. | 변경되지 않은 동일한 요청을 다시 시도하지 마세요. 지원되는 모델 또는 컨텍스트 길이를 선택하거나 service_tier를 default로 설정한 후 명시적으로 다시 시도하세요. |
| 408 | 요청 시간 초과 | 구성된 클라이언트 또는 서비스 시간 제한 내에서 요청이 완료되지 않습니다. Flex 요청은 표준 요청보다 오래 걸릴 수 있습니다. | 더 긴 클라이언트 시간 제한을 사용합니다. 제한된 지수 백오프를 사용하여 다시 시도합니다. 완료 시간이 Flex 요금보다 더 중요하다면 Standard로 다시 시도하세요. |
| 429 | 리소스를 사용할 수 없거나 속도가 제한됨 | Flex 용량을 일시적으로 사용할 수 없거나 요청이 적용 가능한 속도 제한을 초과했습니다. Flex 용량은 선점형이므로 피크 시간대에는 일시적으로 사용할 수 없게 될 가능성이 더 높습니다. | 요청이 속도 제한을 초과하는 경우 할당량을 더 할당하여 글로벌 표준 배포의 속도 제한을 늘입니다. Flex 및 Standard는 이 할당량을 공유합니다. 구독에 큰 처리량 워크로드에 대한 할당량이 충분하지 않은 경우 할당량 증가를 요청합니다. Flex 용량을 일시적으로 사용할 수 없는 경우 지수 백오프와 지터를 사용하여 다시 시도하거나, 평일 야간이나 주말과 같은 비성수기 시간대로 지연을 허용하는 작업을 분산하거나, service_tier을(를) default(으)로 설정한 후 다시 시도하세요. 있는 경우 Retry-After를 준수하세요. |
| 500, 502, 503 또는 504 | 일시적인 서비스 오류 | 임시 서비스 또는 게이트웨이 문제로 인해 완료되지 못했습니다. | 제한된 지수 백오프를 사용하여 다시 시도합니다. 무제한 재시도를 보내지 마세요. |
| 401 또는 403 | 인증 또는 권한 부여 오류 | 자격 증명이 없거나, 유효하지 않거나, 만료되었거나, 리소스에 액세스할 수 없습니다. | 자격 증명 또는 역할 할당을 수정합니다. 구성이 변경될 때까지 다시 시도하지 마세요. |
| 404 | 배포를 찾을 수 없음 | 배포 이름 또는 엔드포인트가 잘못되었습니다. |
model 배포 이름과 일치하고 기본 URL이 올바른 Azure OpenAI 리소스를 가리키는지 확인합니다. |
메모
처리 용량을 사용할 수 없어 거부된 Flex 요청에는 요금이 청구되지 않습니다. 그러나 Flex 및 Standard 요청이 글로벌 표준 배포에 할당된 할당량을 공유하기 때문에 사용 가능한 속도 제한 용량이 적을 수 있습니다.
HTTP 408, 429 및 일시적인 5xx 응답에 대해 임의 지터와 함께 지수 백오프를 사용합니다. 실패한 요청이 바인딩되지 않은 재시도 루프에 남아 있지 않도록 최대 재시도 횟수 및 최대 지연 시간을 설정합니다.
- 응답에
Retry-After가 포함된 경우 이를 존중하세요. - 그렇지 않으면 무작위 지터를 적용한 지수적으로 증가하는 대기 시간을 기다리세요.
- 워크로드에 대해 지연이 허용되는 동안에만 Flex를 다시 시도합니다.
- 재시도 예산이 소진되고 애플리케이션에서 더 높은 표준 비용을 허용하는 경우 표준으로 대체합니다.
- 지연된 Flex 처리와 표준 대체가 애플리케이션의 요구 사항을 충족하지 않는 경우 명시적 오류를 반환합니다.
지원되지 않는 동일한 Flex 요청을 반복적으로 다시 시도하지 마세요. 다시 시도는 모델, 컨텍스트 길이, API 구성 또는 서비스 계층을 변경한 후에만 성공합니다.
사용량 및 비용 모니터링
Azure Monitor 메트릭을 사용하여 동일한 배포에서 Flex 및 Standard 트래픽을 비교합니다. 요청 볼륨, 토큰 사용량, 대기 시간, 실패 및 Flex 요청이 애플리케이션에서 표준으로 대체되는 속도를 모니터링합니다.
Azure Portal에 로그인합니다.
Azure OpenAI 리소스로 이동하여 메트릭을 선택합니다.
Azure OpenAI 요청 메트릭을 추가합니다. Azure OpenAI 지연 시간, Azure OpenAI 사용량 및 오류 메트릭도 추가할 수 있습니다.
ServiceTierRequest가
flex와 일치하는 필터를 추가합니다.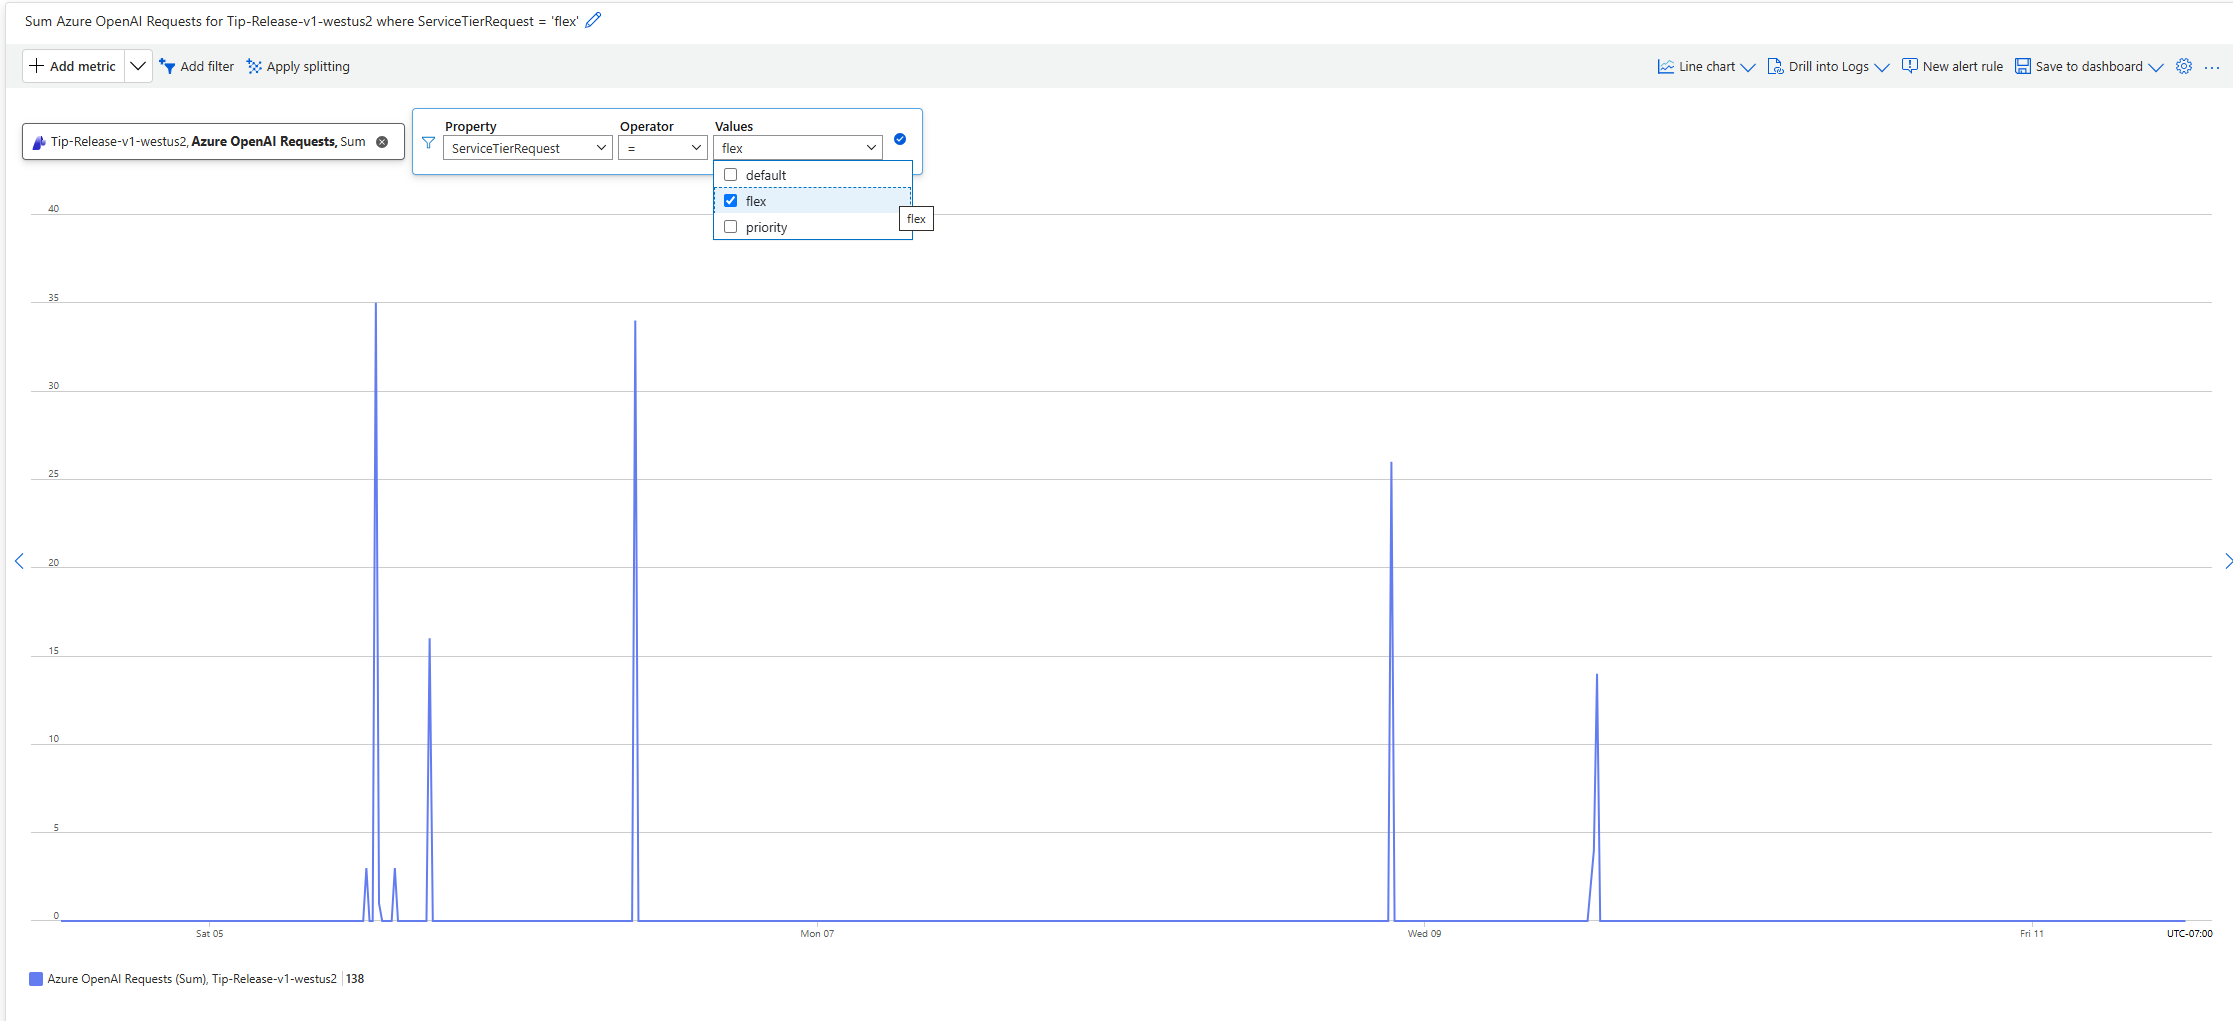
지속적인 HTTP 429 응답, 증가된 오류율 및 워크로드의 재시도 예산을 초과하는 대기 시간에 대한 경고를 만듭니다.
각 워크로드에 대해 다음 신호를 추적합니다.
| 신호 | 중요한 이유 |
|---|---|
| Flex 요청 수 | 저비용 처리를 위해 라우팅된 트래픽 및 도입 현황을 보여 줍니다. |
| 성공적인 Flex 요청 속도 | Flex 용량이 요청을 수락하고 완료하는 빈도를 보여 줍니다. |
| HTTP 429 속도 | Flex 용량 또는 배포 할당량이 제한된 기간을 표시합니다. |
| 표준 대체 횟수 및 속도 | 애플리케이션 제어 대체로 인한 안정성 이점 및 추가 비용을 보여 줄 수 있습니다. |
| 입력, 캐시된 입력 및 출력 토큰 | 비용 귀속을 지원하고 프롬프트 캐싱의 효과를 검증합니다. |
| 종단 간 대기 시간 | 워크로드가 Flex에 적합한지 여부를 결정하는 데 도움이 됩니다. |
HTTP 400 invalid_request_error 수 |
지원되지 않는 모델, 모델 버전, 컨텍스트 길이 또는 요청 구성을 식별합니다. |
모델 배포 모니터링에 대한 자세한 내용은 Monitor Azure OpenAI를 참조하세요.
Flex 사용량은 표준 사용량과 구분할 수 있도록 전용 Flex 미터에 청구됩니다. 비용 분석을 사용하여 리소스 및 배포별로 Flex 토큰 비용을 검토합니다.
- Azure 포털에서 Cost Management + 청구>비용 분석을 엽니다.
- 배포가 포함된 구독, 리소스 그룹 또는 Azure OpenAI 리소스로 필터링합니다.
- 측정기를 기준으로 그룹화 또는 필터링하여 Flex 사용량을 표준 사용량과 구분합니다.
- 청구 태그 필터를 추가하고 배포를 선택한 다음, 배포 이름을 선택합니다.
- Flex 비용 절감을 표준 대체 비용 및 워크로드의 완료 요구 사항과 비교합니다.
Flex 입력 및 출력 토큰의 가격은 해당 표준 요금의% 50으로 책정됩니다. 프롬프트 캐싱은 적격 캐시된 입력 토큰의 비용을 추가로 줄일 수 있습니다. 처리 용량을 사용할 수 없어 거부된 Flex 요청에는 요금이 청구되지 않습니다.
프로덕션 모범 사례 적용
- 더 긴 시간 제한을 설정합니다. Flex 요청은 표준 요청보다 오래 걸릴 수 있습니다. 워크로드에 적합한 클라이언트 시간 제한(예: 15분)으로 시작하고 대표 프롬프트를 사용하여 테스트합니다.
- 제한된 재시도를 사용합니다. 재시도 시도 및 총 경과 시간을 제한합니다.
- 지터를 추가합니다. 동기화된 재시도 급증을 방지하려면 백오프 지연을 임의로 지정합니다.
- 대체를 명시적으로 만듭니다. 암시적 동작에 의존하기보다
default를service_tier(으)로 설정하세요. - 처리된 계층을 추적합니다. 대기 시간, 상태, 토큰 사용량 및 비용 데이터를 사용하여 응답
service_tier값을 기록합니다. - 대화형 및 백그라운드 트래픽을 구분합니다. 가변적인 Flex 지연 시간이 허용되는 경우가 아니라면 사용자 대상 요청은 Standard, Priority 또는 프로비저닝된 처리량으로 유지하세요.
- 중복 작업을 제어합니다. 애플리케이션이 클라이언트 쪽 시간 제한 후에 동일한 논리 작업을 여러 번 제출하지 않는지 확인합니다.
- 테스트 실패 경로입니다. 프로덕션 워크플로에서 Flex 처리를 사용하기 전에 HTTP 400, 408, 429 및 일시적인 5xx 응답에 대한 처리의 유효성을 검사합니다.
- 업그레이드하기 전에 모델 지원을 검토합니다. 교체 모델 또는 모델 버전은 Flex 지원을 자동으로 상속하지 않습니다.
요청 헤더를 사용하여 서비스 계층 재정의
x-ms-service-tier 요청 본문을 검사하거나 수정하지 않고 게이트웨이, 프록시 또는 중앙 집중식 라우팅 계층이 서비스 계층을 선택해야 하는 경우 요청 헤더를 사용합니다. 헤더는 요청 헤더를 통해 OpenAI 서비스 계층을 이미 선택한 애플리케이션에 대한 마이그레이션 변경 내용을 줄일 수도 있습니다.
헤더는 다음 값을 허용합니다.
| 헤더 값 | 요청된 처리 계층 |
|---|---|
flex |
플렉스 |
priority |
우선순위 |
default |
표준 |
auto |
우선순위 |
헤더가 있고 유효한 경우 요청 본문의 service_tier 값보다 우선합니다.
| 헤더 입력 | 요청 본문 입력 | 동작 및 출력 |
|---|---|---|
| 헤더가 생략됨 | 유효한 service_tier 값 |
요청 본문은 계층을 선택합니다. 성공적인 응답은 service_tier에서 처리된 계층을 확인할 수 있음을 나타냅니다. |
| 유효한 헤더 값 | 임의의 값 또는 생략 가능 | 헤더가 요청된 계층을 선택합니다. 성공적인 응답은 service_tier에서 처리된 계층을 확인할 수 있음을 나타냅니다. |
| 지원되지 않는 헤더 값 | 임의의 값 또는 생략 가능 | 요청은 HTTP 400을 반환합니다. 서비스는 요청 본문 값으로 대체되지 않습니다. |
이 예제에서는 헤더를 통해 Flex 처리를 요청합니다. 헤더는 요청 본문의 default 값을 재정의합니다.
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
재정의 헤더는 자동 폴백을 지원하지 않습니다. 잘못된 헤더 값 또는 선택한 배포에서 지원하지 않는 계층은 HTTP 400을 반환합니다.