Merk
Tilgang til denne siden krever autorisasjon. Du kan prøve å logge på eller endre kataloger.
Tilgang til denne siden krever autorisasjon. Du kan prøve å endre kataloger.
SQL analytics-endepunktet gir deg en skrivebeskyttet T-SQL-spørringssurface over Delta-tabellene i hytta di. Hver lakehouse installerer automatisk et SQL-analyse-endepunkt når det opprettes — det er ingenting ekstra å sette opp. Bak kulissene kjører SQL-analyse-endepunktet på samme motor som Fabric datalager, så du får høyytelses, lav-latens SQL-spørringer uten å administrere infrastrukturen.
SQL analytics-endepunktet er ikke unikt for lakehouses. Andre Fabric-elementer — inkludert warehouses, mirrored databases, SQL-databaser og Azure Cosmos DB — tilfører også automatisk et SQL-analyseendepunkt. Opplevelsen og begrensningene er de samme på tvers av dem alle.
Hva du kan gjøre
SQL-analyseendepunktet opererer i skrivebeskyttet modus over Delta-tabeller — du kan ikke sette inn, oppdatere eller slette data gjennom det. For å endre data, bytt til innsjøhuset og bruk Apache Spark.
Innenfor denne skrivebeskyttede grensen kan du:
- Søk i Delta-tabeller med T-SQL — Kjør SELECT-setninger mot hvilken som helst Delta-tabell i hytta di, inkludert tabeller som er eksponert gjennom snarveier til ekstern Azure Data Lake Storage eller Amazon S3.
- Lag visninger, funksjoner og lagrede prosedyrer — Kapsl inn forretningslogikk og gjenbrukbare spørringsmønstre i T-SQL-objekter som vedvarer i SQL-analyseendepunktet.
- Bruk sikkerhet på rad- og objektnivå — Bruk SQL-granulære tillatelser for å kontrollere hvilke brukere som kan se hvilke tabeller, kolonner eller rader.
- Bygg Power BI-rapporter — Power BI-semantiske modeller kan kobles til SQL-analyseendepunktet via Tabular Data Stream (TDS)-endepunktet, slik at du kan bygge rapporter over lakehouse-dataene dine.
- Spør på tvers av arbeidsområder — Bruk OneLake-snarveier for å referere til Delta-tabeller i andre lakehouses eller lagre, og slå dem sammen til én enkelt forespørsel. For flere scenarier på tvers av arbeidsområder, se Lakehouse SQL analytics endpoint use cases.
Note
Eksterne Delta-tabeller som er opprettet med Spark-kode, er ikke synlige for SQL Analytics-endepunktet. Bruk snarveier i tabellseksjonen for å gjøre eksterne delta-tabeller synlige. For å lære hvordan, se Lag en snarvei.
Access SQL-analyseendepunktet
Du kan åpne SQL analytics-endepunktet på to måter:
- Fra arbeidsområdet — I arbeidsområdets gjenstandsliste, finn SQL-analyse-endepunktet (det deler navn med innsjøhuset ditt) og velg det.
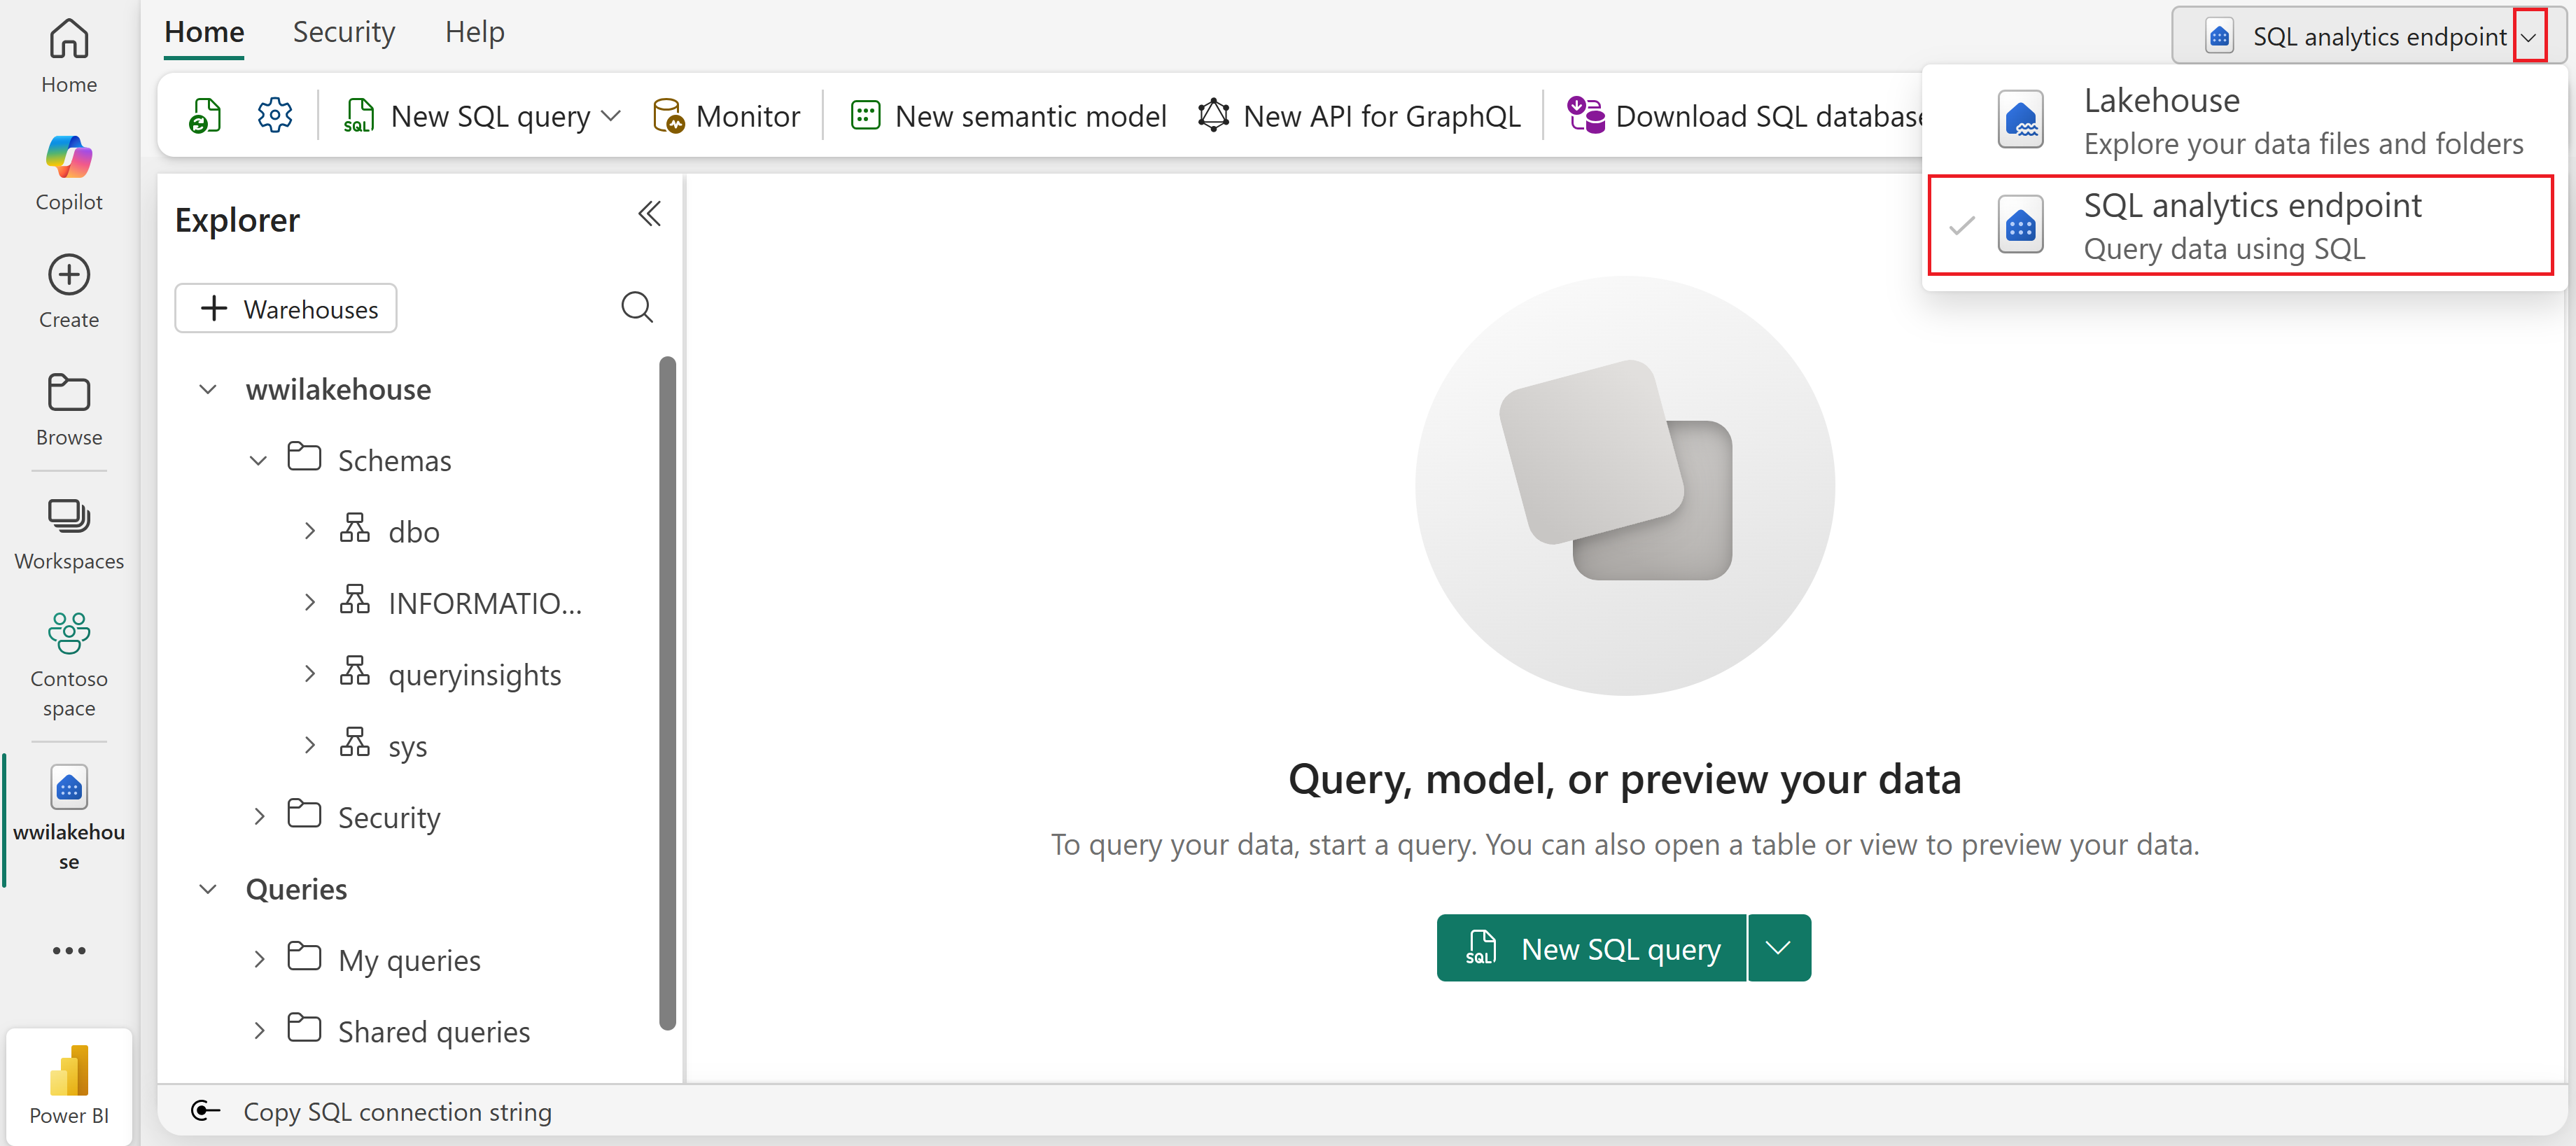
- Fra Lakehouse-utforskeren — I øverste høyre område av båndet, bruk nedtrekksmenyen for å bytte til SQL-analyse-endepunktsvisningen.
Uansett åpner query editor hvor du kan skrive og kjøre T-SQL-spørringer mot Delta-tabellene dine.
Security
SQL-sikkerhetsregler satt på SQL-analyseendepunktet gjelder kun når data aksesseres gjennom endepunktet. De gjelder ikke når de samme dataene er tilgjengelige via Spark eller andre verktøy.
For å sikre dataene dine:
- Sett SQL granular permissions på SQL-analyseendepunktet for å kontrollere access til spesifikke tabeller, kolonner eller rader.
- Sett workspace-roller og tillatelser for å kontrollere hvem som kan access lakehouse og dets data via andre stier.
For mer om sikkerhetsmodellen, se OneLake sikkerhet for SQL-analyseendepunkter.
Synkronisering av metadata
Når du oppretter eller oppdaterer en Delta-tabell i hytta di, oppdager SQL-analyseendepunktet automatisk endringen og oppdaterer SQL-metadata — tabelldefinisjoner, kolonnetyper og statistikk. Det er ingen importtrinn og ingen manuell synkronisering nødvendig. Du har flere muligheter for å manuelt starte en oppdatering av SQL-analyse-endepunktmetadataene.
For mer informasjon, se SQL analytics endpoint metadata sync.
Reprovisioning
Hvis SQL-analyseendepunktet ikke klarer å provisionere når du oppretter et lakehouse, kan du prøve direkte fra lakehouse-hjemmesiden uten å gjenopprette lakehouse.
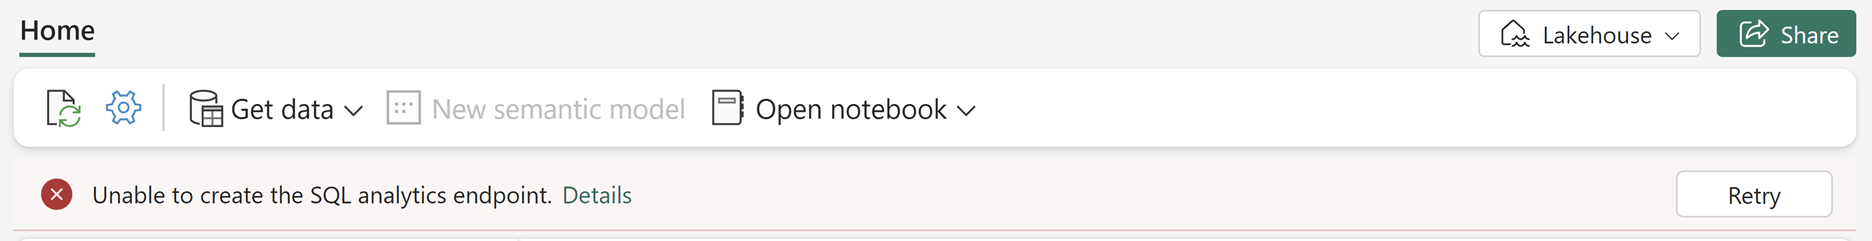
Note
Reprovisionering kan fortsatt feile, akkurat som den opprinnelige provisioneringen. Hvis gjentatte forsøk mislykkes, kontakt support.
Begrensninger
SQL-analyseendepunktet deler motoren sin med lageret i Fabric, og de har de samme begrensningene.
Følgende begrensninger gjelder for automatisk skjemagenerering og metadataoppdagelse i SQL Analytics.
Data bør være i Delta Parquet-format for å bli automatisk registrert i endepunktet for SQL-analyse. Delta Lake er et åpen kildekode-lagringsrammeverk som muliggjør bygging av innsjøhusarkitektur.
Deltakolonnetilordning etter navn støttes, men Delta-kolonnetilordning etter ID støttes ikke. Hvis du vil ha mer informasjon, kan du se Delta Lake-funksjoner og Fabric-opplevelser.
- Deltakolonnetilordning i SQL Analytics-endepunktet er for øyeblikket i forhåndsversjon.
Delta-tabeller som er opprettet utenfor
/tablesmappen, er ikke tilgjengelige i SQL Analytics-endepunktet.Hvis du ikke ser en lakehouse-tabell i SQL-analyse-endepunktet, sjekk plasseringen av tabellen. Kun tabellene som refererer til data i
/tablesmappen er tilgjengelige i SQL-analyse-endepunktet. Tabellene som refererer til data i/filesmappen i innsjøen, vises ikke i SQL Analytics-endepunktet. Som en midlertidig løsning flytter du dataene til/tablesmappen.Noen kolonner som finnes i Spark Delta-tabellene, er kanskje ikke tilgjengelige i tabellene i SQL Analytics-endepunktet. For hver Delta-tabell i Lakehouse genererer SQL-analyseendepunktet automatisk en tabell med T-SQL-datatyper. SQL-analyse-endepunktmotoren er basert på Fabric datalager-motoren, og deler datatyper. Hvis du vil ha en fullstendig liste over støttede datatyper, kan du se Datatyper i Fabric datalager.
Hvis du legger til en sekundærnøkkelbetingelse mellom tabeller i SQL Analytics-endepunktet, kan du ikke gjøre flere skjemaendringer (for eksempel legge til de nye kolonnene). Hvis du ikke ser Delta Lake-kolonnene med typene som skal støttes i SQL Analytics-endepunktet, må du kontrollere om det finnes en sekundærnøkkelbetingelse som kan forhindre oppdateringer i tabellen.
Hvis du vil ha informasjon og anbefalinger om ytelsen til SQL Analytics-endepunktet, kan du se ytelsesvurderinger for SQL Analytics-endepunktet.
Skalar-UDF-er støttes når de er innebygde. Hvis du vil ha mer informasjon, kan du se CREATE FUNCTION og Scalar UDF inlining.
Varchar(max)-datatypen støttes kun i SQL-analyseendepunkter aktivert med den nye metadata-synkroniseringen.
Datatrunkering til 8 KB gjelder fortsatt på tabellene i SQL-analyseendepunktet til lakehouse, inkludert snarveier til et speilet element hvis SQL-analyseendepunktet ikke bruker ny metadatasynkronisering.
Du kan bekrefte om en tabell har en varchar(max) -kolonne fra skjemametadataene ved å bruke følgende T-SQL-spørring. En max_length verdi av -1 representerer varchar(max):
SELECT o.name, c.name, type_name(user_type_id) AS [type], max_length
FROM sys.columns AS c
INNER JOIN sys.objects AS o
ON c.object_id = o.object_id
WHERE max_length = -1
AND type_name(user_type_id) IN ('varchar', 'varbinary');
Skjemaer med navn som kolliderer med systemskjemaer (som
sysellerinformation_schema) og databasesikkerhetsprinsipper (somdb_owner,db_datareader) støttes ikke i SQL-analyse-endepunktet. Tabeller under disse skjemaene vil ikke synkroniseres med SQL-analyseendepunktet.Et arbeidsområde støtter opptil 150 lager- og SQL-analyseendepunkter kombinert. Å lage flere elementer utover denne grensen støttes ikke. Slett et eksisterende element før du oppretter et nytt.