Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of mappen te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen om mappen te wijzigen.
Bepaal de snelheid waarmee uw toepassing aanvragen naar een service verzendt, zodat u binnen de beperkingslimieten en de totale capaciteit van de service blijft. Met deze aanpak kunt u fouten door snelheidsbeperking vermijden of beperken en de doorvoer nauwkeuriger voorspellen.
Snelheidsbeperking is geschikt in veel scenario's, maar het is vooral handig voor grootschalige, terugkerende geautomatiseerde taken, zoals batchverwerking.
Context en probleem
Het uitvoeren van grote aantallen bewerkingen op basis van een vertraagde service kan leiden tot meer verkeer en verminderde doorvoer, omdat u geweigerde aanvragen moet bijhouden en de bewerkingen vervolgens opnieuw moet uitvoeren. Naarmate het aantal bewerkingen toeneemt, kan een beperkingslimiet meerdere doorvoeringen van het opnieuw verzenden van gegevens vereisen, wat resulteert in een grotere impact op de prestaties.
Neem bijvoorbeeld het volgende problematische retry-on-error-proces voor het invoeren van data in Azure Cosmos DB:
Uw toepassing moet 10.000 records opnemen in Azure Cosmos DB. Elke record kost 10 aanvraageenheden (RU's) om op te nemen, dus een totaal van 100.000 RU's is vereist om de taak te voltooien.
Uw Azure Cosmos DB-instantie heeft 20.000 RU's aan ingerichte capaciteit.
U verzendt alle 10.000 records naar Azure Cosmos DB. 2000 records worden geschreven en 8.000 records worden geweigerd.
U verzendt de resterende 8000 records naar Azure Cosmos DB. 2000 records worden geschreven en 6.000 records worden geweigerd.
U verzendt de resterende 6000 records naar Azure Cosmos DB. 2000 records worden met succes geschreven en 4.000 records worden geweigerd.
U verzendt de resterende 4000 records naar Azure Cosmos DB. 2000 records worden met succes geschreven en 2000 records worden geweigerd.
U verzendt de resterende 2000 records naar Azure Cosmos DB. Ze zijn allemaal succesvol geschreven.
De opnametaak is voltooid, maar pas na het verzenden van 30.000 records naar Azure Cosmos DB. De volledige gegevensset bestaat uit slechts 10.000 records.
In dit voorbeeld zijn er andere factoren die u moet overwegen:
Grote aantallen fouten kunnen ook leiden tot extra werk om deze fouten te registreren en de resulterende logboekgegevens te verwerken. De voorgaande benadering verwerkt 20.000 fouten en het vastleggen van deze fouten kan een verwerkings-, geheugen- of opslagresourcekosten met zich meebrengt.
Omdat u de beperkingslimieten van de opnameservice niet kent, hebt u geen manier om verwachtingen in te stellen voor de duur van gegevensverwerking. Met snelheidsbeperking kunt u de benodigde tijd voor opname berekenen.
Oplossing
Snelheidsbeperking kan het verkeer verminderen en de doorvoer mogelijk verbeteren door het aantal records dat gedurende een bepaalde periode naar een service wordt verzonden, te verminderen.
Een service kan aanvragen beperken op basis van verschillende metrische gegevens in de loop van de tijd, zoals:
- Het aantal bewerkingen (bijvoorbeeld 20 aanvragen per seconde).
- De hoeveelheid gegevens (bijvoorbeeld 2 GiB per minuut).
- De relatieve kosten van bewerkingen (bijvoorbeeld 20.000 RU's per seconde).
Ongeacht welke maatstaf u voor throttling gebruikt, uw rate limiting-implementatie omvat het beheersen van het aantal en/of de omvang van bewerkingen die binnen een bepaalde periode naar de service worden verzonden. Frequentiebeperking helpt u de dienst optimaal te gebruiken zonder de throttlinglimiet te overschrijden.
In scenario's waarin uw API's aanvragen sneller kunnen verwerken dan de beperkte opnameservices toestaan, moet u beheren hoe snel u de service gebruikt. Het behandelen van throttling alleen als een mismatch van gegevenssnelheid en het bufferen van opnameverzoeken totdat de service herstelt, creëert risico's. Als uw toepassing niet meer reageert in dit scenario, gaan eventuele gebufferde gegevens verloren.
Om dit risico te vermijden, kunt u overwegen uw records naar een duurzaam berichtensysteem te sturen dat kan omgaan met uw volledige innamesnelheid. (Services zoals Azure Event Hubs kunnen miljoenen bewerkingen per seconde verwerken.) Vervolgens kunt u een of meer taakprocessors gebruiken om de records van het berichtensysteem te lezen met een gecontroleerde snelheid die binnen de limieten van de beperkte service valt. Als u records naar het berichtensysteem verzendt, kunt u intern geheugen besparen door alleen de records uit de wachtrij te verwijderen die gedurende een bepaald tijdsinterval kunnen worden verwerkt.
Azure biedt verschillende duurzame berichtenservices die u met dit patroon kunt gebruiken, waaronder:
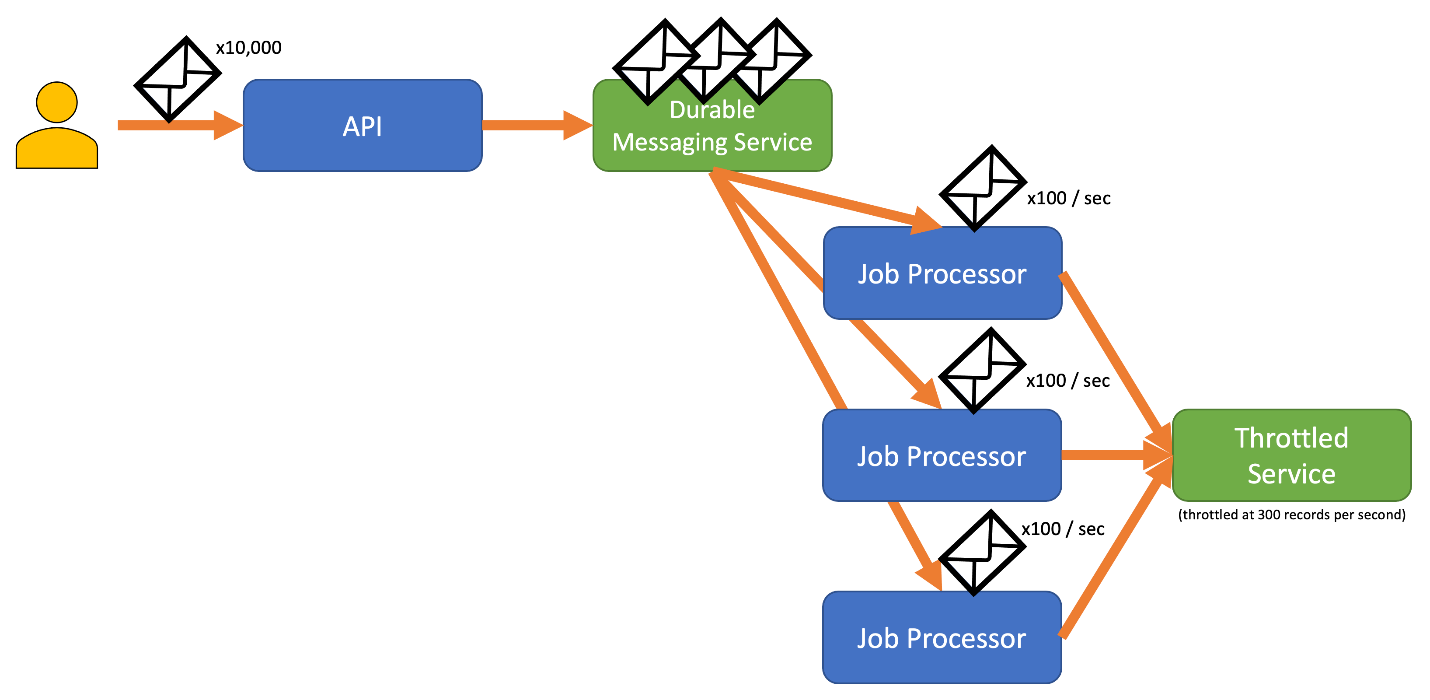
Wanneer u records verzendt, is de periode die u gebruikt voor het vrijgeven van records mogelijk gedetailleerder dan de periode waarop de service wordt beperkt. Systemen stellen vaak limieten in op basis van tijdsperioden die u gemakkelijk kunt begrijpen en waarmee u kunt werken. Voor de computer waarop een service wordt uitgevoerd, kunnen deze tijdsbestekken echter erg lang zijn in vergelijking met hoe snel informatie kan worden verwerkt. Een systeem kan bijvoorbeeld per seconde of per minuut worden afgeremd, maar doorgaans wordt de code verwerkt in de orde van grootte van nanoseconden of milliseconden.
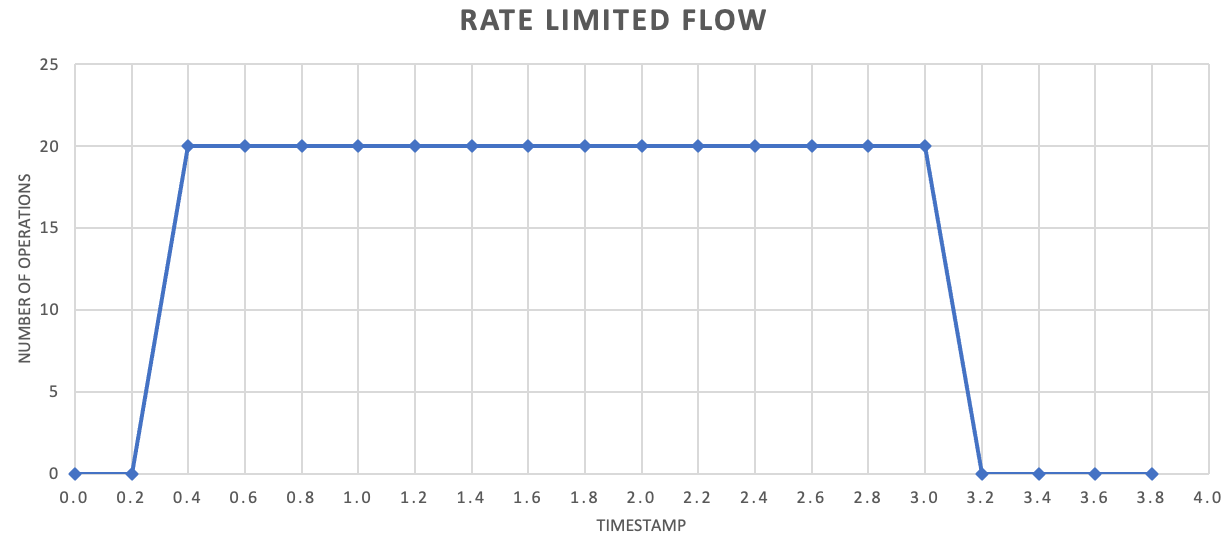
Hoewel dit niet vereist is, wordt het vaak aanbevolen om kleinere aantallen records vaker te verzenden om de doorvoer te verbeteren. Dus in plaats van records voor vrijgave één keer per seconde of één keer per minuut te bundelen, kunt u nog fijnmaziger te werk gaan om het verbruik van resources (geheugen, CPU en netwerk) gelijkmatiger te laten verlopen. Deze aanpak voorkomt potentiële knelpunten die worden veroorzaakt door plotselinge bursts van aanvragen. Als een service bijvoorbeeld 100 bewerkingen per seconde toestaat, kan de implementatie van een frequentielimieter aanvragen gelijkmatig uitzetten door elke 200 milliseconden 20 bewerkingen uit te brengen, zoals wordt weergegeven in de volgende grafiek.
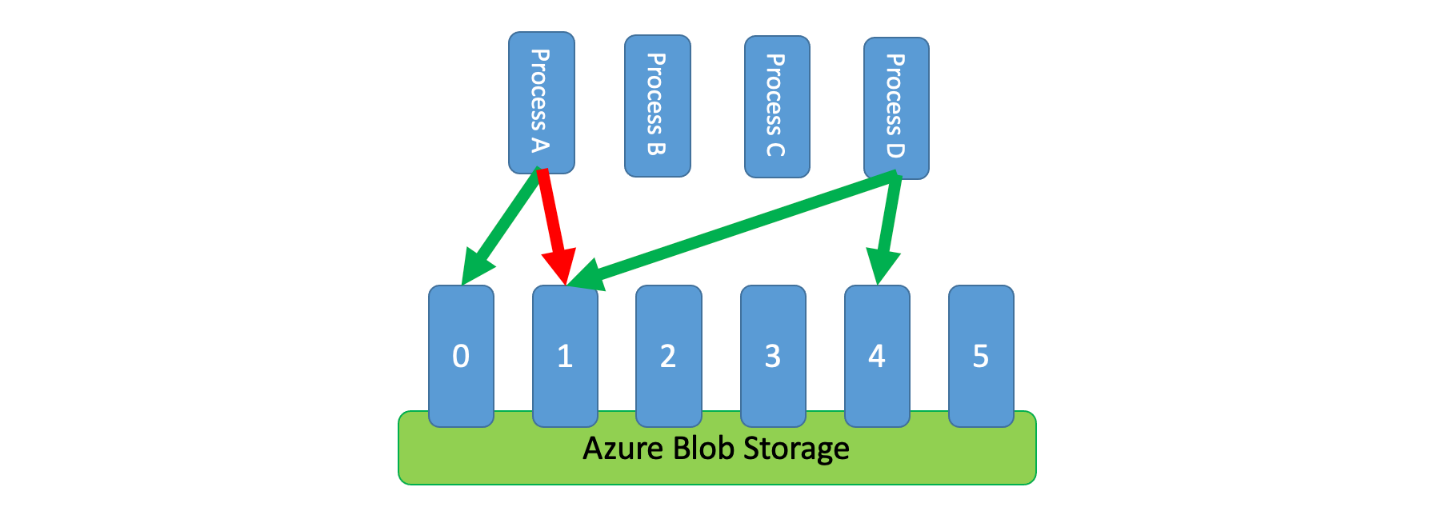
Daarnaast is het soms noodzakelijk dat meerdere niet op elkaar afgestemde processen een in snelheid begrensde service delen. Als u snelheidsbeperking in dit scenario wilt implementeren, kunt u de capaciteit van de service logisch partitioneren en vervolgens een gedistribueerd wederzijds uitsluitingssysteem gebruiken om exclusieve vergrendelingen op deze partities te beheren. De niet-gecoördineerde processen kunnen vervolgens concurreren voor vergrendelingen op deze partities wanneer ze capaciteit nodig hebben. Voor elke partitie waarvoor een proces een vergrendeling bevat, krijgt het een bepaalde hoeveelheid capaciteit.
Als het vertraagde systeem bijvoorbeeld 500 aanvragen per seconde toestaat, kunt u 20 partities maken die elk 25 aanvragen per seconde waard zijn. Als een proces nodig is om 100 aanvragen uit te geven, kan het het gedistribueerde wederzijdse uitsluitingssysteem voor vier partities vragen. Het systeem kan twee partities gedurende 10 seconden verlenen. Het proces zou vervolgens een frequentielimiet hebben van 50 aanvragen per seconde, de taak in twee seconden voltooien en vervolgens de vergrendeling vrijgeven.
Een manier om dit patroon te implementeren, is door Azure Storage te gebruiken. In dit scenario maakt u één 0-byte-blob per logische partitie in een container. Uw toepassingen kunnen dan gedurende korte tijd exclusieve leases verkrijgen op basis van deze blobs (bijvoorbeeld 15 seconden). Voor elke lease waarvoor een aanvraag wordt goedgekeurd, kan de capaciteit van die partitie worden gebruikt. De toepassing moet vervolgens de leasetijd bijhouden, zodat, wanneer de tijd verloopt, de toepassing kan stoppen met het gebruik van de capaciteit die is verleend. Wanneer u dit patroon implementeert, wilt u vaak dat elk proces probeert een willekeurige partitie te leasen wanneer deze capaciteit nodig heeft.
Als u de latentie verder wilt verminderen, kunt u voor elk proces een kleine hoeveelheid exclusieve capaciteit toewijzen. Een proces zou dan alleen een lease voor gedeelde capaciteit aanvragen als het zijn gereserveerde capaciteit moest overschrijden.
Als alternatief voor Azure Storage kunt u dit soort leasebeheersysteem ook implementeren met behulp van technologieën zoals ZooKeeper, enzovoort en Redis/Redsync.
Problemen en overwegingen
Houd rekening met de volgende punten wanneer u besluit hoe u dit patroon implementeert:
Hoewel het frequentiebeperkingspatroon het aantal beperkingsfouten kan verminderen, moet uw toepassing nog steeds eventuele beperkingsfouten die zich kunnen voordoen, correct verwerken.
Zorg ervoor dat herhalingspogingen zijn afgestemd op ratelimiting. Blinde of al te agressieve nieuwe verzoekpogingen kunnen de belasting verhogen en een stortvloed aan nieuwe verzoekpogingen veroorzaken, dus geef back-pressure-signalen (bijvoorbeeld HTTP 429 met
Retry-After) door en gebruik een beperkt aantal nieuwe verzoekpogingen met kleine willekeurige vertragingen tussen de pogingen.Als uw toepassing meerdere werkstromen heeft die toegang hebben tot dezelfde beperkte service, moet u ze allemaal integreren in uw strategie voor snelheidsbeperking. U kunt bijvoorbeeld het in bulk laden van records in een database ondersteunen, maar ook het opvragen van records in diezelfde database. U kunt de capaciteit beheren door ervoor te zorgen dat alle werkstromen worden beperkt door hetzelfde mechanisme voor snelheidsbeperking. U kunt ook afzonderlijke pools met capaciteit reserveren voor elke workstream.
De beperkte service kan in meerdere toepassingen worden gebruikt. In sommige gevallen is het mogelijk om dat gebruik te coördineren (zoals eerder in dit artikel wordt weergegeven). Als u meer throttlingfouten ziet dan verwacht, kan dat erop wijzen dat er concurrentie is tussen toepassingen die toegang proberen te krijgen tot een service. In dit geval moet u overwegen om de doorvoer die wordt opgelegd door uw snelheidsbeperkingsmechanisme tijdelijk te verminderen totdat het gebruik van andere toepassingen afneemt.
Wanneer gebruikt u dit patroon?
Gebruik dit patroon wanneer:
U moet het aantal throttlingfouten verminderen dat wordt veroorzaakt door een service waarvoor een limiet op het aantal aanvragen geldt.
U wilt het verkeer minimaliseren vergeleken met naïeve benaderingen waarbij bij fouten opnieuw wordt geprobeerd.
U moet het geheugenverbruik verminderen door records alleen uit de wachtrij te verwijderen wanneer er voldoende capaciteit is om ze te verwerken.
Dit patroon is mogelijk niet geschikt wanneer:
Voor de bewerking is onmiddellijke, synchrone voltooiing met zeer lage latentie vereist en kan wachtrij- of uitgestelde verwerking niet worden getolereerd.
Het belangrijkste knelpunt is niet de snelheid van aanvragen, maar eerder gelijktijdige verwerking of strijd om resources (bijvoorbeeld CPU-verzadiging of langlopende actieve taken). In deze gevallen zijn instellingen voor schaalbaarheid of concurrentie geschikter.
Ontwerp van werkbelasting
Beoordeel hoe u het patroon voor snelheidsbeperking gebruikt in het ontwerp van een workload om de doelstellingen en principes te ondersteunen die worden behandeld in de pijlers van het Azure Well-Architected Framework. De volgende tabel bevat richtlijnen over hoe dit patroon de doelstellingen van elke pijler ondersteunt.
| Pijler | Hoe dit patroon ondersteuning biedt voor pijlerdoelen |
|---|---|
| betrouwbaarheid ontwerpbeslissingen helpen uw workload tolerant te worden defect te raken en ervoor te zorgen dat deze herstelt naar een volledig functionerende status nadat er een storing is opgetreden. | Deze tactiek beschermt de klant door de beperkingen en kosten van communicatie met een service te erkennen en te respecteren wanneer de service liever overmatig gebruik vermijdt. - RE:07 Zelfbehoud |
Als dit patroon compromissen binnen een pijler introduceert, moet u deze tegen de doelstellingen van de andere pijlers overwegen.
Example
Met de volgende voorbeeldtoepassing kunnen gebruikers records van verschillende typen verzenden naar een API. Elk recordtype heeft een unieke taakprocessor die de volgende stappen uitvoert:
- Validation
- Verrijking
- Invoeging van de record in de database
Alle onderdelen van de toepassing (API, taakprocessor A en taakprocessor B) zijn afzonderlijke processen die onafhankelijk kunnen worden geschaald. De processen communiceren niet rechtstreeks met elkaar.
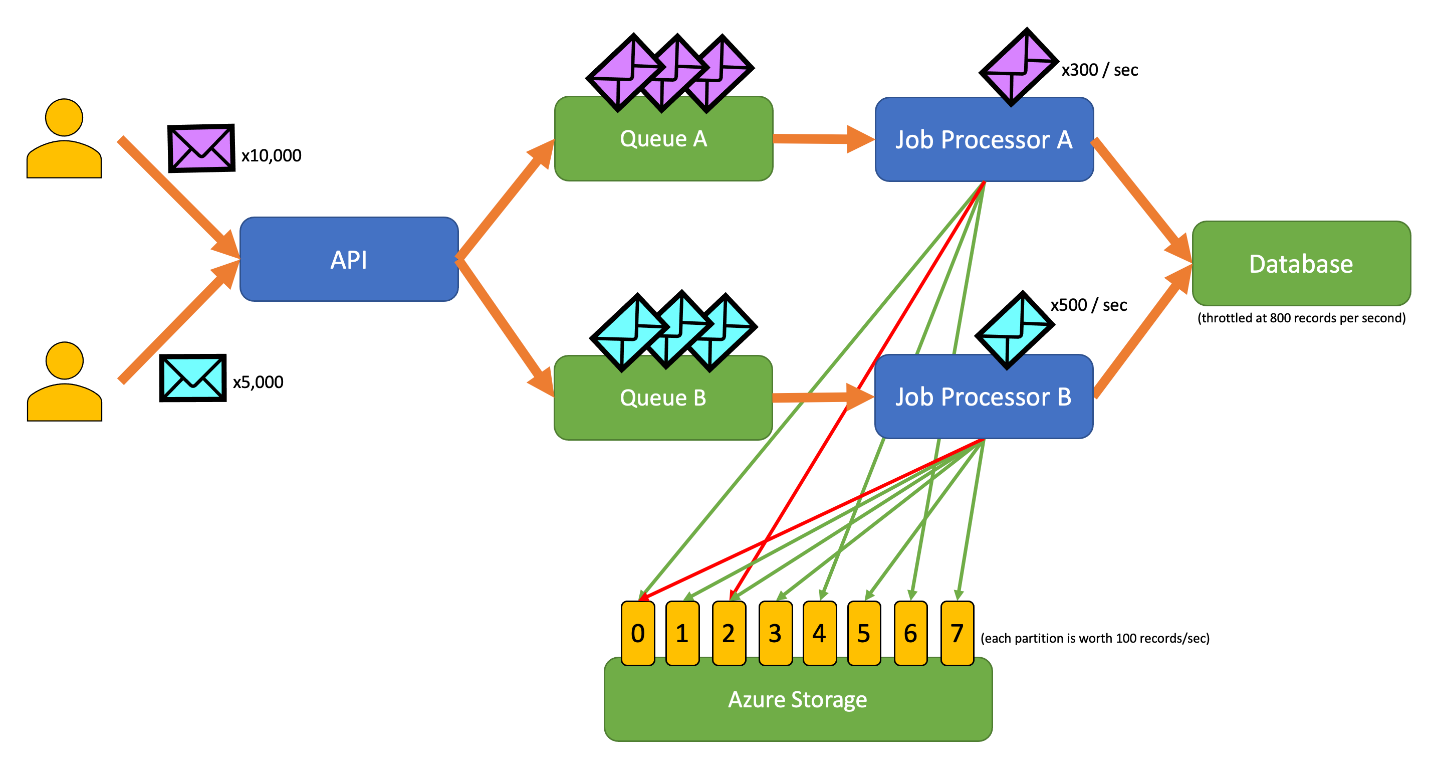
In dit voorbeeld vertegenwoordigt elke bloblease een vast aandeel van de toegestane databasedoorvoer. Een processor kan alleen items uit de wachtrij halen en schrijven met de gezamenlijke snelheid van de leases waarover deze momenteel beschikt. Naarmate processors in de loop van de tijd leases krijgen of verliezen, worden de toegestane schrijfsnelheid gewijzigd, waardoor het totale databaseverkeer binnen de geconfigureerde limiet blijft, terwijl alle in de wachtrij geplaatste werkvoortgang nog steeds wordt toegestaan.
Dit diagram bevat de volgende werkstroom:
- Een gebruiker verzendt 10.000 records van het type A naar de API.
- De API plaatst die 10.000 records in wachtrij A.
- Een gebruiker verzendt 5000 records van het type B naar de API.
- De API plaatst die 5.000 records in wachtrij B.
- Taakprocessor A ziet dat wachtrij A records bevat en probeert een exclusieve lease op blob 2 te verkrijgen.
- Taakprocessor B ziet dat wachtrij B records bevat en probeert een exclusieve lease op blob 2 te verkrijgen.
- Taakverwerker A kan de lease niet verkrijgen.
- Taakprocessor B verkrijgt de lease op blob 2 voor 15 seconden. Aanvragen voor de database kunnen nu met een snelheid van 100 per seconde worden beperkt.
- Taakprocessor B haalt 100 records uit wachtrij B en schrijft ze.
- Er gaat een seconde voorbij.
- Jobprocessor A ziet dat wachtrij A meer records heeft en probeert een exclusieve lease op blob 6 te verkrijgen.
- Jobprocessor B ziet dat wachtrij B meer records heeft en probeert een exclusieve lease op blob 3 te verkrijgen.
- Taakprocessor A krijgt de lease voor blob 6 voor 15 seconden. Aanvragen voor de database kunnen nu met een snelheid van 100 per seconde worden beperkt.
- Jobprocessor B verkrijgt de lease op blob 3 gedurende 15 seconden. Aanvragen voor de database kunnen nu worden beperkt met een snelheid van 200 per seconde. (Het heeft ook de lease voor blob 2.)
- Taakverwerker A verwijdert 100 records uit wachtrij A en schrijft ze.
- Jobprocessor B verwijdert 200 records uit wachtrij B en schrijft ze.
- Er gaat een seconde voorbij.
- Jobprocessor A ziet dat wachtrij A meer records heeft en probeert een exclusieve lease op blob 0 te verkrijgen.
- Jobprocessor B ziet dat wachtrij B meer records heeft en probeert een exclusieve lease op blob 1 te verkrijgen.
- Jobprocessor A verkrijgt de lease op blob 0 gedurende 15 seconden. Aanvragen voor de database kunnen nu worden beperkt met een snelheid van 200 per seconde. (Het heeft ook de lease op blob 6.)
- Jobprocessor B verkrijgt de lease op blob 1 gedurende 15 seconden. Aanvragen voor de database kunnen nu worden beperkt met een snelheid van 300 per seconde. (Het heeft ook het leasecontract voor blobs 2 en 3.)
- Taakverwerker A verwijdert 200 records uit wachtrij A en schrijft ze.
- Jobprocessor B verwijdert 300 records uit wachtrij B en schrijft ze.
- Enzovoort.
Na 15 seconden worden een of beide taken nog steeds niet voltooid. Naarmate de leases verlopen, moet een processor ook het aantal aanvragen verminderen dat deze in de wachtrij zet en schrijft.
 Implementaties van dit patroon zijn beschikbaar in verschillende programmeertalen:
Volgende stappen
De volgende richtlijnen zijn mogelijk ook relevant wanneer u dit patroon implementeert:
Geavanceerde aanvraagbeperking met Azure API Management. Gebruik dit als aanvullende toegangscontrole aan de edge om aanroeplimieten per sleutel en quota af te dwingen, en om consistente backpressure-signalen naar clients terug te sturen.
Kies tussen Azure Messaging-services. Kies de beste robuuste berichteninfrastructuur voor buffering en gecontroleerde gegevensinname.
Tijdelijke fouten in Azure toepassingen verwerken. Ontwerp het nieuwpogingsgedrag zo dat clients hun pogingen correct uitstellen wanneer limieten worden bereikt.
Gerelateerde bronnen
De volgende patronen en richtlijnen zijn mogelijk ook relevant wanneer u dit patroon implementeert:
Throttling. Het frequentiebeperkingspatroon wordt doorgaans geïmplementeerd als reactie op een beperkte service.
Retry. Wanneer aanvragen naar een service waarvoor snelheidsbeperking geldt, resulteren in snelheidsbeperkingsfouten, is het over het algemeen raadzaam die aanvragen na een passend tijdsinterval opnieuw te proberen.
Queue-Based Load Leveling is vergelijkbaar met het Rate Limiting-patroon, maar verschilt op een aantal belangrijke punten:
Snelheidsbeperking hoeft niet noodzakelijkerwijs wachtrijen te gebruiken om de belasting te beheren, maar moet wel gebruikmaken van een duurzame berichtenservice. Een frequentiebeperkingspatroon kan bijvoorbeeld gebruikmaken van services zoals Apache Kafka of Event Hubs.
Het snelheidsbeperkingspatroon introduceert het concept van een gedistribueerd systeem voor wederzijdse uitsluiting over partities heen, waarmee u capaciteit kunt beheren voor meerdere ongecoördineerde processen die met dezelfde service met snelheidsbeperking communiceren.
Het queue-based load-leveling-patroon is toepasbaar wanneer er een prestatieverschil tussen services is of wanneer u de veerkracht wilt verbeteren. Dat is dus een breder patroon dan rate limiting, dat zich specifieker richt op efficiënte toegang tot een afgeknepen service.