Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Deze handleiding laat zien hoe u de tolerantie valideert van een Valkey-cluster dat is geïmplementeerd in Azure Kubernetes Service (AKS) met behulp van het locust load testing-framework. Het helpt bij het bouwen van een testclient, het implementeren ervan in AKS, het simuleren van fouten en het analyseren van clustergedrag.
Notitie
Dit artikel bevat verwijzingen naar de term master (primair), een term die niet langer door Microsoft wordt gebruikt. Wanneer de term uit de Valkey-software wordt verwijderd, wordt deze uit dit artikel verwijderd.
Voorbeeldclienttoepassing bouwen voor Valkey
De volgende stappen laten zien hoe u een voorbeeldclienttoepassing voor Valkey bouwt.
De voorbeeldclienttoepassing maakt gebruik van het locust load testing framework om een workload te simuleren op het Valkey-cluster dat u hebt geconfigureerd en geïmplementeerd. De Python-code implementeert een Locust-gebruikersklasse die verbinding maakt met het Valkey-cluster en voert een set- en getoperatie uit. U kunt deze klasse uitbreiden om complexere bewerkingen te implementeren.
Notitie
U wordt aangeraden de veiligste verificatiestroom te gebruiken die beschikbaar is. De verificatiestroom die in deze procedure wordt beschreven, vereist een zeer hoge mate van vertrouwen in de toepassing en draagt risico's die niet aanwezig zijn in andere stromen. U moet deze stroom alleen gebruiken wanneer andere veiligere stromen, zoals beheerde identiteiten, niet haalbaar zijn.
Maak het Dockerfile en
requirements.txtplaats deze in een nieuwe map met behulp van de volgende opdrachten:mkdir valkey-client cd valkey-client cat > Dockerfile <<EOF FROM python:3.10-slim-bullseye COPY requirements.txt . COPY locustfile.py . RUN pip install --upgrade pip && pip install --no-cache-dir -r requirements.txt EOF cat > requirements.txt <<EOF valkey locust EOFMaak het
locustfile.pybestand met de code van de Valkey-clienttoepassing:cat > locustfile.py <<EOF import time from locust import between, task, User, events,tag, constant_throughput from valkey import ValkeyCluster from random import randint class ValkeyLocust(User): wait_time = constant_throughput(50) host = "valkey-cluster.valkey.svc.cluster.local" def __init__(self, *args, **kwargs): super(ValkeyLocust, self).__init__(*args, **kwargs) self.client = ValkeyClient(host=self.host) def on_stop(self): self.client.close() @task @tag("set") def set_value(self): self.client.set_value("set_value") @task @tag("get") def get_value(self): self.client.get_value("get_value") class ValkeyClient(object): def __init__(self, host, *args, **kwargs): super().__init__(*args, **kwargs) with open("/etc/valkey-password/valkey-password-file.conf", "r") as f: self.password = f.readlines()[0].split(" ")[1].strip() self.host = host self.vc = ValkeyCluster(host=self.host, port=6379, password=self.password, username="default", cluster_error_retry_attempts=0, socket_timeout=2, keepalive=1 ) def set_value(self, key, command='SET'): start_time = time.perf_counter() try: result = self.vc.set(randint(0, 1000), randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result def get_value(self, key, command='GET'): start_time = time.perf_counter() try: result = self.vc.get(randint(0, 1000)) if not result: result = '' length = len(str(result)) total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=length, ) except Exception as e: total_time = (time.perf_counter()- start_time) * 1000 events.request.fire( request_type=command, name=key, response_time=total_time, response_length=0, exception=e ) result = '' return result EOF
De Docker-image bouwen en pushen naar ACR
Bouw de Docker-afbeelding en upload het naar Azure Container Registry (ACR) met behulp van de
az acr buildopdracht.az acr build --image valkey-client --registry ${MY_ACR_REGISTRY} .Controleer of de image succesvol is gepusht met behulp van de
az acr repository listopdracht.az acr repository list --name ${MY_ACR_REGISTRY} --output tableIn de uitvoer moet de
valkey-clientafbeelding worden weergegeven, zoals in het volgende voorbeeld:Result ---------------- valkey-client
De voorbeeldclient-pod implementeren in AKS
Maak een
Poddie de Valkey-clientafbeelding gebruikt, die in de vorige stap is gebouwd met dekubectl applyopdracht. De podspecificatie bevat het Secret Store CSI-volume met het Valkey-wachtwoord dat de client gebruikt om verbinding te maken met het Valkey-cluster.kubectl apply -f - <<EOF --- kind: Pod apiVersion: v1 metadata: name: valkey-client namespace: valkey spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: agentpool operator: In values: - nodepool1 containers: - name: valkey-client image: ${MY_ACR_REGISTRY}.azurecr.io/valkey-client command: ["locust", "--processes", "4"] volumeMounts: - name: valkey-password mountPath: "/etc/valkey-password" volumes: - name: valkey-password csi: driver: secrets-store.csi.k8s.io readOnly: true volumeAttributes: secretProviderClass: "valkey-password" EOFStel port forwarding in voor poort 8089 om toegang te krijgen tot de Locust-webinterface op uw lokale machine met behulp van de
kubectl port-forward-opdracht.kubectl port-forward -n valkey valkey-client 8089:8089Open de locust-webinterface bij
http://localhost:8089en start de test. U kunt het aantal gebruikers en de spawnsnelheid aanpassen om een workload op het Valkey-cluster te simuleren. In de volgende grafiek worden 100 gebruikers en een spawnfrequentie van 10 gebruikt.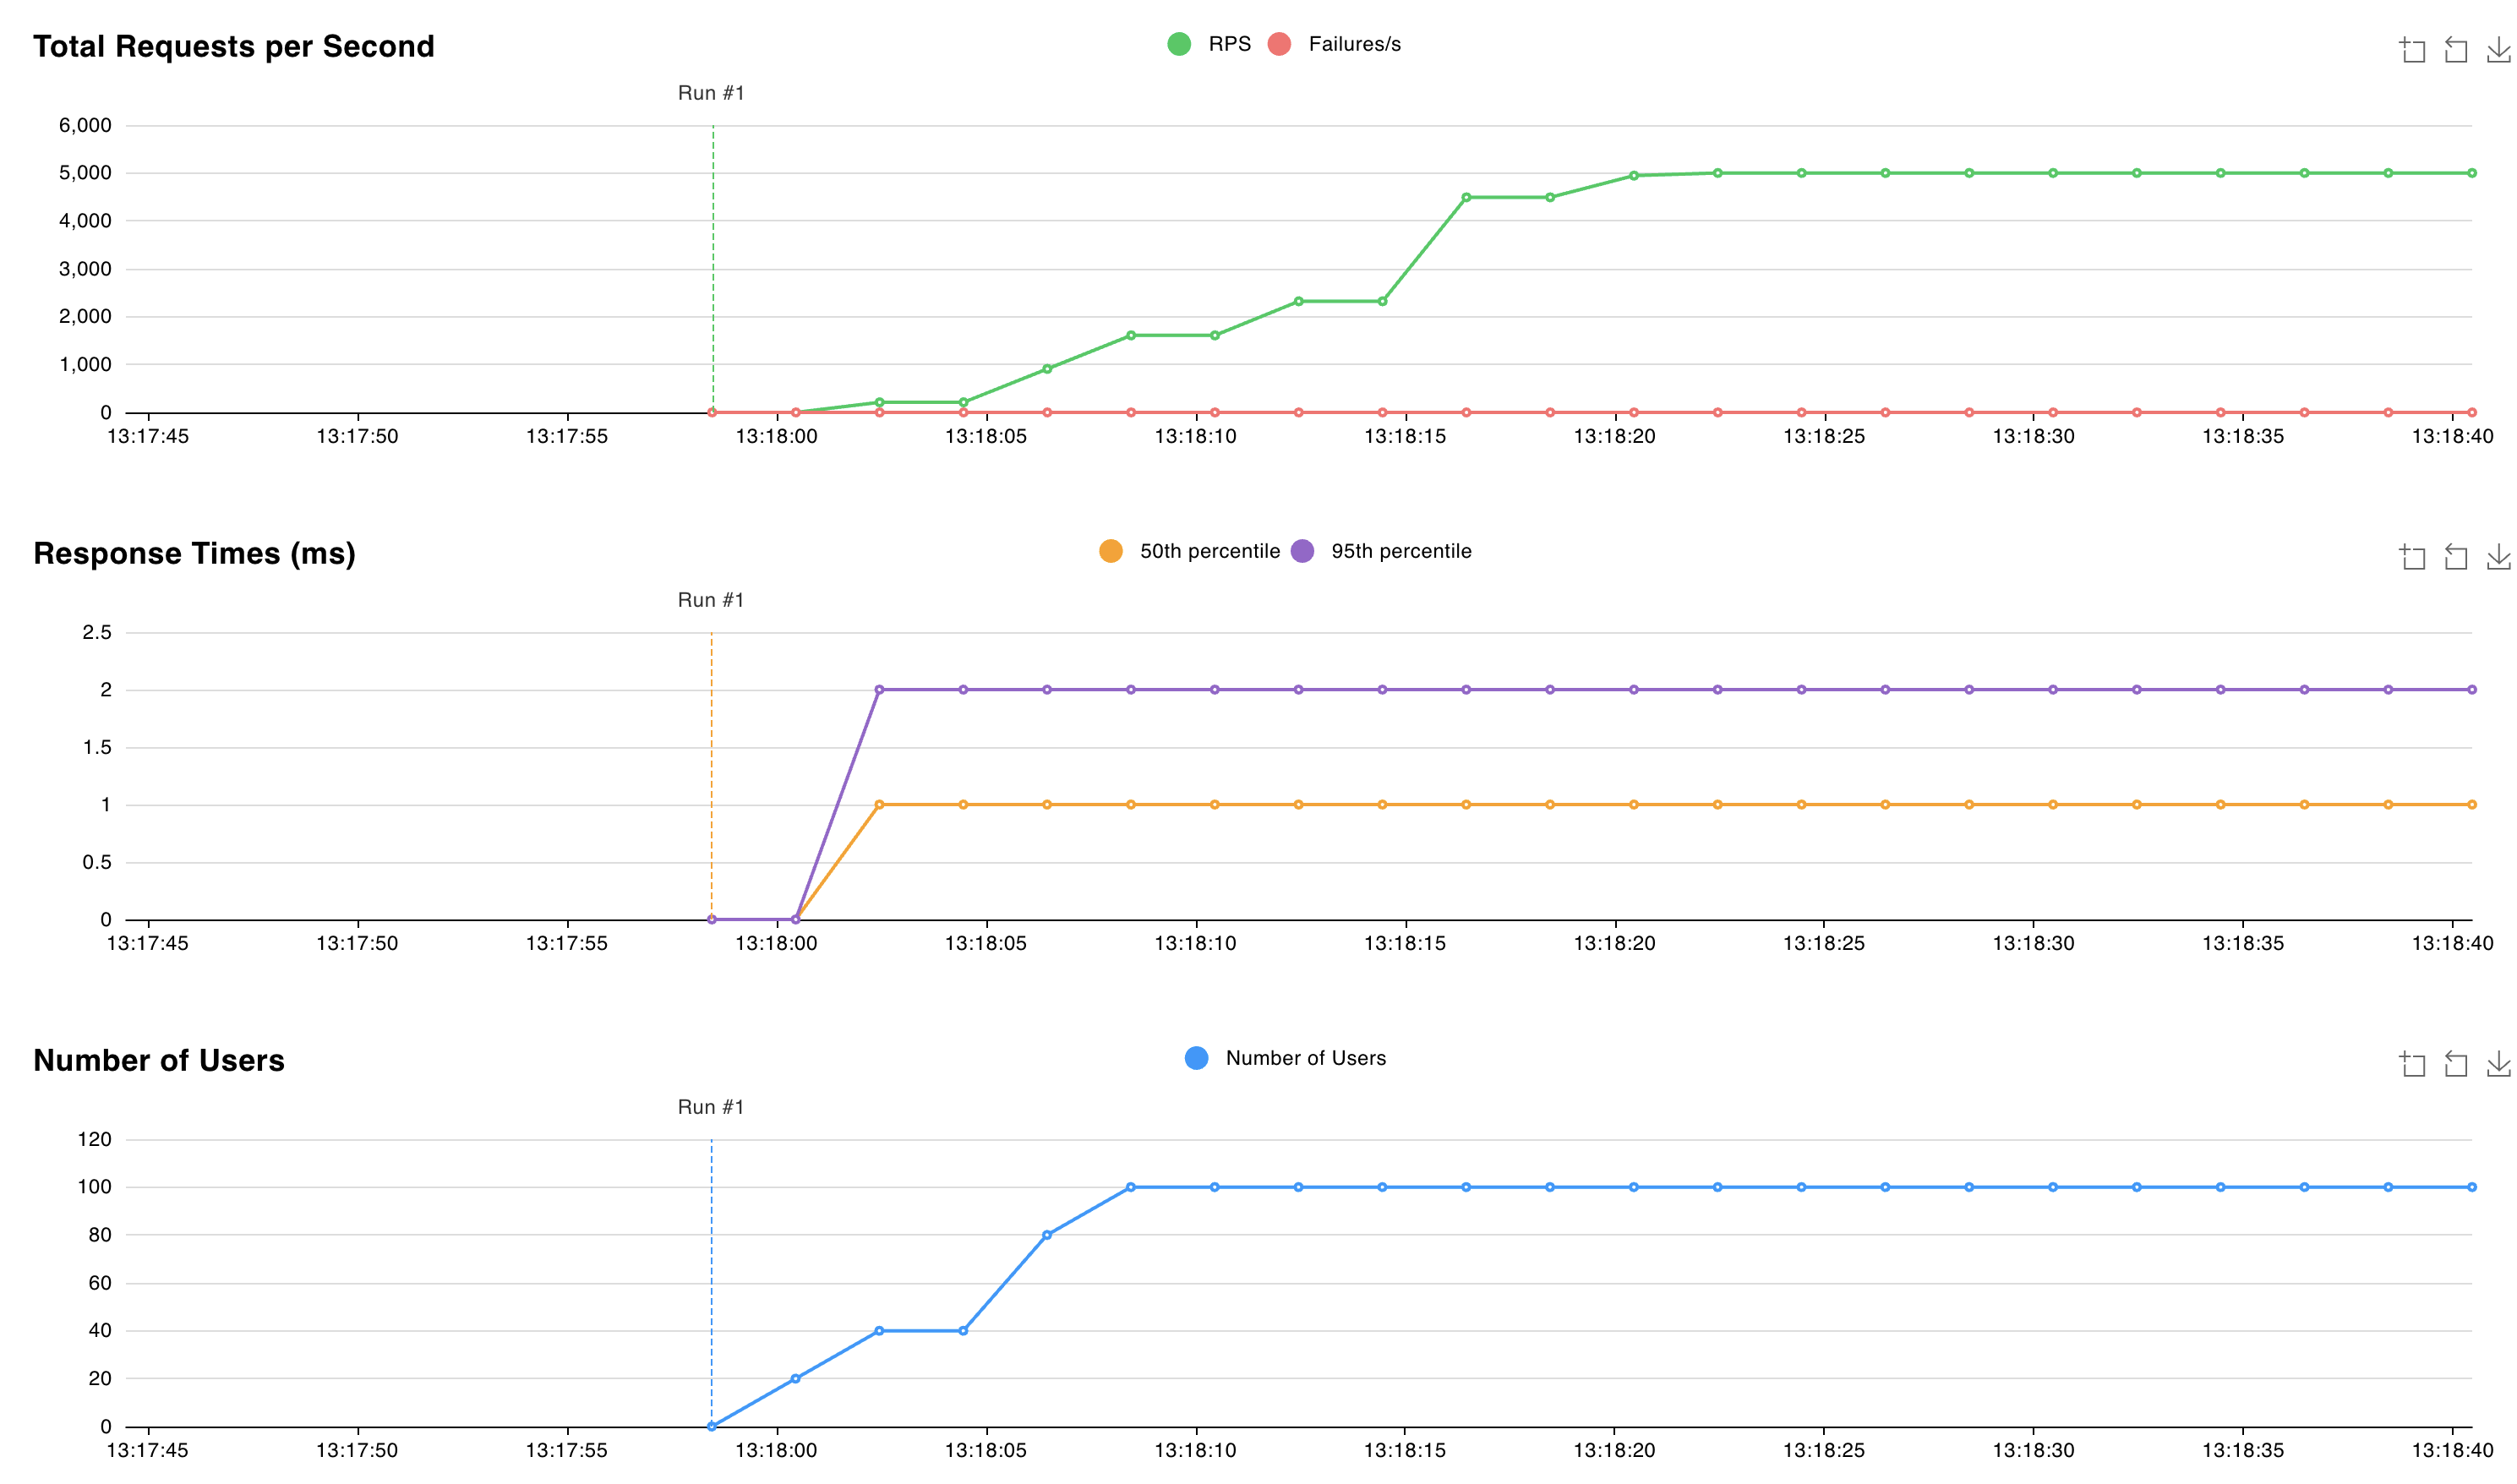
Fout simuleren en valkey-clustergedrag observeren
Simuleer een storing door de
StatefulSette verwijderen met behulp van dekubectl deleteopdracht en de--cascade=orphanvlag. Het doel is om één pod te kunnen verwijderen zonder deStatefulSetverwijderde pod onmiddellijk opnieuw te maken.kubectl delete statefulset valkey-masters --cascade=orphanVerwijder de
valkey-masters-0pod met behulp van dekubectl delete podopdracht.kubectl delete pod valkey-masters-0Controleer de lijst met pods met behulp van de
kubectl get podsopdracht.kubectl get podsDe uitvoer moet aangeven dat de pod
valkey-masters-0is verwijderd. De andere pods moeten deRunningstatus hebben, zoals wordt weergegeven in het volgende voorbeeld:NAME READY STATUS RESTARTS AGE valkey-client 1/1 Running 0 6m34s valkey-masters-1 1/1 Running 0 16m valkey-masters-2 1/1 Running 0 16m valkey-replicas-0 1/1 Running 0 16m valkey-replicas-1 1/1 Running 0 16m valkey-replicas-2 1/1 Running 0 16mHaal de logboeken van de
valkey-replicas-0pod op met behulp van dekubectl logs valkey-replicas-0opdracht.kubectl logs valkey-replicas-0In de uitvoer zien we dat de volledige gebeurtenis ongeveer 18 seconden duurt:
1:S 05 Nov 2024 12:18:53.961 * Connection with primary lost.
1:S 05 Nov 2024 12:18:53.961 * Caching the disconnected primary state.
1:S 05 Nov 2024 12:18:53.961 * Reconnecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:53.961 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:53.964 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:54.910 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:18:54.910 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:18:54.912 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:18:55.920 * Connecting to PRIMARY 10.224.0.250:6379
[..CUT..]
1:S 05 Nov 2024 12:19:10.056 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:10.057 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:10.058 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:10.709 * Node c44d4b682b6fb9b37033d3e30574873545266d67 () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:10.864 * NODE 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e () possibly failing.
1:S 05 Nov 2024 12:19:11.066 * 10000 changes in 60 seconds. Saving...
1:S 05 Nov 2024 12:19:11.068 * Background saving started by pid 29
1:S 05 Nov 2024 12:19:11.068 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:11.068 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:11.069 # Error condition on socket for SYNC: Connection refused
29:C 05 Nov 2024 12:19:11.090 * DB saved on disk
29:C 05 Nov 2024 12:19:11.090 * Fork CoW for RDB: current 0 MB, peak 0 MB, average 0 MB
1:S 05 Nov 2024 12:19:11.169 * Background saving terminated with success
1:S 05 Nov 2024 12:19:11.884 * FAIL message received from ba36d5167ee6016c01296a4a0127716f8edf8290 () about     9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e ()
1:S 05 Nov 2024 12:19:11.884 # Cluster state changed: fail
1:S 05 Nov 2024 12:19:11.974 * Start of election delayed for 510 milliseconds (rank #0, offset 7225807).
1:S 05 Nov 2024 12:19:11.976 * Node d43f370a417d299b78bd1983792469fe5c39dcdf () reported node 9e7c43890613cc3ad4006a9cdc0b5e5fc5b6d44e     () as not reachable.
1:S 05 Nov 2024 12:19:12.076 * Connecting to PRIMARY 10.224.0.250:6379
1:S 05 Nov 2024 12:19:12.076 * PRIMARY <-> REPLICA sync started
1:S 05 Nov 2024 12:19:12.076 * Currently unable to failover: Waiting the delay before I can start a new failover.
1:S 05 Nov 2024 12:19:12.078 # Error condition on socket for SYNC: Connection refused
1:S 05 Nov 2024 12:19:12.581 * Starting a failover election for epoch 15.
1:S 05 Nov 2024 12:19:12.616 * Currently unable to failover: Waiting for votes, but majority still not reached.
1:S 05 Nov 2024 12:19:12.616 * Needed quorum: 2. Number of votes received so far: 1
1:S 05 Nov 2024 12:19:12.616 * Failover election won: I'm the new primary.
1:S 05 Nov 2024 12:19:12.616 * configEpoch set to 15 after successful failover
1:M 05 Nov 2024 12:19:12.616 * Discarding previously cached primary state.
1:M 05 Nov 2024 12:19:12.616 * Setting secondary replication ID to c0b5b2df8a43b19a4d43d8f8b272a07139e0ca34, valid up to offset:     7225808. New replication ID is 029fcfbae0e3e4a1dccd73066043deba6140c699
1:M 05 Nov 2024 12:19:12.616 * Cluster state changed: ok
Tijdens dit tijdvenster van 18 seconden zien we dat schrijfbewerkingen naar de shard die deel uitmaakt van de verwijderde pod mislukken en dat het Valkey-cluster een nieuwe primaire selecteert. De aanvraaglatentie piekt naar 60 ms gedurende dit tijdvenster.
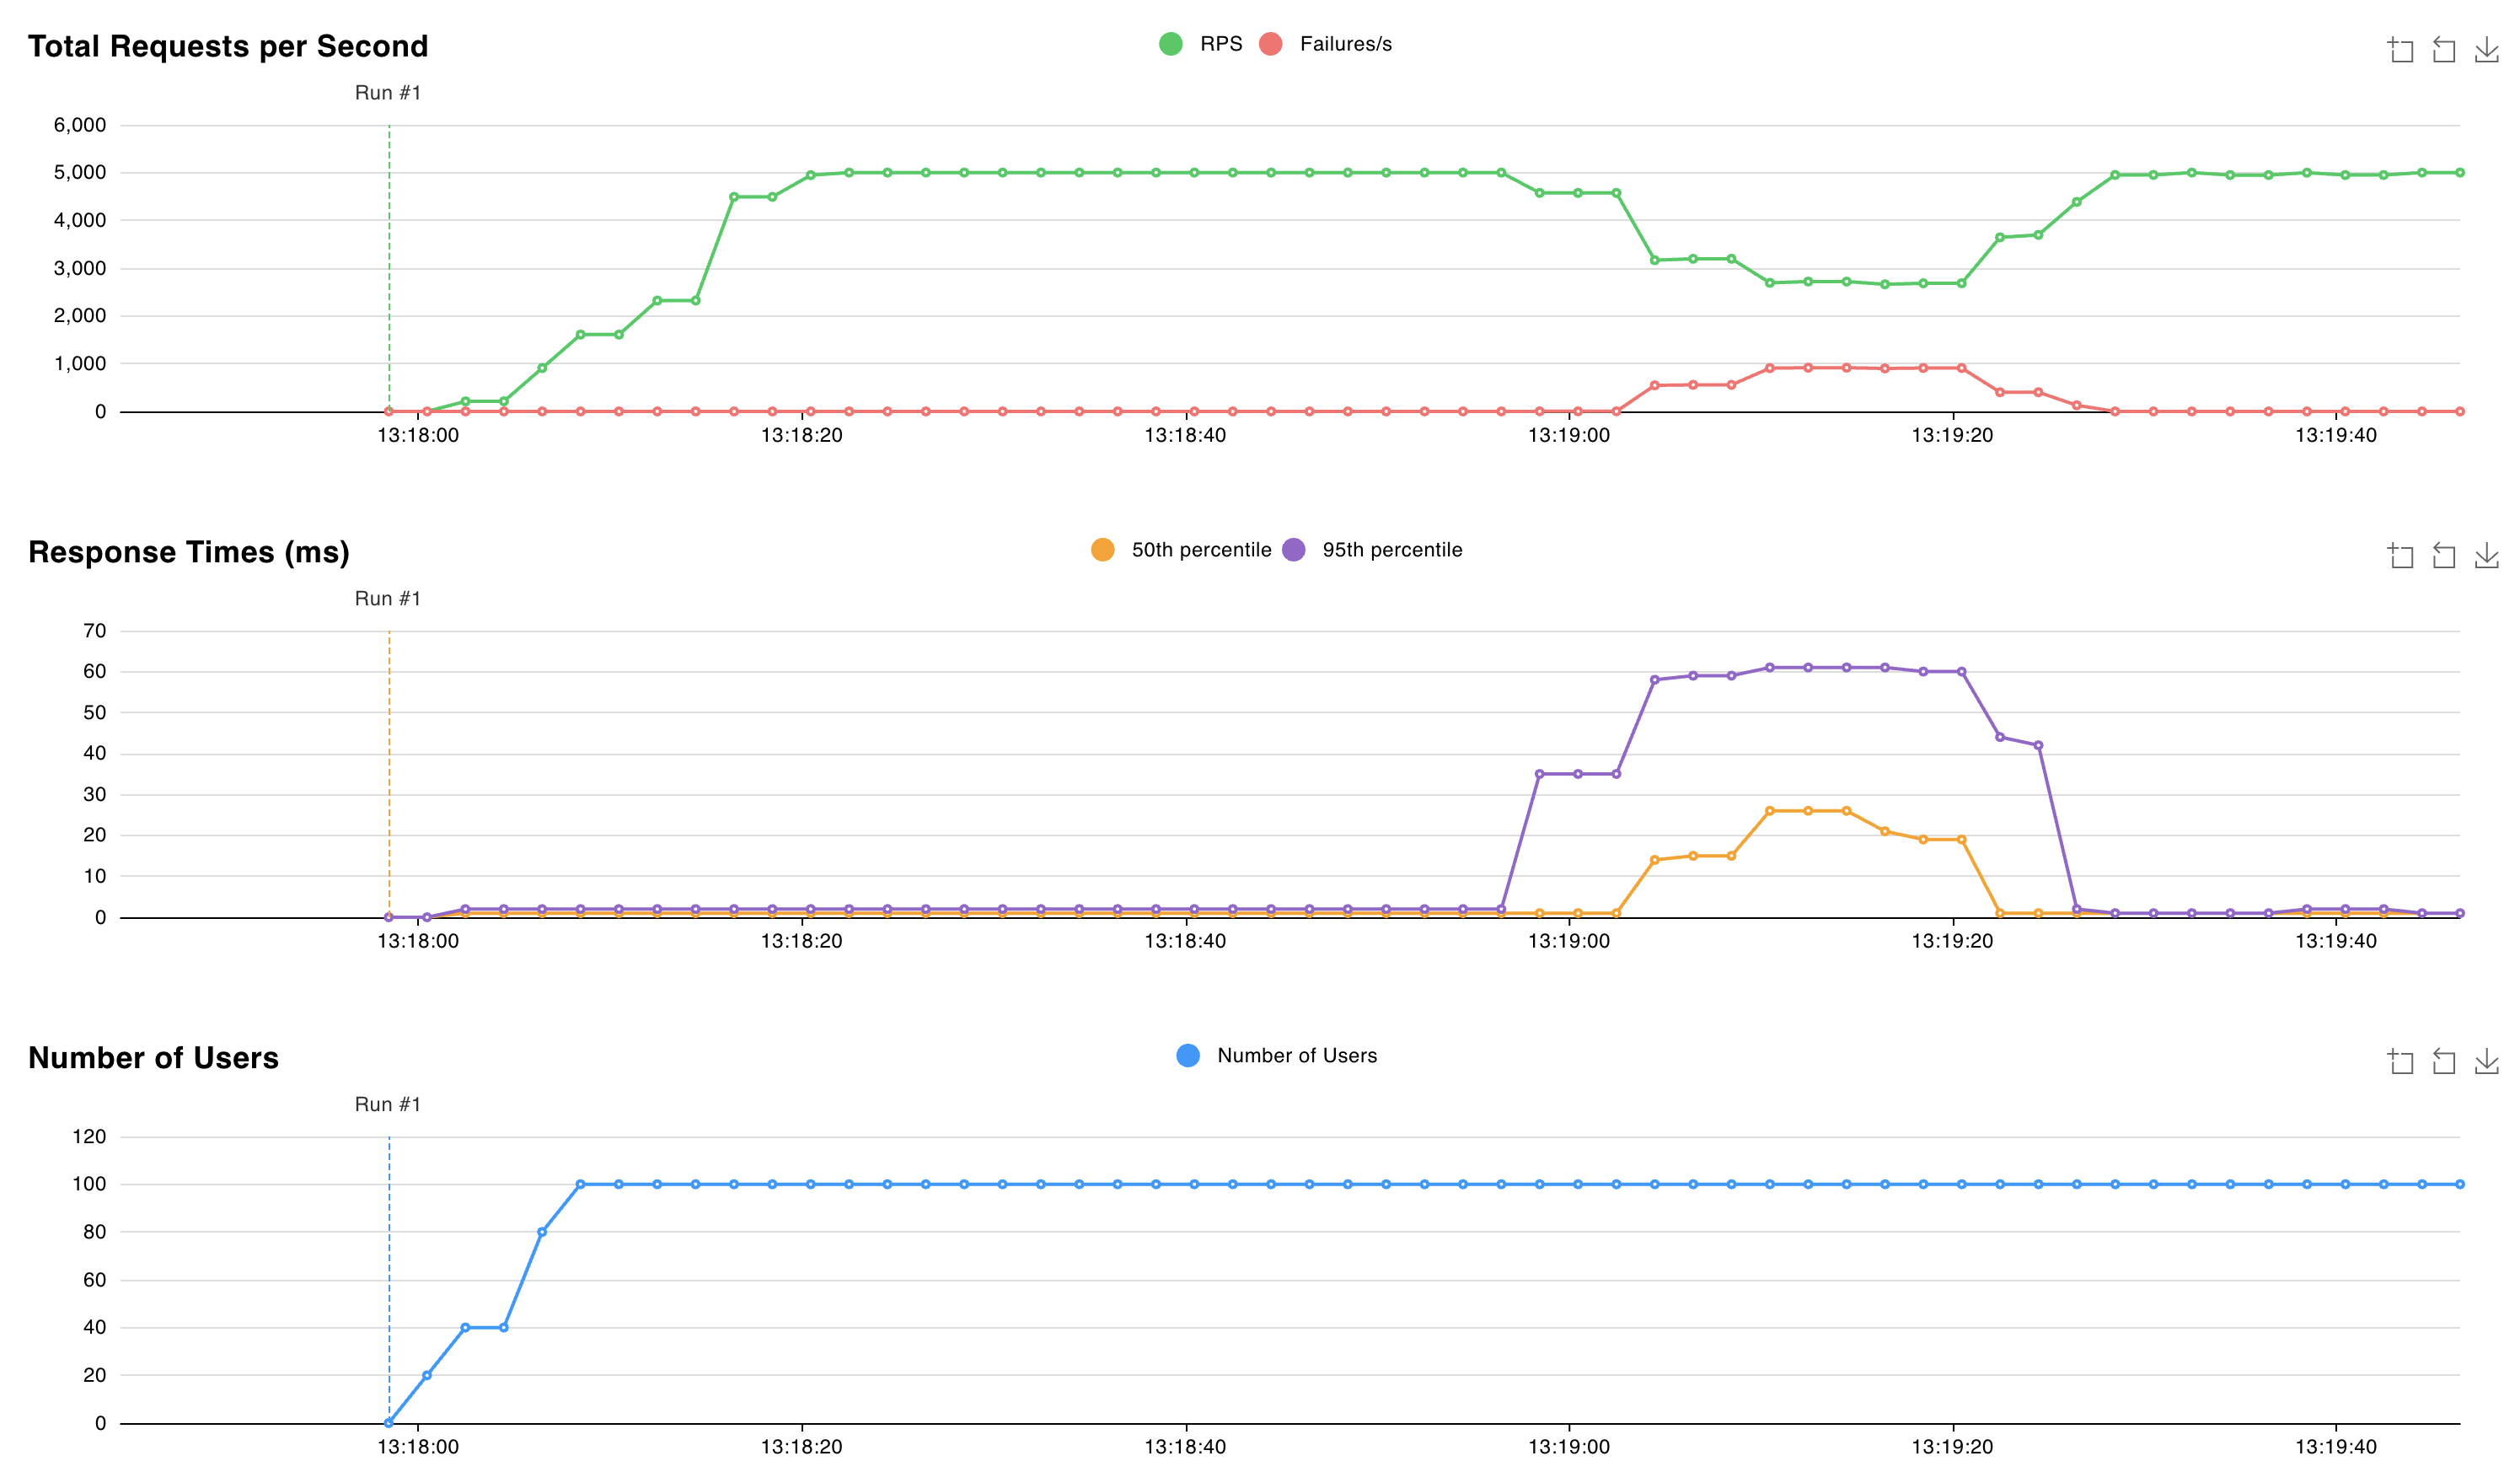
Nadat de nieuwe primaire server is geselecteerd, blijft het Valkey-cluster aanvragen verwerken met een latentie van ongeveer 2 ms.
Volgende stap
Bijdragers
Microsoft onderhoudt dit artikel. De volgende inzenders hebben het oorspronkelijk geschreven:
- Nelly Kiboi | servicemonteur
- Saverio Proto | Principal Customer Experience Engineer