Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Important
Deze functie bevindt zich in de bètaversie.
Managed agent-geheugen geeft je agenten duurzaam, langdurig geheugen dat gedurende gesprekken blijft bestaan. Azure Databricks slaat het geheugen op in Lakebase en beheert de opslag, indexering en semantische zoekopdracht voor je, zodat je agenten gebruikersvoorkeuren, eerdere beslissingen en opgebouwde context kunnen onthouden zonder dat jij een database hoeft te beheren.
Note
Tijdens de preview word je gefactureerd voor de onderliggende Lakebase-instantie die je geheugenvermeldingen opslaat. Er zijn geen extra kosten van toepassing voor het geheugen van de beheerde agent. De prijzen kunnen veranderen naarmate de preview vordert.
Gebruik managed memory wanneer je wilt dat je agenten:
- Onthoud gebruikersvoorkeuren, feiten en beslissingen over afzonderlijke gesprekken.
- Personaliseer de antwoorden op basis van wat een agent in eerdere sessies heeft geleerd.
- Deel opgebouwde kennis tussen agenten en projecten.
- Verbeter de nauwkeurigheid en efficiëntie in de loop van de tijd.
Managed memory werkt met agents die op elk framework zijn gebouwd. Gebruik voor kortdurende gespreksgeschiedenis binnen één interactie beheerde agentsessies.
Requirements
- Installeer Python 3.10 of hoger, om de AgentKit SDK te gebruiken. AgentKit SDK is de Databricks Python-client voor agent-API's die in de onderstaande voorbeelden worden gebruikt. Je kunt de REST API ook direct aanroepen vanuit elke taal, zonder Python-vereiste.
Hoe beheerd geheugen werkt
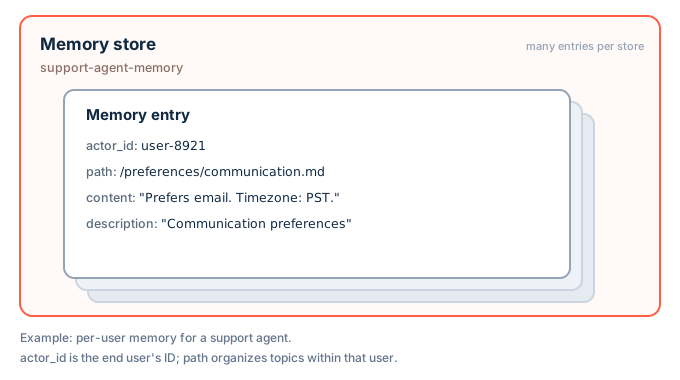
Beheerd geheugen heeft twee niveaus:
- Een memory store is de container binnen een werkruimte voor de herinneringen van een agent. Door een store te maken, wordt de onderliggende Lakebase-opslag automatisch ingericht. Je adresseert een winkel aan de hand van de
display_name. - Een geheugenvermelding is een individueel stuk inhoud in een winkel. Elke vermelding bevat een vrije tekst
content, een kortedescriptiontekst die wordt gebruikt voor het ophalen, en een set velden die het organiseren en partitioneren:-
actor_id(vereist): aan wie het geheugen toebehoort, zoals een eindgebruiker of een andere agent. -
session_id(optioneel): registreert van welke sessie het geheugen is vastgelegd, voor tracering en herkomst. Laat het niet staan voor geheugen dat niet aan een specifieke sessie gekoppeld is. -
path(vereist): een bestandssysteem-achtig pad dat elementen binnen een actor organiseert, zoals/preferences/response-style.md.
-
Een entry wordt uniek geïdentificeerd door de combinatie van actor_id, session_id, en path.
Ophalen
Haal geheugen op twee manieren op:
-
Vermeld vermeldingen voor een actor, optioneel gefilterd op
session_idof met eenpathvoorvoegsel. Gebruik dit om te bladeren of een index te renderen van wat een makelaar weet. - Zoek naar items voor een actor met een zoekopdracht in natuurlijke taal. Zoeken geeft de meest relevante vermeldingen terug, gerangschikt op basis van een volledige tekst (BM25) relevantiescore.
Get started
Deze voorbeelden richten beheerd geheugen op voor een supportagent: ze maken een geheugenopslag aan, slaan de voorkeur van een gebruiker op en roepen deze op in een later gesprek. Kies de klant die bij jouw project past. Een geheugenopslag display_name moet 3 tot 56 tekens bevatten, beginnen met een kleine letter, eindigen met een letter of cijfer, en alleen kleine letters, cijfers en koppeltekens bevatten.
AgentKit SDK
De AgentKit SDK is de Databricks Python-client voor agent-API's, verspreid in het databricks-agentbricks pakket. Het authenticeert met de SDK van Databricks WorkspaceClient.
Installeer de AgentKit SDK:
pip install databricks-agentbricksMaak een geheugenopslag aan voor je agent.
AgentKitClientAuthenticeert met uwWorkspaceClientgegevens:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Sla een geheugen op nadat de agent iets duurzaams over een gebruiker heeft geleerd.
actor_idis wiens geheugen dit is,pathorganiseert het binnen die actor, endescriptionverbetert het ophalen:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )Herinner de herinneringen van de gebruiker in een later gesprek met een zoekopdracht in natuurlijke taal:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
REST API
De clients roepen de REST API aan onder /api/2.0/agents/memory-stores. Roep het rechtstreeks aan in andere talen dan Python.
Genereer een OAuth-token met de Databricks CLI:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Maak een geheugenopslag aan voor je agent:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"display_name": "support-agent-memory", "description": "Support agent memory"}'
Sla een geheugenvermelding op voor een gebruiker.
actor_idis wiens geheugen dit is,pathorganiseert het endescriptionverbetert het ophalen:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Roep de herinneringen van de gebruiker op met een zoekopdracht in natuurlijke taal:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Geef je agent geheugentools
Om een agent te laten bepalen wanneer geheugen wordt opgeslagen en teruggeroepen, wrappen de clientoperaties als tools en instrueren de agent wanneer ze gebruikt moeten worden in zijn systeemprompt. Stel de actor_id in in code van een vertrouwde applicatie op basis van de geverifieerde identiteit van de eindgebruiker. Laat het model nooit kiezen wiens geheugen het leest of schrijft.
Het volgende voorbeeld omvat de AgentKit SDK memory_store van Get Started als tools voor de OpenAI Agents SDK.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user."""
        memory_store.add(actor_id=actor_id, path=path, content=content, description=description)
        return f"Saved memory at {path}"

    return [search_memory, save_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences and recall them when relevant.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
Hetzelfde patroon werkt met de Claude Agent SDK en andere frameworks: wrap de zoek- en toevoegoperaties van de store als het tooltype van het framework.
Partitie en veilig geheugen
In een winkel kun je met actor_id onderscheid maken tussen van wie welke herinneringen zijn. Elke lijst en zoekopdracht is beperkt tot één enkel actor_id, dus kies de strategie die aansluit bij wat je makelaar moet onthouden:
-
Persoonlijk geheugen voor elke gebruiker: Stel
actor_idin op de geverifieerde identiteit van de eindgebruiker. Elke gebruiker krijgt zijn eigen partitie, en de agent roept alleen de invoer van die gebruiker op.- Voorbeeld: Een supportmedewerker onthoudt de communicatievoorkeuren en eerdere tickets van één gebruiker.
-
Gedeeld geheugen voor een groep: Stel
actor_idin op een vaste sleutelwaarde die je kiest, bijvoorbeeld een team-, project- of organisatie-ID. Iedereen leest en schrijft dezelfde herinneringen.- Voorbeeld: Een teamagent onthoudt een gedeeld woordenlijstje met bedrijfstermen en interne conventies.
-
Geheugen opgedeeld op basis van iets anders: Maak
actor_idop basis van je eigen waarden, zoals een tenant-ID of eenuser:projectsamengestelde waarde.-
Voorbeeld: Een multi-tenant app stelt zo in
actor_iddat{tenant}:{user}de gebruikers van elke klant van elkaar geïsoleerd blijven.
-
Voorbeeld: Een multi-tenant app stelt zo in
Stel actor_id in je applicatiecode in vanuit de context van de vertrouwde caller: de geverifieerde eindgebruikersidentiteit voor per-gebruiker geheugen, of een vertrouwde team- of projectsleutel voor gedeeld geheugen. Laat het model het nooit kiezen. Als je strategie afhankelijk is van een eindgebruikersidentiteit, wijs dan verzoeken af die er geen bevatten, in plaats van terug te vallen op een gedeelde actor_id.
Warning
actor_id scheidt geheugens, maar het is geen toegangsbeveiliging. Beheerde geheugenopslagen zijn workspace-scoped, dus elke principal die een opslag kan bereiken kan elke invoer lezen en schrijven over alle actoren. De winkel, niet de acteur, is de beveiligingsgrens. Voor strikte isolatie tussen tenants of gebruikers, maak per grens een aparte geheugenopslag aan.
Om een andere principal, zoals de serviceprincipal van uw agent, een store te laten gebruiken, verleen deze toegang via de grant-permission-operatie van de store (memory_store.grant_permission(principal_id) in de AgentKit SDK).
Limitations
- Beheerd geheugen biedt alleen langetermijngeheugen. Voor korte gespreksgeschiedenis, zie managed agent sessions.
- Zoeken is een op relevantie gerangschikte volledige-tekstzoekbewerking (BM25) die een top-N-resultaatset van maximaal 100 items retourneert. Het ondersteunt geen paginering of vectorgelijkheidszoekopdracht.
- Toegangscontrole wordt op winkelniveau gehandhaafd. Toegangscontrole per item en per actor is niet beschikbaar.
- De winkel
display_nameis onveranderlijk na de creatie. Alleendescriptionkan worden bijgewerkt.