Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Migreer uw workloads van klassieke berekening naar serverloze berekeningen. Serverloze rekenprocessen verwerken het inrichten, schalen, runtime-upgrades en optimalisatie automatisch.
De meeste klassieke workloads kunnen worden gemigreerd met minimale of geen codewijzigingen. Deze pagina is gericht op deze workloads. Sommige functies, zoals df.cache, worden nog niet ondersteund op serverloos, maar er zijn geen codewijzigingen nodig zodra deze beschikbaar zijn. Bepaalde werkbelastingen die afhankelijk zijn van R- of Scala-notebooks, vereisen klassieke berekeningen en kunnen niet worden gemigreerd naar serverloos. Zie Serverloze rekenbeperkingen voor een volledige lijst met huidige beperkingen.
Migreren met de migratieagent
Important
Deze functie bevindt zich in de bètaversie. Workspace-beheerders kunnen het inschakelen via de Previews-pagina door zich aan te melden bij de Compute Agent-preview . Zie Azure Databricks previews beheren.
Je kunt een migratieagent gebruiken om een enkel notebook of taak te migreren naar serverless compute. De agent beoordeelt de omgeving, bibliotheken, Spark-configuraties, tags en code van de workload, en stelt vervolgens elke wijziging voor als een individueel voorstel dat je kunt accepteren of afwijzen. Geaccepteerde wijzigingen worden ter plaatse toegepast en kunnen worden teruggedraaid.
Wat de makelaar beoordeelt en verandert
| Area | Wat de agent doet |
|---|---|
| Omgeving en bibliotheken | Vertaalt bibliotheekinstallaties naar een specificatie voor een serverless omgeving, inclusief installaties van %pip, cluster-init-scripts, clusterbibliotheken voor taken en verwijzingen naar een privé-pakketindex. |
| Omgevingsvariabelen | Vertaalt clusteromgevingsvariabelen naar hun serverloze equivalenten, waarbij geheime referenties van de werkruimte behouden blijven en platformbeheerde waarden worden weggelaten. |
| Data- en opslagtoegang | Herschrijft serverless-incompatibele paden, zoals lokale schijfpaden, dbfs:/ en mountpaden, zodat ze verwijzen naar Unity Catalog-volumes. De agent past automatisch ondubbelzinnige herschrijvingen toe en vraagt je een volume te kiezen wanneer het doel ambigu is. |
| Spark-configuraties | Classificeert elke Spark-configuratie, geeft commentaar op configuraties die veilig zijn om te verwijderen, en markeert en verwijdert configuraties die serverless niet ondersteunt. Omvat zowel configuraties die aan een cluster zijn gekoppeld als configuraties binnen het notebook. |
| Werklastcode | Herschrijft code die serverless niet ondersteunt tot compatibele equivalenten, zoals RDD-operaties die worden herschreven naar DataFrame-operaties, en past code aan voor ANSI-mode SQL-gedrag op serverless. |
| Tags | Vertaalt aangepaste clustertags, zoals een kostencentrumtag, naar hun serverless equivalenten. |
| Prestatiemodus | Stelt een prestatiemodus voor op basis van de configuratie van de cluster. Zie Een prestatiemodus kiezen. |
Requirements
Workspace admin-toegang wordt aanbevolen om een volledige migratie te garanderen. Dit komt doordat de agent ook globale init-scripts op werkruimteniveau inspecteert buiten de doelwerklast. Je kunt misschien migreren als je toestemming hebt
CAN MANAGEvoor de werklast, maar zonder beheerdersrechten kan dat resulteren in ontbrekende bibliotheken, omgevingsinstellingen of tags.Bevestig dat je toegang hebt tot de makelaar. Typ
/computein Genie Code./computezou in het autocomplete-menu moeten verschijnen. Als het niet verschijnt, moet een werkruimtebeheerder de preview in je werkruimte inschakelen.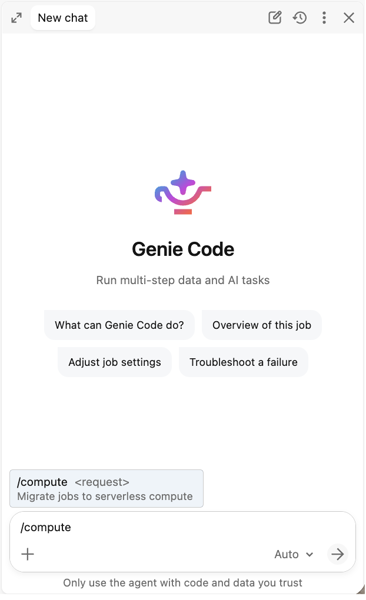
Een notebook migreren
- Open het notitieblok dat je wilt migreren.
- Open Genie Code en start
/compute migrate to serverlessvanaf het/commandopalet. - Bekijk de bevindingen van de agent. De agent analyseert de omgeving, bibliotheken en code van het notebook en stelt voor elk item dat moet worden aangepast een wijziging voor, zoals het verplaatsen van de installatie van een bibliotheek naar een omgevingsspecificatie of het herschrijven van een codecelle zodat deze serverless kan worden uitgevoerd.
- Accepteer of wijs elke voorgestelde wijziging af.
- Pas de wijzigingen toe die je hebt geaccepteerd. Ze worden ter plekke in het notitieboekje geschreven.
- Sluit het notebook aan op serverless en start het om te bevestigen dat het zich gedraagt zoals je verwacht. Zie Verificatie van een gemigrerde werklast.
Een baan verplaatsen
- Open de baan waar je naartoe wilt migreren.
- Open Genie Code en start
/compute migrate to serverlessvanaf het/commandopalet. - De agent kloont je taak en probeert de gekloneerde taak naar serverless te migreren.
- Bekijk de bevindingen van de agent. Voor een multitask-taak somt de agent elke taak en de per-taak-cluster configuratie op en stelt wijzigingen voor voor elk, terwijl het schema van de taak behouden blijft.
- Accepteer of verwerp elke voorgestelde wijziging op het migratieoppervlak: omgeving en bibliotheken, Spark-configuraties en alle workloadcode die moet worden gewijzigd.
- Pas de wijzigingen toe die je hebt geaccepteerd. De rekencapaciteit van de taak wordt overgeschakeld op serverless.
- Voer de taak uit in serverless en bevestig de resultaten. Zie Verificatie van een gemigrerde werklast.
- Optioneel promoot de agent als laatste stap de gemigrerde kloon. Het kopieert de configuratie en notitieboeken van de kloon terug naar je oorspronkelijke taak (waarbij dezelfde job-ID, schema en rechten behouden blijven), en verwijdert vervolgens de kloon. Als je de promotie overslaat en beide taken behoudt, pauzeer dan de planning voor de taak die je niet uitvoert; anders activeert dezelfde trigger beide taken en kan dit schrijfbewerkingen of andere neveneffecten dupliceren.
Verifieer een gemigrerde werklast
De agent stelt wijzigingen voor en past deze toe, maar voert je werklast niet uit en verifieert de output ervan niet. Voer altijd een gemigrerde workload op serverless uit en bevestig de resultaten voordat je erop vertrouwt, vooral bij workloads die naar productietabellen schrijven. Als de makelaar een wijziging voorstelt die er niet goed uitziet, wijs die dan af en stuur ons feedback zodat we de makelaar kunnen verbeteren. Zie Productfeedback verzenden.
Tip
Terwijl je een gemigrerde workload valideert, draai deze dan in prestatie-geoptimaliseerde modus. Hij start sneller dan de standaardmodus, dus je krijgt snellere feedback als je de resultaten bevestigt. Schakel over naar de modus die het beste bij de werklast past voordat je het in productie uitvoert. Zie Een prestatiemodus kiezen.
Wanneer de agent iets vindt dat hij niet veilig kan migreren, meldt hij een blokker en stopt standaard weer. Je kunt expliciet opdracht geven om voorbij bepaalde compatibiliteits- of afhankelijkheidsblokkers te gaan, maar dat accepteert het risico dat die afhankelijkheden, kostenattributie of runtime-gedrag niet worden overgedragen, en de werklast kan falen op serverless.
Migratiewijzigingen terugdraaien
De wijzigingen die de agent aanbrengt zijn omkeerbaar.
Voor een notebook opent u het en herstelt u de revisie van vlak vóór de migratie. Bekijk versiegeschiedenis in Databricks-notebooks.
Voor een opdracht, als je de geïmporteerde kloon niet hebt gepromoot, is je oorspronkelijke taak nooit veranderd: voer het uit zoals voorheen en verwijder de kloon. Als je de kloon hebt gepromoot, herstel dan van de back-up die de agent heeft gemaakt voordat er een wijziging is gedaan:
- Open de back-upmap in de thuismap van je werkruimte:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. De agent liet dit pad zien tijdens de migratie. Als er meerdere tijdstempels zijn, kies dan degene van net voor de migratie. - Open
job.yaml, dat je taakinstellingen van vóór de migratie bevat, en pas die instellingen opnieuw toe op dezelfde taak met eenPOST /api/2.2/jobs/reset-verzoek, waarmee de taakinstellingen worden overschreven met de instellingen die je opgeeft. Je kunt ze ook in de JSON-definitie van de functie in de UI plakken. Dit brengt de taak terug naar klassieke rekenkracht. - Open
mapping.yaml, waarin elk geback-upt bestand en het oorspronkelijke pad waar het vandaan kwam wordt vermeld. Kopieer elk back-upbestand terug over het oorspronkelijke pad om de codeherschrijvingen ongedaan te maken. - Voer de taak uit om te bevestigen dat het zich gedraagt zoals voor de migratie.
De migratie verwijdert deze back-up nooit. Taken die de agent niet heeft aangepast, zoals uit Git afkomstige taken en SQL- of dbt-taken, worden vastgelegd in job.yaml, maar de bijbehorende bestanden worden niet naar de back-up gekopieerd, dus herstel die indien nodig vanuit je gezaghebbende bron.
Bekende beperkingen
- De volgende worden als blokkers gerapporteerd: aangepaste images, ML Runtime-varianten, Databricks Runtime-versies van vóór 13, Spark-configuraties die niet veilig kunnen worden genegeerd op serverless, en afhankelijkheden zoals eggs, JARs en Maven-bibliotheken. Een blocker betekent dat de agent stopt in plaats van dat item te migreren. Je kunt het probleem óf zelf oplossen en de migratie opnieuw uitvoeren, óf de agent opdracht geven toch te migreren, waarbij dat item onopgelost blijft en de workload in een serverless-omgeving mogelijk mislukt.
- De agent leest init-scripts die zijn opgeslagen in workspace-bestanden of Unity Catalog-volumes. Init-scripts die zijn opgeslagen in ABFSS of DBFS kunnen niet worden gelezen en worden als blokkers gerapporteerd.
- De agent inspecteert niet elk klassiek rekenattribuut. Clusterloglevering en SSH-sleutels worden niet gemodelleerd, en hoewel het veel DBFS-mountafhankelijkheden uit workloadcode detecteert, wordt niet elke mount opgesomd of opgelost.
- Cache- en checkpoint-API's, globale tijdelijke weergaven, DBFS-mount-management aanroepen en Scala- of R-code zijn standaard harde blokkers. Je kunt de agent opdracht geven om door te gaan, maar de onopgeloste functionaliteit blijft ongewijzigd en kan falen op serverless.
- Banen met meer dan 10 migratabele taken kunnen momenteel niet worden gemigreerd.
- De agent migreert één workload tegelijk. Er is geen vlootbrede ontdekking, bulkmigratie of goedkeuringsproces voor beheerders.
- De agent stelt wijzigingen voor en past de door jou accepterende wijzigingen toe, maar voert je werklast niet uit of verifieert de correctheid van de output. Controleer een gemigrerde werklast voordat je erop vertrouwt voor productiedata.
- Als de bron van waarheid in je workload een Databricks Asset Bundle of een Git-map is, past de agent wijzigingen toe aan het werkruimteobject dat aanwezig is. Stem die wijzigingen af met je bundel of repository zodat een latere implementatie de migratie niet overschrijft.
Handmatig migreren naar serverless
Voer de volgende stappen uit om uw workloads van klassieke berekening naar serverloze berekeningen te migreren:
- Controleer de vereisten: controleer of de toegang tot uw werkruimte, netwerken en cloudopslag voldoet aan de vereisten. Zie Voorvereisten.
- Code bijwerken: breng alle benodigde code- en configuratiewijzigingen aan. Zie Uw code bijwerken.
- Test uw workloads: valideer de compatibiliteit en correctheid voordat u de overstap maakt. Zie Uw workloads testen.
- Kies een prestatiemodus: selecteer de prestatiemodus die het beste overeenkomt met uw workloadvereisten. Zie Een prestatiemodus kiezen.
- Migreren in fasen: serverloos incrementeel implementeren, te beginnen met nieuwe en workloads met een laag risico. Zie Migreren in fasen.
- Kosten bewaken: serverloos DBU-verbruik bijhouden en waarschuwingen instellen. Zie Kosten monitoren.
Prerequisites
Voordat u begint met migreren, moet u mogelijk een aantal verouderde configuraties in uw werkruimte bijwerken.
| Voorwaarde | Action | Details |
|---|---|---|
| Workspace is ingeschakeld voor Unity Catalog | Migreren vanuit Hive Metastore indien nodig | Werk een Azure Databricks-werkruimte bij naar Unity Catalog |
| Netwerken geconfigureerd | VPC-peering vervangen door NCC's, Private Link of firewallregels | Serverloze rekenvlaknetwerken |
| Toegang tot cloudopslag | Verouderde patronen voor gegevenstoegang vervangen door externe locaties van Unity Catalog | Verbinding maken met cloudobjectopslag met behulp van Unity Catalog |
Controleer of uw werkruimte zich in een ondersteunde regio bevindt.
Uw code bijwerken
In de volgende secties worden de code- en configuratiewijzigingen vermeld die nodig zijn om uw workloads compatibel te maken met serverloos.
Toegang tot gegevens
Verouderde patronen voor gegevenstoegang worden niet ondersteund op serverloos. Werk uw code bij om in plaats daarvan Unity Catalog te gebruiken.
| Klassiek patroon | Serverloze vervanging | Details |
|---|---|---|
DBFS-paden (dbfs:/...) |
Unity Catalog-volumes | Wat zijn Unity Catalog-volumes? |
| Hive Metastore-tabellen | Unity Catalog-tabellen (of HMS Federation) | Werk een Azure Databricks-werkruimte bij naar Unity Catalog |
| Referenties voor opslagaccount | Externe locaties van Unity Catalog | Verbinding maken met cloudobjectopslag met behulp van Unity Catalog |
| Aangepaste JDBC JAR's | Lakehouse Federatie | Wat is query federatie? |
Waarschuwing
DBFS-toegang is beperkt op serverloos. Werk alle dbfs:/ paden naar Unity Catalog-volumes bij voordat u migreert. Zie Bestanden migreren die zijn opgeslagen in DBFS voor meer informatie.
Voorbeeld: DBFS-paden en Hive Metastore-verwijzingen vervangen
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs en code
Bepaalde API's en codepatronen worden niet ondersteund op serverloos. Raadpleeg deze tabel om te zien of uw code moet worden bijgewerkt.
| Klassiek patroon | Serverloze vervanging | Details |
|---|---|---|
RDD-API's (sc.parallelize, rdd.map) |
DataFrame API's | Spark Connect vergelijken met Spark Classic |
df.cache(), df.persist() |
Caching-aanroepen verwijderen | Beperkingen voor serverloze berekeningen |
spark.sparkContext, sqlContext |
Gebruik (SparkSession) rechtstreeks spark |
Spark Connect vergelijken met Spark Classic |
Hive-variabelen (${var}) |
SQL DECLARE VARIABLE of Python f-tekenreeksen |
DECLARE VARIABLE |
| Niet-ondersteunde Spark-configuraties | Niet-ondersteunde configuraties verwijderen. Serverloze past automatisch de meeste instellingen aan. | Spark-eigenschappen configureren voor serverloze notebooks en taken |
Voorbeeld: RDD-bewerkingen vervangen door DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Voorbeeld: SparkContext en caching vervangen
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Verschillen in SQL-gedrag
Serverless compute schakelt standaard ANSI-modus in. Databricks Runtime schakelt standaard ANSI-modus in in versie 17.0 en hoger. Als je klassieke compute een eerdere versie draait, veroorzaken sommige zoekopdrachten die daar slagen runtime-fouten op serverless.
De migratieagent past de code automatisch aan voor het gedrag in ANSI-modus. Als je handmatig migreert, bekijk dan de volgende bewerkingen, die meestal het gedrag veranderen:
| Bewerking | Klassieke compute met ANSI-modus uitgeschakeld | Serverloze rekenkracht |
|---|---|---|
Ongeldige typeconversie, zoals CAST('abc' AS INT) |
Retourneert NULL |
Genereert CAST_INVALID_INPUT |
| Rekenkundige geheelgetaloverloop | Wikkelt zich om. Bijvoorbeeld, 2147483647 + 1 retourneert -2147483648. |
Genereert ARITHMETIC_OVERFLOW |
| Decimale rekenkundige overflow | Retourneert NULL |
Genereert NUMERIC_VALUE_OUT_OF_RANGE |
| Delen door nul | Retourneert NULL |
Genereert DIVIDE_BY_ZERO |
| Verkeerd gevormde URL in parse_url | Retourneert NULL |
Verhogingen INVALID_URL |
Om NULL terug te geven in plaats van een fout te veroorzaken, vervang je de bewerking door het equivalente try_*, zoals try_cast, try_add, try_divide of try_parse_url. Databricks raadt deze aanpak aan in plaats van ANSI-modus uit te schakelen, omdat ANSI-modus kwaliteitsproblemen aan het licht brengt die door een stille NULL worden verborgen.
Om de ANSI-modus voor casts, rekenkunde en parsing uit te schakelen, zet spark.sql.ansi.enabled op false. Serverless compute past ANSI-regels toe op impliciete casts bij tabelinvoegingen, ongeacht deze instelling, omdat spark.sql.storeAssignmentPolicy niet kan worden gewijzigd op serverless compute. Voor een volledige beschrijving van ANSI-gedrag, zie ANSI-compliance in Databricks Runtime.
Bibliotheken en omgevingen
U kunt bibliotheken en omgevingen op werkruimteniveau beheren met behulp van basisomgevingen en op notebookniveau met behulp van de serverloze omgeving van het notebook.
| Klassiek patroon | Serverloze vervanging | Details |
|---|---|---|
| Initscripts | Serverloze omgevingen | De serverloze omgeving configureren |
| Clusterbibliotheken | Notebook-beperkte en omgeving-bibliotheken | De serverloze omgeving configureren |
| Maven/JAR-bibliotheken | JAR-taakondersteuning voor taken; PyPI voor notebooks | JAR-taak voor jobs |
| Docker-containers | Serverloze omgevingen voor bibliotheekbehoeften | De serverloze omgeving configureren |
Maak Python pakketten vast in requirements.txt voor reproduceerbare omgevingen. Zie Python-pakketversies specificeren.
Streamen
Streaming-workloads worden ondersteund op serverloze architectuur, maar bepaalde triggers worden niet ondersteund. Werk uw code bij om de ondersteunde triggers te gebruiken.
| Sparktrigger | Ondersteund | Aantekeningen |
|---|---|---|
Trigger.AvailableNow() |
Ja | Aanbevolen |
Trigger.Once() |
Ja | Dit is verouderd verklaard. Gebruik in plaats daarvan Trigger.AvailableNow(). |
Trigger.ProcessingTime(interval) |
No | Retourneert INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
No | Gebruik in plaats daarvan de continue modus van Lakeflow-pijplijnen |
Standaard (geen instelling .trigger()) |
No | Als .trigger() wordt weggelaten, is de standaard ProcessingTime("0 seconds"), wat niet wordt ondersteund in serverloze omgevingen. Stel .trigger(availableNow=True) altijd expliciet in. |
Voor continue streaming migreert u naar declaratieve Spark-pijplijnen in de continue modus of gebruikt u taken met continue planning met AvailableNow. Voor grote bronnen stelt u maxFilesPerTrigger of maxBytesPerTrigger om out-of-memory-fouten te voorkomen.
Voorbeeld: Streaming-triggers herstellen
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Uw workloads testen
- Snelle compatibiliteitstest: voer de workload uit op klassieke berekeningen met de standaardtoegangsmodus en Databricks Runtime 14.3 of hoger. Als de uitvoering slaagt, kan de workload zonder codewijzigingen naar serverloos worden gemigreerd.
- Vergelijking van A/B (aanbevolen voor productie): Voer dezelfde workload uit op klassiek (beheer) en serverloos (experiment). De uitvoertabellen vergelijken en de juistheid controleren. Herhalen totdat de uitvoer overeenkomt.
- Tijdelijke configuraties: u kunt tijdens het testen tijdelijk ondersteunde Spark-configuraties instellen. Verwijder ze zodra ze stabiel zijn.
Een prestatiemodus kiezen
Serverloze taken en pijplijnen ondersteunen twee prestatiemodi: standaard en geoptimaliseerd voor prestaties. De prestatiemodus die u kiest, is afhankelijk van uw workloadvereisten.
| Mode | Availability | Opstarten | Ideaal voor |
|---|---|---|---|
| Standard | Jobs, Lakeflow-pipelines | 4-6 minuten | Kostengevoelige batch |
| Geoptimaliseerd voor prestaties | Notebooks, taken, Lakeflow-pijplijnen | Seconden | Interactief, latentiegevoelig |
Migreren in fasen
- Nieuwe workloads: start alle nieuwe notebooks en taken op serverloos.
- Workloads met een laag risico: PySpark-/SQL-workloads migreren die al in de standaardtoegangsmodus en Databricks Runtime 14.3 of hoger staan.
- Complexe workloads: migreren die codewijzigingen vereisen, zoals het herschrijven van RDD's, het bijwerken van DBFS, en het oplossen van triggerproblemen.
- Resterende workloads: controleer regelmatig naarmate de mogelijkheden worden uitgebreid.
Kosten controleren
Serverloze facturering is gebaseerd op DBU-verbruik, niet op clustertijd. Valideer de kostenverwachtingen met representatieve workloads voordat u op schaal migreert. Zie De kosten van serverloze berekeningen bewaken voor hulpprogramma's en strategieën voor het bewaken van serverloze kosten.
Aanvullende bronnen
- Aanbevolen procedures voor serverloze berekening: Optimalisatietips voor serverloze workloads
- Beperkingen voor serverloze berekeningen: volledige lijst met huidige beperkingen en niet-ondersteunde functies
- De serverloze omgeving configureren: Bibliotheken en afhankelijkheden beheren
- Ondersteunde Spark-configuraties: Spark-configuraties beschikbaar op serverloos
- Spark Connect versus klassieke Spark: Gedragsverschillen in serverloze architectuur
- Serverloze netwerkbeveiliging: NCC's, Private Link en firewallconfiguratie
- Releaseopmerkingen voor serverless computing: Nieuwe mogelijkheden bijhouden wanneer ze worden uitgebracht
- Upgradehandleiding voor Unity Catalog: Migreren van Hive Metastore naar Unity Catalog
U kunt ook verwijzen naar de volgende blogberichten voor meer informatie:
- Wat is serverloze computing?: Overzicht van serverloze mogelijkheden en klantresultaten
- Ontwikkeling van data engineering: hoe serverloze compute notebooks en Lakeflow-taken transformeert: hoe serverloze computing Lakeflow-taken en -pijplijnen aandrijft.