Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Important
Deze functie bevindt zich in de bètaversie. Om het te gebruiken, moet een werkruimtebeheerder AI/BI Dashboard Materialization inschakelen op de Previews-pagina. Zie Azure Databricks previews beheren.
AI/BI-dashboards zijn gebaseerd op dashboardgebonden gegevenssets. Standaard wordt elke dataset live geëvalueerd, dus elke keer dat een dashboard laadt of een viewer ermee interacteert, draaien de onderliggende queries, joins en source scans opnieuw op je SQL-warehouse. Voor dashboards die zijn gebouwd op dure source queries of veel joins, is het opnieuw uitvoeren van die queries bij elke interactie traag en kostbaar.
Materialisatie van datasets berekent de resultaten van een dataset vooraf en slaat deze op, zodat het zware werk volgens een schema één keer wordt uitgevoerd in plaats van bij elke keer dat een dashboard wordt geladen of wanneer ermee wordt geïnterageerd. Interacties worden vervolgens weergegeven vanuit de opgeslagen resultaten, waardoor gepubliceerde dashboards sneller worden weergegeven.
Materialisatie maakt gebruik van de materialisatietechnologie voor metriekweergaven van Unity Catalog. Zie Materialisatie voor metrische weergaven.
Wat wordt gematerialiseerd
Materialisatie berekent de gegevens van de dataset vooraf en slaat deze op. Wat wordt opgeslagen verschilt tussen de twee datasettypes:
- Voor SQL-datasets wordt het volledige queryresultaat vooraf berekend en opgeslagen.
- Voor lokale metriekweergaven wordt het rijniveau-datamodel (brondata, joins en filtervelden) opgeslagen, terwijl metingen nog steeds bij het querymoment worden berekend aan de hand van de vooraf berekende basis.
Benefits
Materialisatie van datasets biedt de volgende voordelen:
- Snellere dashboards zonder herstructureren. Kostbare joins en bronscans worden volgens een schema één keer uitgevoerd in plaats van telkens wanneer gegevens worden geladen, waardoor de wachttijd verdwijnt die gebruikers ervaren wanneer een dashboard opnieuw query’s uitvoert op grote tabellen.
- Lagere datawarehousekosten bij het uitlezen. Door het basisdatamodel vooraf te berekenen, hoeft dezelfde zware query niet voor elke gebruiker en bij elke paginalading opnieuw te worden uitgevoerd, waardoor onnodig gebruik van het datawarehouse wordt verminderd.
- Geen operationele overhead. Azure Databricks maakt, slaat op en vernieuwt de gematerialiseerde data voor je. Er is geen pijplijn, schema of opslag om te beheren.
Costs
Materialisatie van datasets brengt opslag- en rekenkosten met zich mee:
- Opslag. Je betaalt voor het opslaan van de gematerialiseerde data. De kosten hangen af van de onderliggende opslag die wordt gebruikt. Voor een overzicht van opslag in Unity Catalog, zie Verbind met cloudobjectopslag met Unity Catalog.
- Berekenen. Initiële aanmaak en verversingen worden uitgevoerd op serverless Lakeflow-pijplijnen en brengen rekenkosten met zich mee. Zie prijzen voor Lakeflow pipelines.
Weeg deze kosten af tegen de besparingen die ontstaan door herhaalde scans van de brongegevens en joins te vermijden. Kies een verversingsschema dat de versheid van data in balans brengt met de rekenkosten.
Wanneer materialisatie te gebruiken
Materialisatie is niet altijd de juiste hefboom voor prestaties. Het voordeel ligt in het vervangen van herhaalde, volledige herberekening van een dataset (scannen en joinen) door leesopdrachten tegen een vooraf berekende tabel. Materialiseer een dataset wanneer een of meer van de volgende van toepassing zijn:
- Sterk interactieve dashboards. Het dashboard bevat veel filters, kruisfiltering of drill-downs. Zonder materialisatie wordt de datasetquery bij elke interactie opnieuw uitgevoerd, dus het vooraf berekenen van die datasets betaalt zich herhaaldelijk uit in een sessie.
- Kostbare datasets. De dataset is opgebouwd uit joins op meerdere tabellen, zware views of gemeenschappelijke tabeluitdrukkingen (CTE's), windowfuncties of unions tussen veel tabellen.
- Selectieve filters op grote tabellen. De dataset selecteert een kleine subset, zoals één regio of de laatste 7 dagen, uit miljarden rijen. Materialisatie slaat alleen de kleine subset op.
- Tolerantie voor geplande versheid. De data hoeft alleen zo vers te zijn als het verversingsschema van het dashboard, bijvoorbeeld per uur of dag, in plaats van in real time.
Voor kleine datasets of dashboards die zelden worden geladen, is de livequery vaak snel genoeg en is materialisatie de kosten mogelijk niet waard. Omdat materialisatie per publicatie en per dataset opt-in is, kun je het alleen toepassen waar het zich uitbetaalt.
Requirements
- Toegang tot een AI/BI-dashboard.
- Het dashboard wordt gepubliceerd met de optie 'Gegevens delen'-permissies . Materialisatie wordt niet ondersteund voor dashboards die met individuele datarechten zijn gepubliceerd. Zie Wat zijn gedeelde gegevensmachtigingen?
- Serverless computing ingeschakeld in de werkruimte. De eerste aanmaak en verversing worden uitgevoerd op serverloze Lakeflow-pijplijnen. Zie Serverloze SQL-warehouses instellen.
- KAN toestemming gebruiken op een SQL-warehouse met Databricks Runtime 17.3 en hoger.
Materialisatie van datasets mogelijk maken
Datasets zijn standaard geselecteerd voor materialisatie, maar materialisatie staat uit voor het dashboard totdat je de optie Materialize datasets inschakelt tijdens het publiceren.
Kies welke datasets je wilt materialiseren
Klik op het tabblad Gegevens op het materialisatie-icoon naast een dataset om deze op te nemen of uit te sluiten.
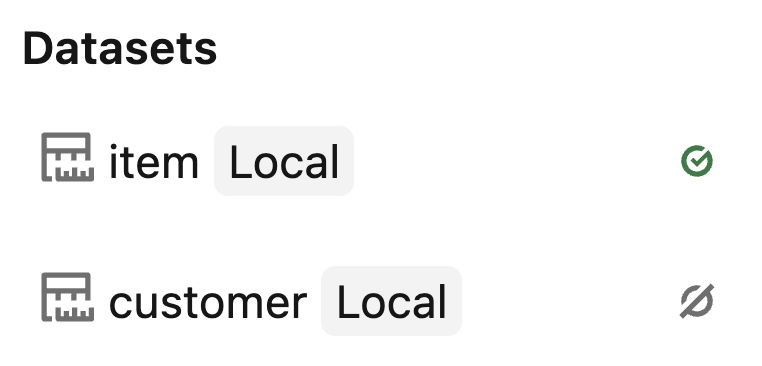
Wanneer je een dataset uitsluit van materialisatie, geven zoekopdrachten naar die dataset live resultaten, terwijl zoekopdrachten naar gematerialiseerde datasets de laatste materialisatierun weerspiegelen. Wanneer alle datasets hetzelfde materialisatieschema gebruiken, hebben widgets een consistente versheid van de data.
Publiceer met materialisatie
- Klik op Publiceren in het conceptdashboard.
- Selecteer de rechten voor delen van gegevens in het publicatiemenu.
- Zet de optie Materialize datasets in om de datasets die geselecteerd zijn op het tabblad Data te materialiseren.
- Klik op Publiceren.
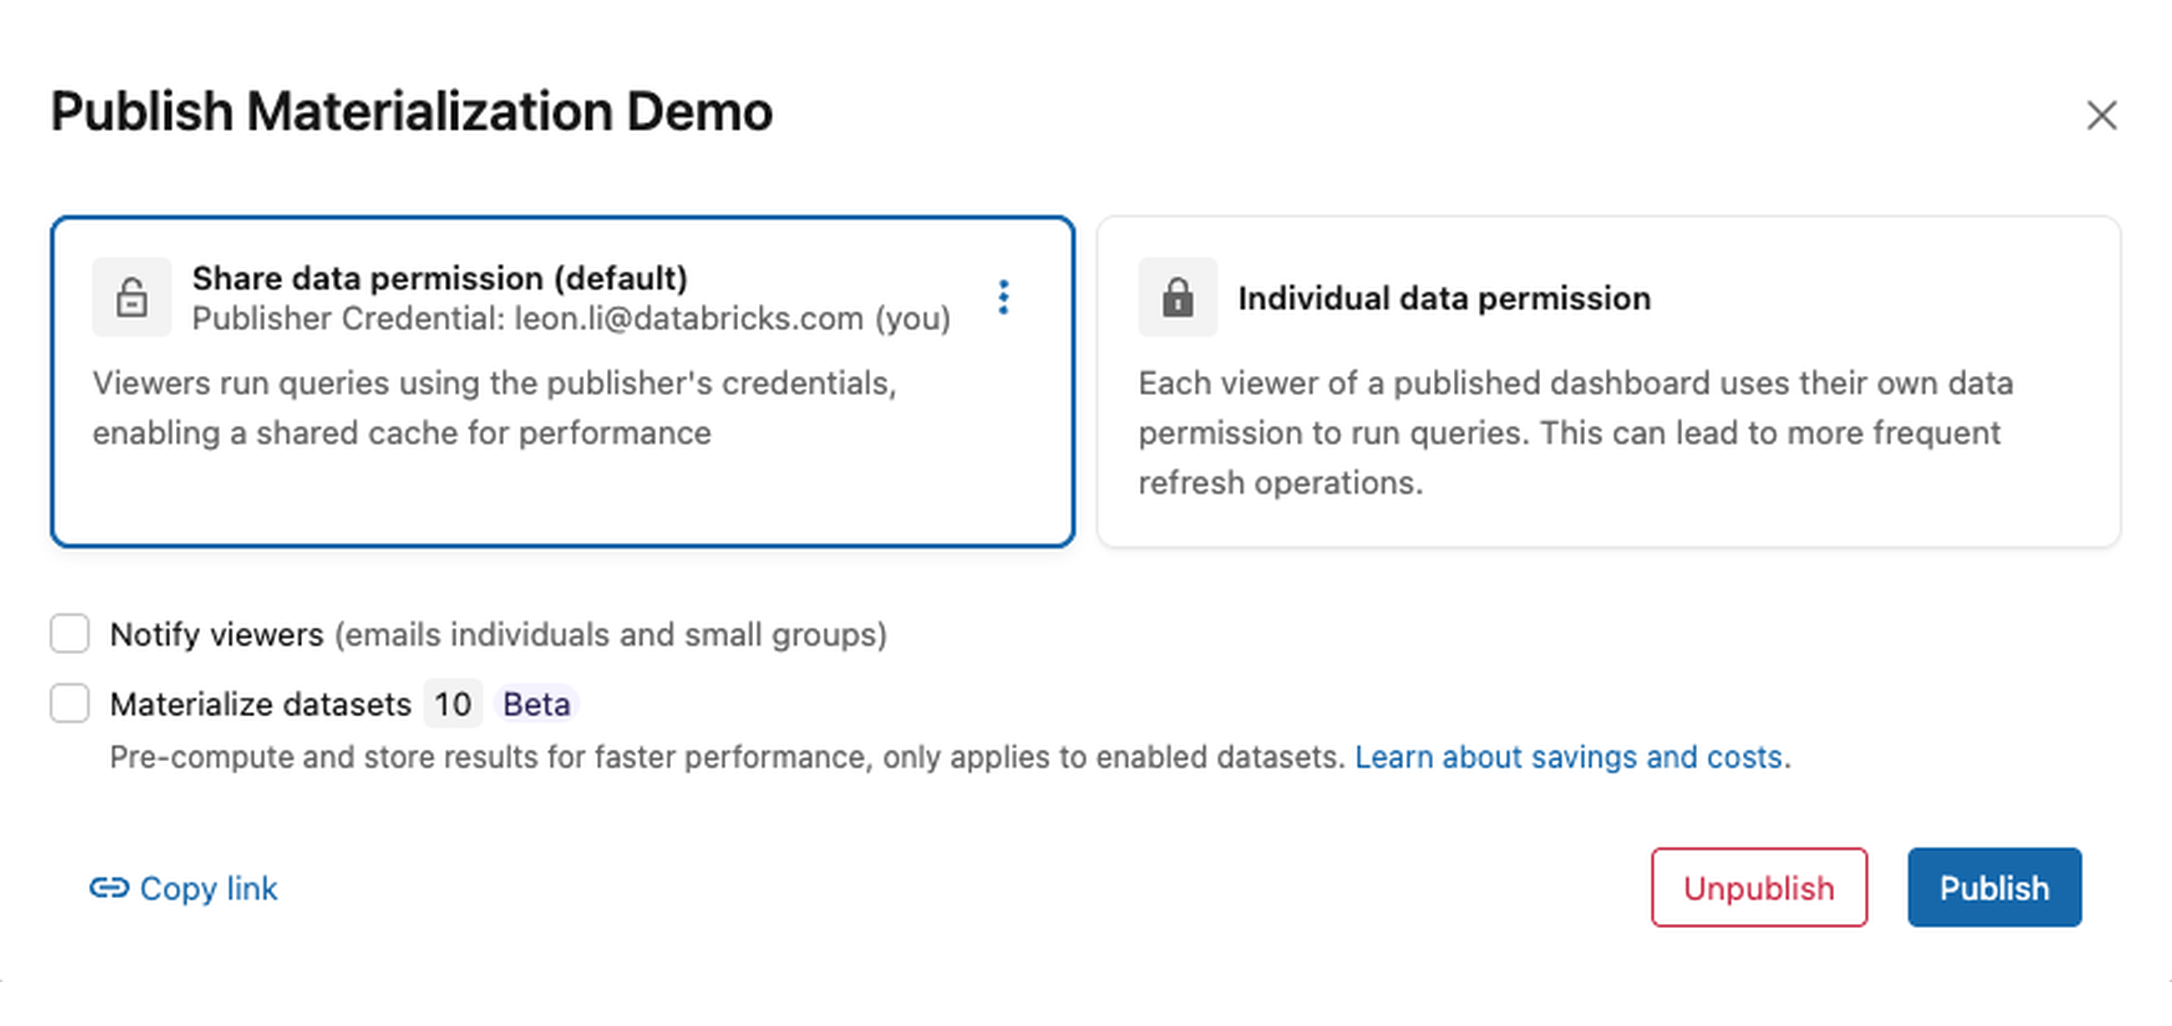
Zet bij elke publicatie de optie Materialize datasets aan.
Stel een verversingsschema in
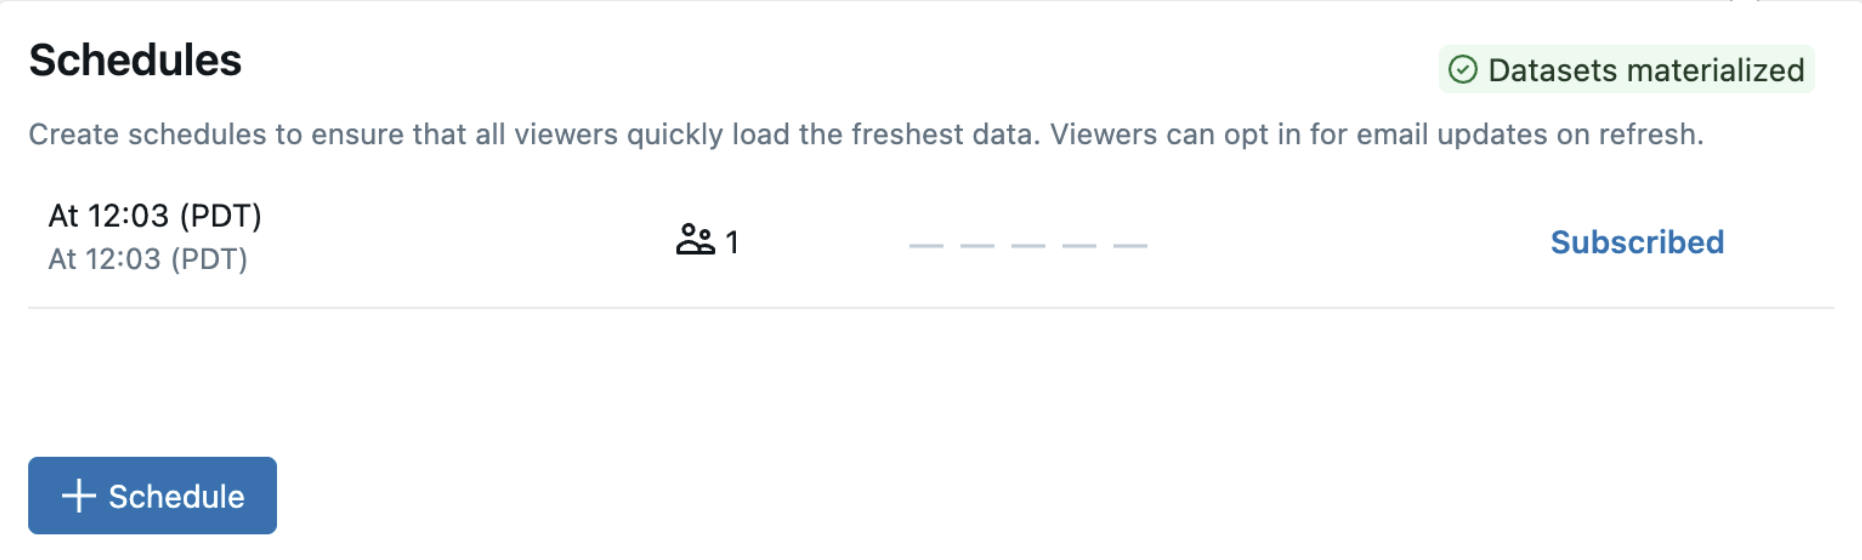
Gematerialiseerde data worden ververst volgens het vernieuwingsschema van het dashboard. Gebruik het dashboardschema om de verversingsfrequentie aan te passen.
Als het dashboard geen schema heeft, voegt publiceren met materialisatie ingeschakeld een dagelijks verversschema toe. Huidige schema's worden behouden. Zonder een actief schema verversen gematerialiseerde data niet automatisch na aanmaak.
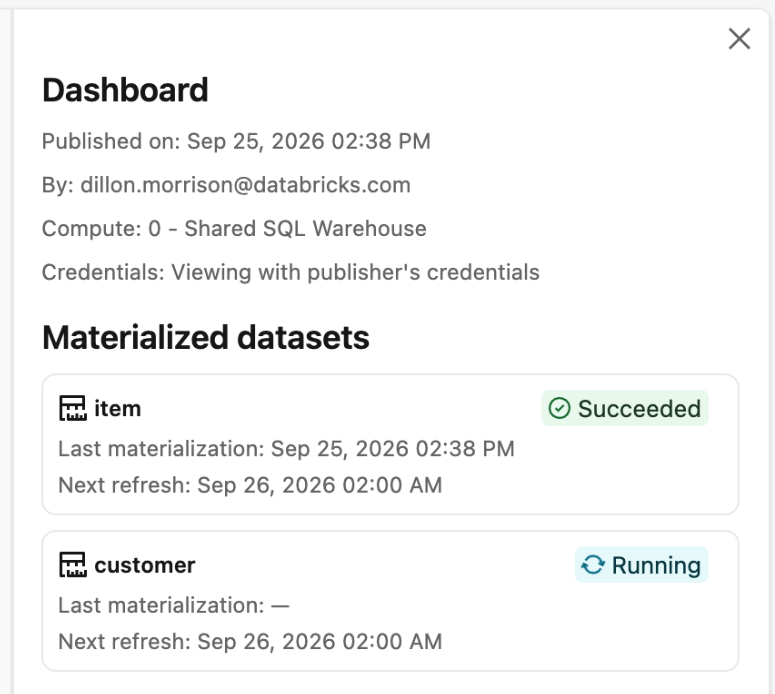
Bekijk materialisatiestatus
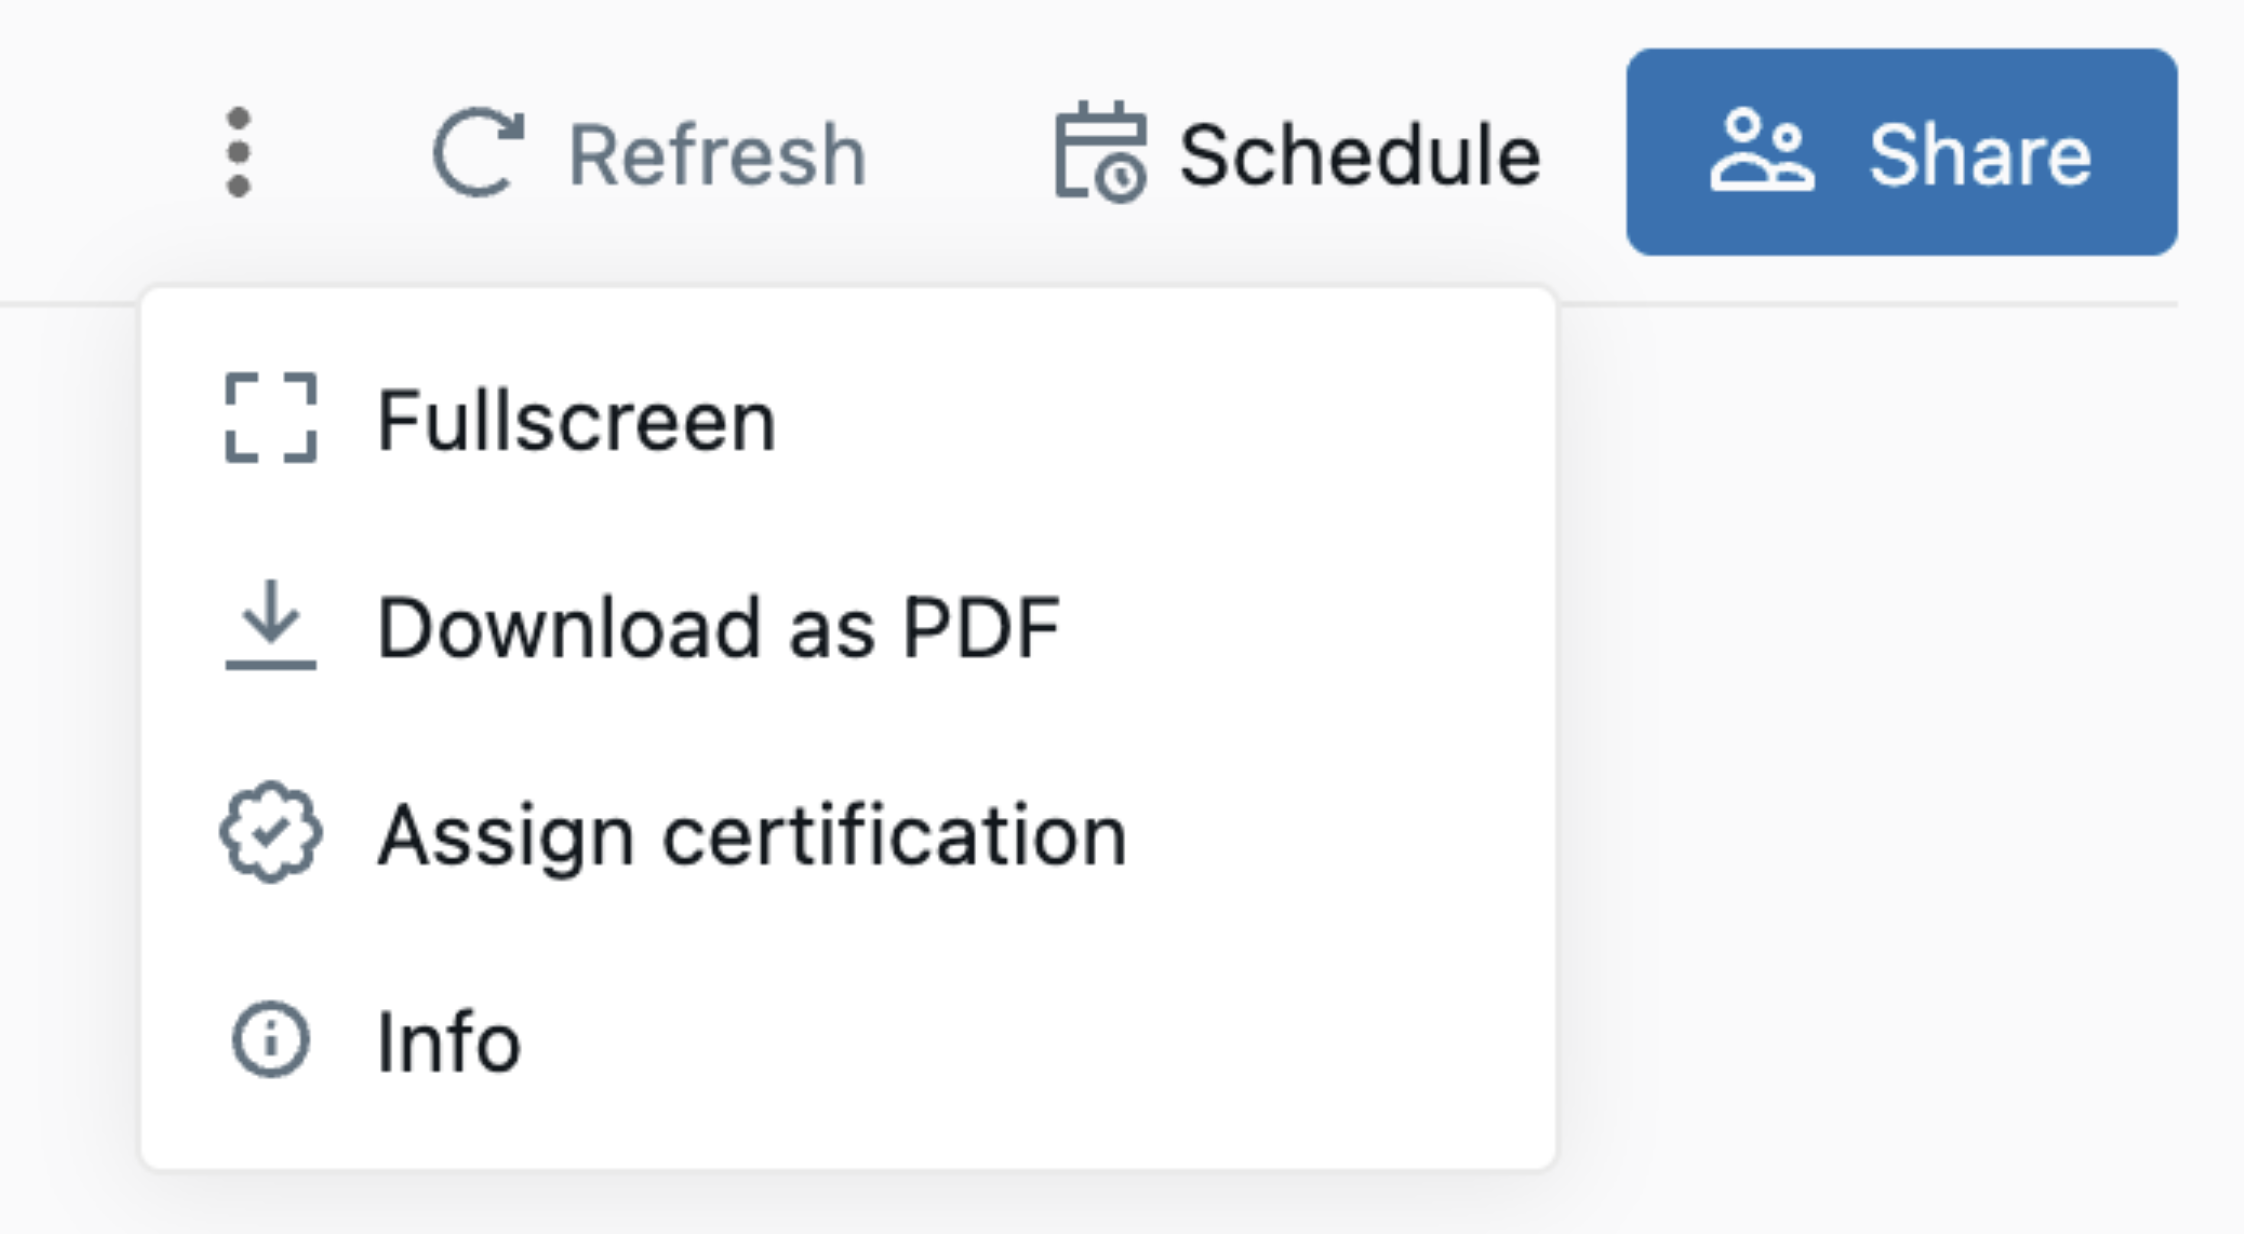
Open in het gepubliceerde dashboard het  en selecteer Info. De zijbalk toont de status en verversinformatie van elke gematerialiseerde dataset.
Hergebruik en schoonmaak
Azure Databricks beheert de levenscyclus van uw gematerialiseerde data:
- Hergebruik tussen revisies. Als een dashboard door dezelfde gebruiker opnieuw wordt gepubliceerd en een dataset ongewijzigd blijft, wordt de bestaande materialisatie hergebruikt, waardoor verspilde rekenkracht wordt voorkomen.
- Automatische schoonmaak. Azure Databricks verwijdert materialisaties waarnaar een gepubliceerd dashboard niet langer verwijst, bijvoorbeeld na een definitiewijziging of nadat de publicatie ongedaan is gemaakt.
Herpublicatie ververst niet per se gematerialiseerde gegevens.
Limitations
Datasetmaterialisatie kent de volgende beperkingen:
- Alleen gepubliceerde dashboards. Materialisatie geldt voor gepubliceerde dashboards. Concepten blijven live data opvragen.
- Geen geparametriseerde datasets. Datasets die parameters definiëren kunnen niet worden gematerialiseerd. Als je een geparameteriseerde dataset inschakelt voor materialisatie, rapporteert Azure Databricks deze als mislukt in plaats van deze te materialiseren.
- Refresh volgt alleen het dashboardschema. Er is geen apart verversingsschema per dataset. Materialisatie wordt vernieuwd volgens het schema voor gepland vernieuwen van je dashboard.
- Serverless vereist. De eerste aanmaak en verversingen worden uitgevoerd op serverloze Lakeflow-pipelines, dus in de werkruimte moet serverless compute zijn ingeschakeld.
- Beschermde gegevens worden niet aangeboden vanuit materialisaties. Een materialisatie kan niet worden aangemaakt voor brongegevens die worden beschermd door beveiliging op rijniveau, kolommaskers of beleidsregels voor attribuutgebaseerde toegangscontrole (ABAC). Als beveiliging op rijniveau wordt toegevoegd aan een brontabel nadat de materialisatie is aangemaakt, omzeilen latere query's op de metriekweergave de materialisatie en worden ze uitgevoerd op de brongegevens.
- Toestemming voor het delen van gegevens vereist. Je kunt materialisatie alleen inschakelen als je publiceert met gedeelde data-rechten. Je kunt het niet inschakelen wanneer je publiceert met individuele data-rechten.
Veelgestelde vragen
De volgende vragen behandelen het materialisatiegedrag van datasets, verversingen en permissies.
Verandert materialisatie mijn statistieken of resultaten?
Materialisatie behoudt de querylogica van de dataset, maar de gegevens komen overeen met de meest recente geslaagde vernieuwing. Voor lokale metriekweergaven worden metingen tijdens het querytijdstip berekend aan de hand van de gematerialiseerde data. Zie wat wordt gematerialiseerd.
Wat gebeurt er als een materialisatie niet klaar is of niet beschikbaar is?
Als een materialisatie niet klaar is of niet beschikbaar is op het moment van het opvragen, geeft de query een foutmelding terug in plaats van het opvragen van live data. Wacht tot de materialisatie klaar is en voer de query dan opnieuw uit.
Waar wordt de gematerialiseerde data opgeslagen?
Azure Databricks slaat de gematerialiseerde data op in beheerde, interne opslag die is beperkt tot je gepubliceerde dashboard. Er is niets voor jou om te publiceren in Unity Catalog, en geen schema of opslag om te beheren. Access blijft je dashboard en onderliggende datarechten volgen.
Hoe vaak worden de gematerialiseerde gegevens ververst?
Gematerialiseerde data worden ververst volgens het vernieuwingsschema van het dashboard. Zie Set een verversingsschema in.
Welke compute gebruikt materialisatie?
Initiële creatie en verversing draaien beide op serverloze Lakeflow-pijplijnen die worden beheerd door Azure Databricks. Daarom moet serverless computing ingeschakeld zijn in de werkruimte.
Heeft materialisatie invloed op machtigingen?
No. Materialisatie verleent geen extra toegang tot data. Access volgt nog steeds de deelconfiguratie van het dashboard en de machtigingen die worden gebruikt om het te publiceren.
Wat gebeurt er als ik opnieuw publiceer?
Bestaande materialisaties kunnen worden hergebruikt wanneer dezelfde gebruiker een ongewijzigde dataset opnieuw publiceert. Zie Hergebruik en opruimen. Zet bij elke publicatie de optie Materialize datasets aan.