Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Het sdp-meta project van Databricks Labs biedt hulpprogramma's voor het genereren van pijplijnen op basis van metagegevens die u onderhoudt.
Note
Het open source sdp-metaproject, net als alle projecten in het databrickslabs GitHub-account, bestaat uitsluitend voor verkenningsdoeleinden. Azure Databricks biedt hiervoor geen ondersteuning of serviceovereenkomsten (SLA's). Dien geen azure Databricks-ondersteuningstickets in voor problemen met betrekking tot dit project. Dien in plaats daarvan een GitHub-issue in, die wordt beoordeeld wanneer de tijd het toelaat.
Wat is sdp-meta?
Met Lakeflow-pijplijnen kunt u declaratief een tabel opgeven en een stroom genereren in een pijplijn die de tabel maakt en deze up-to-date houdt wanneer de brongegevens veranderen. Als uw organisatie echter honderden tabellen heeft, kost het genereren en beheren van deze pijplijnen veel tijd en kan dit leiden tot inconsistente procedures.
Het sdp-meta-project is een metadata-gedreven metaprogrammatieframework dat is ontworpen om te werken met Lakeflow-pijpleidingen. Met dit framework kunt u brons- en zilvergegevenspijplijnen automatiseren door gebruik te maken van metagegevens die zijn vastgelegd in een set JSON- en YAML-bestanden. Tijdens runtime lezen generieke pipelines je metadata en bouwen dynamisch de daarin beschreven flows op. Brons- en zilververwerking kan in aparte pijpleidingen of samen in een gecombineerde pijpleiding verlopen. Je genereert de metadata over je pijplijnen, en sdp-meta genereert je pijplijnen.
Met uw logica gecentraliseerd op één plaats (de metagegevens), is uw systeem sneller, herbruikbaar en eenvoudiger te onderhouden.
Note
Het sdp-meta-project heette dlt-metavroeger , naar de oudere Delta Live Tables-functie in Azure Databricks.
Delta Live Tables is vervangen door Lakeflow-pijpleidingen, en sdp-meta werkt samen met Lakeflow-pijpleidingen. Als je een bestaande dlt-meta installatie upgradet, bekijk dan de migratiegids in de sdp-meta-documentatie.
Voordelen van sdp-meta
Er zijn twee hoofdgebruiksscenario's voor sdp-meta:
- U kunt eenvoudig een groot aantal tabellen opnemen en opschonen.
- Dwing data engineering-standaarden af voor meerdere pijplijnen en gebruikers.
De voordelen van het gebruik van een op metagegevens gebaseerde benadering zijn onder andere:
- Het onderhouden van metagegevens kan zonder kennis van Python- of SQL-code worden uitgevoerd.
- Het onderhouden van metagegevens, in plaats van de code, vereist minder overhead en vermindert fouten.
- De code wordt gegenereerd door sdp-meta, dus het blijft consistent en heeft minder aangepaste code over pipelines en gepubliceerde tabellen.
- U kunt tabellen eenvoudig groeperen in pijplijnen binnen de metagegevens, waardoor het aantal pijplijnen wordt gegenereerd dat nodig is om uw gegevens zo efficiënt mogelijk bij te werken.
Hoe SDP-meta werkt
De volgende afbeelding toont een overzicht van het sdp-metasysteem:
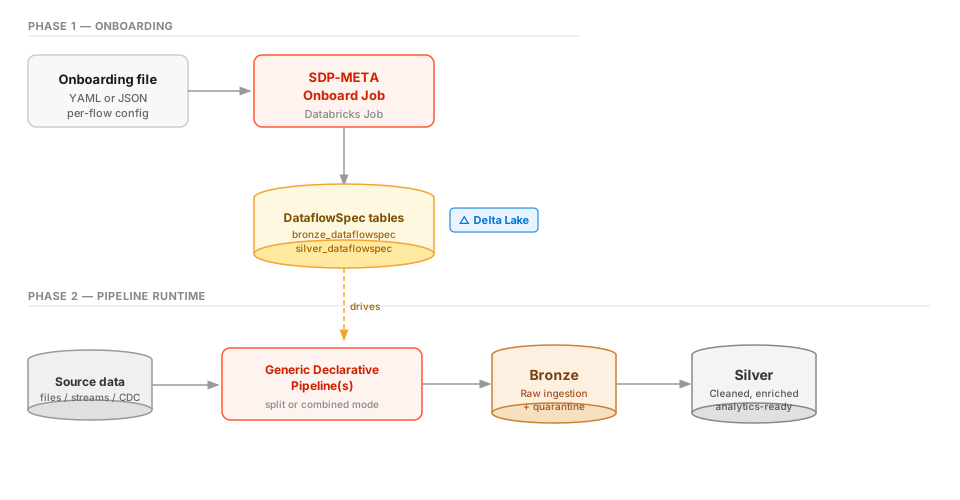
- Je maakt de metadatabestanden aan als invoer voor sdp-meta, om je bronbestanden en outputs, kwaliteitsregels en vereiste verwerking te specificeren. Deze onboardingbestanden kunnen worden geschreven in JSON of YAML.
- Jij leidt de sdp-meta onboarding functie. De engine compileert de onboardingbestanden tot een dataflowspecificatie, genaamd DataflowSpec, en slaat deze op in Delta-tabellen (
bronze_dataflowspecensilver_dataflowspec) voor later gebruik. - Tijdens runtime leest een generieke pipeline de DataflowSpec en bouwt dynamisch de bronze verwerkingsgrafiek. Het leest je brongegevens (bestanden, streams of CDC) en past de juiste dataverwachtingen toe om aan je kwaliteitsregels te voldoen, genereert je bronze tabellen en quarantaineert records die niet aan die regels voldoen.
- Silver-verwerking kan draaien in een aparte generieke pipeline, wat standaard is voor Declarative Automation Bundles, of in dezelfde pipeline wanneer je gecombineerde modus gebruikt. De pijplijn gebruikt DataflowSpec om de juiste transformaties en andere verwerking toe te passen, waarbij zilveren tabellen worden gegenereerd die schoongemaakt, verrijkt en analyseklaar zijn.
Je voert de pipelines uit die door sdp-meta worden gegenereerd om de output actueel te houden terwijl je brondata wordt bijgewerkt.
Get started
Om sdp-meta te gebruiken, moet je:
- Implementeer en configureer de sdp-meta-oplossing.
- Bereid de metagegevens voor uw bronzen en zilveren laagtabellen voor.
- Maak een taak om de metagegevens te onboarden.
- Gebruik de metagegevens om pijplijnen voor uw tabellen te maken.
Het sdp-meta-project ondersteunt verschillende deployment-interfaces: bundels (aanbevolen), een interactieve CLI, een Databricks-app met een browsergebaseerde GUI, een MCP-server voor AI-ondersteunde setup, en een draagbare Agent Skill voor vaardigheidsbewuste AI-agenten.
De sdp-meta-documentatie op GitHub bevat een tutorial om je te helpen met dit proces te beginnen. Voor meer informatie, zie 'Beginnen met sdp-meta' op GitHub.