Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Flexverwerking (preview) biedt inferentie met 50% korting ten opzichte van standaardverwerking voor workloads die tragere reactietijden en incidentele onbeschikbaarheid van resources aankunnen. Selecteer Flex-verwerking voor een afzonderlijk verzoek aan de Responses API of Chat Completions API door service_tier in te stellen op flex.
Gebruik Flexverwerking voor werk met een niet-interactieve en lagere prioriteit, zoals modelevaluaties, gegevensverrijking, documentanalyse en asynchrone toepassingswerkstromen. Voor latentiegevoelige of capaciteitsgevoelige workloads gebruikt u in plaats daarvan standaardverwerking, prioriteitsverwerking of ingerichte doorvoer.
Important
Met de introductie van Flex-verwerking worden aanvragen die zijn ingesteld service_tierflex alleen verwerkt wanneer het geselecteerde model Flex-verwerking ondersteunt. Een niet-ondersteund model retourneert een HTTP 400 invalid_request_error en valt niet terug op Standaardverwerking. Flexverwerking heeft geen latency-SLA en geen service-SLA.
Prerequisites
Een Azure-abonnement. Maak er gratis een.
Een Azure OpenAI-resource met een ondersteund model dat is geïmplementeerd met behulp van het implementatietype Global Standard.
Het resource-eindpunt en een API-sleutel of Microsoft Entra ID-aanmeldingsgegevens. In de voorbeelden in dit artikel wordt een API-sleutel gebruikt die is opgeslagen in de
AZURE_OPENAI_API_KEYomgevingsvariabele.Een workload die variabele latentie en tijdelijke meldingen dat resources niet beschikbaar zijn kan tolereren.
Python 3.10 of hoger en het OpenAI-Python pakket voor de Python voorbeelden:
pip install --upgrade openai
Een Flex-aanvraag verzenden
Stel service_tier in op flex in elk verzoek dat Flex-verwerking moet gebruiken. De model waarde is de naam van uw Azure modelimplementatie.
Python
In het volgende voorbeeld wordt een Flex-aanvraag verzonden met behulp van de Antwoorden-API:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
Het antwoord bevat de gegenereerde analyse en de servicelaag die de aanvraag verwerkt.
Naslaginformatie:Antwoorden-API
REST
In het volgende voorbeeld wordt dezelfde aanvraag rechtstreeks naar de antwoorden-API verzonden:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Als u wilt controleren welke laag de aanvraag verwerkt, controleert u het service_tier veld in een geslaagd antwoord.
Referentie:REST-referentie voor de Responses API
Een verwerkingsoptie kiezen
Flex-, Standard- en Priority-verwerking zijn servicelaagkeuzes voor online API-aanvragen. Batch en ingerichte doorvoercapaciteit zijn afzonderlijke implementatie- en aankoopopties.
| Option | Hoe u het selecteert | Latentie en beschikbaarheid | Kostenmodel | Geschikt voor |
|---|---|---|---|---|
| Flex-verwerking | Stel aanvraagniveau in service_tier op flex. |
Variabele latentie. Aanvragen kunnen HTTP 429 retourneren wanneer flexcapaciteit niet beschikbaar is. | 50% korting vergeleken met Standard-tokentarieven. Kortingen voor tokens in cache zijn ook van toepassing. | Evaluaties, verrijking, offline-analyse en achtergrondtaken die vertraging kunnen verdragen. |
| Standaardverwerking | Stel aanvraagniveau service_tier in op default, of gebruik de Standard-laag die is geconfigureerd voor de implementatie. |
Onlineverwerking naar beste vermogen voor algemene werklasten. | Standaard tarief voor betalen per token. | Ontwikkel-, test- en productieworkloads met variabel verkeer. |
| Prioriteitsverwerking | Configureer Prioriteit voor de implementatie of stel aanvraagniveau service_tier in op priority. |
Lagere en consistentere latentie, met een gedefinieerd doel voor ondersteunde modellen. | Prioriteitstarief voor betaling per token. | Latentiegevoelige onlinetoepassingen zonder een toezegging voor gereserveerde capaciteit. |
| Batch | Dien een asynchrone batchtaak in bij een Batch-implementatie. | Voor voltooiing wordt gestreefd naar 24 uur. Geen real-time-latentiestreefwaarde. | Gereduceerd batchtarief. | Grote offlinetaken waarvoor geen onmiddellijke reactie nodig is. |
| Ingestelde doorvoer | Een ingerichte implementatie maken en ingerichte doorvoereenheden (PTU's) aanschaffen of reserveren. | Gereserveerde capaciteit met voorspelbare doorvoer en latentie. | PTU-facturering per uur of een Azure reservering. | Bedrijfskritieke productieworkloads met een hoog volume. |
Kies Flexverwerking wanneer alle volgende voorwaarden van toepassing zijn:
- Uw workload kan langere en variabele verwerkingstijden tolereren.
- U geeft de voorkeur aan lagere kosten dan voorspelbare latentie.
- Uw toepassing kan tijdelijke fouten opnieuw proberen of een mislukte aanvraag routeren naar De standaardverwerking.
- Het geselecteerde model en de aanvraagcontext worden ondersteund.
Gebruik flexverwerking niet wanneer een van de volgende voorwaarden van toepassing is:
- Een gebruiker wacht op een interactief antwoord.
- De aanvraag moet worden voltooid binnen een strikt latentiedoel.
- Uw toepassing kan tijdelijke HTTP 429-antwoorden niet tolereren of opnieuw proberen.
- U hebt gereserveerde verwerkingscapaciteit of voorspelbare doorvoer nodig.
Flexverwerking heeft de volgende kenmerken:
-
Selectie op verzoekniveau: Stel
service_tiervoor elk verzoek dat Flex-verwerking moet gebruiken in opflex. - Geen afzonderlijke implementatie: Verzend Standard- en Flex-aanvragen naar dezelfde Global Standard-implementatie en selecteer de laag per aanvraag.
- Ondersteunde API's: Gebruik de API voor antwoorden of chatvoltooiingen.
- Synchroon antwoord: De API-aanroep blijft synchroon, ook al kan het langer duren voordat de workload is voltooid. Flexverwerking is niet hetzelfde als de Batch-API.
- Capaciteitsafhankelijke beschikbaarheid: Een aanvraag kan HTTP 429 retourneren wanneer flexcapaciteit niet beschikbaar is.
-
Geen automatische terugval naar Standard: Uw toepassing moet expliciet opnieuw proberen met
service_tieringesteld opdefaultals Standard-verwerking acceptabel is. - Gedeeld quotum: Flex- en Standard-aanvragen maken gebruik van het quotum dat is toegewezen aan de Global Standard-implementatie.
- Dezelfde modeluitvoerkwaliteit: Flex maakt gebruik van hetzelfde onderliggende model als Standard. De verwerkingslaag wijzigt de latentie, beschikbaarheid en prijs, niet de kwaliteit van het model.
Note
Flex-invoer- en uitvoertokens ontvangen een korting van 50% vergeleken met de bijbehorende Standard-tokentarieven. In aanmerking komende invoertokens in de cache ontvangen ook de toepasselijke korting voor in cache opgeslagen tokens. Zie Azure OpenAI-prijzen voor actuele tarieven.
Ondersteunde modellen bekijken
Flexverwerking heeft bij de introductie een beperkte modelbeschikbaarheid.
gpt-5.6-sol is het eerste ondersteunde model. De volgende tabel bevat ondersteunde modellen. Microsoft voegt meer modellen toe naarmate er ondersteuning beschikbaar komt.
| Model | Version | Implementatietype | Beschikbaarheid van de regio |
|---|---|---|---|
gpt-6.1-sol |
2026-09-29 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
gpt-6-sol |
2026-09-22 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
gpt-6-luna |
2026-09-22 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
gpt-6-astra |
2026-09-03 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
gpt-5.6-sol |
2026-07-09 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
gpt-5.6-luna |
2026-07-09 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
gpt-5.6-terra |
2026-07-09 |
Algemene standaard | Alle Azure regio's waar Global Standard beschikbaar is |
Controleer deze tabel voordat u een Flex-aanvraag verzendt. Stel niet dat een model of een nieuwe modelversie flexverwerking ondersteunt, omdat dit ondersteuning biedt voor Standard- of Priority-verwerking. Een niet-ondersteund model retourneert HTTP 400. Als u wilt voorkomen dat uw toepassing wordt onderbroken, implementeert u een terugval op toepassingsniveau naar De standaardverwerking wanneer de prijzen en prestaties van Standard acceptabel zijn.
Terugvallen op standaardverwerking
Flexverwerking routeert niet automatisch een aanvraag naar Standard wanneer flexcapaciteit niet beschikbaar is. Als het voltooien van de aanvraag belangrijker is dan het behouden van Flex-prijzen, voert u de aanvraag opnieuw uit met service_tier ingesteld op default.
In het volgende voorbeeld wordt een voltooiings-eerste beleid gebruikt. Er wordt eerst geprobeerd met Flex-verwerking en na een HTTP 429-respons wordt het eenmaal opnieuw geprobeerd met Standard-verwerking:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Terugval naar Standard wijzigt de prijs- en prestatiekenmerken van de aanvraag. Gebruik dit patroon alleen wanneer de workload standaardprijzen kan accepteren.
Een HTTP 429-antwoord kan duiden op niet-beschikbare Flex-capaciteit of een quotumlimiet. Omdat Flex- en Standard-verwerking hetzelfde quotum delen, kan het Standard-verzoek ook mislukken als het oorspronkelijke antwoord werd veroorzaakt door een quotumbeperking. Stel limieten voor nieuwe pogingen in en verwerk een tweede RateLimitError in uw applicatie. Wanneer de service de Flex-specifieke fout-id retourneert, gebruikt u deze om de fallback te beperken tot capaciteitsgerelateerde reacties.
Voor workloads die prioriteit geven aan de laagste kosten, voert u Flexverwerking opnieuw uit met exponentieel uitstel voordat u terugvalt. Voor workloads die prioriteit geven aan de voltooiingstijd, moet u terugvallen op Standard na de eerste flexcapaciteitsfout.
ReferentieRateLimitError:
Flexfouten verwerken
Permanente aanvraagfouten onderscheiden van tijdelijke capaciteitsfouten.
| HTTP-status | Fout | Oorzaak | Aanbevolen verwerking |
|---|---|---|---|
| 400 | invalid_request_error |
Het geselecteerde model, de modelversie, de contextlengte, de API of de aanvraagconfiguratie biedt geen ondersteuning voor Flex-verwerking. | Probeer dezelfde aanvraag niet opnieuw. Selecteer een ondersteund model of contextlengte of probeer het expliciet opnieuw met service_tier ingesteld op default. |
| 408 | Time-out van aanvraag | De aanvraag wordt niet voltooid binnen de geconfigureerde client- of servicetime-out. Flexaanvragen kunnen langer duren dan Standard-aanvragen. | Gebruik een langere time-out voor clients. Probeer het opnieuw met begrensde exponentiële wachttijd. Als de voltooiingstijd belangrijker is dan flexprijzen, probeert u het opnieuw met Standard. |
| 429 | Bron niet beschikbaar of aanvraaglimiet bereikt | Flexcapaciteit is tijdelijk niet beschikbaar of de aanvraag heeft een toepasselijke frequentielimiet overschreden. Flexcapaciteit is voorbeschikbaar, dus tijdelijke onbeschikbaarheid is waarschijnlijker tijdens piekuren. | Als de aanvraag een frequentielimiet heeft overschreden, verhoogt u de frequentielimiet van de Global Standard-implementatie door meer quotum toe te wijzen. Flex en Standard delen dit quotum. Als het abonnement niet voldoende quota heeft voor een workload met hoge doorvoer, vraag dan een quotumverhoging aan. Als Flex-capaciteit tijdelijk niet beschikbaar is, probeer het opnieuw met exponentiële back-off en jitter, verdeel werk dat vertraging kan verdragen over daluren, zoals doordeweekse nachten of weekenden, of probeer het opnieuw met service_tier ingesteld op default. Respecteer Retry-After indien aanwezig. |
| 500, 502, 503 of 504 | Tijdelijke servicefout | Een tijdelijk service- of gatewayprobleem heeft voltooiing verhinderd. | Probeer het opnieuw met begrensde exponentiële wachttijd. Verzend geen onbeperkt aantal nieuwe pogingen. |
| 401 of 403 | Verificatie- of autorisatiefout | De referentie ontbreekt, is ongeldig, verlopen of heeft geen toegang tot de resource. | Corrigeer de aanmeldingsgegevens of roltoewijzing. Probeer het pas opnieuw als de configuratie is gewijzigd. |
| 404 | Implementatie is niet gevonden | De implementatienaam of het eindpunt is onjuist. |
model Controleer of deze overeenkomt met de implementatienaam en of de basis-URL verwijst naar de juiste Azure OpenAI-resource. |
Note
Een Flex-aanvraag geweigerd omdat de verwerkingscapaciteit niet beschikbaar is, wordt niet gefactureerd. U ziet echter mogelijk minder beschikbare snelheidslimietcapaciteit omdat Flex- en Standard-aanvragen het quotum delen dat is toegewezen aan de Global Standard-implementatie.
Gebruik exponentieel uitstel met willekeurige jitter voor HTTP 408-, 429- en tijdelijke 5xx-antwoorden. Stel een maximumaantal nieuwe pogingen en maximale vertraging in, zodat een mislukte aanvraag niet in een niet-gebonden lus voor opnieuw proberen blijft staan.
- Respecteer
Retry-Afterals dit in het antwoord voorkomt. - Wacht anders op een exponentieel toenemende vertraging met willekeurige jitter.
- Probeer Flex alleen opnieuw terwijl de vertraging acceptabel blijft voor de workload.
- Terugvallen op Standard als het budget voor opnieuw proberen is uitgeput en de toepassing de hogere Standard-kosten toestaat.
- Retourneer een expliciete fout als de vertraagde Flex-verwerking of Standard-terugval niet voldoet aan de vereisten van de toepassing.
Probeer niet herhaaldelijk dezelfde niet-ondersteunde Flex-aanvraag opnieuw. Een nieuwe poging slaagt pas nadat u het model, de contextlengte, de API-configuratie of de servicelaag hebt gewijzigd.
Gebruik en kosten controleren
Gebruik Azure Monitor metrische gegevens om Flex- en Standard-verkeer op dezelfde implementatie te vergelijken. Bewaak het aanvraagvolume, het tokenverbruik, de latentie, fouten en de snelheid waarmee Flex-aanvragen terugvallen op Standard in uw toepassing.
Meld u aan bij het Azure-portaal.
Ga naar uw Azure OpenAI-resource en selecteer Metrische gegevens.
Voeg de metriek Azure OpenAI-aanvragen toe. U kunt ook Azure OpenAI-latentie, Azure OpenAI-gebruik en metrische foutgegevens toevoegen.
Voeg een filter toe waarbij ServiceTierRequest gelijk is aan
flex.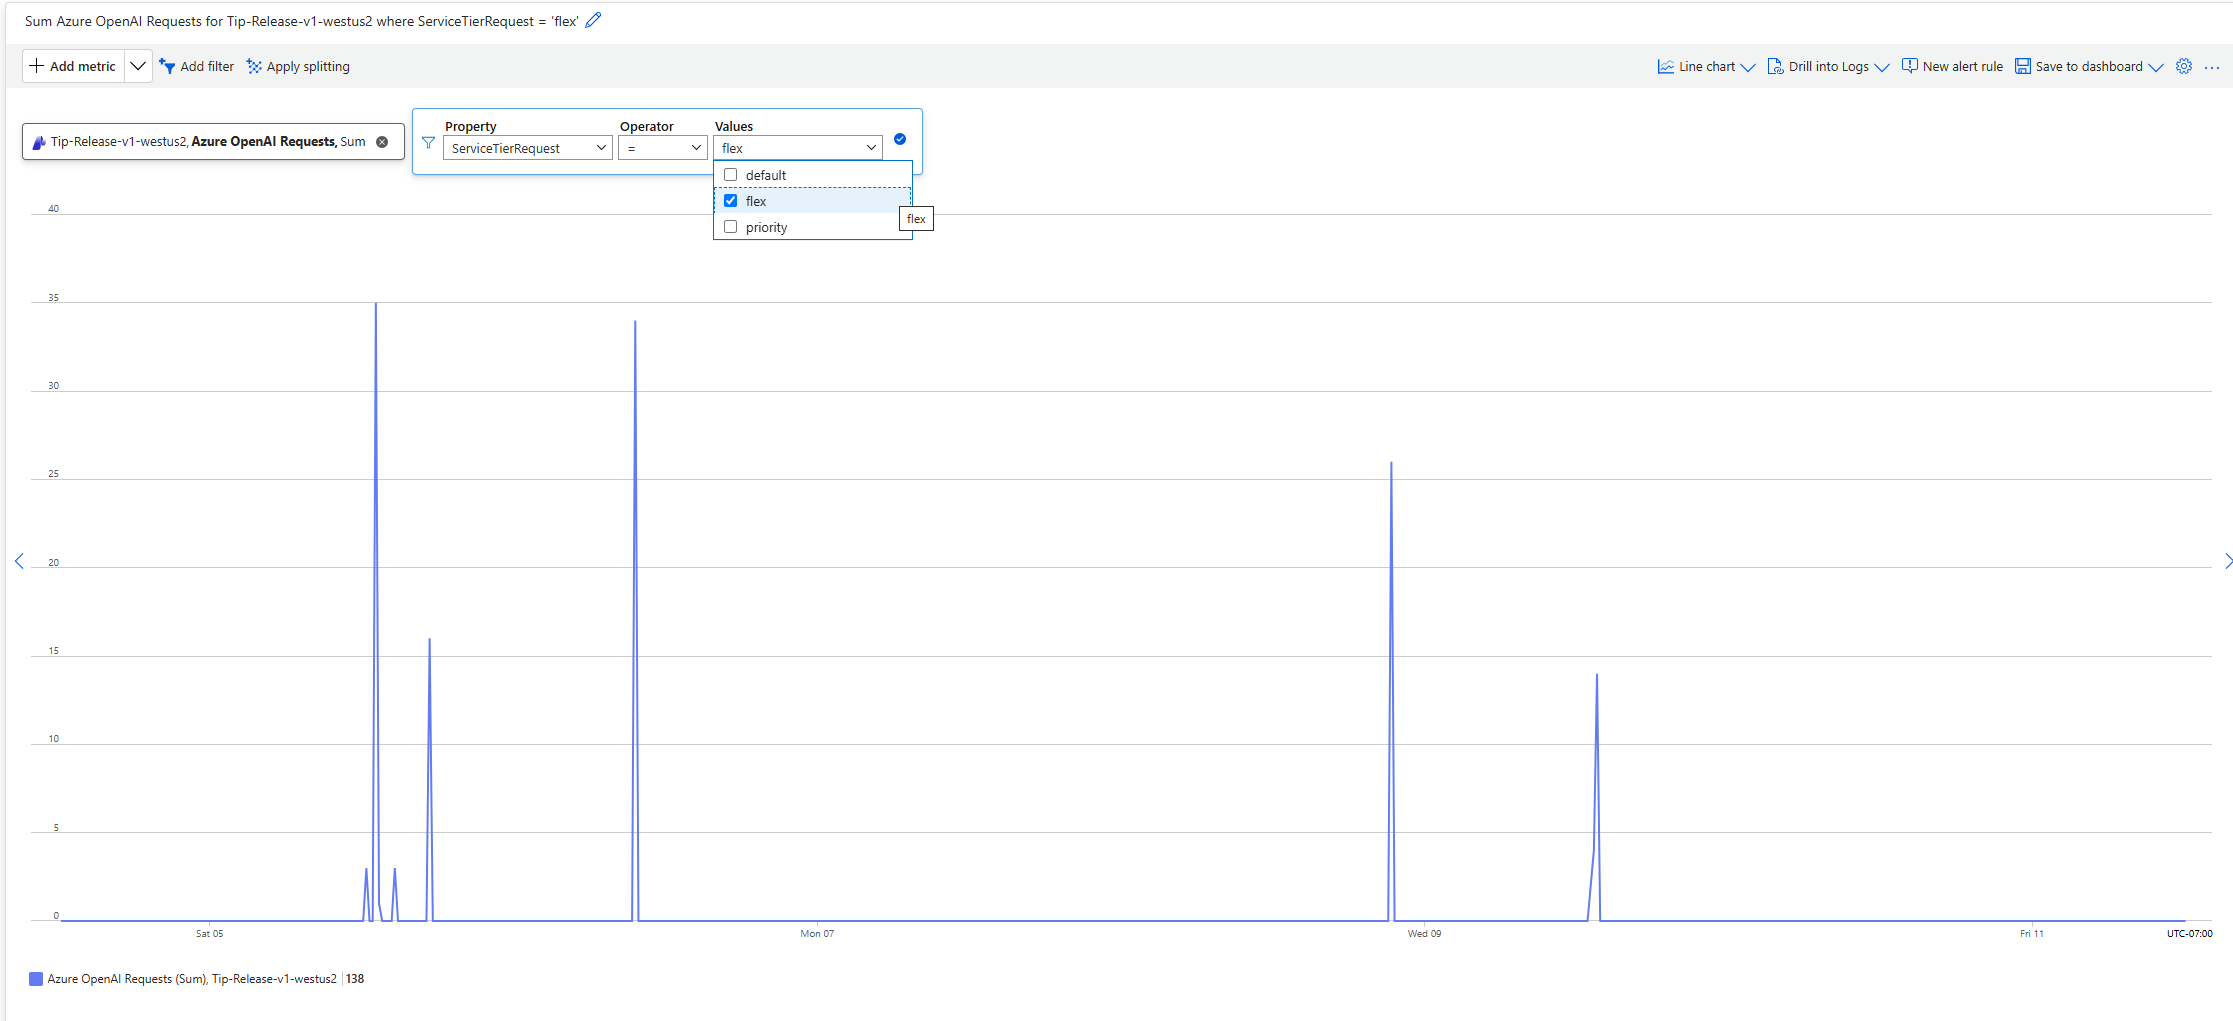
Maak waarschuwingen voor langdurige HTTP 429-antwoorden, verhoogde foutpercentages en latentie die het budget voor opnieuw proberen van uw workload overschrijdt.
Volg de volgende signalen voor elke workload:
| Signaal | Waarom het belangrijk is |
|---|---|
| Aantal Flex-aanvragen | Toont acceptatie en verkeer dat wordt gerouteerd voor goedkopere verwerking. |
| Geslaagde Flex-aanvraagsnelheid | Laat zien hoe vaak flexcapaciteit aanvragen accepteert en voltooit. |
| HTTP 429-snelheid | Geeft perioden weer waarin flexcapaciteit of implementatiequotum wordt beperkt. |
| Standaard terugvalaantal en -rente | Toont het betrouwbaarheidsvoordeel en de toegevoegde kosten van door toepassingen beheerde terugval. |
| Invoer-, gecachete invoer- en uitvoertokens | Ondersteunt kostentoerekening en verifieert het effect van prompt-caching. |
| end-to-end-latentie | Hiermee kunt u bepalen of een workload geschikt blijft voor Flex. |
HTTP 400 invalid_request_error aantal |
Identificeert niet-ondersteunde modellen, modelversies, contextlengten of aanvraagconfiguraties. |
Zie Monitor Azure OpenAI voor meer informatie over het bewaken van modelimplementaties.
Flexgebruik wordt gefactureerd op toegewezen Flexmeters, zodat u deze kunt onderscheiden van Standaardgebruik. Gebruik Kostenanalyse om de kosten van flextoken per resource en implementatie te controleren.
- Open in de Azure PortalCost Management + Facturering>Kostenanalyse.
- Filter op het abonnement, de resourcegroep of de Azure OpenAI-resource die de implementatie bevat.
- Groeperen of filteren op meter om flexgebruik te scheiden van standaardgebruik.
- Voeg een factureringstagfilter toe, selecteer implementatie en kies de naam van de implementatie.
- Vergelijk Flex-kostenbesparingen met standard-terugvalkosten en de voltooiingsvereisten van de workload.
Flex-invoer- en uitvoertokens zijn geprijsd op 50% van de bijbehorende Standaardtarieven. Promptcaching kan de kosten van in aanmerking komende inputtokens in de cache verder verlagen. Een Flex-aanvraag geweigerd omdat de verwerkingscapaciteit niet beschikbaar is, wordt niet gefactureerd.
Best practices voor productie toepassen
- Stel een langere time-out in. Flexaanvragen kunnen langer duren dan Standard-aanvragen. Begin met een clienttime-out die geschikt is voor uw workload, zoals 15 minuten, en test met representatieve prompts.
- Gebruik een begrensd aantal herhalingspogingen. Limiet voor nieuwe pogingen en totale verstreken tijd.
- Voeg jitter toe. Randomiseer uitstelvertragingen om gesynchroniseerde pieken voor opnieuw proberen te voorkomen.
- Maak de fallbackoptie expliciet. Ingesteld
service_tieropdefaultin plaats van te vertrouwen op impliciet gedrag. - Volg het verwerkte niveau. Noteer de antwoordwaarde
service_tiermet latentie, status, tokengebruik en kostengegevens. - Interactief en achtergrondverkeer scheiden. Houd gebruikersgerichte aanvragen op Standaard, Prioriteit of ingerichte doorvoer, tenzij variabele Flex-latentie acceptabel is.
- Voorkom dubbel werk. Zorg ervoor dat de toepassing niet meerdere keren dezelfde logische taak indient na time-outs aan de clientzijde.
- Foutpaden testen. Valideer de verwerking voor HTTP 400-, 408-, 429- en tijdelijke 5xx-antwoorden voordat u Flexverwerking gebruikt in productiewerkstromen.
- Bekijk modelondersteuning vóór upgrades. Een vervangend model of modelversie neemt niet automatisch Flex-ondersteuning over.
De servicelaag overschrijven met een aanvraagheader
Gebruik de x-ms-service-tier aanvraagheader wanneer een gateway, proxy of gecentraliseerde routeringslaag de servicelaag moet selecteren zonder de aanvraagbody te inspecteren of te wijzigen. De header kan ook migratiewijzigingen verminderen voor toepassingen die al een OpenAI-servicelaag selecteren via een aanvraagheader.
De header accepteert de volgende waarden:
| Headerwaarde | Aangevraagde verwerkingslaag |
|---|---|
flex |
Flexibiliteit |
priority |
Priority |
default |
Standard |
auto |
Priority |
Wanneer de koptekst aanwezig is en geldig is, heeft deze voorrang op de service_tier waarde in de hoofdtekst van de aanvraag.
| Koptekstinvoer | Invoer van aanvraagbody | Gedrag en uitvoer |
|---|---|---|
| Koptekst weggelaten | Geldige service_tier waarde |
De aanvraagtekst specificeert het niveau. Een geslaagd antwoord identificeert de verwerkte laag in service_tier. |
| Geldige headerwaarde | Een willekeurige waarde of weggelaten | De header selecteert de aangevraagde laag. Een geslaagd antwoord identificeert de verwerkte laag in service_tier. |
| Niet-ondersteunde headerwaarde | Een willekeurige waarde of weggelaten | De aanvraag retourneert HTTP 400. De service valt niet terug op de hoofdtekstwaarde van de aanvraag. |
In dit voorbeeld wordt Flex-verwerking aangevraagd via de header. De header overschrijft de default waarde in de aanvraagbody:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
De overschrijvingsheader biedt geen automatische terugvaloptie. Een ongeldige headerwaarde of een laag die door de geselecteerde implementatie niet wordt ondersteund, retourneert HTTP 400.