Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Azure DocumentDB is een volledig beheerde NoSQL databaseservice voor moderne toepassingsontwikkeling met MongoDB-compatibiliteit. Azure DocumentDB ondersteunt een configuratie voor hoge beschikbaarheid met synchroon gerepliceerde hot-stand-byreplica's en zoneredundantie. Het biedt ook een optionele leesreplica in een andere Azure-regio en automatische back-ups met point-in-time-herstel om bescherming te bieden tegen onopzettelijk gegevensverlies.
Wanneer u Azure gebruikt, is betrouwbaarheid een gedeelde verantwoordelijkheid. Microsoft biedt een scala aan mogelijkheden ter ondersteuning van tolerantie en herstel. U bent verantwoordelijk voor het begrijpen van de werking van deze mogelijkheden binnen alle services die u gebruikt en het selecteren van de mogelijkheden die u nodig hebt om te voldoen aan uw bedrijfsdoelstellingen en beschikbaarheidsdoelen.
In dit artikel wordt beschreven hoe u Azure DocumentDB bestand maakt tegen verschillende mogelijke storingen en problemen, waaronder tijdelijke fouten, storingen in de beschikbaarheidszone, regiostoringen en serviceonderhoud. Het beschrijft ook back-upgedrag en biedt belangrijke informatie over HA en replicatie tussen regio's.
Aanbevelingen voor productie-implementatie voor betrouwbaarheid
Zie Best practices voor hoge beschikbaarheid (HA) en replicatie tussen regio's in Azure DocumentDB voor een lijst met aanbevelingen voor het verbeteren van de betrouwbaarheid van uw cluster.
Overzicht van betrouwbaarheidsarchitectuur
In deze sectie worden enkele belangrijke aspecten beschreven van de werking van de service die het meest relevant is vanuit het perspectief van betrouwbaarheid. In de sectie wordt de logische architectuur geïntroduceerd, die enkele van de resources en functies bevat die u implementeert en gebruikt. Ook wordt de fysieke architectuur besproken, die details biedt over hoe de service achter de schermen werkt.
Logische architectuur
De primaire resource die u implementeert, is een Azure DocumentDB-cluster. Voor elk cluster kiest u een rekenlaag en configureert u opslag. De geselecteerde laag bepaalt de mogelijkheden die beschikbaar zijn voor betrouwbaarheidsfuncties, zoals hoge beschikbaarheid (HA), en bepaalt ook hoe u capaciteit plant voor tolerantiescenario's.
Toepassingen maken verbinding met een cluster met behulp van verbindingsreeksen en eindpunten. Azure DocumentDB biedt verbindingseindpunten voor lees-schrijfbewerkingen en, indien geconfigureerd, eindpunten voor leesreplicaclusters. Met deze eindpunten kan uw toepassing stabiele verbindingspatronen blijven gebruiken terwijl de service achter de schermen failovergedrag beheert.
Binnen elk cluster zijn uw gegevens ingedeeld als databases, verzamelingen en documenten. Dit met MongoDB compatibele gegevensmodel vormt de basis voor ontwerpbeslissingen op workloadniveau, zoals shardingstrategie, lees- en schrijfpatronen en back-up- en herstelbereik.
Fysieke architectuur
Azure DocumentDB uw cluster uitvoert op shards, die knooppunten (virtuele machines) vertegenwoordigen waarop de service wordt uitgevoerd. U kunt één shard implementeren of uitschalen naar meerdere shards. Het implementeren van meerdere shards verbetert de schaalcapaciteit, maar biedt op zichzelf geen hoge beschikbaarheid.
Wanneer u HOGE beschikbaarheid inschakelt, richt Azure DocumentDB een overeenkomende set stand-by-shards in. Elke primaire shard heeft een stand-by-shard. De dienst repliceert gegevens synchroon tussen elk primair-stand-by-paar en promoveert de stand-by-shard als de primaire shard uitvalt. Zie Hoge beschikbaarheid in Azure DocumentDB voor meer informatie over hoge beschikbaarheid.
Azure DocumentDB gebruikt Azure Storage voor duurzaamheid van shards. Als HA is uitgeschakeld, gebruikt elke shard lokaal redundante opslag (LRS). LRS onderhoudt drie kopieën van de gegevens, maar is niet tolerant voor het verlies van een beschikbaarheidszone. Zie Overzicht van redundantieopties voor LRS-duurzaamheid.
Zie Beschikbaarheid en herstel na noodgevallen (DR) in Azure DocumentDB: achter de schermen voor meer informatie.
Tolerantie voor tijdelijke fouten
Tijdelijke fouten zijn korte, onregelmatige fouten in onderdelen. Ze vinden vaak plaats in een gedistribueerde omgeving, zoals de cloud, en ze zijn een normaal onderdeel van de bewerkingen. Tijdelijke fouten corrigeren zichzelf na een korte periode. Het is belangrijk dat uw toepassingen tijdelijke fouten kunnen afhandelen, meestal door de betreffende aanvragen opnieuw uit te voeren.
Alle cloudtoepassingen moeten de Azure richtlijnen voor tijdelijke foutafhandeling volgen wanneer ze communiceren met api's, databases en andere onderdelen die in de cloud worden gehost. Zie Aanbevelingen voor het afhandelen van tijdelijke fouten voor meer informatie.
Azure DocumentDB compatibel is met het MongoDB-protocol, zodat toepassingen meestal verbinding maken met mongoDB-stuurprogramma's. U bent verantwoordelijk voor het configureren van de instellingen voor opnieuw proberen van het stuurprogramma van uw toepassing voor het afhandelen van tijdelijke fouten, met name verbindingsonderbrekingen en korte schrijfonderbrekingen tijdens failover-gebeurtenissen. Volg deze richtlijnen:
Gebruik MongoDB-stuurprogramma's die ondersteuning bieden voor automatische verwerking van nieuwe pogingen voor tijdelijke verbindingsfouten.
Stel exponentieel toenemend uitstel in voor nieuwe pogingen en beperk het aantal pogingen.
Ontwerp indien mogelijk schrijfbewerkingen om idempotent te zijn, zodat het opnieuw proberen veilig is. Zie het Idempotent Consumer-patroon voor algemene implementatierichtlijnen over idempotentie.
Tolerantie voor fouten in beschikbaarheidszones
Beschikbaarheidszones zijn fysiek gescheiden groepen datacenters binnen een Azure-regio. Wanneer één zone uitvalt, kunnen services een failover uitvoeren naar een van de resterende zones.
Als u ondersteuning voor beschikbaarheidszones wilt gebruiken in Azure DocumentDB, schakelt u hoge beschikbaarheid (HA) in. Wanneer u hoge beschikbaarheid inschakelt in een regio die beschikbaarheidszones ondersteunt, wordt uw cluster zone-redundant omdat Azure DocumentDB de stand-by-shards in een andere beschikbaarheidszone plaatst dan de primaire shards. Stand-by-shards ontvangen geen clientaanvragen, tenzij hun primaire shard mislukt.
Als u hoge beschikbaarheid uitschakelt, plaatst Azure DocumentDB geen stand-byshards in een andere beschikbaarheidszone, dus als er een beschikbaarheidszone uitvalt, kan uw cluster onbeschikbaar worden.
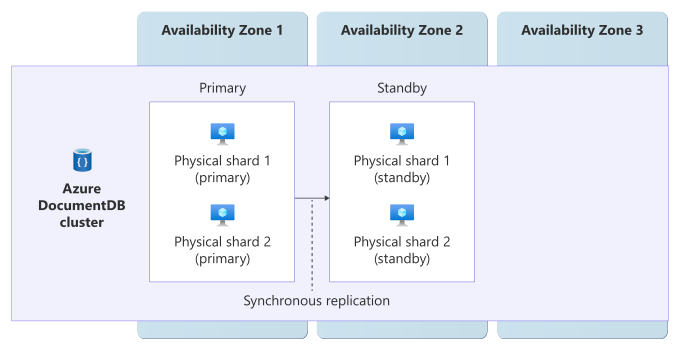
In het diagram ziet u één Azure DocumentDB-cluster in drie beschikbaarheidszones. Twee primaire fysieke shards bevinden zich in beschikbaarheidszone 1 en de bijbehorende fysieke stand-by-shards bevinden zich in beschikbaarheidszone 2. Pijlen tussen elke primaire shard en de bijbehorende standby-shard geven synchrone replicatie aan. Beschikbaarheidszone 3 bevat geen shards in dit voorbeeld.
Behoeften
Regioondersteuning: Als u beschikbaarheidszones wilt gebruiken met Azure DocumentDB, kiest u een regio die ondersteuning biedt voor zowel Azure DocumentDB als beschikbaarheidszones. Controleer de beschikbare producten per regio en vergelijk deze met regio's die beschikbaarheidszones ondersteunen.
Hoge beschikbaarheid: U moet hoge beschikbaarheid inschakelen op het cluster. HA vereist dat het cluster gebruikmaakt van het M30-computeniveau (of hoger).
Overwegingen
Hoewel sommige Azure DocumentDB-API's verwijzingen naar dezelfde zone-implementatiemodi bevatten, biedt Azure DocumentDB geen ondersteuning voor implementaties met dezelfde zone-HA. De service ondersteunt zone-redundante HA-implementaties.
Exemplaardistributie tussen zones
Microsoft selecteert twee beschikbaarheidszones voor het cluster. In zoneredundante HA-implementaties plaatst Azure DocumentDB alle primaire shards in één zone en alle stand-by-shards in de andere zone.
Cost
Wanneer hoge beschikbaarheid is ingeschakeld, richt Azure DocumentDB een stand-by-shard in voor elke primaire shard, waardoor de reken- en opslagkosten van uw cluster toenemen. In regio's die beschikbaarheidszones ondersteunen, maakt HA het cluster ook zone-redundant. In sommige implementatiemodi biedt Azure DocumentDB standaard HA. Laat HA ingeschakeld voor productieworkloads. Voor ontwikkelings- en testworkloads kunt u HA uitschakelen om de kosten te verlagen. Zie Azure DocumentDB-prijzen voor meer informatie over prijzen.
Ondersteuning voor beschikbaarheidszones configureren
Maak een nieuw zoneredundant Azure DocumentDB-cluster: Wanneer u een cluster maakt in een regio die beschikbaarheidszones ondersteunt, schakelt u HA in om het cluster zoneredundant te maken. Zie Quickstart: Een Azure DocumentDB-cluster maken met behulp van de Azure-portal voor gedetailleerde stappen.
Zoneredundantie inschakelen op een bestaand Azure DocumentDB-cluster: U kunt HA (hoge beschikbaarheid) inschakelen op een bestaand cluster. Er is geen downtime voor databases wanneer hoge beschikbaarheid is ingeschakeld of uitgeschakeld op een Azure DocumentDB-cluster. Zie Een Azure DocumentDB-cluster schalen voor gedetailleerde stappen.
Gedrag wanneer alle zones in orde zijn
In deze sectie wordt beschreven wat u kunt verwachten wanneer u een Azure DocumentDB-cluster configureert voor hoge beschikbaarheid in een regio die beschikbaarheidszones ondersteunt en alle zones operationeel zijn.
Bewerking tussen zones: De primaire shards verwerken alle clientaanvragen. Standby-shards in een andere beschikbaarheidszone ontvangen geen clientverzoeken, tenzij de primaire shard uitvalt.
Replicatie van gegevens in meerdere zones: Replicatie tussen primaire en stand-by-shards is synchroon. Schrijfbewerkingen worden opgeslagen op zowel de primaire als de standby-shards voordat de service een reactie terugstuurt.
Gedrag tijdens een zonefout
In deze sectie wordt beschreven wat u kunt verwachten wanneer u een Azure DocumentDB-cluster configureert voor hoge beschikbaarheid in een regio die beschikbaarheidszones ondersteunt en er een storing is in een van de zones.
Detectie en respons: Microsoft bewaakt de shardstatus en verwerkt detectie- en failoverbewerkingen voor u. Als een primaire shard niet meer beschikbaar is vanwege een zonestoring, bevordert Azure DocumentDB automatisch de stand-by-shard en bouwt vervolgens redundantie opnieuw op door een nieuwe stand-by-shard te maken.
Notification: Microsoft informeert u niet automatisch wanneer een zone niet beschikbaar is. U kunt Azure Service Health echter gebruiken om inzicht te hebben in de algehele status van de service, inclusief eventuele zonefouten, en u kunt Service Health-waarschuwingen instellen om u op de hoogte te stellen van problemen.
Actieve verzoeken: Lopende verzoeken die niet zijn bevestigd vóór een failover, kunnen mislukken en moeten door de client opnieuw worden geprobeerd. Als uw toepassing tijdelijke fouten afhandelt, worden deze nieuwe pogingen doorgaans automatisch voltooid.
Verwacht gegevensverlies: Azure DocumentDB gegevens synchroon repliceert tussen de primaire en stand-by-shards, zodat er geen gegevensverlies wordt verwacht.
Verwachte downtime: Er wordt geen downtime verwacht voor leesbewerkingen. Voor schrijfbewerkingen kan er een korte onderbreking optreden terwijl de failover is voltooid. Als uw toepassing tijdelijke storingen correct opnieuw probeert, uit zich dit meestal als een korte vertraging.
Herdistributie: De verbindingsreeks verandert niet, zodat clients hetzelfde eindpunt blijven gebruiken. De dienst leidt verkeer automatisch om naar gepromoveerde standby-shards en bouwt nieuwe standby-shards opnieuw op.
Herstel van zone
Wanneer de beschikbaarheidszone wordt hersteld, herstelt Azure DocumentDB automatisch normale bewerkingen voor alle zones die door het cluster worden gebruikt.
Testen op zonefouten
Het Azure DocumentDB-platform beheert verkeersroutering, failover en zoneherstel voor zone-redundante clusters. U hoeft geen processen voor fouten in de beschikbaarheidszone te initiëren of valideren.
Tolerantie voor storingen in de hele regio
U implementeert elk Azure DocumentDB-cluster in één Azure regio. Ter ondersteuning van tolerantie voor regiofouten configureert u replicatie tussen regio's door één replicacluster toe te voegen in een andere regio.
Replicatie tussen regio's
Azure DocumentDB ondersteunt replicatie tussen regio's via een replicacluster. Het replicacluster wordt weergegeven als een afzonderlijk cluster in uw resourcegroep. U kunt dit replica-cluster gebruiken voor noodherstel en het opschalen van leesbewerkingen. Azure DocumentDB automatisch en asynchroon gegevenswijzigingen repliceert van het primaire cluster naar het replicacluster.
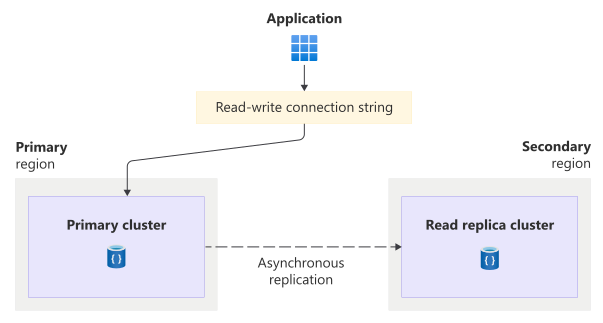
Het diagram toont een toepassing die via de lees-/schrijfverbindingsreeks verbinding maakt met het primaire cluster in de primaire regio. Een onderbroken pijl toont asynchrone replicatie van het primaire cluster naar een leesreplicacluster in de secundaire regio.
Als uw primaire regio mislukt, kan het replicacluster worden gepromoveerd tot het lees-/schrijfcluster. De globale lees-/schrijf-verbindingsreeks wordt automatisch bijgewerkt zodat deze naar het gepromoveerde cluster verwijst.
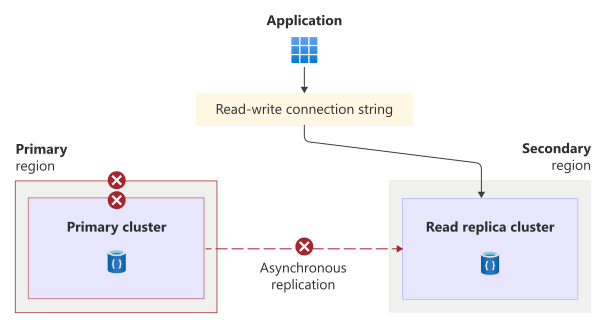
Het diagram toont een toepassing die via de lees-/schrijfverbindingsreeks verbinding maakt met het replicacluster in de secundaire regio na de promotie. Foutsymbolen markeren het primaire cluster, de primaire regio en het voormalige asynchrone replicatiepad.
In deze sectie vindt u een overzicht van de betrouwbaarheidsoverwegingen voor replicatie tussen regio's. Zie Replicatie tussen regio's en dezelfde regio beheren op uw Azure DocumentDB-cluster en best practices voor replicatie in meerdere regio's en replicatie in dezelfde regio in Azure DocumentDB.
Failover tussen regio's
Azure DocumentDB ondersteunt drie promotiemodi:
Geforceerde promotie: Promoveert het replicacluster onmiddellijk zodat het schrijfbewerkingen accepteert en leidt inkomend schrijfverkeer om via de globale verbindingsreeks voor lezen en schrijven. Deze modus minimaliseert de uitvaltijd, maar kan leiden tot gegevensverlies omdat niet-gerepliceerde schrijfbewerkingen verloren gaan.
Door de service beheerde failover: U kunt uw cluster configureren voor het gebruik van door de service beheerde failover. Microsoft controleert uw primaire cluster en activeert automatisch een geforceerde promotie als het primaire cluster niet in orde is.
Gecontroleerde promotie: Voorkomt gegevensverlies, maar vereist enige uitvaltijd terwijl niet-gerepliceerde schrijfbewerkingen worden gerepliceerd. Voor een probleemloze promotie moeten beide clusters in orde zijn, zodat u deze niet kunt uitvoeren tijdens een storing in de regio.
Zie failovermodi tussen regio's in Azure DocumentDB voor meer informatie.
Behoeften
Regioondersteuning: U kunt replicatie tussen regio's gebruiken in alle Azure regio's die ondersteuning bieden voor Azure DocumentDB.
Rekenlaag: Replicatie tussen regio's vereist de M30-rekenlaag of hoger.
Overwegingen
Netwerktoegang: Replicaclusters nemen geen netwerkinstellingen over van het primaire cluster. Configureer firewallregels of privé-eindpunten afzonderlijk op het replicacluster en test de connectiviteit vóór een failover. Zie Continue schrijfbewerkingen, leesbewerkingen op clusterreplica's en verbindingsreeksen voor meer informatie.
Functieondersteuning: Replicaclusters bieden geen ondersteuning voor herstel naar een bepaald tijdstip (PITR) of hoge beschikbaarheid in de regio.
Als hoge beschikbaarheid is ingeschakeld op het primaire cluster, bent u verantwoordelijk voor het opnieuw inschakelen van hoge beschikbaarheid op het gepromoveerde cluster.
Zie Azure DocumentDB-servicelimieten en -quota voor meer informatie.
Cost
Replicatie tussen regio's voegt kosten toe voor de reken- en opslagresources van het replicacluster. Kosten voor gegevensoverdracht tussen regio's zijn ook van toepassing. Zie Azure DocumentDB-prijzen en bandbreedteprijzen voor meer informatie over prijzen.
Ondersteuning voor meerdere regio's configureren
Een replicacluster maken: Als u replicatie tussen regio's wilt inschakelen, maakt u een replicacluster op basis van uw primaire cluster. U kunt een replicacluster maken wanneer u het primaire cluster of later maakt. Zie Replicatie tussen regio's en dezelfde regio beheren op uw Azure DocumentDB-cluster voor stappen.
Automatische failover configureren: Als u wilt dat Azure de replica automatisch promoveren tijdens storingen in de primaire regio, schakelt u door de service beheerde failover in. Zie door de service beheerde failover inschakelen voor meer informatie.
Note
Microsoft activeert doorgaans servicebeheerde failover alleen in extreme gebeurtenissen, zoals een hele regiostoring of een groot aantal betrokken klanten. Er kan een vertraging optreden voordat de failover wordt geactiveerd. Als u de beschikbaarheid snel wilt herstellen, raden we u aan het failoverproces te beheren met behulp van door de klant geïnitieerde geforceerde promotie.
Gedrag wanneer alle regio's in orde zijn
In deze sectie wordt beschreven wat u kunt verwachten wanneer u een Azure DocumentDB-cluster configureert voor replicatie tussen regio's en alle regio's operationeel zijn.
Bewerking tussen regio's: Het primaire cluster dient alle lees-/schrijfverkeer. Het replicacluster verwerkt alleen-leesverkeer, dat u kunt gebruiken om leesworkloads op te schalen of om leesverkeer lokaal te houden in een specifieke regio. De globale lees-/schrijfverbindingsreeks verwijst altijd naar het huidige schrijfbare cluster, zodat clients niet hoeven bij te houden welke regio de primaire regio is.
Replicatie van gegevens in meerdere regio's: Replicatie tussen het primaire cluster en het replicacluster is asynchroon. Schrijfbewerkingen worden doorgevoerd op het primaire cluster en bevestigd aan de client voordat ze worden gerepliceerd naar het replicacluster. Deze methode voorkomt dat netwerklatentie tussen regio's invloed heeft op schrijfprestaties. Omdat replicatie asynchroon is, wordt er een vertraging in de replicatie verwacht tussen de primaire en replicaclusters en kunnen niet-gerepliceerde schrijfbewerkingen verloren gaan tijdens een geforceerde failover.
Gedrag tijdens een regiofout
In deze sectie wordt beschreven wat u kunt verwachten wanneer u een Azure DocumentDB-cluster configureert voor replicatie tussen regio's en er een storing is in de regio van het primaire cluster.
Detectie en reactie: De verantwoordelijkheid voor het detecteren van de storing en het reageren is afhankelijk van het type failover dat uw cluster gebruikt.
- Als door de service beheerde failover is ingeschakeld, detecteert Azure DocumentDB de storing en voert automatisch een geforceerde promotie van het replicacluster uit.
- Als door de service beheerde failover niet is ingeschakeld, bent u verantwoordelijk voor het detecteren van de storing en het activeren van een geforceerde promotie.
Zie failovermodi tussen regio's in Azure DocumentDB voor meer informatie.
Notification: Microsoft geeft u niet automatisch een melding wanneer een regio uitvalt. U kunt Azure Service Health echter gebruiken om inzicht te hebben in de algehele status van de service, inclusief eventuele regiofouten, en u kunt Service Health-waarschuwingen instellen om u op de hoogte te stellen van problemen.
Actieve aanvragen: Actieve aanvragen voor de mislukte primaire regio kunnen mislukken. Nadat de failover is voltooid, moeten toepassingen opnieuw verbinding maken en nieuwe pogingen doen bij het gepromoveerde cluster.
Verwachte gegevensverlies: Failovers tijdens regiofouten zijn niet gepland, dus niet-gerepliceerde schrijfbewerkingen kunnen verloren gaan omdat replicatie asynchroon is.
Verwachte downtime: De algehele downtime is afhankelijk van de detectietijd, failovermodus en het gedrag van opnieuw verbinding maken met de client.
Voor door de klant geïnitieerde geforceerde promotie omvat de totale downtime de tijd die nodig is om de storing te detecteren en uw reactieprocessen te initiëren, evenals de tijd die nodig is om de promotie te voltooien.
Zodra een promotie is gestart, wordt deze doorgaans binnen een paar minuten voltooid.
Omleiding: De globale verbindingsreeks voor lezen en schrijven verwijst na de promotie automatisch naar het gepromoveerde cluster. Toepassingen die gebruikmaken van clusterspecifieke verbindingsreeksen, vereisen mogelijk configuratie-updates, zodat ze verkeer naar het gezonde cluster leiden.
Herstel van de regio
Azure DocumentDB schakelt na herstel niet automatisch terug naar de oorspronkelijke regio. Als u schrijfbewerkingen wilt retourneren naar de oorspronkelijke regio, voert u een andere promotie uit nadat u de voorkeurstopologie hebt hersteld. Gebruik een gecontroleerde promotie om gegevensverlies tijdens failback te voorkomen. Een elegante promotie vereist een kleine hoeveelheid downtime en u kunt deze uitvoeren op een moment dat u kiest, zoals tijdens een onderhoudsvenster. Zie Een sierlijke promotie activeren voor meer informatie.
Test voor regiofouten
Test regelmatig uw herstelproces na noodgevallen door het replicacluster in een gecontroleerde omgeving te promoten.
Gebruik gedwongen promotie om het gedrag bij storingen te simuleren. Deze test kan leiden tot gegevensverlies, dus overweeg deze test uit te voeren in een niet-productieomgeving. Zie Een geforceerde promotie activeren voor meer informatie.
Gebruik gecontroleerde promotie voor geplande overschakelingsoefeningen wanneer u gegevensverlies wilt voorkomen. Zie Een sierlijke promotie activeren voor meer informatie.
Back-up maken en terugzetten
Replicatie en ondersteuning voor beschikbaarheidszones helpen een cluster beschikbaar te houden tijdens infrastructuurfouten. Azure DocumentDB maakt automatisch continue back-ups, die een ander risico aanpakken door herstel naar een bepaald tijdstip (PITR) in te schakelen nadat u per ongeluk gegevens hebt verwijderd of gewijzigd. Azure DocumentDB maakt back-ups zonder dat dit van invloed is op de prestaties of beschikbaarheid van databasebewerkingen. Zie Redundantie, replicatie en back-up voor meer informatie over hoe replicatie en back-up verschillende risico's aanpakken.
Azure DocumentDB slaat back-ups afzonderlijk op van de brongegevens. In regio's die beschikbaarheidszones ondersteunen, slaat de service back-upmomentopnamen op in drie beschikbaarheidszones. Azure DocumentDB deze back-ups beheert en u kunt ze niet exporteren. De service bewaart back-ups gedurende 35 dagen voor actieve clusters, 7 dagen voor actieve burstable-tier-clusters (M10, M20, M25) en 7 dagen voor verwijderde clusters.
U kunt een back-up herstellen naar een nieuw cluster. Nadat u dit hebt gedaan, moet u een set taken na herstel uitvoeren.
Zie Een cluster herstellen in Azure DocumentDB voor meer informatie.
Tolerantie voor serviceonderhoud
Microsoft past regelmatig service-updates toe en voert ander onderhoud uit. Het Azure platform verwerkt deze activiteiten automatisch en zorgt ervoor dat onderhoud naadloos en transparant voor u is. Er wordt geen downtime verwacht tijdens onderhoudsgebeurtenissen, tenzij u op de hoogte bent gesteld via Azure Service Health gepland onderhoud.
Geplande onderhoudsgebeurtenissen kunnen nog steeds kortdurende, voorbijgaande storingen veroorzaken bij clientbewerkingen. Uw toepassing moet deze gebeurtenissen afhandelen met behulp van de richtlijnen voor opnieuw proberen in Tolerantie voor tijdelijke fouten.
Diensteniveau-overeenkomst
De SLA (Service Level Agreement) voor Azure-services beschrijft de verwachte beschikbaarheid van elke service en de voorwaarden waaraan uw oplossing moet voldoen om die beschikbaarheidsverwachting te bereiken. Zie SLA's voor onlineservices voor meer informatie.
Voor Azure DocumentDB zijn beschikbaarheids-SLA's alleen van toepassing wanneer hoge beschikbaarheid (HA) is ingeschakeld voor uw cluster. Verschillende beschikbaarheids-SLA's zijn van toepassing op de volgende configuraties:
Voor hoge beschikbaarheid geconfigureerde clusters die zich over meerdere Azure-regio's uitstrekken met behulp van regioreplicatie.
Voor hoge beschikbaarheid ingeschakelde clusters in één regio.