Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Van toepassing op:✅ Warehouse in Microsoft Fabric
Dit artikel beschrijft methoden voor het migreren van datawarehouses van SQL Server naar Microsoft Fabric Data Warehouse.
Tip
Voor meer informatie over strategie en planning, zie Migratieplanning: SQL Server to Fabric Data Warehouse.
Gebruik de Fabric Migration Assistant voor Data Warehouse voor een geautomatiseerde migratie-ervaring vanuit SQL Server. De rest van dit artikel beschrijft meer handmatige migratiestappen.
De volgende tabel vat methoden samen voor het migreren van het dataschema (DDL), databasecode (DML) en data. Elke optie wordt later in dit artikel beschreven.
| Option | Method | Wat het doet | Vaardigheid of voorkeur | Scenario |
|---|---|---|---|---|
| 1 | Data Factory | Schemaconversie Gegevensextractie Gegevensopname |
Data Factory-pijplijn | Vereenvoudigde schema- en datamigratie. Aanbevolen voor dimensietabellen. |
| 2 | Data Factory met partities | Schemaconversie Gegevensextractie Gegevensopname |
Data Factory-pijplijn | Parallelle migratie voor grote feitentabellen. |
| 3 | Schema-eerst migratie | Schemaconversie | Data Factory-pijplijn | Migreer eerst het schema en extraheer en laad daarna de gegevens afzonderlijk in om meer controle over de doorvoer te krijgen. |
| 4 | SQL-migratiescripts | Schemaconversie Gegevensextractie Codebeoordeling |
T-SQL | Gebruik een IDE en scripts voor gedetailleerde controle over migratietaken. |
| 5 | SQL-databaseprojecten | Schemaconversie Codebeoordeling |
SQL-project | Gebruik een databaseproject voor bronbeheer, beoordeling en deployment. |
| 6 | dbt | Schemaconversie Conversie van databasecode |
dbt | Hergebruik een bestaand dbt-project door de adapter en doelconfiguratie te wijzigen. |
Een workload kiezen voor de eerste migratie
Wanneer je beslist waar je een SQL Server naar Fabric Data Warehouse migratieproject start, kies dan een werklastgebied waar je:
- Bewijs de haalbaarheid van migreren naar Fabric Data Warehouse door snel de voordelen van de nieuwe omgeving te realiseren. Begin klein en eenvoudig, en bereid je voor op meerdere kleine migraties.
- Geef je technische medewerkers tijd om relevante ervaring op te doen met de processen en tools die zij gebruiken om andere werklasten te migreren.
- Maak een sjabloon voor verdere migraties die specifiek is voor je SQL Server-omgeving, tools en processen.
Tip
Maak een inventaris van objecten die gemigrerd moeten worden en documenteer het migratieproces van begin tot eind zodat het herhaald kan worden voor andere databases of workloads.
Het datavolume bij een initiële migratie moet groot genoeg zijn om de mogelijkheden en voordelen van Fabric Data Warehouse aan te tonen, maar klein genoeg om snel waarde te tonen. Een grootte in het bereik van 1-10 terabyte is typisch.
Migreren met Fabric Data Factory
Fabric Data Factory biedt een low-code interface waarmee tabel-DDL kan worden omgezet en data kan migreren vanuit SQL Server.
Fabric Data Factory kan de volgende taken uitvoeren:
- Zet schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak schema-objecten aan in Fabric Data Warehouse.
- Migrer data naar Fabric Data Warehouse.
Optie 1. Schema- en datamigratie met kopieerassistent
Deze methode gebruikt de Data Factory Copy-assistent om verbinding te maken met de bron-SQL Server database, tabel-DDL om te zetten naar Fabric syntaxis en data naar Fabric Data Warehouse te kopiëren. Je kunt één of meer brontabellen selecteren. De gegenereerde pijplijn gebruikt een ForEach-activiteit om de geselecteerde tabellen parallel te kopiëren.
Wanneer je de kopieeroperatie configureert:
- Gebruik de SQL Server-connector voor de bronverbinding.
- Beperk parallelle kopieën tot een niveau dat de brondatabase en het netwerk kunnen ondersteunen.
- Monitor de bron-CPU, I/O, het gebruik van transactielogboeken en de latentie van de productiewerklast tijdens extractie.
Aanbevolen gebruik
Gebruik Copy Assistant voor een eenvoudige interface die DDL converteert en geselecteerde tabellen in één bewerking invoert. Deze methode past goed bij dimensietabellen en kleinere workloads.
Voor grote tabellen gebruik je partitionering om de lees- en schrijfparalleliteit te vergroten.
Optie 2. Datamigratie met partitionering
Voor grote feitentabellen gebruik je voor elke tabel een Copy-activiteit en configureer je de bronpartitionering. Gebruik fysieke partities wanneer beschikbaar, of configureer de opdeling van dynamisch bereik door een geschikte numerieke of datumkolom en de minimale en maximumwaarden daarvan te specificeren.
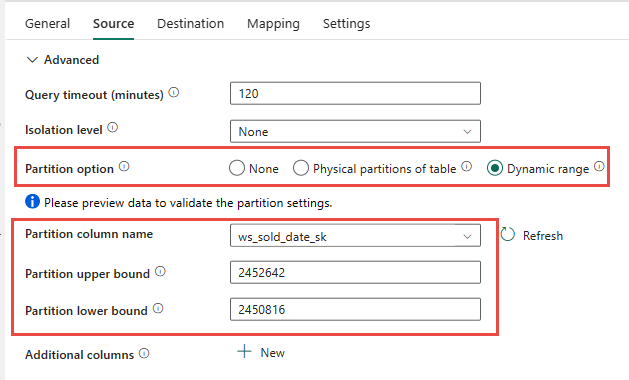
Wanneer je partitionering gebruikt:
- Kies een partitiekolom die de rijen gelijkmatig verdeelt.
- Vermijd het creëren van meer gelijktijdige bronqueries dan SQL Server kan verwerken zonder de productieworkloads te beïnvloeden.
- Test het partitiebereik en de instellingen voor parallelle kopiëren met een representatieve werklast.
- Verhoog de paralleliteit geleidelijk terwijl je de bron en bestemming monitort.
Aanbevolen gebruik
Gebruik Data Factory-partitionering voor grote feitentabellen wanneer parallelle extractie de doorvoer verbetert. Bepaal het batchaantal en de partitiebereiken op basis van je brondatabase, bronnen en netwerkcapaciteit.
Optie 3. Schema-eerst migratie
Voor grotere databases, scheid schemamigratie van datamigratie:
- Converteer en maak tabelschema's in Fabric Data Warehouse.
- Haal brongegevens uit in Azure Data Lake Storage (ADLS) Gen2.
- Gebruik Data Factory of het COPY INTO-commando om de gestagede data in Fabric Data Warehouse te importeren.
Door deze fasen te scheiden, kun je extractie en inname onafhankelijk afstemmen.
Schemamigratie met Data Factory
Je kunt een Fabric pipeline gebruiken om tabelschema's van SQL Server naar Fabric Data Warehouse te migreren zonder rijen te kopiëren.
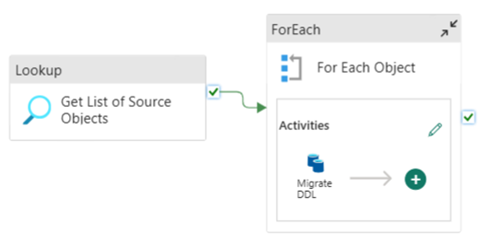
Configureer pijplijnparameters
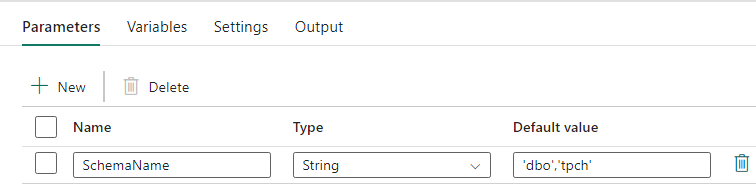
Maak een SchemaName parameter aan die aangeeft welke schema's gemigrerd moeten worden. Gebruik dbo als standaard, of voer een komma-gescheiden lijst in zoals 'dbo','sales'.
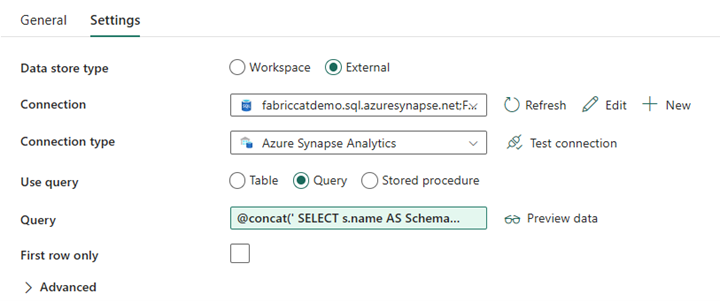
Configureer de opzoekactiviteit
Maak een zoekactiviteit aan en stel de verbinding in met de brondatabase van SQL Server. Op het tabblad Instellingen :
- Stel het gegevensarchieftype in op Extern.
- Selecteer de bronverbinding met SQL Server.
- Zet Use query op Query.
- Voeg een dynamische query toe die het bronschema en de tabelnamen teruggeeft.
Gebruik de volgende expressie om de query te maken:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Configureer de ForEach-activiteit
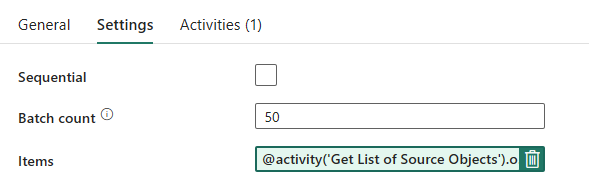
In het tabblad Instellingen voor de ForEach-activiteit:
- Schakel Sequential uit om iteraties gelijktijdig te laten draaien.
- Stel het batchaantal in op een waarde die de brondatabase kan aanhouden. Begin met een conservatieve waarde en test die.
- Stel items in op
@activity('Get List of Source Objects').output.value.
De kopieeractiviteit configureren
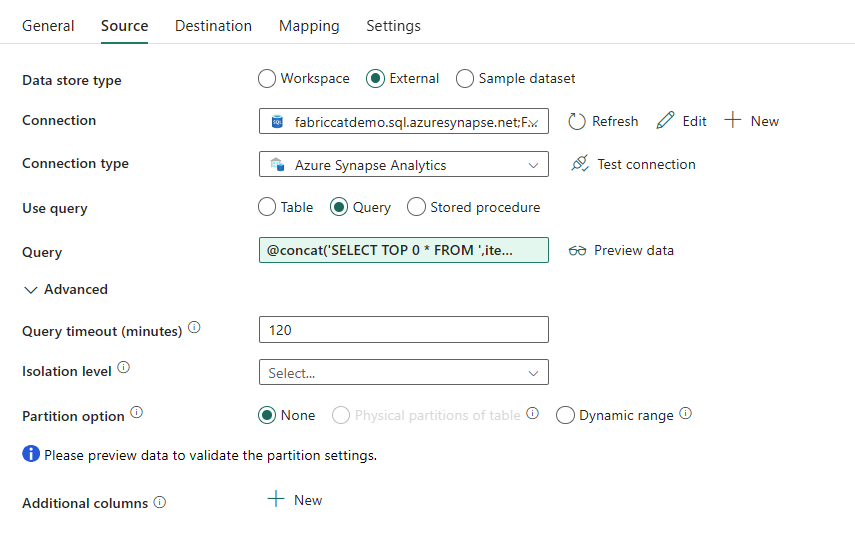
Voeg binnen de ForEach-activiteit een Copy-activiteit toe. Op het tabblad Bron :
- Stel het gegevensarchieftype in op Extern.
- Selecteer de bronverbinding met SQL Server.
- Zet Use query op Query.
- Stel Query zo
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)in dat alleen tabelmetadata wordt gemigreerd.
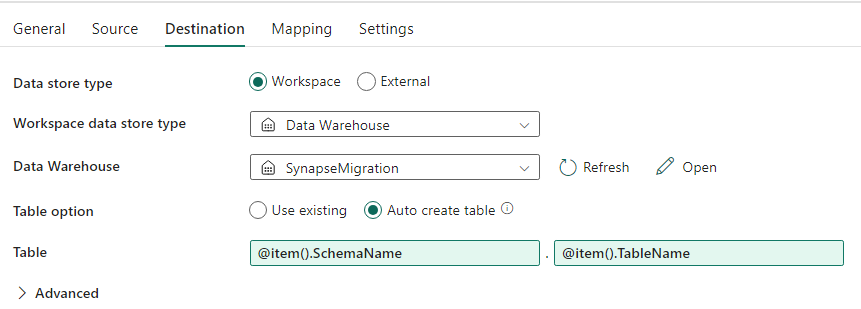
Op het tabblad Bestemming :
- Stel het type van datastore in op Werkruimte.
- Stel het type Workspace data store in op Data Warehouse en selecteer het bestemmingswarehouse.
- Stel het bestemmingsschema in op
@item().SchemaName. - Stel de bestemmingstabel in op
@item().TableName.
Controleer nadat je de pipeline hebt uitgevoerd of Fabric Data Warehouse elke geselecteerde tabel bevat met het verwachte schema.
Migreren met SQL-scripts
Gebruik T-SQL- en PowerShell-migratiescripts wanneer je gedetailleerde controle wilt over schemaconversie, data-extractie en code-beoordeling.
Migratiescripts kunnen:
- Zet schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak schema-objecten aan in Fabric Data Warehouse.
- Haal data uit SQL Server naar ADLS Gen2.
- Marker niet-ondersteunde T-SQL-syntaxis in opgeslagen procedures, functies en views.
Het Microsoft Fabric CAT-team levert migratiecodevoorbeelden in de fabric-migratierepository.
Aanbevolen gebruik
Gebruik scripts wanneer je bekend bent met T-SQL, de voorkeur geeft aan een geïntegreerde ontwikkelomgeving en individuele migratietaken moet beheren. Gebruik COPY INTO of Data Factory om geëxtraheerde data in Fabric Data Warehouse te importeren.
Migreren met behulp van SQL-databaseprojecten
Fabric Data Warehouse wordt ondersteund in de SQL Database Projects-extensie voor Visual Studio Code.
Een SQL-databaseproject biedt bronbeheer, databasetesten, schemavalidatie en implementatiemogelijkheden. Hiermee is het volgende mogelijk:
- Zet schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak schema-objecten aan in Fabric Data Warehouse.
- Beoordeel niet-ondersteunde T-SQL-syntaxis in opgeslagen procedures, functies en views.
Voor datamigratie gebruik Data Factory om direct van SQL Server te kopiëren, of haal data uit naar ADLS Gen2 en verwerk deze via COPY INTO Data Factory.
Voor een walkthrough over het gebruik van SQL-databaseprojecten met migratiescripts, zie de fabric-migration repository.
Voor meer informatie, zie Begin met de SQL Database Projects-extensie en Bouw een databaseproject vanuit de opdrachtregel.
Migratie met dbt
Als je SQL Server data warehouse dbt gebruikt, kun je de dbt-adapter voor Fabric Data Warehouse gebruiken om schema- en databasecode te converteren door het doelprofiel en de adapter te wijzigen.
Het dbt-framework genereert DDL- en DML-scripts uit modelbestanden. Je moet de gegevens apart migreren door gebruik te maken van Data Factory of een andere datamigratieoptie in dit artikel.
Om te beginnen, zie Tutorial: Stel DBT in voor Fabric Data Warehouse.
Gegevensinname in Fabric Data Warehouse
Voor gestaged data gebruik COPY INTO of Fabric Data Factory om bestanden van ADLS Gen2 in Fabric Data Warehouse te importeren. Overweeg de volgende richtlijnen:
- Haal grote tabellen parallel uit wanneer de brondatabase en het netwerk voldoende capaciteit hebben.
- Geef de voorkeur aan Parquet-bestanden om opslag- en netwerkgebruik te verminderen en de inname-efficiëntie te verbeteren.
- Laad meerdere bestemmingstabellen gelijktijdig wanneer je Fabric-capaciteit de werklast kan dragen.
- Monitor zowel de bronextractie als de capaciteit van Fabric om de optimale mate van parallelisme te vinden.