Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Van toepassing op:✅ SQL Analytics-eindpunt en -magazijn in Microsoft Fabric
Belangrijk
Deze functie is beschikbaar als preview-versie.
Gegevensclustering in Fabric Data Warehouse organiseert gegevens voor snellere queryprestaties en verminderd rekengebruik. In deze zelfstudie worden de stappen beschreven voor het maken van tabellen met gegevensclustering, van het maken van geclusterde tabellen tot het controleren van hun effectiviteit.
Vereiste voorwaarden
- Een Microsoft Fabric-tenantaccount met een actief abonnement.
- Zorg ervoor dat u een werkruimte met Microsoft Fabric hebt: Maak een werkruimte.
- Zorg ervoor dat u al een magazijn hebt gemaakt. Als u een nieuw magazijn wilt maken, raadpleegt u Een magazijn maken in Microsoft Fabric.
- Basiskennis van T-SQL en het uitvoeren van query's op gegevens.
Voorbeeldgegevens importeren
In deze zelfstudie wordt gebruikgemaakt van de NY Taxi voorbeelddataset. De NY Taxi-gegevens importeren in uw datawarehouse. Gebruik de zelfstudie Voorbeeldgegevens naar Datawarehouse laden.
Maak een tabel met dataclustering
Voor deze zelfstudie hebben we twee kopieën van de NYTaxi-tabel nodig: de reguliere kopie van de tabel zoals geïmporteerd uit de zelfstudie en een kopie die gebruikmaakt van gegevensclustering. Gebruik de volgende opdracht om een nieuwe tabel te maken met behulp van (CTAS), op basis van CREATE TABLE AS SELECT de oorspronkelijke NYTaxi-tabel:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Opmerking
In het voorbeeld wordt ervan uitgegaan dat de tabelnaam die wordt gegeven aan de NY Taxi-dataset in de zelfstudie "Voorbeeldgegevens laden naar Gegevensmagazijn." Als u een andere naam voor uw tabel hebt gebruikt, past u de opdracht aan om nyctlc te vervangen door uw tabelnaam.
Met deze opdracht maakt u een exacte kopie van de oorspronkelijke NYTaxi-tabel, maar met gegevensclustering in de lpepPickupDatetime kolom. Vervolgens gebruiken we deze kolom voor het uitvoeren van query's.
Gegevens opvragen
Voer een query uit op de NYTaxi-tabel en herhaal dezelfde query op de NYTaxi_With_DataClustering tabel ter vergelijking.
Opmerking
Voor deze analyse is het handig om te kijken naar de koude cacheprestaties van beide uitvoeringen, dat wil gezegd, zonder gebruik te maken van de cachefuncties van Fabric Data Warehouse. Voer daarom elke query precies één keer uit voordat u de resultaten in Query Insights bekijkt.
We gebruiken een vaakgebruikte query in het Data Warehouse. Met deze query wordt het gemiddelde tarief berekend per jaar tussen de datums 2008-12-31 en 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Opmerking
De labeloptie die in deze query wordt gebruikt, is handig wanneer we de querydetails van de Regular tabel vergelijken met de tabel die later gegevensclustering gebruikt met behulp van Query Insights-weergaven.
Vervolgens herhalen we dezelfde query, maar in de versie van de tabel die gebruikmaakt van gegevensclustering:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
De tweede query maakt gebruik van het label Clustered waarmee we deze query later kunnen identificeren met Query Insights.
De effectiviteit van gegevensclustering controleren
Nadat u clustering hebt ingesteld, kunt u de effectiviteit ervan beoordelen met behulp van Query Insights. Query-inzichten in Fabric Data Warehouse legt historische queryuitvoeringsgegevens vast en aggregeren deze in bruikbare inzichten, zoals het identificeren van langlopende of vaak uitgevoerde query's.
In dit geval gebruiken we Query Insights om het verschil in gegevens te vergelijken die zijn gescand tussen de reguliere en de geclusterde gevallen.
Gebruik de volgende query:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Met deze query worden details opgehaald uit de exec_requests_history weergave. Zie queryinsights.exec_requests_history (Transact-SQL) voor meer informatie.
De query filtert de resultaten op de volgende manieren:
- Haalt alleen rijen op die de
NYTaxitekst in de opdrachtnaam bevatten (zoals is gebruikt in de testquery's) - Haalt alleen rijen op waarbij de labelwaarde normaal of geclusterd is
Opmerking
Het kan enkele minuten duren voordat uw querygegevens beschikbaar zijn in Query Insights. Als uw Query Insights-query geen resultaten retourneert, probeert u het na enkele minuten opnieuw.
Als u deze query uitvoert, zien we de volgende resultaten:

Beide query's hebben een aantal rijen van 6 en vergelijkbare verzendtijden. De Clustered query toont total_elapsed_time_ms 1794, allocated_cpu_time_ms van 1676 en data_scanned_remote_storage_mb van 77,519. De Regular query toont total_elapsed_time_ms 2651, allocated_cpu_time_ms van 2600 en data_scanned_remote_storage_mb van 177.700. Deze getallen laten zien dat hoewel beide query's dezelfde resultaten hebben geretourneerd, de Clustered versie ongeveer 36% minder CPU-tijd heeft gebruikt dan de Regular versie en ongeveer 56% minder gegevens op schijf heeft gescand. Er is geen cache gebruikt in een van beide queryuitvoeringen. Dit zijn belangrijke resultaten om de uitvoeringstijd en het verbruik van query's te verminderen en de lpepPickupDatetime kolom een sterke kandidaat te maken voor gegevensclustering.
Opmerking
Dit is een kleine tabel, met ongeveer 76 miljoen rijen en 2 GB aan gegevensvolume. Hoewel deze query slechts zes rijen op de aggregatie retourneert (één voor elk jaar in het bereik), scant deze ongeveer 8,3 miljoen rijen in het datumbereik dat is opgegeven voordat de resultaten worden samengevoegd. Werkelijke productiegegevens met grotere gegevensvolumes kunnen aanzienlijke resultaten opleveren. Uw resultaten kunnen variëren op basis van de capaciteitsgrootte, resultaten in de cache of gelijktijdigheid tijdens de query's.
Kies clusteringkolommen op basis van je workload
Voor productietabellen gebruik je waargenomen querypatronen in plaats van te raden welke kolommen geclusterd moeten worden. De operationele capaciteit van de sqldw-cli vaardigheid analyseert de geschiedenis van Query Insights, rangschikt terugkerende querypatronen op basis van remote gescande data en identificeert kolommen die in WHERE predicaten worden gebruikt.
Voordat je begint, installeer Skills for Fabric, zorg je ervoor dat het warehouse recente queryactiviteit heeft en controleer je of je de workspace-rol Contributor of hoger hebt. Open vervolgens de GitHub Copilot CLI en gebruik een prompt zoals deze:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
De vaardigheid identificeert de querypatronen met de grootste scanimpact, haalt de tabellen en filterkolommen uit die queries en rangschikt de clusterende kandidaten. Bekijk de aanbevelingen met deze richtlijnen:
- Geef de voorkeur aan kolommen die herhaaldelijk grote tabellen filteren en gebruikmaken van midden- tot hoge kardinaliteitswaarden, zoals data of identificaties.
- Geef de voorkeur aan kolommen die worden gebruikt in selectieve bereikspredicaten of gelijkheidspredicaten in de
WHERE-component. - Selecteer kolommen niet alleen omdat ze in gelijkheidsjoin-condities voorkomen. Deze omstandigheden profiteren niet van dataclustering.
- Gebruik niet meer dan vier clusterkolommen en voeg niet meer kolommen toe dan de werklast vereist.
Stel bijvoorbeeld een e-commerce warehouse voor, waar Sales.SalesOrder 1,5 miljard rijen en Sales.OrderLine 6 miljard rijen zijn. Na het analyseren van terugkerende vragen kan de vaardigheid deze aanbevelingen teruggeven:
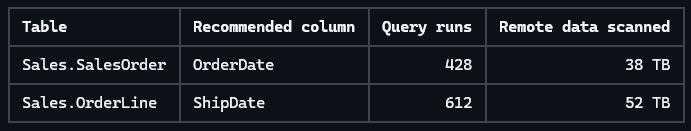
De datumkolommen zijn sterke kandidaten omdat ze de grootste tabellen filteren, common range-predicaten ondersteunen en meer mogelijkheden bieden om bestanden over te slaan dan kolommen met lage cardinaliteit zoals OrderStatus of SalesRegion.
De bewerkingsmogelijkheden van sqldw-cli zijn alleen-lezen. Het raadt kolommen aan, maar maakt geen tabellen aan of vervangt ze. Nadat je de aanbeveling hebt bekeken, gebruik je CTAS om een geclusterde kopie van de tabel te maken:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Vergelijk de geclusterde en niet-geclusterde workloads om het effect te verifiëren. Nadat je de geclusterde tabel hebt gevalideerd, hernoem je de originele tabel en hernoem je vervolgens de geclusterde tabel naar de oorspronkelijke naam:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
De oorspronkelijke tabel blijft beschikbaar als Sales.SalesOrder_old voor een rollback. Controleer de afhankelijke werklasten en de nieuwe tabel voordat je de originele tabel verwijdert. Wanneer je de rollback-kopie niet meer nodig hebt, laat die dan vallen:
DROP TABLE Sales.SalesOrder_old;