Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
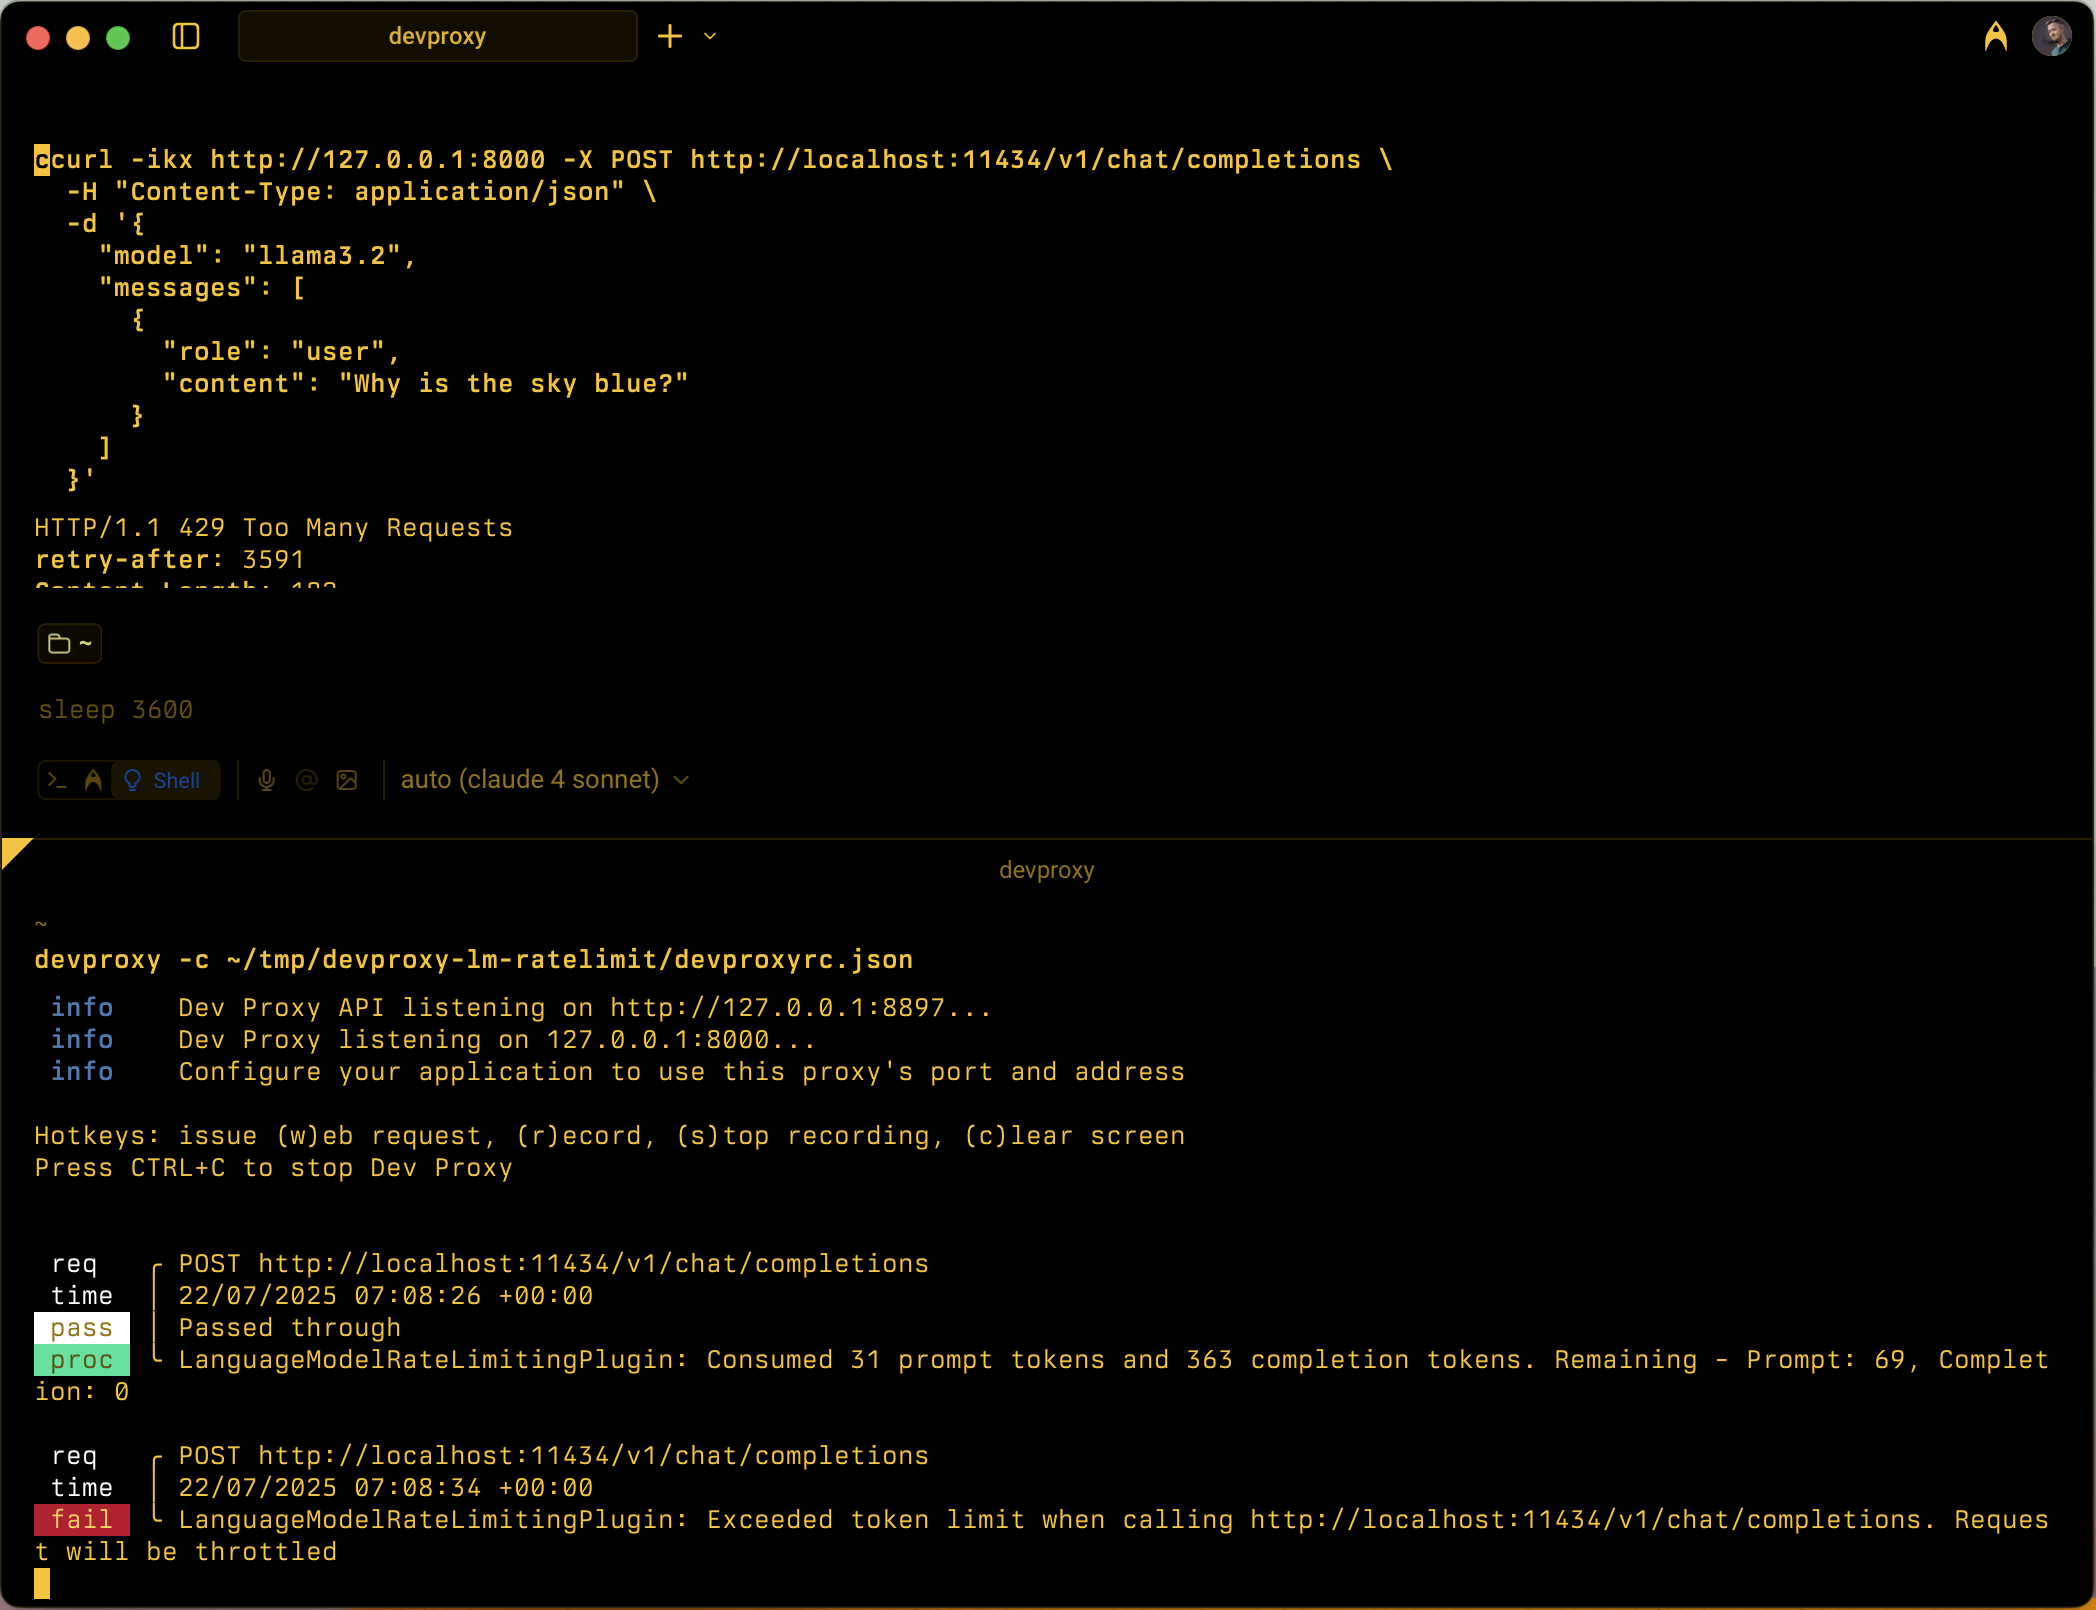
Simuleert snelheidsbeperking op basis van tokens voor taalmodel-API's door het bijhouden van prompt- en voltooiingstokenverbruik binnen configureerbare tijdvensters.
Configuratievoorbeeld
{
  "$schema": "https://raw.githubusercontent.com/dotnet/dev-proxy/main/schemas/v4.0.0/rc.schema.json",
  "plugins": [
    {
      "name": "LanguageModelRateLimitingPlugin",
      "enabled": true,
      "pluginPath": "~appFolder/plugins/DevProxy.Plugins.dll",
      "configSection": "languageModelRateLimitingPlugin"
    }
  ],
  "urlsToWatch": [
    "https://api.openai.com/*",
    "http://localhost:11434/*"
  ],
  "languageModelRateLimitingPlugin": {
    "$schema": "https://raw.githubusercontent.com/dotnet/dev-proxy/main/schemas/v4.0.0/languagemodelratelimitingplugin.schema.json",
    "promptTokenLimit": 5000,
    "completionTokenLimit": 5000,
    "resetTimeWindowSeconds": 60,
    "whenLimitExceeded": "Throttle",
    "headerRetryAfter": "retry-after"
  }
}
Configuratie-eigenschappen
| Property | Description | Default |
|---|---|---|
promptTokenLimit |
Maximum aantal prompttokens dat is toegestaan binnen het tijdvenster. | 5000 |
completionTokenLimit |
Maximum aantal voltooiingstokens dat is toegestaan binnen het tijdvenster. | 5000 |
resetTimeWindowSeconds |
Tijdvenster in seconden waarna tokenlimieten opnieuw worden ingesteld. | 60 |
whenLimitExceeded |
Reactiegedrag wanneer tokenlimieten worden overschreden. Deze waarde kan Throttle of Custom zijn. |
Throttle |
headerRetryAfter |
De naam van de HTTP-header voor het opnieuw proberen van gegevens. | retry-after |
customResponseFile |
Pad naar bestand met aangepaste respons wanneer whenLimitExceeded deze is ingesteld op Custom. |
token-limit-response.json |
Aangepaste antwoordconfiguratie
Wanneer whenLimitExceeded dit is ingesteld Custom, kunt u een aangepast antwoord definiëren in een afzonderlijk JSON-bestand:
{
  "$schema": "https://raw.githubusercontent.com/dotnet/dev-proxy/main/schemas/v4.0.0/languagemodelratelimitingplugin.customresponsefile.schema.json",
  "statusCode": 429,
  "headers": [
    {
      "name": "retry-after",
      "value": "@dynamic"
    },
    {
      "name": "content-type",
      "value": "application/json"
    }
  ],
  "body": {
    "error": {
      "message": "You have exceeded your token quota. Please wait before making additional requests.",
      "type": "insufficient_quota",
      "code": "token_quota_exceeded"
    }
  }
}
Aangepaste antwoordeigenschappen
| Property | Description |
|---|---|
statusCode |
HTTP-statuscode die moet worden geretourneerd wanneer de tokenlimiet wordt overschreden. |
headers |
Matrix van HTTP-headers die moeten worden opgenomen in het antwoord. Gebruik @dynamic deze functie voor opnieuw proberen na het automatisch berekenen van seconden totdat deze opnieuw is ingesteld. |
body |
Antwoordtekstobject dat is geserialiseerd naar JSON. |
Hoe het werkt
LanguageModelRateLimitingPlugin werkt door:
- OpenAI API-aanvragen onderscheppen: POST-aanvragen controleren op geconfigureerde URL's die openAI-compatibele aanvraagbody's bevatten
-
Tokenverbruik bijhouden: parseert antwoorden om te extraheren
prompt_tokensencompletion_tokensuit de gebruikssectie - Limieten afdwingen: onderhoudt het uitvoeren van totalen van verbruikte tokens binnen het geconfigureerde tijdvenster
- Beperkingsreacties verleent: Wanneer limieten worden overschreden, retourneert u standaardbeperkingsreacties of aangepaste antwoorden
Ondersteunde aanvraagtypen
De invoegtoepassing ondersteunt zowel OpenAI-voltooiings- als chat-voltooiingsaanvragen:
-
Voltooiingsaanvragen: Aanvragen met een
prompteigenschap -
Aanvragen voor chatvoltooiing: aanvragen met een
messageseigenschap
Tokentracking
Tokenverbruik wordt afzonderlijk bijgehouden voor:
- Prompttokens: invoertokens die door de aanvraag worden gebruikt
- Voltooiingstokens: Uitvoertokens gegenereerd door het antwoord
Wanneer een van beide limieten wordt overschreden, worden de volgende aanvragen beperkt totdat het tijdvenster opnieuw wordt ingesteld.
Gedrag van tijdvensters
- Tokenlimieten opnieuw instellen na de geconfigureerde
resetTimeWindowSeconds - De timer voor opnieuw instellen wordt gestart wanneer de eerste aanvraag wordt verwerkt
- Wanneer een tijdvenster verloopt, worden prompt- en voltooiingstokentellers opnieuw ingesteld op de geconfigureerde limieten
Standaardbeperkingsreactie
Wanneer whenLimitExceeded dit is ingesteld Throttle, retourneert de invoegtoepassing de snelheidslimietfout van OpenAI per minuut (TPM), zodat clients weer worden uitgeschakeld en het opnieuw proberen:
{
  "error": {
    "message": "Rate limit reached for gpt-4o on tokens per min (TPM): Limit 5000, Used 5120. Please try again in 42s.",
    "type": "tokens",
    "param": null,
    "code": "rate_limit_exceeded"
  }
}
Het bericht bevat het model van de aanvraag (wanneer de aanvraag een aanvraag opgeeft), de limiet voor vragen of voltooiingstokens die worden gebruikt, het aantal tokens dat wordt gebruikt in het huidige tijdvenster en de seconden totdat de tokenlimieten opnieuw zijn ingesteld. Het bericht zegt tokens per min (TPM)altijd, ongeacht de resetTimeWindowSeconds waarde.
Het antwoord bevat:
- HTTP-statuscode:
429 Too Many Requests -
retry-afterheader met seconden totdat tokenlimieten opnieuw worden ingesteld - CORS-headers wanneer de oorspronkelijke aanvraag een
Originheader bevat
Als u een facturerings- of quotumfout wilt simuleren, zoals OpenAI's insufficient_quota, waarmee clients kunnen stoppen met opnieuw proberen, stelt whenLimitExceededCustom u deze in en definieert u de fout in een aangepast antwoordbestand.
Gebruikssituaties
LanguageModelRateLimitingPlugin is handig voor:
- Snelheidsbeperking op basis van tokens testen: Simuleren hoe uw toepassing zich gedraagt wanneer taalmodelproviders tokenquota afdwingen
- Simulatie van ontwikkelingskosten: Inzicht in gebruikspatronen voor tokens tijdens de ontwikkeling voordat u echte API-limieten bereikt
- Tolerantietests: Controleer of uw toepassing tokenlimietfouten correct verwerkt en de juiste logica voor opnieuw proberen implementeert
- Lokale LLM-tests: Token beperken van scenario's met lokale taalmodellen (zoals Ollama) die hun eigen limieten niet afdwingen
Voorbeeldscenario's
Scenario 1: Beperking van basistoken
{
  "languageModelRateLimitingPlugin": {
    "promptTokenLimit": 1000,
    "completionTokenLimit": 500,
    "resetTimeWindowSeconds": 300
  }
}
Met deze configuratie kunnen maximaal 1000 prompttokens en 500 voltooiingstokens binnen een venster van 5 minuten worden voltooid.
Scenario 2: Aangepaste foutreacties
{
  "languageModelRateLimitingPlugin": {
    "promptTokenLimit": 2000,
    "completionTokenLimit": 1000,
    "resetTimeWindowSeconds": 60,
    "whenLimitExceeded": "Custom",
    "customResponseFile": "custom-token-error.json"
  }
}
Deze configuratie maakt gebruik van een aangepast antwoordbestand om gespecialiseerde foutberichten te bieden wanneer tokenlimieten worden overschreden.
Volgende stap
Met ons samenwerken op GitHub
De bron voor deze inhoud vindt u op GitHub, waar u ook problemen en pull-aanvragen kunt maken en controleren. Bekijk onze gids voor inzenders voor meer informatie.
