Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Van toepassing op: SQL ServerAzure SQL DatabaseAzure SQL Managed InstanceSQL-database in Microsoft Fabric
De SQL Server Database Engine verwerkt query's op verschillende gegevensopslagarchitecturen, zoals lokale tabellen, gepartitioneerde tabellen en tabellen die zijn verdeeld over meerdere servers. De volgende secties behandelen hoe de Database Engine queries verwerkt en het hergebruik van querys optimaliseert via execution plan caching.
De codevoorbeelden in dit artikel gebruiken de AdventureWorks2025, AdventureWorksDW2025, of AdventureWorksLT2025 voorbeelddatabase, die je kunt downloaden van de Azure Data SQL Samples Repository GitHub-repository.
Uitvoeringsmodi
De SQL Server Database Engine kan Transact-SQL (T-SQL)-statements verwerken met behulp van twee verschillende verwerkingsmodi:
- Uitvoering in rijmodus
- Uitvoering van batchmodus
Uitvoering in rijmodus
Row mode execution is een queryverwerkingsmethode die wordt gebruikt met rowstore-tabellen en indexen, waarbij gegevens in rijformaat worden opgeslagen. Wanneer een query wordt uitgevoerd en gegevens in rowstore-tabellen en indexen benadert, lezen de uitvoeringsboom-operatoren en kindoperatoren elke vereiste rij over alle kolommen die in het objectschema zijn gespecificeerd. Van elke gelezen rij haalt de Database Engine vervolgens de kolommen op die nodig zijn voor de resultaatset, waarnaar wordt verwezen door een SELECT statement, JOIN predicaat of filterpredicaat.
Notitie
Rijmodusuitvoering is zeer efficiënt voor OLTP-scenario's, maar kan minder efficiënt zijn bij het scannen van grote hoeveelheden data, bijvoorbeeld in Data Warehousing-scenario's.
Uitvoering van batchmodus
Uitvoering in batchmodus is een queryverwerkingsmethode die meerdere rijen tegelijk verwerkt (vandaar de term batch). Elke kolom in een batch wordt opgeslagen als een vector in een afzonderlijk geheugengebied, dus batchmodusverwerking is gebaseerd op vectoren. Batch-modus verwerking gebruikt ook algoritmen die geoptimaliseerd zijn voor geavanceerde instructiesetextensies en verhoogde geheugendoorvoer in moderne processoren.
Uitvoering in batchmodus was oorspronkelijk geïntegreerd en geoptimaliseerd rond het columnstore-opslagformaat. Vanaf SQL Server 2019 (15.x) en in Azure SQL Database vereist batchmodus uitvoering geen columnstore-indexen. Zie Batch-modus in rowstorevoor meer informatie.
Batch-modus verwerking werkt waar mogelijk op gecomprimeerde data en elimineert de uitwisselingsoperator die door uitvoering in rijmodus wordt gebruikt. Het resultaat is beter parallellisme en snellere prestaties.
Wanneer een query in batchmodus draait en data in kolomopslagindexen raadpleegt, lezen de uitvoeringsboomoperatoren en kindoperatoren meerdere rijen samen in kolomsegmenten. De Database Engine leest alleen de kolommen die nodig zijn voor het resultaat, waarnaar wordt verwezen door een SELECT statement, JOIN predicaat of filterpredicaat. Voor meer informatie over columnstore-indexen, zie Columnstore Index Architecture.
Notitie
Batch-uitvoering is zeer efficiënt voor datawarehousing-scenario's waar het grote hoeveelheden data kan lezen en aggregeren.
Verwerking van SQL-instructies
Het verwerken van één enkele T-SQL-instructie is de meest basale manier waarop de Database Engine T-SQL-instructies uitvoert. De volgende stappen illustreren het basisproces door één enkele SELECT instructie te verwerken die alleen naar lokale basistabellen verwijst (geen views of externe tabellen).
Volgorde van logische operatoren
Wanneer je meer dan één logische operator in een stelling gebruikt, wordt NOT eerst geëvalueerd, dan AND, en tenslotte OR. Rekenkundige en bitgewijze operatoren worden behandeld vóór logische operatoren. Raadpleeg operator precedence voor meer informatie.
In het volgende voorbeeld geldt de kleurvoorwaarde voor productmodel 21, en niet voor productmodel 20, omdat AND voorrang heeft op OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Het gebruik van haken, zelfs als ze niet vereist zijn, kan de leesbaarheid van queries verbeteren en de kans op fouten door operatorprioriteit verkleinen. Het volgende voorbeeld is beter leesbaar dan het vorige voorbeeld en heeft dezelfde betekenis.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
U kunt de betekenis van de query wijzigen door haakjes toe te voegen om de evaluatie van de OR eerst af te dwingen. Met de volgende query worden alleen producten gevonden onder modellen 20 en 21 die rood zijn.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
SELECT-instructies optimaliseren
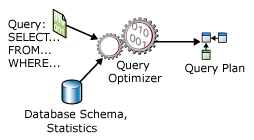
Een SELECT verklaring is niet-procedureel; er worden niet de exacte stappen vermeld die de databaseserver moet gebruiken om de aangevraagde gegevens op te halen. Dit declaratieve gedrag betekent dat de databaseserver de instructie en de database moet analyseren om de meest efficiënte manier te bepalen om de gevraagde data te extraheren. Dit proces wordt queryplanoptimalisatie genoemd. De component die deze taak uitvoert is de Query Optimizer. De invoer van de Query Optimizer bestaat uit de query, het databaseschema (objectdefinities) en de objectstatistieken. De output van de Query Optimizer is een query-uitvoeringsplan, soms aangeduid als queryplan of uitvoeringsplan. De inhoud van een uitvoeringsplan wordt in meer detail beschreven in Execution plan caching and reuse.
Het volgende diagram illustreert de invoer en output van de Query Optimizer tijdens de optimalisatie van één enkele SELECT statement:
Een verklaring definieert SELECT alleen:
- De indeling van de resultatenset. Dit wordt meestal opgegeven in de selectielijst. Andere componenten, zoals
ORDER BYenGROUP BYhebben echter ook invloed op de uiteindelijke vorm van de resultatenset. - De tabellen die de brongegevens bevatten. Dit wordt opgegeven in de
FROM-clausule. - Hoe de tabellen logisch met elkaar samenhangen voor de
SELECT-instructie. Dit wordt gedefinieerd in de join-expressie, die kan voorkomen in deWHEREclausule of in eenONclausule die volgt opFROM. - De voorwaarden waaraan de rijen in de brontabellen moeten voldoen om in aanmerking te komen voor de
SELECT-instructie. Deze worden opgegeven in deWHERE- enHAVING-clausules.
Een query-uitvoeringsplan definieert:
De volgorde waarin de brontabellen worden geopend.
Typisch kan de databaseserver de basistabellen in vele sequenties benaderen om de resultaatset samen te stellen. Als de
SELECT-instructie bijvoorbeeld verwijst naar drie tabellen, kan de databaseserver eerst toegang krijgen totTableA, de gegevens uitTableAgebruiken om overeenkomende rijen uitTableBte extraheren en vervolgens de gegevens uitTableBgebruiken om gegevens uitTableCte extraheren. De andere reeksen waarin de databaseserver toegang heeft tot de tabellen, zijn:TableC,TableB,TableAof
TableB,TableA,TableCof
TableB,TableC,TableAof
TableCTableATableBDe methoden die worden gebruikt om gegevens uit elke tabel te extraheren.
Over het algemeen zijn er verschillende methoden voor toegang tot de gegevens in elke tabel. Als slechts een paar rijen met specifieke sleutelwaarden nodig zijn, kan de databaseserver snel rijen opzoeken of een klein indexbereik scannen. Als alle rijen in de tabel nodig zijn, kan de databaseserver in plaats daarvan de hele tabel of index scannen. Als alle rijen in een tabel vereist zijn, maar er een index is waarvan de sleutelkolommen in een
ORDER BYstaan, kan het uitvoeren van een indexscan in plaats van een tabelscan een aparte sortering van de resultaatset voorkomen. Als een tabel erg klein is, kunnen volledige scans de meest efficiënte methode zijn voor vrijwel alle toegang tot de tabel.De methoden die worden gebruikt voor het berekenen van berekeningen en het filteren, aggregeren en sorteren van gegevens uit elke tabel.
Wanneer data uit tabellen wordt opgehaald, voeren verschillende methoden berekeningen uit over data, zoals het berekenen van scalaire waarden en het aggregeren en sorteren van data zoals gedefinieerd in de querytekst. Bijvoorbeeld bij het gebruik van een
GROUP BYofORDER BY-clausule, en hoe gegevens te filteren, bijvoorbeeld bij het gebruik van eenWHEREofHAVING-clausule.
Het proces van het selecteren van één uitvoeringsplan uit mogelijk veel mogelijke plannen wordt optimalisatie genoemd. Query Optimizer is een van de belangrijkste onderdelen van de database-engine. Hoewel de Query Optimizer wat overhead gebruikt om de query te analyseren en een plan te selecteren, wordt deze overhead meestal meerdere keren bespaard wanneer de Query Optimizer een efficiënt uitvoeringsplan kiest. Twee bouwbedrijven kunnen bijvoorbeeld identieke blauwdrukken voor een huis krijgen. Als het ene bedrijf een paar dagen aan het begin besteedt aan het plannen van hoe ze het huis moeten bouwen, en het andere bedrijf zonder planning begint te bouwen, is het bedrijf dat de tijd neemt om het project te plannen waarschijnlijk als eerste klaar.
De Query Optimizer is een kostengebaseerde optimizer. Elk mogelijk uitvoeringsplan heeft een bijbehorende kosten in termen van de hoeveelheid gebruikte rekenresources. De Query Optimizer moet de mogelijke plannen analyseren en het abonnement kiezen met de laagste geschatte kosten. Sommige complexe statements hebben duizenden mogelijke uitvoeringsplannen. In deze gevallen analyseert de Query Optimizer niet alle mogelijke combinaties. In plaats daarvan worden complexe algoritmen gebruikt om een uitvoeringsplan te vinden dat redelijk dicht bij de minimale kosten ligt.
De Query Optimizer kiest niet per se het uitvoeringsplan met de laagst geraamde kosten. Het vindt een plan met redelijk geschatte kosten binnen de beschikbare tijd voor optimalisatie. Een parallel uitvoeringsplan kan meer middelen gebruiken dan een seriële plan, terwijl het de geraamde verstreken tijd vermindert.
De SQL Server Query Optimizer vertrouwt op statistieken wanneer hij de resourcekosten van verschillende methoden voor het extraheren van informatie uit een tabel of index schat. Statistieken worden bijgehouden voor kolommen en indexen, en bevatten informatie over de dichtheid1 van de onderliggende data. Deze informatie geeft de selectiviteit van de waarden in een bepaalde index of kolom aan. In een tabel die auto's vertegenwoordigt, hebben veel auto's bijvoorbeeld dezelfde fabrikant, maar elke auto heeft een uniek voertuigidentificatienummer (VIN). Een index van de VIN is selectiever dan een index van de fabrikant, omdat VIN een lagere dichtheid heeft dan de fabrikant. Als de indexstatistieken niet actueel zijn, is de queryoptimalisatie mogelijk niet de beste keuze voor de huidige status van de tabel. Zie Statisticsvoor meer informatie over densiteit.
1 Dichtheid definieert de verdeling van unieke waarden in de gegevens of het gemiddelde aantal dubbele waarden voor een bepaalde kolom. Naarmate de dichtheid afneemt, neemt de selectiviteit van een waarde toe.
De Query Optimizer is belangrijk omdat hij de databaseserver in staat stelt zich dynamisch aan te passen aan veranderende omstandigheden in de database zonder input van een ontwikkelaar of databasebeheerder. Deze functie stelt ontwikkelaars in staat zich te richten op het beschrijven van het eindresultaat van de query. Ze kunnen erop vertrouwen dat de Query Optimizer een efficiënt uitvoeringsplan opstelt voor de toestand van de database telkens wanneer het queryplan voor een statement wordt geoptimaliseerd.
Notitie
SQL Server Management Studio heeft drie opties voor het weergeven van uitvoeringsplannen:
- Het Geschatte Uitvoeringsplan, dat is het gecompileerde plan, zoals geproduceerd door de Query Optimizer.
- Het Actual Execution Plan is hetzelfde als het gecompileerde plan plus de uitvoeringscontext. Deze context bevat runtime-informatie die beschikbaar is nadat de uitvoering is voltooid, zoals uitvoeringswaarschuwingen, of in nieuwere versies van de Database Engine, de verstreken tijd en de tijdens de uitvoering gebruikte CPU-tijd.
- De Live Query Statistics, hetzelfde als het gecompileerde plan plus de uitvoeringscontext. Deze context bevat runtime-informatie tijdens de uitvoering en wordt elke seconde bijgewerkt. Runtime-informatie omvat bijvoorbeeld het daadwerkelijke aantal rijen dat door de operatoren stroomt.
Een SELECT-instructie verwerken
De Database Engine verwerkt één enkele SELECT instructie door de volgende stappen te volgen:
- De parser scant de
SELECTinstructie en breekt deze op in logische eenheden, zoals trefwoorden, expressies, operators en id's. - Een queryboom, soms een sequentieboom genoemd, wordt gebouwd die de logische stappen beschrijft die nodig zijn om de brongegevens om te zetten in het formaat dat door de resultaatset vereist is.
- De Query Optimizer analyseert verschillende manieren om toegang te krijgen tot de brontabellen. Het selecteert de reeks stappen die de resultaten het snelst teruggeeft met minder middelen. Het werkt de queryboom bij om deze exacte reeks stappen vast te leggen. De uiteindelijke, geoptimaliseerde versie van de querystructuur wordt het uitvoeringsplan genoemd.
- De relationele engine begint het plan uit te voeren. Terwijl het stappen verwerkt waarvoor data uit de basistabellen nodig is, vraagt het de benodigde rijsets aan bij de opslagengine.
- De relationele engine verwerkt de gegevens die worden geretourneerd door de opslagengine in de indeling die is gedefinieerd voor de resultatenset en retourneert de resultatenset naar de client.
Evaluatie van constant vouwen en expressies
De database-engine evalueert enkele constante expressies vroeg om de queryprestaties te verbeteren. Deze optimalisatietechniek die door de Query Optimizer wordt gebruikt, heeft als doel expressies te vereenvoudigen tijdens het compileren in plaats van tijdens runtime. Het omvat het evalueren van constante expressies tijdens het compileren van query's, zodat het resulterende uitvoeringsplan efficiënter is. Dit proces wordt constant folding genoemd. Een constante is een T-SQL-literaal, zoals 3, 'ABC', , '2025-12-31', 1.0e3, of 0x12345678. Neem bijvoorbeeld deze query:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Hier is 30 * 12 een constante expressie. De Database Engine evalueert deze expressie tijdens de compilatie en kan de query intern herschrijven als:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Vouwbare expressies
De Database Engine gebruikt constant folding met de volgende soorten expressies:
- Rekenkundige expressies, zoals
1 + 1en5 / 3 * 2, die alleen constanten bevatten. - Logische expressies, zoals
1 = 1en1 > 2 AND 3 > 4, die alleen constanten bevatten. - Ingebouwde functies die de Database Engine als vouwbaar beschouwt, waaronder
CASTenCONVERT. Over het algemeen is een intrinsieke functie samenvouwbaar als het alleen een functie is van haar invoer en niet van andere contextuele informatie, zoalsSETopties, taalinstellingen, databaseopties en encryptiesleutels. Niet-deterministische functies zijn niet vouwbaar. Deterministische ingebouwde functies kunnen worden gevouwen, met enkele uitzonderingen. - Deterministische methoden van CLR-gebruikersgedefinieerde types en deterministische, scalair-waardige CLR-gebruikersfuncties. Zie Constant Folding voor CLR User-Defined Functions and Methodsvoor meer informatie.
Notitie
Er wordt een uitzondering gemaakt voor grote objecttypen. Als het uitvoertype van het vouwproces een groot objecttype is (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json of xml), vouwt de Database Engine de expressie niet.
Niet-samenvouwbare expressies
Alle andere expressietypen kunnen niet worden gevouwen. In het bijzonder zijn de volgende typen expressies niet vouwbaar:
- Niet-stante expressies, zoals een expressie waarvan het resultaat afhankelijk is van de waarde van een kolom.
- Expressies waarvan de resultaten afhankelijk zijn van een lokale variabele of parameter, zoals
@x. - Niet-deterministische functies.
- Door de gebruiker gedefinieerde T-SQL-functies.
- Expressies waarvan de resultaten afhankelijk zijn van taalinstellingen.
- Expressies waarvan de resultaten afhankelijk zijn van
SETopties. - Expressies waarvan de resultaten afhankelijk zijn van serverconfiguratieopties.
Voorbeelden van vouwbare en niet-vouwbare constante expressies
Houd rekening met de volgende query:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Als de PARAMETERIZATION databaseoptie voor deze query niet is ingesteld op FORCED, wordt de expressie 117.00 + 1000.00 geëvalueerd en vervangen door het resultaat, 1117.00, voordat de query wordt gecompileerd. Voordelen van deze constant folding zijn onder andere:
- De expressie hoeft niet herhaaldelijk tijdens runtime te worden geëvalueerd.
- De waarde van de expressie nadat deze geëvalueerd is, wordt door de Query Optimizer gebruikt om de grootte van de resultaatset van het deel van de query
TotalDue > 117.00 + 1000.00te schatten.
Aan de andere kant, als dbo.f een door de gebruiker gedefinieerde scalaire functie is, wordt de expressie dbo.f(100) niet gefold, omdat de Database Engine geen expressies vouwt die door de gebruiker gedefinieerde functies bevatten, zelfs als ze deterministisch zijn. Voor meer informatie over parameterisatie, zie Forced parameterization.
Expressie-evaluatie
Daarnaast worden sommige expressies die niet constant zijn gevouwen, maar waarvan de argumenten al bij het compileren bekend zijn, ongeacht of het parameters of constanten zijn, geëvalueerd door de cardinaliteitsschatting die onderdeel is van de optimizer tijdens de optimalisatie.
Met name de volgende ingebouwde functies en speciale operators worden geëvalueerd tijdens het compileren als al hun invoer bekend is: UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CASTen CONVERT. De volgende operators worden ook tijdens het compileren geëvalueerd als al hun invoer bekend is:
- Rekenkundige operatoren:
+,-,*,/, unaire- - Logische operatoren:
AND,OR,NOT - Vergelijkingsoperatoren:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
Er worden geen andere functies of operators geëvalueerd door de Query Optimizer tijdens de schatting van de kardinaliteit.
Voorbeelden van evaluatie van compilatietijdexpressie
Beschouw deze opgeslagen procedure:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Tijdens de optimalisatie van de instructie SELECT in de procedure probeert de Query Optimizer de verwachte kardinaliteit van de resultatenset voor de voorwaarde OrderDate > @d + 1te evalueren. De expressie @d + 1 is niet constant opgevouwen, omdat @d een parameter is. Tijdens optimalisatietijd is de waarde van de parameter echter bekend. Deze waarde stelt de Query Optimizer in staat om de grootte van de resultaatset nauwkeurig te schatten, wat helpt bij het kiezen van een goed queryplan.
Beschouw nu een voorbeeld dat vergelijkbaar is met het vorige, behalve dat een lokale variabele @d2@d + 1 vervangt in de query en de expressie wordt geëvalueerd in een SET statement in plaats van in de query.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Wanneer de SELECT statement in MyProc2 is geoptimaliseerd in de Database Engine, is de waarde van @d2 niet bekend. Daarom gebruikt de Query Optimizer een standaardschatting voor de selectiviteit van OrderDate > @d2 (in dit geval 30 procent).
Andere verklaringen verwerken
De basisstappen voor het verwerken van een SELECT statement zijn van toepassing op andere T-SQL-statements zoals INSERT, UPDATE, en DELETE. Zowel de instructies UPDATE als DELETE moeten gericht zijn op de set rijen die aangepast of verwijderd moet worden. Het proces voor het identificeren van deze rijen is hetzelfde proces dat wordt gebruikt om de bronrijen te identificeren die bijdragen aan de resultatenset van een SELECT-instructie. Beide UPDATE- en INSERT-statements kunnen ingebedde SELECT-statements bevatten die de datawaarden leveren om bij te werken of in te voegen.
Zelfs Data Definition Language (DDL)-instructies, zoals CREATE PROCEDURE of ALTER TABLE, worden opgelost tot een reeks relationele bewerkingen op de systeemcatalogustabellen en soms (zoals ALTER TABLE ADD COLUMN) tegen de datatabellen.
Werktabellen
De relationele engine kan een werktabel moeten bouwen om een logische bewerking uit te voeren die is gespecificeerd in een T-SQL-instructie. Worktables zijn interne tabellen die tussenresultaten bevatten. Werktabellen worden gegenereerd voor bepaalde GROUP BY, ORDER BYof UNION queries. Als bijvoorbeeld een ORDER BY-clausule verwijst naar kolommen die niet door indexen worden bedekt, kan de relationele engine een werktabel moeten genereren om de resultaatset in de gevraagde volgorde te sorteren. Werktabellen worden soms ook gebruikt als spools die het resultaat van het uitvoeren van een deel van een queryplan tijdelijk bevatten. Werktafels worden aangemaakt in tempdb en worden automatisch verwijderd zodra ze niet meer nodig zijn.
Resolutie weergeven
De Database Engine queryprocessor behandelt geïndexeerde en niet-geïndexeerde weergaven verschillend:
- De database slaat de rijen van een geïndexeerde view op in hetzelfde formaat als een tabel. Als de Query Optimizer besluit een geïndexeerde weergave te gebruiken in een queryplan, behandelt hij de geïndexeerde weergave op dezelfde manier als een basistabel.
- Alleen de definitie van een niet-geïndexeerde weergave wordt opgeslagen, niet de rijen van de weergave. De Query Optimizer verwerkt de logica uit de weergavedefinitie in het uitvoeringsplan dat het bouwt voor de T-SQL-instructie die verwijst naar de niet-geïndexeerde weergave.
De logica die de Query Optimizer gebruikt om te bepalen wanneer een geïndexeerde weergave wordt gebruikt, lijkt op de logica die hij gebruikt om te bepalen wanneer een index op een tabel wordt gebruikt. Als de data in de geïndexeerde weergave het geheel of een deel van de T-SQL-instructie omvat, en de Query Optimizer bepaalt dat een index op de weergave het goedkope toegangspad is, kiest hij de index ongeacht of in de query met naam naar de weergave wordt verwezen.
Wanneer een T-SQL-instructie verwijst naar een niet-geïndexeerd view, analyseren de parser en Query Optimizer de bron van zowel de T-SQL-instructie als de view en zetten ze deze vervolgens om in één uitvoeringsplan. De T-SQL-instructie en de view hebben geen aparte uitvoeringsplannen.
Bekijk bijvoorbeeld de volgende weergave:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Op basis van deze visie voeren beide T-SQL-instructies dezelfde bewerkingen uit op de basistabellen en leveren ze dezelfde resultaten:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
De Showplan-functie van SQL Server Management Studio (SSMS) laat zien dat de relationele engine hetzelfde uitvoeringsplan bouwt voor beide van deze SELECT instructies.
Hints gebruiken bij weergaven
Als je hints plaatst op views in een query, kunnen ze conflicteren met andere hints die worden ontdekt wanneer de view wordt uitgebreid om toegang te krijgen tot de basistabellen. Wanneer dit conflict zich voordoet, geeft de query een foutmelding terug. Bekijk bijvoorbeeld de volgende weergave die een tabelhint in de definitie bevat:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Stel nu dat u deze query invoert:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
De query faalt, omdat de SERIALIZABLE hint op de Person.AddrState view zich voortplant, zowel naar de Person.Address- als de Person.StateProvince-tabellen in de view wanneer deze wordt uitgebreid. Als u de weergave echter uitvouwt, ziet u ook de NOLOCK hint op Person.Address. Omdat de SERIALIZABLE en NOLOCK hints conflicteren, is de resulterende query onjuist.
De TABLOCKX, HOLDLOCK, NOLOCK, READCOMMITTED en REPEATABLEREAD tabelhints conflicteren met elkaar, net als de SERIALIZABLE, TABLOCK, ROWLOCK, NOLOCK en PAGLOCK tabelhints.
Hints kunnen worden doorgegeven via niveaus van geneste weergaven. Stel dat een query de HOLDLOCK hint toepast op een view v1. Wanneer v1 wordt uitgebreid, zie je dat de weergave v2 deel uitmaakt van de definitie ervan. De definitie van v2bevat een NOLOCK hint voor een van de basistabellen. Maar deze tabel neemt ook de HOLDLOCK hint over van de query in weergave v1. Omdat de NOLOCK en HOLDLOCK hints conflicteren, mislukt de query.
Wanneer je de FORCE ORDER hint gebruikt in een query die een view bevat, bepaalt de positie van de view in de geordende constructie de join-volgorde van de tabellen binnen de view. De volgende query selecteert bijvoorbeeld uit drie tabellen en een weergave:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
En View1 wordt gedefinieerd zoals getoond in het volgende voorbeeld:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
De joinvolgorde in het queryplan is Table1, Table2, TableA, TableB, Table3.
Indexen voor weergaven oplossen
Zoals bij elke index kiest de Database Engine ervoor om een geïndexeerde view in zijn queryplan te gebruiken alleen als de Query Optimizer bepaalt dat dit voordelig is.
Je kunt geïndexeerde weergaven maken in elke editie van de Database Engine. In sommige edities houdt de Query Optimizer automatisch rekening met de geïndexeerde weergave, terwijl je in andere edities de NOEXPAND tabelhint moet gebruiken. Automatisch gebruik van een geïndexeerde weergave door de Query Optimizer wordt alleen ondersteund in specifieke edities van SQL Server.
Notitie
Azure SQL Database en Azure SQL Managed Instance ondersteunen het automatisch gebruik van geïndexeerde weergaven zonder de NOEXPAND hint op te geven.
De Query Optimizer gebruikt een geïndexeerde view wanneer aan de volgende voorwaarden is voldaan:
- Deze sessieopties zijn ingesteld op
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- De
NUMERIC_ROUNDABORTsessieoptie is ingesteld opOFF. - De Query Optimizer vindt een match tussen de view-indexkolommen en elementen in de query, zoals:
- Zoekconditiepredicaten in de
WHEREclausule - Joinbewerkingen
- Aggregatiefuncties
-
GROUP BY-clausules - Tabelverwijzingen
- Zoekconditiepredicaten in de
- De geschatte kosten voor het gebruik van de index hebben de laagste kosten van eventuele toegangsmechanismen die door de Query Optimizer worden beschouwd.
- Elke tabel waarnaar in de query wordt verwezen (rechtstreeks of door een weergave uit te vouwen voor toegang tot de onderliggende tabellen) die overeenkomt met een tabelverwijzing in de geïndexeerde weergave, moet dezelfde set hints hebben toegepast in de query.
Notitie
De hints voor READCOMMITTED en READCOMMITTEDLOCK worden altijd als verschillende hints in deze context beschouwd, ongeacht het huidige isolatieniveau van transacties.
Behalve de vereisten voor de SET opties en tabelhints, zijn dit dezelfde regels die de Query Optimizer gebruikt om te bepalen of een tabelindex een query omvat. Je hoeft niets anders in de query op te geven om een geïndexeerde weergave te gebruiken.
Een query hoeft niet expliciet te verwijzen naar een geïndexeerde weergave in de FROM component voor de Query Optimizer om de geïndexeerde weergave te gebruiken. Als de query verwijzingen bevat naar kolommen in de basistabellen die ook aanwezig zijn in de geïndexeerde weergave en de Query Optimizer schattingen maakt dat het gebruik van de geïndexeerde weergave het laagste mechanisme voor toegang tot kosten biedt, kiest de Query Optimizer de geïndexeerde weergave, vergelijkbaar met de manier waarop deze basistabelindexen kiest wanneer ze niet rechtstreeks in een query worden verwezen. De queryoptimalisatie kan de weergave kiezen wanneer deze kolommen bevat waarnaar niet wordt verwezen door de query, zolang de weergave de laagste kostenoptie biedt voor het dekken van een of meer van de kolommen die in de query zijn opgegeven.
Query Optimizer behandelt een geïndexeerde weergave waarnaar in de FROM-component wordt verwezen als een standaardweergave. De queryoptimalisatie breidt de definitie van de weergave uit naar de query aan het begin van het optimalisatieproces. Vervolgens wordt het vergelijken van geïndexeerde weergaven uitgevoerd. De geïndexeerde weergave kan worden gebruikt in het uiteindelijke uitvoeringsplan dat is geselecteerd door queryoptimalisatie, of in plaats daarvan kan het plan de benodigde gegevens uit de weergave materialiseren door toegang te krijgen tot de basistabellen waarnaar wordt verwezen door de weergave. De Query Optimizer kiest het alternatief voor de laagste kosten.
Hints gebruiken met geïndexeerde weergaven
U kunt voorkomen dat indexen voor een query worden gebruikt met behulp van de EXPAND VIEWS queryhint, of u kunt de NOEXPAND tabelhint gebruiken om het gebruik van een index af te dwingen voor een geïndexeerde weergave die is opgegeven in de FROM component van een query. U moet echter de Query Optimizer dynamisch laten bepalen welke toegangsmethoden voor elke query moeten worden gebruikt. Beperk uw gebruik van EXPAND en NOEXPAND tot specifieke gevallen waarin testen hebben aangetoond dat ze de prestaties aanzienlijk verbeteren.
De
EXPAND VIEWS-optie geeft aan dat de query-optimalisator geen weergave-indexen moet gebruiken voor de hele query.Wanneer je
NOEXPANDvoor een weergave specificeert, houdt de Query Optimizer rekening met het gebruik van alle indexen die op de weergave zijn gedefinieerd.NOEXPANDopgegeven met de optioneleINDEX()component dwingt de Query Optimizer om de opgegeven indexen te gebruiken. Je kunt alleen specificerenNOEXPANDvoor een geïndexeerde weergave en niet voor een weergave die niet geïndexeerd is. Automatisch gebruik van een geïndexeerde weergave door de Query Optimizer wordt alleen ondersteund in specifieke edities van SQL Server.Notitie
Azure SQL Database en Azure SQL Managed Instance ondersteunen het automatisch gebruik van geïndexeerde weergaven zonder de
NOEXPANDhint op te geven.
Wanneer noch NOEXPAND noch EXPAND VIEWS is opgegeven in een query die een weergave bevat, wordt de weergave uitgebreid voor toegang tot onderliggende tabellen. Als de query waaruit de weergave bestaat, tabelhints bevat, worden deze hints doorgegeven aan de onderliggende tabellen. (Dit proces wordt uitgebreider uitgelegd in View resolution.) Zolang de hints op de onderliggende tabellen van de view identiek zijn, komt de query in aanmerking om te worden gekoppeld aan een geïndexeerde view. Meestal komen deze hints overeen met elkaar, omdat ze direct van de weergave worden overgenomen. Als de query echter verwijst naar tabellen in plaats van weergaven en de hints die rechtstreeks op deze tabellen worden toegepast, zijn deze niet identiek, dan komt een dergelijke query niet in aanmerking voor overeenkomsten met een geïndexeerde weergave. Als de INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCKof XLOCK hints van toepassing zijn op de tabellen die in de query worden genoemd na het uitbreiden van de weergave, komt de query niet in aanmerking voor overeenkomende geïndexeerde weergave.
Als een tabelhint in de vorm van INDEX ( index_val [ ,...n] ) verwijst naar een weergave in een query en u niet ook de NOEXPAND hint opgeeft, wordt de indexhint genegeerd. Als u het gebruik van een bepaalde index wilt opgeven, gebruikt u NOEXPAND.
Over het algemeen, wanneer de Query Optimizer een geïndexeerde weergave koppelt aan een query, past hij alle hints die in de tabellen of weergaven in de query zijn gespecificeerd direct toe op de geïndexeerde weergave. Als de Query Optimizer ervoor kiest geen geïndexeerde view te gebruiken, stuurt hij alle hints direct door naar de tabellen waarnaar in de view wordt verwezen. Voor meer informatie, zie Bekijk resolutie. Deze doorgifte is niet van toepassing op join-hints. Ze worden alleen toegepast op de oorspronkelijke positie in de query. De Query Optimizer houdt geen rekening met join-hints bij het koppelen van queries aan geïndexeerde views. Als een queryplan gebruikmaakt van een geïndexeerde weergave die overeenkomt met een deel van een query die een join-hint bevat, wordt de join-hint niet gebruikt in het plan.
Hints zijn niet toegestaan in de definities van geïndexeerde weergaven. De Database Engine negeert hints binnen geïndexeerde weergavedefinities bij het onderhouden ervan, of bij het uitvoeren van queries die geïndexeerde weergaven gebruiken.
Zie Tabelhints voor meer informatie.
Gedistribueerde gepartitioneerde weergaven oplossen
De Database Engine queryprocessor optimaliseert de prestaties van gedistribueerde gepartitioneerde views. Het belangrijkste aspect van gedistribueerde gepartitioneerde weergaveprestaties is het minimaliseren van de hoeveelheid gegevens die tussen lidservers worden overgedragen.
De Database Engine bouwt intelligente, dynamische plannen die efficiënt gebruik maken van gedistribueerde queries om data uit remote member-tabellen te benaderen:
- De queryprocessor gebruikt OLE DB om eerst de definities van de controlebeperkingen uit elke lidtabel op te halen. Met deze methode kan de queryprocessor de verdeling van sleutelwaarden over de lidtabellen in kaart brengen.
- De Query Processor vergelijkt de sleutelbereiken die zijn opgegeven in een
WHERE-clausule van een T-SQL-instructie met de map die laat zien hoe de rijen in de lidtabellen zijn verdeeld. De queryprocessor bouwt vervolgens een query-uitvoeringsplan dat gedistribueerde queries gebruikt om alleen die externe rijen op te halen die nodig zijn om de T-SQL-instructie te voltooien. Het uitvoeringsplan is ook zo opgebouwd dat elke toegang tot remote member-tabellen, voor data of metadata, wordt uitgesteld totdat de informatie nodig is.
Denk bijvoorbeeld aan een systeem waarin een Customers tabel is gepartitioneerd op Server1 (CustomerID van 1 tot en met 3299999), Server2 (CustomerID van 3300000 tot 6599999) en Server3 (CustomerID van 66000000 tot 9999999).
Overweeg het uitvoeringsplan dat is gebouwd voor deze query die wordt uitgevoerd op Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
Het uitvoeringsplan voor deze query extraheert de rijen met CustomerID-sleutelwaarden van 3200000 tot 3299999 uit de lokale ledentabel en voert een gedistribueerde query uit om de rijen met sleutelwaarden van 3300000 tot en met 3400000 van Server2 op te halen.
De Database Engine Query Processor kan ook dynamische logica inbouwen in query-uitvoeringsplannen voor T-SQL-instructies waarbij de sleutelwaarden niet bekend zijn wanneer het plan moet worden opgebouwd. Denk bijvoorbeeld aan deze opgeslagen procedure:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
De Database Engine kan niet voorspellen welke sleutelwaarde telkens wanneer de procedure wordt uitgevoerd door de parameter @CustomerIDParameter wordt opgegeven. Omdat de sleutelwaarde niet kan worden voorspeld, kan de queryprocessor ook niet voorspellen welke ledentabel hij moet benaderen. Om dit geval af te handelen, bouwt de Database Engine een uitvoeringsplan met conditionele logica, de zogenaamde dynamische filters, om te bepalen welke membertabel wordt geraadpleegd, gebaseerd op de invoerparameterwaarde. Aangenomen dat de GetCustomer opgeslagen procedure op Server1 is uitgevoerd, kan de logica van het uitvoeringsplan worden weergegeven zoals weergegeven in de volgende output:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
De Database Engine bouwt soms dit soort dynamische uitvoeringsplannen, zelfs voor queries die niet geparametriseerd zijn. Query Optimizer kan een query parameteriseren, zodat het uitvoeringsplan opnieuw kan worden gebruikt. Als de Query Optimizer een query parametriseert die verwijst naar een gepartitioneerde weergave, kan de Query Optimizer niet langer aannemen dat de vereiste rijen uit een gespecificeerde basistabel komen. Vervolgens moet het dynamische filters gebruiken in het uitvoeringsplan.
Opgeslagen procedure en triggeruitvoering
De Database Engine slaat alleen de bron op voor opgeslagen procedures en triggers. Wanneer een opgeslagen procedure of trigger voor het eerst wordt uitgevoerd, wordt de bron gecompileerd in een uitvoeringsplan. Als de opgeslagen procedure of trigger opnieuw wordt uitgevoerd voordat het uitvoeringsplan verouderd is uit het geheugen, detecteert de relationele engine het bestaande plan en wordt het opnieuw gebruikt. Als het plan uit het geheugen wordt verwijderd, wordt er een nieuw plan gebouwd. Dit proces lijkt op het proces dat de Database Engine volgt voor alle T-SQL-instructies. Het belangrijkste prestatievoordeel dat opgeslagen procedures en triggers hebben in de Database Engine vergeleken met batches dynamische T-SQL is dat hun T-SQL-statements altijd hetzelfde zijn. Daarom komt de relationele engine eenvoudig overeen met bestaande uitvoeringsplannen. Opgeslagen procedure- en triggerplannen kunnen eenvoudig opnieuw worden gebruikt.
Het uitvoeringsplan voor opgeslagen procedures en triggers wordt afzonderlijk uitgevoerd van het uitvoeringsplan voor de batch die de opgeslagen procedure aanroept of de trigger activeert. Deze scheiding maakt meer hergebruik mogelijk van de opgeslagen procedure en trigger-uitvoeringsplannen.
Uitvoeringsplan opslaan in cache en hergebruik
De Database Engine gebruikt geheugen om zowel uitvoeringsplannen als databuffers op te slaan. Het percentage geheugen dat wordt toegewezen aan uitvoeringsplannen of databuffers wordt dynamisch aangepast, afhankelijk van de toestand van het systeem. Het deel van het geheugen dat uitvoeringsplannen opslaat, wordt de plancache genoemd.
Opslagplaatsen voor plancache
De plancache heeft twee opslagplaatsen voor alle gecompileerde plannen.
- De cacheopslag voor Object Plans (OBJCP), voor plannen die betrekking hebben op persistente objecten, zoals opgeslagen procedures, functies en triggers.
- De SQL Plans-cache (SQLCP) slaat plannen op die betrekking hebben op geautomatiseerd geparameteriseerde, dynamische of voorbereide query's.
De volgende query geeft informatie over het geheugengebruik voor deze twee cacheopslagen:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
De plancache heeft twee extra stores die geen plannen opslaan:
- De Bound Trees cacheopslag (PHDR), voor datastructuren die worden gebruikt tijdens de compilatie van plannen voor weergaven, constraints en standaardinstellingen. Deze structuren staan bekend als bound trees of algebrizerbomen.
- De Extended Stored Procedures cache-opslag (XPROC), voor vooraf gedefinieerde systeemprocedures, zoals sp_executesql of xp_cmdshell. Deze opgeslagen procedures gebruiken een DLL in plaats van T-SQL-instructies. De gecachte structuur bevat alleen de functienaam en de DLL-naam waarin de procedure is geïmplementeerd.
Onderdelen van het uitvoeringsplan
Database Engine-uitvoeringsplannen hebben de volgende hoofdcomponenten:
Gecompileerd plan (of queryplan)
Het queryplan dat door het compilatieproces wordt geproduceerd, is meestal een nieuwe, alleen-lezen gegevensstructuur die door een willekeurig aantal gebruikers wordt gebruikt. Er wordt informatie opgeslagen over:
Fysieke operators die de bewerking implementeren die wordt beschreven door logische operators.
De volgorde van deze operators, waarmee de volgorde wordt bepaald waarin gegevens worden geopend, gefilterd en geaggregeerd.
Het aantal geschatte gegevensrijen dat door de operatoren wordt verwerkt.
Notitie
Het queryplan slaat ook informatie op over de statistische objecten die worden gebruikt voor kardinaliteitsschatting.
Welke ondersteuningsobjecten moeten worden gemaakt, zoals werktabellen of werkbestanden in
tempdb.
Het queryplan slaat geen gebruikerscontext of runtime-informatie op. De Database Engine bepaalt het aantal worker-threads telkens wanneer het een plan uit de plancache haalt. Een gecachet parallel plan kan ook serieel draaien.
Uitvoeringscontext
Elke gebruiker die de query op dat moment uitvoert, heeft een datastructuur die de specifieke gegevens voor de uitvoering van die gebruiker bevat, zoals parameterwaarden. Deze datastructuur wordt de uitvoeringscontext genoemd. De structuur van de uitvoeringscontextgegevens wordt opnieuw gebruikt, maar de inhoud ervan is dat niet. Als een andere gebruiker dezelfde query uitvoert, worden de gegevensstructuren opnieuw geïnitialiseerd met de context voor de nieuwe gebruiker.
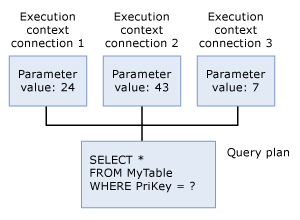
Plannen hergebruiken voor identieke statements
Wanneer de Database Engine een T-SQL-instructie uitvoert, kijkt deze eerst door de plancache om te verifiëren dat er een bestaand uitvoeringsplan voor dezelfde T-SQL-instructie bestaat. De T-SQL-instructie kwalificeert als bestaand als deze letterlijk overeenkomt met een eerder uitgevoerde T-SQL-instructie met een gecachet plan, teken voor teken. De Database Engine hergebruikt elk bestaand plan dat het vindt, waardoor de overhead van het opnieuw compileren van de T-SQL-instructie wordt bespaard. Als er geen uitvoeringsplan bestaat, genereert de Database Engine een nieuw uitvoeringsplan voor de query.
Notitie
De plancache bewaart geen uitvoeringsplannen voor sommige T-SQL-instructies, zoals bulk operation statements die draaien op rowstore of statements met grote stringliterals. Deze plannen bestaan alleen terwijl de query draait.
De Database Engine gebruikt een efficiënt algoritme om bestaande uitvoeringsplannen voor een specifieke T-SQL-instructie te vinden. In de meeste systemen zijn de minimale middelen die deze scan gebruikt minder dan de middelen die worden bespaard door bestaande plannen opnieuw te gebruiken in plaats van elke T-SQL-instructie te compileren.
De algoritmen om nieuwe T-SQL-statements te koppelen aan bestaande, ongebruikte uitvoeringsplannen in de plancache vereisen dat alle objectreferenties volledig gekwalificeerd zijn. Stel bijvoorbeeld dat Person het standaardschema is voor de gebruiker die de volgende SELECT statements uitvoert. Hoewel je in dit voorbeeld de tabel Person niet volledig hoeft te kwalificeren om deze uit te voeren, betekent dit dat de tweede instructie niet overeenkomt met een bestaand plan, maar de derde instructie wel:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Het wijzigen van een van de volgende SET opties voor een bepaalde uitvoering beïnvloedt de mogelijkheid om plannen te hergebruiken, omdat de Database Engine constant folding uitvoert en deze opties de resultaten van dergelijke expressies beïnvloeden:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Meerdere plannen voor dezelfde query in de cache opslaan
Query's en uitvoeringsplannen zijn uniek identificeerbaar in de database-engine, net als een vingerafdruk:
- De hash- van het queryplan is een binaire hash-waarde die wordt berekend in het uitvoeringsplan voor een bepaalde query en wordt gebruikt om vergelijkbare uitvoeringsplannen op unieke wijze te identificeren.
- De queryhash is een binaire hashwaarde die wordt berekend op de T-SQL-tekst van een query, en wordt gebruikt om queries uniek te identificeren.
Je kunt een gecompileerd plan uit de plancache ophalen door een planhandle te gebruiken. Deze tijdelijke identificatie blijft alleen constant zolang het plan in de cache blijft. De plangreep is een hash-waarde die is afgeleid van het gecompileerd plan van de hele batch. De planhandle voor een gecompileerd plan blijft hetzelfde, zelfs als één of meer statements in de batch opnieuw worden gecompileerd.
Notitie
Als je een plan voor een batch compileert in plaats van een enkele statement, kun je de planhandle en statement-offsets gebruiken om het plan voor individuele statements in de batch te krijgen.
De sys.dm_exec_requests DMV bevat de kolommen statement_start_offset en statement_end_offset voor elk record. Deze kolommen verwijzen naar de momenteel uitvoerende instructie van een momenteel uitvoerende batch of persistent object. Zie sys.dm_exec_requests voor meer informatie.
De sys.dm_exec_query_stats DMV bevat deze kolommen ook voor elk record. Deze kolommen verwijzen naar de positie van een statement binnen een batch of een persisted object. Zie sys.dm_exec_query_stats voor meer informatie.
De daadwerkelijke T-SQL-tekst van een batch wordt opgeslagen in een aparte geheugenruimte van de plancache, genaamd de SQL Manager-cache (SQLMGR). Je kunt de T-SQL-tekst voor een gecompileerd plan ophalen uit de SQL Manager-cache door een SQL-handle te gebruiken. Deze tijdelijke identificator blijft alleen constant zolang er ten minste één plan dat ernaar verwijst, in de plancache blijft. De SQL-handle is een hashwaarde die is afgeleid van de volledige batchtekst en is gegarandeerd uniek voor elke batch.
Notitie
Net als bij een gecompileerd plan wordt de T-SQL-tekst per batch opgeslagen, inclusief de opmerkingen. De SQL-handle bevat de MD5-hash van de volledige batchtekst en is gegarandeerd uniek voor elke batch.
De volgende query geeft informatie over het geheugengebruik voor de SQL Manager-cache:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Er is een één-op-veel relatie tussen een SQL-handle en plan-handles. Deze voorwaarde doet zich voor wanneer de cachesleutel voor de gecompileerde plannen anders is. Dit verschil kan ontstaan door veranderingen in SET opties tussen twee uitvoeringen van dezelfde batch.
Houd rekening met de volgende SQL opgeslagen procedure:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Controleer wat u kunt vinden in de plancache door de volgende zoekopdracht te gebruiken:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Dit is de resultatenset.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Voer nu de opgeslagen procedure uit met een andere parameter, zonder verdere wijzigingen in de uitvoeringscontext:
EXECUTE usp_SalesByCustomer 8;
GO
Controleer opnieuw wat je kunt vinden in de plancache. Dit is de resultatenset.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Let op dat de usecounts waarde stijgt naar 2, wat betekent dat hetzelfde gecachte plan wordt hergebruikt as-is, omdat de uitvoeringscontextdatastructuren worden hergebruikt. Verander nu de SET ANSI_DEFAULTS optie en voer de opgeslagen procedure uit met dezelfde parameter.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Controleer opnieuw wat je kunt vinden in de plancache. Dit is de resultatenset.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
U ziet nu twee vermeldingen in de sys.dm_exec_cached_plans DMV-uitvoer:
- De
usecountskolom toont de waarde1in het eerste record. Deze waarde vertegenwoordigt het plan dat eenmaal is uitgevoerd metSET ANSI_DEFAULTS OFF. - De
usecountskolom toont de waarde2in het tweede record. Deze waarde staat voor het metSET ANSI_DEFAULTS ONuitgevoerde plan, omdat het twee keer is uitgevoerd. - De andere
memory_object_addressverwijst naar een andere invoer van het uitvoeringsplan in de plancache. Desql_handlewaarde is echter hetzelfde voor beide vermeldingen, omdat ze verwijzen naar dezelfde batch.- De uitvoering met
ANSI_DEFAULTSgezet opOFFheeft een nieuweplan_handle, en deze is beschikbaar voor hergebruik voor aanroepen met dezelfde setSETopties. De nieuwe plangreep is nodig omdat de uitvoeringscontext opnieuw is geïnitialiseerd vanwege gewijzigdeSETopties. Maar die wijziging veroorzaakt geen hercompilatie: beide vermeldingen verwijzen naar hetzelfde plan en dezelfde query, zoals blijkt uit dezelfde waarden voorquery_plan_hashenquery_hash.
- De uitvoering met
Deze situatie betekent dat je twee planvermeldingen in de cache hebt die overeenkomen met dezelfde batch. Het benadrukt het belang van ervoor te zorgen dat de opties die van invloed zijn op de plancache SET hetzelfde zijn wanneer dezelfde zoekopdrachten herhaald worden uitgevoerd. Deze aanpak optimaliseert het hergebruik van het plan en houdt de grootte van de plancache tot het vereiste minimum.
Aanbeveling
Een veelvoorkomende valkuil is dat verschillende clients verschillende standaardwaarden voor de SET opties kunnen hebben. Bijvoorbeeld, een verbinding die via SQL Server Management Studio wordt gemaakt, zet QUOTED_IDENTIFIER automatisch op ON, terwijl SQLCMD QUOTED_IDENTIFIER op OFF zet. Het uitvoeren van dezelfde queries vanuit deze twee clients resulteert in meerdere plannen (zoals beschreven in het vorige voorbeeld).
Uitvoeringsplannen verwijderen uit de plancache
Uitvoeringsplannen blijven in de plancache zolang er genoeg geheugen is om ze op te slaan. Wanneer er geheugendruk is, gebruikt de SQL Server Database Engine een kostengebaseerde aanpak om te bepalen welke uitvoeringsplannen uit de plancache verwijderd moeten worden. Om een kostengebaseerde beslissing te nemen, verhoogt en verlaagt de SQL Server Database Engine een huidige kostenvariabele voor elk uitvoeringsplan op basis van de volgende factoren.
Wanneer een gebruikersproces een uitvoeringsplan in de cache plaatst, stelt het gebruikersproces de huidige kosten gelijk aan de oorspronkelijke querycompilatiekosten. Voor ad-hoc uitvoeringsplannen zet het gebruikersproces de huidige kosten op nul. Daarna zet een gebruikersproces elke keer dat het naar een uitvoeringsplan verwijst, de huidige kosten terug naar de oorspronkelijke compileerkosten. Voor ad-hoc query-uitvoeringsplannen verhoogt de gebruikerssessie de huidige kosten. Voor alle abonnementen is de maximale waarde voor de huidige kosten de oorspronkelijke compileerkosten.
Wanneer geheugendruk aanwezig is, verwijdert de SQL Server Database Engine uitvoeringsplannen uit de plancache. Als u wilt bepalen welke plannen u wilt verwijderen, onderzoekt de SQL Server Database Engine herhaaldelijk de status van elk uitvoeringsplan en verwijdert u plannen wanneer de huidige kosten nul zijn. Een uitvoeringsplan met nul huidige kosten wordt niet automatisch verwijderd wanneer er geheugendruk is. Het wordt alleen verwijderd wanneer de SQL Server Database Engine het plan onderzoekt en de huidige kosten nul zijn. Bij het onderzoeken van een uitvoeringsplan pusht de SQL Server Database Engine de huidige kosten naar nul door de huidige kosten te verlagen als een query momenteel geen gebruik maakt van het plan.
De SQL Server Database Engine blijft de uitvoeringsplannen onderzoeken totdat er genoeg plannen zijn verwijderd om aan geheugenvereisten te voldoen. Hoewel er geheugenbelasting bestaat, kunnen de kosten van een uitvoeringsplan toenemen en meer dan één keer afnemen. Wanneer geheugendruk niet meer bestaat, stopt de SQL Server Database Engine met het verlagen van de huidige kostenwaarde van ongebruikte uitvoeringsplannen. Alle uitvoeringsplannen blijven in de plancache, zelfs als de kosten nul zijn.
De SQL Server Database Engine gebruikt de resourcemonitor en gebruikerswerkthreads om geheugen vrij te maken van de plancache als reactie op geheugendruk. De resource monitor- en user worker-threads kunnen tegelijkertijd plannen bekijken om de huidige kosten voor elk ongebruikt uitvoeringsplan te verlagen. De resourcemonitor verwijdert uitvoeringsplannen uit de plancache wanneer er globale geheugenbelasting bestaat. Het maakt geheugen vrij om beleid af te dwingen voor systeemgeheugen, procesgeheugen, resourcegroepgeheugen en maximale grootte voor alle caches.
De maximale grootte voor alle caches is een functie van de grootte van de buffergroep en kan het maximale servergeheugen niet overschrijden. Voor meer informatie over het configureren van het maximale servergeheugen, zie de max server memory instelling in sp_configure.
De werkdraad van de gebruiker verwijdert uitvoeringsplannen uit de plancache wanneer er sprake is van cachegeheugenbelasting. Ze dwingen beleidsregels af voor maximale grootte van één cache en maximale vermeldingen in één cache.
In de volgende voorbeelden ziet u welke uitvoeringsplannen worden verwijderd uit de plancache:
- Er wordt vaak naar een uitvoeringsplan verwezen, zodat de kosten nooit naar nul gaan. Het plan blijft in de plancache en wordt niet verwijderd tenzij er geheugendruk is en de huidige kosten nul zijn.
- Er wordt een ad-hocuitvoeringsplan ingevoegd en er wordt niet opnieuw naar verwezen totdat er geheugendruk optreedt. Omdat ad hoc-plannen worden geïnitialiseerd met een huidige kostprijs van nul, ziet de SQL Server Database Engine bij het onderzoeken van het uitvoeringsplan de nul huidige kosten en verwijdert het plan uit de plancache. Het ad hoc uitvoeringsplan blijft in de plancache met nul huidige kosten wanneer er geen geheugendruk is.
Als u handmatig één of alle plannen uit de cache wilt verwijderen, gebruikt u DBCC FREEPROCCACHE-. Je kunt ook DBCC FREESYSTEMCACHE gebruiken om elke cache te wissen, inclusief de plancache. SQL Server 2016 (13.x) en latere versies, gebruikt u ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE om de procedure (plan) cache voor de database in scope te wissen.
Een wijziging in sommige configuratie-instellingen via sp_configure en reconfigure zorgt er ook voor dat plannen uit de plancache worden verwijderd. U vindt de lijst met deze configuratie-instellingen in de sectie Opmerkingen van het DBCC FREEPROCCACHE artikel. Wanneer u deze configuratiewijziging aanbrengt, wordt het volgende informatiebericht naar het foutlogboek geschreven:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Uitvoeringsplannen opnieuw compileren
Bepaalde wijzigingen in een database kunnen een uitvoeringsplan inefficiënt of ongeldig maken. De Database Engine detecteert deze wijzigingen en markeert het plan als niet geldig. Er moet vervolgens een nieuw plan worden gecompileerd voor de volgende verbinding waarmee de query wordt uitgevoerd. Voorwaarden die een plan ongeldig maken zijn onder andere:
- Wijzigingen aan een tabel of weergave waarnaar wordt verwezen door de query (
ALTER TABLEenALTER VIEW). - Wijzigingen aan één procedure, waardoor alle plannen voor die procedure uit de cache (
ALTER PROCEDURE) zouden worden verwijderd. - Wijzigingen in indexen die door het uitvoeringsplan worden gebruikt.
- Updates van statistieken die door het uitvoeringsplan worden gebruikt, ongeacht of ze expliciet door een instructie zoals
UPDATE STATISTICSworden gegenereerd of automatisch worden gegenereerd. - Een index verwijderen die wordt gebruikt door het uitvoeringsplan.
- Een expliciete aanroep van
sp_recompile. - Grote aantallen wijzigingen in sleutels (gegenereerd door
INSERTofDELETEinstructies van andere gebruikers die een tabel wijzigen waarnaar wordt verwezen door de query). - Als het aantal rijen in de ingevoegde of verwijderde tabellen aanzienlijk toeneemt voor tabellen met triggers.
- Een opgeslagen procedure uitvoeren door de
WITH RECOMPILEoptie te gebruiken.
De meeste hercompilaties zijn vereist ofwel voor de correctheid van instructies, of om mogelijk snellere query-uitvoeringsplannen te verkrijgen.
Wanneer een instructie binnen een batch hercompilatie triggert, wordt alleen die instructie opnieuw gecompileerd, niet de hele batch. Deze regel geldt ongeacht of de batch wordt ingediend via een opgeslagen procedure, trigger, ad hoc batch of prepared statement.
Hercompilatie op statement-niveau bevoordeelt de prestaties omdat in de meeste gevallen een klein aantal statements hercompilaties en de bijbehorende nadelen veroorzaken, in termen van CPU-tijd en locks. Deze sancties worden daarom vermeden voor de andere statements in de batch die niet opnieuw gecompileerd hoeven te worden.
De sql_statement_recompile uitgebreide gebeurtenis (XEvent) rapporteert hercompilaties op instructieniveau. Deze XEvent vindt plaats wanneer een hercompilatie op instructieniveau vereist is voor elk type batch. Deze eis omvat opgeslagen procedures, triggers, ad hoc batches en queries. Batches kunnen worden ingediend via verschillende interfaces, waaronder sp_executesql, dynamische SQL, Prepare-methoden of Execute-methoden.
De kolom recompile_cause van sql_statement_recompile XEvent bevat een geheel getal dat de reden voor de hercompilatie aangeeft. De volgende lijst bevat de mogelijke redenen:
- Cursoropties gewijzigd
- Uitgestelde compilatie
-
FOR BROWSEmachtiging gewijzigd -
OPTION (RECOMPILE)aangevraagd - Geparameteriseerd plan leeggemaakt
- De gepartitioneerde weergave is gewijzigd
- Plan dat invloed heeft op de databaseversie gewijzigd
- Querymeldingsomgeving gewijzigd
- Query Store mist het plan
- Het afdwingen van een Query Store-plan is mislukt
- Query Store-plan dat beleid afdwingt gewijzigd
- Externe rijenset is gewijzigd
- Schema gewijzigd
-
SEToptie gewijzigd - Statistieken gewijzigd
- Tijdelijke tabel is gewijzigd
Notitie
Wanneer je de AUTO_UPDATE_STATISTICS databaseoptie op ON zet, worden queries opnieuw gecompileerd wanneer ze zich richten op tabellen of geïndexeerde weergaven waarvan de statistieken zijn bijgewerkt of waarvan de kardinaliteiten sinds de laatste uitvoering aanzienlijk zijn gewijzigd. Dit gedrag is van toepassing op standaard door de gebruiker gedefinieerde tabellen, tijdelijke tabellen en de ingevoegde en verwijderde tabellen die zijn gemaakt door DML-triggers.
Instellen van AUTO_UPDATE_STATISTICS op OFF stopt deze hercompilaties, maar verouderde statistieken verslechteren meestal de queryprestaties meer dan de hercompilaties doen. Voor meer informatie, zie de AUTO_UPDATE_STATISTICS-optie . De inserted- en deleted-tabellen van DML-triggers INSTEAD OF worden aangemaakt in tempdb, dus ze volgen de instelling AUTO_UPDATE_STATISTICS van tempdb.
Gebruik expliciete parameters voor hergebruik van het plan
Het gebruik van parameters, waaronder benoemde parameters in ADO.NET-toepassingen en parametermarkers in OLE DB- en ODBC-toepassingen, kan het hergebruik van uitvoeringsplannen vergroten.
Waarschuwing
Valideer gebruikersinvoer altijd door het testtype, de lengte, de notatie en het bereik te testen. Zie SQL-injectievoor meer informatie.
Het enige verschil tussen de volgende twee SELECT-instructies is de waarden die in de WHERE-voorwaarde worden vergeleken.
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Het enige verschil tussen de uitvoeringsplannen voor deze query's is de waarde die is opgeslagen voor de vergelijking met de kolom ProductSubcategoryID. Hoewel het doel is dat de Database Engine altijd herkent dat de statements in wezen hetzelfde plan genereren en de plannen hergebruiken, detecteert de Database Engine deze gelijkenis soms niet in complexe T-SQL-instructies.
Het scheiden van constanten van de T-SQL-instructie door gebruik te maken van parameters helpt de relationele engine dubbele plannen te herkennen. Gebruik parameters op de volgende manieren:
Gebruik in T-SQL
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Deze methode wordt aanbevolen voor T-SQL-scripts, stored procedures of triggers die SQL-instructies dynamisch genereren.
ADO.NET met
SqlClientgebruikt benoemde parameters, zoals@Parm. OLE DB en ODBC gebruiken parametermarkers. Parametermarkers zijn vraagtekens (?) die een constante in een SQL-statement vervangen en gebonden zijn aan een programmavariabele. U doet bijvoorbeeld het volgende in een ODBC-toepassing:Gebruik
SQLBindParameterom een geheel getalvariabele te binden aan de eerste parametermarkering in een SQL-instructie.Plaats de waarde van het gehele getal in de variabele.
Voer de statement uit en specificeer de parametermarker (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
De SQL Server Native Client OLE DB Provider en de SQL Server Native Client ODBC-driver gebruiken
sp_executesqlom instructies naar SQL Server te sturen wanneer parametermarkers in applicaties worden gebruikt.Schrijf stored procedures, die zijn ontworpen om parameters te gebruiken.
Als je geen expliciet parameters in het ontwerp van je applicaties verwerkt, kun je ook vertrouwen op de Query Optimizer om bepaalde queries automatisch te parametriseren door gebruik te maken van het standaardgedrag van eenvoudige parameterisatie. U kunt ook afdwingen dat Query Optimizer alle query's in de database parameteriseren door de optie PARAMETERIZATION van de instructie ALTER DATABASE in te stellen op FORCED.
Eenvoudige parameterisatie
In de Database Engine verhoogt het gebruik van parameters of parametermarkers in T-SQL-instructies het vermogen van de relationele engine om nieuwe T-SQL-instructies te koppelen aan bestaande, eerder gecompileerde uitvoeringsplannen.
Waarschuwing
Valideer gebruikersinvoer altijd door het testtype, de lengte, de notatie en het bereik te testen. Zie SQL-injectievoor meer informatie.
Als een T-SQL-instructie zonder parameters wordt uitgevoerd, parameteriseert de Database Engine de instructie intern om de kans te vergroten dat deze wordt gekoppeld aan een bestaand uitvoeringsplan. Dit proces wordt parametrisatie genoemd. De standaard is eenvoudige parameterisatie, en je kunt gedwongen parameterisatie voor een database inschakelen.
Houd rekening met deze instructie:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Je kunt de waarde 1 aan het einde van de statement als parameter specificeren. De relationele engine bouwt het uitvoeringsplan voor deze batch alsof je in plaats van de waarde 1 een parameter hebt gespecificeerd. Door deze eenvoudige parameterisatie herkent de Database Engine dat de volgende twee statements in wezen hetzelfde uitvoeringsplan genereren en hergebruikt het eerste plan voor de tweede statement:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Bij het verwerken van complexe T-SQL-statements kan de relationele engine moeite hebben om te bepalen welke expressies geparametriseerd kunnen worden. Om het vermogen van de relationele engine te vergroten om complexe T-SQL-instructies te koppelen aan bestaande, ongebruikte uitvoeringsplannen, specificeer je expliciet de parameters door gebruik te maken van sp_executesql of parametermarkeringen.
Notitie
Wanneer je de +, -, *, /, of % rekenkundige operatoren gebruikt om impliciete of expliciete conversie uit te voeren van int-, smallint-, tinyint- of bigint-constanten naar de float-, real, decimal of numeric datatypes, past de Database Engine specifieke regels toe om het type en de precisie van de expressieresultaten te berekenen. Deze regels verschillen, afhankelijk van of de query geparametriseerd is. Daarom kunnen vergelijkbare expressies in query's in sommige gevallen verschillende resultaten opleveren.
Onder het standaardgedrag van eenvoudige parameterisatie parametriseert de Database Engine een relatief kleine klasse van query's. U kunt echter opgeven dat alle query's in een database worden geparameteriseerd, afhankelijk van bepaalde beperkingen, door de optie PARAMETERIZATION van de opdracht ALTER DATABASE in te stellen op FORCED. Deze wijziging kan de prestaties verbeteren van databases die grote volumes gelijktijdige queries ervaren door de frequentie van querycompilaties te verminderen.
U kunt ook opgeven dat één query en alle andere query's die syntactisch gelijkwaardig zijn, maar alleen verschillen in de parameterwaarden, worden geparameteriseerd.
Aanbeveling
Wanneer je een object-relationele mapping (ORM) oplossing gebruikt zoals Entity Framework (EF), zijn applicatiequeries zoals handmatige LINQ-querybomen of bepaalde ruwe SQL-queries mogelijk niet geparametriseerd. Deze beperking beïnvloedt het hergebruik van plannen en de mogelijkheid om queries in de Query Store te volgen. Zie voor meer informatie EF Query-caching en parameterisering en EF Raw SQL-query's.
Geforceerde parameterisatie
Je kunt het standaard eenvoudige parameterisatiegedrag van de Database Engine overrulen door te specificeren dat alle SELECT, INSERT, UPDATE, en DELETE statements in een database geparametriseerd moeten zijn, onder bepaalde beperkingen. Schakel geforceerde parameterisatie in door de PARAMETERIZATION optie in de FORCED instructie op ALTER DATABASE te zetten. Geforceerde parameterisatie kan de prestaties van bepaalde databases verbeteren door de frequentie van querycompilaties en hercompilaties te verminderen. Databases die kunnen profiteren van geforceerde parameterisatie zijn over het algemeen databases die te maken hebben met grote hoeveelheden gelijktijdige query's van bronnen zoals point-of-sale-toepassingen.
Wanneer je de optie PARAMETERIZATION instelt op FORCED, wordt elke letterlijke waarde die voorkomt in een SELECT, INSERT, UPDATE of DELETE statement, ingediend in welke vorm dan ook, tijdens de compilatie van een query omgezet in een parameter. De uitzonderingen zijn letterlijke waarden die worden weergegeven in de volgende queryconstructies:
-
INSERT...EXECUTEverklaringen. - Instructies in de inhoud van opgeslagen procedures, triggers of door de gebruiker gedefinieerde functies. De Database Engine hergebruikt al queryplannen voor deze routines.
- Voorbereide statements die al geparametriseerd zijn in de client-side applicatie.
- Instructies die XQuery-methodeaanroepen bevatten, waarbij de methode wordt weergegeven in een context waarin de argumenten doorgaans worden geparameteriseerd, zoals een
WHERE-component. Als de methode wordt weergegeven in een context waarin de argumenten niet worden geparameteriseerd, wordt de rest van de instructie geparameteriseerd. - Statements binnen een T-SQL-cursor. (
SELECTinstructies in API-cursors worden met parameters ingesteld.) - Verouderde queryconstructies.
- Elke instructie die wordt uitgevoerd in de context van
ANSI_PADDINGofANSI_NULLSingesteld opOFF. - Instructies die meer dan 2097 letterlijke waarden bevatten die in aanmerking komen voor parameterisatie.
- Verklaringen die verwijzen naar variabelen, zoals
WHERE T.col2 >= @bb. - Uitspraken die de
RECOMPILEquery hint bevatten. - Verklaringen die een
COMPUTE-clausule bevatten. - Verklaringen die een
WHERE CURRENT OF-clausule bevatten.
De volgende queryclausules zijn niet geparametriseerd. In deze gevallen worden alleen de clausules niet geparameteriseerd. Andere componenten binnen dezelfde query kunnen in aanmerking komen voor geforceerde parameterisatie.
- De
<select_list>van elkeSELECT-instructie. Deze lijst bevatSELECTlijsten van subqueries enSELECTlijsten binnenINSERTstatements. - Subquery
SELECTinstructies die in eenIF-instructie worden weergegeven. - De
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOofwelFOR XMLclausules van een query. - Argumenten, direct of als subexpressies, naar
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXML, of eenFULLTEXT-operator. - Het patroon en escape-teken argumenten van een
LIKE-clausule. - Het stijlargument van een
CONVERT-clausule. - Constanten binnen een
IDENTITY-clausule. - Constanten die zijn opgegeven met behulp van de syntaxis van de ODBC-extensie.
- Constant vouwbare expressies die argumenten zijn van de operatoren
+,-,*,/en%. Bij het overwegen van geschiktheid voor geforceerde parameterisering beschouwt de Database Engine een expressie als constant-foldable wanneer een van de volgende voorwaarden waar is:- Er worden geen kolommen, variabelen of subquery's weergegeven in de expressie.
- De expressie bevat een
CASE-clausule.
- Argumenten voor queryhint-clausules, waaronder het argument number_of_rows van de
FASTquery hint, het argument number_of_processors van deMAXDOPquery hint en het argument number van deMAXRECURSIONquery hint.
Parametrisatie vindt plaats op het niveau van individuele T-SQL-instructies. Met andere woorden, afzonderlijke instructies in een batch worden geparameteriseerd. Na het compileren wordt een geparametriseerde query uitgevoerd in de context van de batch waarin deze oorspronkelijk is ingediend. Als een uitvoeringsplan voor een query is gecachet, kun je bepalen of de query geparametriseerd is door te verwijzen naar de sql kolom van de sys.syscacheobjects dynamische beheerweergave. Als een query wordt geparametriseerd, komen de namen en datatypes van parameters vóór de tekst van de ingediende batch in deze kolom, zoals (@1 TINYINT).
Notitie
Parameternamen zijn willekeurig. Gebruikers of applicaties zouden niet afhankelijk moeten zijn van een bepaalde naamvolgorde. Ook kunnen de volgende items wisselen tussen versies van SQL Server en cumulatieve update (CU) upgrades: parameternamen, de keuze van literals die geparametriseerd zijn, en de spatiëring in de geparametriseerde tekst.
Gegevenstypen van parameters
Wanneer de Database Engine literals parametriseert, worden de parameters omgezet naar de volgende datatypen:
- Gehele literalen waarvan de grootte anders binnen het int-datatype zou passen, parametriseren naar int. Grotere gehele literalen die delen zijn van predicaten die een vergelijkingsoperator bevatten (inclusief
<,<=,=,!=,>,ANY<>ALLBETWEEN!>!<SOME>=enIN) parametriëren naar numeric(38,0). Grotere literalen die geen deel uitmaken van predicaten met vergelijkingsoperatoren worden geparametriseerd als numeric waarvan de precisie net groot genoeg is om de grootte te ondersteunen en waarvan de schaal 0 is. - Fixed-point numerieke literalen die deel uitmaken van predicaten met vergelijkingsoperatoren, parametriseren naar numeriek met een precisie van 38 en een schaal die net groot genoeg is om de grootte te ondersteunen. Fixed-point numerieke literalen die geen deel uitmaken van predicaten met vergelijkingsoperatoren parameteriseren naar numeric, waarvan de precisie en schaal net groot genoeg zijn om de grootte te ondersteunen.
- Numerieke letterlijke constanten met drijvende komma parametriseren naar float(53).
- Niet-Unicode stringliterals worden als varchar(8000) geparametriseerd als de literal binnen 8.000 tekens past, en als deze groter is dan 8.000 tekens als varchar(max).
- Unicode-stringliterals parametriseren naar nvarchar(4000) als de literal binnen 4.000 Unicode-tekens past, en tot nvarchar(max) als de literal groter is dan 4.000 tekens.
- Binaire literalen parametriseren naar varbinary(8000) als de binaire letteraal binnen 8.000 bytes past. Als het groter is dan 8.000 bytes, wordt het omgezet naar varbinary(max).
- Geldliteralen worden geparametriseerd naar geld.
Richtlijnen voor het gebruik van geforceerde parameters
Houd de volgende punten in overweging wanneer je de PARAMETERIZATION optie op FORCEDzet:
- Gedwongen parametrisatie verandert de literale constanten in een query in parameters bij het compileren van een query. Daarom kan de Query Optimizer suboptimale plannen voor query's kiezen. Met name de Query Optimizer is minder geneigd de query te koppelen aan een geïndexeerde weergave of een index op een berekende kolom. Het kan ook suboptimale plannen kiezen voor query's die zijn geplaatst op gepartitioneerde tabellen en gedistribueerde gepartitioneerde weergaven. Gebruik geen gedwongen parameterisatie voor omgevingen die sterk afhankelijk zijn van geïndexeerde weergaven en indexen op berekende kolommen. Over het algemeen zouden alleen ervaren databaseprofessionals de
PARAMETERIZATION FORCEDoptie moeten gebruiken nadat ze hebben vastgesteld dat het de prestaties niet nadelig beïnvloedt. - Gedistribueerde query's die verwijzen naar meer dan één database komen in aanmerking voor geforceerde parameterisatie, zolang de optie
PARAMETERIZATIONis ingesteld opFORCEDin de database waarvan de context van de query wordt uitgevoerd. - Door de
PARAMETERIZATIONoptie in te stellen opFORCED, worden alle queryplannen uit de plancache van een database verwijderd, behalve die welke momenteel worden gecompileerd, opnieuw gecompileerd of uitgevoerd. Queryplannen voor queries die compileren of draaien tijdens de instellingswijziging worden geparametriseerd bij de volgende uitvoering van de query. - Het instellen van de
PARAMETERIZATIONoptie is een online operatie die geen exclusieve sloten op databaseniveau vereist. - De huidige instelling van de optie
PARAMETERIZATIONblijft behouden bij het opnieuw verbinden of herstellen van een database.
Je kunt het gedrag van geforceerde parameterisatie overrulen door te specificeren dat eenvoudige parametrisatie op één enkele query moet worden geprobeerd, en op alle andere query's die syntactisch equivalent zijn maar alleen verschillen in hun parameterwaarden. U kunt daarentegen opgeven dat geforceerde parameterisatie wordt uitgevoerd op slechts een set syntactisch equivalente query's, zelfs als geforceerde parameterisatie is uitgeschakeld in de database. Gebruik plan guides hiervoor.
Notitie
Wanneer de optie PARAMETERIZATION is ingesteld op FORCED, kan het rapporteren van foutberichten verschillen van wanneer de optie PARAMETERIZATION is ingesteld op SIMPLE: er kunnen meerdere foutberichten worden gerapporteerd onder geforceerde parameterisatie, waarbij minder berichten worden gerapporteerd onder eenvoudige parameterisatie en de regelnummers waarin fouten optreden, onjuist kunnen worden gerapporteerd.
Wanneer geforceerde parameterisatie is ingeschakeld, kan eenvoudige parameterisatie nog steeds plaatsvinden. De volgende query kan bijvoorbeeld niet worden geparameteriseerd volgens de regels voor geforceerde parameters:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Het kan echter worden geparameteriseerd volgens eenvoudige parameterisatieregels. Wanneer geforceerde parameterisatie wordt geprobeerd, maar mislukt, wordt eenvoudige parameterisatie nog steeds geprobeerd.
SQL-instructies voorbereiden
De Database Engine ondersteunt het voorbereiden van T-SQL-statements vóór uitvoering. Als een applicatie een T-SQL-instructie meerdere keren moet uitvoeren, kan het de database-API gebruiken om:
- Bereid de verklaring één keer voor. Deze stap compileert de T-SQL-instructie tot een uitvoeringsplan.
- Voer het vooraf gecompileerde uitvoeringsplan uit elke keer dat de statement moet worden uitgevoerd. Deze aanpak voorkomt dat de T-SQL-instructie bij elke uitvoering na de eerste keer opnieuw wordt gecompileerd. Het voorbereiden en uitvoeren van instructies wordt beheerd door API-functies en -methoden. De SQL Server Native Client OLE DB Provider en de SQL Server Native Client ODBC-driver ondersteunen het prepare/execute-model van het uitvoeren van T-SQL-instructies. Bij een voorbereidingsaanvraag verzendt de provider of het stuurprogramma de instructie naar SQL Server met een aanvraag om de instructie voor te bereiden. De Database Engine compileert een uitvoeringsplan en geeft een handle voor dat plan terug aan de provider of driver. Bij een uitvoeringsaanvraag verzendt de provider of het stuurprogramma de server een aanvraag om het plan uit te voeren dat aan de ingang is gekoppeld.
Prepared statements kunnen geen tijdelijke objecten maken in de Database Engine. Voorbereide instructies kunnen niet verwijzen naar door het systeem opgeslagen procedures die tijdelijke objecten maken, zoals tijdelijke tabellen. Deze procedures moeten rechtstreeks worden uitgevoerd.
Overmatig gebruik van het prepare/execute-model kan de prestaties verslechteren. Als een instructie slechts één keer wordt uitgevoerd, vereist directe uitvoering slechts één keer heen en weer over het netwerk naar de server. Het voorbereiden en uitvoeren van een T-SQL-instructie die slechts één keer wordt uitgevoerd, vereist een extra netwerk-heen-terugreis: één trip om de statement voor te bereiden en één trip om deze uit te voeren.
Het voorbereiden van een statement is effectiever als je parametermarkers gebruikt. Stel dat een toepassing af en toe wordt gevraagd productgegevens op te halen uit de AdventureWorksLT2025 voorbeelddatabase. Er zijn twee manieren waarop de applicatie deze taak kan uitvoeren.
Door de eerste aanpak te gebruiken, kan de applicatie een aparte query uitvoeren voor elk gevraagd product:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Met de tweede benadering voert de applicatie de volgende bewerkingen uit:
Bereidt een statement voor dat een parametermarkering bevat (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Hiermee wordt een programmavariabele gebonden aan de parametermarkering.
Telkens wanneer productgegevens nodig zijn, vult u de afhankelijke variabele met de sleutelwaarde en voert u de instructie uit.
De tweede benadering is efficiënter als de instructie meer dan drie keer wordt uitgevoerd.
In de Database Engine heeft het prepare/execute-model geen significant prestatievoordeel ten opzichte van directe uitvoering, vanwege de manier waarop de Database Engine uitvoeringsplannen hergebruikt. De Database Engine heeft efficiënte algoritmen om de huidige T-SQL-instructie te koppelen aan uitvoeringsplannen die zijn gegenereerd voor eerdere uitvoeringen van dezelfde T-SQL-instructie. Als een applicatie een T-SQL-instructie met parametermarkers meerdere keren uitvoert, hergebruikt de Database Engine het uitvoeringsplan van de eerste uitvoering voor de tweede en daaropvolgende uitvoeringen (tenzij het plan uit de plancache verdwijnt). Het prepare/execute-model heeft nog steeds de volgende voordelen:
- Het vinden van een query-uitvoeringsplan via een identificerende ingang is efficiënter dan de algoritmen die een T-SQL-instructie koppelen aan bestaande query-uitvoeringsplannen.
- De applicatie kan bepalen wanneer het uitvoeringsplan wordt gemaakt en wanneer het wordt hergebruikt.
- Het prepare/execute-model is overdraagbaar naar andere databases, waaronder eerdere versies van SQL Server.
Parametergevoeligheid
Parametergevoeligheid, ook wel parameter sniffing genoemd, verwijst naar een proces waarbij de Database Engine de huidige parameterwaarden tijdens compilatie of hercompilatie snift, en deze doorgeeft aan de Query Optimizer om mogelijk efficiëntere query-uitvoeringsplannen te genereren.
Parameterwaarden worden gelezen tijdens de compilatie of hercompilatie voor de volgende typen batches:
- Opgeslagen procedures
- Queries die worden ingediend via
sp_executesql - Voorbereide queries
Voor meer informatie over het oplossen van parameter-sniffingproblemen, zie:
- parametergevoelige problemen onderzoeken en oplossen
- Gebruik expliciete parameters voor hergebruik van het plan
- optimalisatie van parametergevoelig plan
- Het oplossen van problemen met parametergevoelige query-uitvoeringsplannen in Azure SQL Database
- Problemen met parametergevoelige query-uitvoeringsplan oplossen in Azure SQL Managed Instance
Wanneer een query in de Database Engine de OPTION (RECOMPILE) hint gebruikt, zet de Query Optimizer parameter- en lokale variabelen om in constanten tijdens het compileren die door constant folding kunnen worden vereenvoudigd tot literalen. Tijdens de compilatie kent de optimizer en kan hij de huidige runtimewaarden van parameters en lokale variabelen gebruiken zoals die direct voorafgaand aan die instructie bestaan. De OPTION (RECOMPILE) hint stelt de optimizer in staat een meer optimaal queryplan te genereren dat is afgestemd op de specifieke waarden en optimaal gebruik te maken van de beste onderliggende indexen tijdens runtime. Voor parameters verwijst dit proces niet naar de waarden die oorspronkelijk zijn doorgegeven aan de batch of opgeslagen procedure, maar naar hun waarden op het moment van hercompilatie. Deze waarden kunnen binnen de procedure worden aangepast voordat de instructie die RECOMPILE bevat wordt bereikt. Dit gedrag kan de prestaties verbeteren voor queries met sterk variabele of scheve invoergegevens, maar de query moet dan wel elke keer worden gecompileerd wanneer deze wordt uitgevoerd. Deze kost kan hoog zijn. Vermijd het gebruik van de RECOMPILE hint zonder de impact ervan op de totale werklast te beoordelen.
Lokale variabelen en kardinaliteitsschattingen
Wanneer een query lokale variabelen gebruikt, kan de Database Engine hun waarden niet sniffen tijdens compilatie, dus schat hij de kardinaliteit met beschikbare statistieken of heuristieken. Als er statistieken bestaan, wordt doorgaans de alledichtheidswaarde (ook wel gemiddelde dichtheid genoemd) uit het statistische histogram gebruikt om een schatting te maken van het aantal rijen dat overeenkomt met het predicaat. Als er echter geen statistieken beschikbaar zijn voor de kolom, valt de Database Engine terug op heuristische schattingen, zoals het aannemen van 10% selectiviteit voor gelijkheidspredicaten en 30% voor ongelijkheden en bereikspredicaten. Deze schattingen kunnen leiden tot minder nauwkeurige uitvoeringsplannen. Hier volgt een voorbeeld van een query die gebruikmaakt van een lokale variabele.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
In dit geval gebruikt de Database Engine de waarde 100 niet om de query te optimaliseren. Er wordt een algemene schatting gebruikt.
Parallelle queryverwerking
De Database Engine biedt parallelle queries om de query-uitvoering en indexoperaties te optimaliseren voor computers die meer dan één microprocessor (CPU) hebben. Omdat de Database Engine een query- of indexbewerking parallel kan uitvoeren met behulp van meerdere werkerthreads van het besturingssysteem, wordt de bewerking snel en efficiënt afgerond.
Tijdens queryoptimalisatie zoekt de Database Engine naar queries of indexoperaties die baat kunnen hebben bij parallelle uitvoering. Voor deze queries voegt de Database Engine exchange-operatoren in in het query-uitvoeringsplan om de query voor te bereiden op parallelle uitvoering. Een exchange-operator is een operator in een queryuitvoeringsplan dat procesbeheer, herdistributie van gegevens en stroombeheer biedt. De exchange-operator bevat de Distribute Streams, Repartition Streamsen Gather Streams logische operatoren als subtypen, waarvan een of meer kunnen worden weergegeven in de Showplan-uitvoer van een queryplan voor een parallelle query.
Belangrijk
Bepaalde constructies belemmeren het vermogen van de Database Engine om parallelisme te gebruiken op het gehele uitvoeringsplan, of delen daarvan.
Constructies die parallellisme remmen, zijn onder andere:
| Bouwen | Beschrijving |
|---|---|
| Scalaire UDFs | Voor meer informatie over scalaire, door de gebruiker gedefinieerde functies, zie Door de gebruiker gedefinieerde functies maken. Vanaf SQL Server 2019 (15.x) kan de SQL Server Database Engine deze functies inlijnen en het gebruik van parallelisme tijdens queryverwerking mogelijk maken. Voor meer informatie over scalar UDF-inlining, zie Intelligente queryverwerking in SQL-databases. |
| Externe Query | Voor meer informatie over Remote Query, zie Naslaginformatie voor logische en fysieke showplan-operatoren. |
| dynamische cursors | Voor meer informatie over cursors, zie DECLARE CURSOR. |
| recursieve queries | Voor meer informatie over recursie, zie Richtlijnen voor het definiëren en gebruiken van recursieve algemene tabelexpressies en Recursie in T-SQL. |
| Multi-statement tabelwaardefuncties (MSTVF's) | Voor meer informatie over MSTVF's, zie Door de gebruiker gedefinieerde functies maken (Database Engine). |
TOP trefwoord |
Zie TOP voor meer informatie. |
Een queryuitvoeringsplan kan het kenmerk NonParallelPlanReason bevatten in het element QueryPlan, waarin wordt beschreven waarom parallellisme niet is gebruikt. Waarden voor dit kenmerk zijn:
| NonParallelPlanReden-waarde | Beschrijving |
|---|---|
MaxDOPSetToOne |
Maximale mate van parallelisme ingesteld op 1. |
EstimatedDOPIsOne |
De geschatte mate van parallelisme is 1. |
NoParallelWithRemoteQuery |
Parallellisme wordt niet ondersteund voor externe query's. |
NoParallelDynamicCursor |
Parallelle plannen worden niet ondersteund voor dynamische cursors. |
NoParallelFastForwardCursor |
Parallelle plannen worden niet ondersteund voor snelle cursors. |
NoParallelCursorFetchByBookmark |
Parallelle plannen worden niet ondersteund voor cursors die via bladwijzer worden opgehaald. |
NoParallelCreateIndexInNonEnterpriseEdition |
Het maken van parallelle indexen wordt niet ondersteund voor een niet-Enterprise-editie. |
NoParallelPlansInDesktopOrExpressEdition |
Parallel plannen worden niet ondersteund voor Desktop- en Express-editie. |
NonParallelizableIntrinsicFunction |
Query verwijst naar een niet-parallelle, intrinsieke functie. |
CLRUserDefinedFunctionRequiresDataAccess |
Parallellisme wordt niet ondersteund voor een CLR UDF waarvoor gegevenstoegang is vereist. |
TSQLUserDefinedFunctionsNotParallelizable |
Query verwijst naar een door de gebruiker gedefinieerde T-SQL-functie die niet parallelliseerbaar was. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Transacties met tabelvariabelen bieden geen ondersteuning voor parallelle geneste transacties. |
DMLQueryReturnsOutputToClient |
De DML-query retourneert uitvoer naar de client en kan niet parallell worden uitgevoerd. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
Niet-ondersteunde combinatie van seriële en parallelle plannen voor één online indexopbouw. |
CouldNotGenerateValidParallelPlan |
Verificatie van het parallelle plan mislukt, teruggeschakeld naar serieel. |
NoParallelForMemoryOptimizedTables |
Parallellisme wordt niet ondersteund voor de In-Memory OLTP-tabellen waarnaar wordt verwezen. |
NoParallelForDmlOnMemoryOptimizedTable |
Parallellisme wordt niet ondersteund voor DML op een In-Memory OLTP-tabel. |
NoParallelForNativelyCompiledModule |
Parallellisme wordt niet ondersteund voor systeemeigen gecompileerde modules waarnaar wordt verwezen. |
NoRangesResumableCreate |
Het genereren van het operationele bereik is mislukt voor een hervatbare maakbewerking. |
Nadat exchange-operators zijn ingevoegd, is het resultaat een uitvoeringsplan voor parallelle query's. Een parallelle-queryuitvoeringsplan kan meer dan één worker thread gebruiken. Een serieel uitvoeringsplan, dat wordt gebruikt door een niet-parallelle (seriële) query, gebruikt slechts één werkrolthread voor de uitvoering ervan. Het werkelijke aantal worker threads dat door een parallelle query wordt gebruikt, wordt bepaald bij de initialisatie van de uitvoering van het queryplan en hangt af van de complexiteit van het plan en de mate van parallelisme.
De mate van parallelisme (DOP) specificeert het maximale aantal processors dat kan worden gebruikt om een parallelle taak uit te voeren. DOP geeft niet het totale aantal workerthreads aan dat door een query wordt gebruikt. De DOP-limiet wordt ingesteld per taak. Het is niet per aanvraag of per query limiet. Dit betekent dat tijdens een parallelle uitvoering van een query één aanvraag meerdere taken kan uitvoeren die zijn toegewezen aan een scheduler-. Meer processors dan gespecificeerd door de MAXDOP kunnen gelijktijdig worden gebruikt op elk moment van query-uitvoering, wanneer verschillende taken gelijktijdig worden uitgevoerd. Zie de handleiding Thread en taakarchitectuurvoor meer informatie.
De Query Optimizer gebruikt geen parallel uitvoeringsplan voor een query als een van de volgende voorwaarden waar is:
Het seriële uitvoeringsplan is triviaal, of overschrijdt de kostendrempel voor het instellen van parallelisme niet.
Het seriële uitvoeringsplan heeft een lagere totale geschatte substructuurkosten dan elk parallel uitvoeringsplan dat door de optimizer is verkend.
De query bevat scalaire of relationele operators die niet parallel kunnen worden uitgevoerd. Bepaalde operators kunnen ertoe leiden dat een sectie van het queryplan in seriële modus wordt uitgevoerd of dat het hele plan in seriële modus wordt uitgevoerd.
Notitie
De totale geschatte substructuurkosten van een parallel plan kunnen lager zijn dan de drempelwaarde voor parallelle uitvoering. Met andere woorden, de totale geschatte subboomkosten van het seriële plan overschreden dit, en het queryplan met de lagere totale ramte subboomkosten werd gekozen.
Mate van parallelisme (DOP)
De Database Engine detecteert automatisch de beste mate van parallelisme voor elke instantie van een parallelle query-uitvoering of indexbewerking in de data definition language (DDL). Deze waarde wordt bepaald op basis van de volgende criteria:
Of SQL Server wordt uitgevoerd op een computer met meer dan één microprocessor of CPU-, zoals een symmetrische multiprocessingcomputer (SMP). Alleen computers met meer dan één CPU kunnen parallelle query's gebruiken.
Of voldoende werkrolthreads beschikbaar zijn. Voor elke query- of indexbewerking is een bepaald aantal worker threads nodig om uit te voeren. Voor het uitvoeren van een parallel plan zijn meer werkthreads nodig dan een serieel plan, en het aantal vereiste werkthreads neemt toe met de mate van parallelle uitvoering. Wanneer aan de worker thread-eis van het parallelle plan voor een specifieke graad van parallelisme niet kan worden voldaan, verlaagt de SQL Server Database Engine automatisch de graad van parallelisme, of voert het parallelle plan serieel uit.
Het -type query- of indexbewerking werd uitgevoerd. Indexbewerkingen die een index maken of herbouwen, of een geclusterde index verwijderen en query's die cpu-cycli gebruiken, zijn de beste kandidaten voor een parallel plan. Samenvoegingen van grote tabellen, grote aggregaties en sortering van grote resultatensets zijn bijvoorbeeld goede kandidaten. Basisqueries, vaak te vinden in transactieverwerkingsapplicaties, merken dat de extra coördinatie die nodig is om een query parallel uit te voeren zwaarder weegt dan de potentiële prestatieverbetering. Om onderscheid te maken tussen query's die profiteren van parallelle uitvoering en query's die geen voordeel hebben, vergelijkt de SQL Server Database Engine de geschatte kosten voor het uitvoeren van de query- of indexbewerking met de kostendrempel voor parallellisme waarde. Gebruikers kunnen de standaardwaarde van
5wijzigen door sp_configure te gebruiken als goed testen aantoont dat een andere waarde beter geschikt is voor de lopende werklast.Of er voldoende rijen zijn omte verwerken. Als de queryoptimalisatie bepaalt dat het aantal rijen te laag is, worden exchange-operators niet geïntroduceerd om de rijen te distribueren. De operatoren worden dus serieel uitgevoerd. Het uitvoeren van de operators in een serieel plan voorkomt scenario's wanneer de opstart-, distributie- en coördinatiekosten de winsten overschrijden die worden bereikt door parallelle uitvoering van operatoren.
Of huidige statistieken beschikbaar zijn. Als de hoogste mate van parallelle uitvoering niet mogelijk is, worden lagere graden overwogen voordat het parallelle plan wordt verlaten. Bijvoorbeeld, wanneer je een geclusterde index op een view aanmaakt, kunnen statistieken niet worden geëvalueerd, omdat de geclusterde index nog niet bestaat. In dit geval kan de SQL Server Database Engine niet de hoogste mate van parallelle uitvoering bieden voor de indexbewerking. Sommige operators, zoals sorteren en scannen, kunnen echter nog steeds profiteren van parallelle uitvoering.
Notitie
Parallelle indexbewerkingen zijn alleen beschikbaar in sql Server Enterprise-, Developer- en Evaluation-edities.
Tijdens de uitvoering bepaalt de SQL Server Database Engine of de huidige systeemworkload en configuratiegegevens die eerder zijn beschreven, parallelle uitvoering mogelijk maken. Als parallel uitvoering gerechtvaardigd is, bepaalt de SQL Server Database Engine het optimale aantal werkthreads en verspreidt de uitvoering van het parallelle plan over deze werkthreads. Wanneer een query- of indexbewerking wordt uitgevoerd op meerdere werkthreads voor parallelle uitvoering, wordt hetzelfde aantal werkthreads gebruikt totdat de bewerking is voltooid. De SQL Server Database Engine heroverweegt het optimale aantal worker thread beslissingen telkens wanneer een uitvoeringsplan wordt opgehaald uit plancache. Zo kan één uitvoering van een gecacht, parallel plan serieel worden uitgevoerd, een latere uitvoering van hetzelfde plan kan drie workerthreads gebruiken, en een derde uitvoering vier workerthreads.
De update- en verwijderoperators in een parallel queryuitvoeringsplan worden serieel uitgevoerd, maar de WHERE component van een UPDATE of een DELETE instructie kan parallel worden uitgevoerd. De werkelijke gegevenswijzigingen worden vervolgens serieel toegepast op de database.
Vanaf databasecompatibiliteitsniveau 110 kan de SELECT ... INTO instructie parallel worden uitgevoerd. Andere vormen van insert-operatoren werken op dezelfde manier als beschreven in eerdere versies.
Vanaf databasecompatibiliteitsniveau 130 kan de INSERT ... SELECT instructie parallel worden uitgevoerd bij het invoegen in heaps of geclusterde columnstore-indexen (CCI), en met behulp van de TABLOCK hint. Inserts in lokale tijdelijke tabellen (geïdentificeerd door het # prefix) en globale tijdelijke tabellen (geïdentificeerd door ## prefixen) zijn ook ingeschakeld voor parallelisme met behulp van de TABLOCK hint. Zie INSERT voor meer informatie.
Statische en sleutelsetgestuurde cursors kunnen worden gevuld door parallelle uitvoeringsplannen. Het gedrag van dynamische cursors kan echter alleen worden aangeboden door seriële uitvoering. Query Optimizer genereert altijd een serieel uitvoeringsplan voor een query die deel uitmaakt van een dynamische cursor.
Mate van parallelle uitvoering negeren
De mate van parallelle uitvoering stelt het aantal processors in dat moet worden gebruikt in parallelle uitvoering van het plan. Je kunt deze configuratie op verschillende niveaus instellen:
Serverniveau, door gebruik te maken van de maximale mate van parallelliteit (
MAXDOP) serverconfiguratie-optie.Van toepassing op: SQL Server
SQL Server 2019 (15.x) introduceerde automatische aanbevelingen voor het instellen van de
MAXDOPserverconfiguratie-optie tijdens het installatieproces. Met de gebruikersinterface van setup kunt u de aanbevolen instellingen accepteren of uw eigen waarde invoeren. Zie Database Engine Configuration - MaxDOP-paginavoor meer informatie.Workloadniveau, door gebruik te maken van de
MAX_DOPconfiguratieoptie voor de Resource Governor-workloadgroep.Van toepassing op: SQL Server
Databaseniveau, door gebruik te maken van de
MAXDOPdatabase-scoped configuratie.Van toepassing op: SQL Server, Azure SQL Database en Azure SQL Managed Instance
Op query- of indexinstructieniveau, door gebruik te maken van de
MAXDOPquery hint ofMAXDOPindex-optie. Je kunt bijvoorbeeld deMAXDOP-optie gebruiken om het aantal processors dat aan een online indexbewerking is toegewezen te regelen door dit te verhogen of te verlagen. Op deze manier kun je de middelen die door een indexoperatie worden gebruikt in balans brengen met die van de gelijktijdige gebruikers.Van toepassing op: SQL Server, Azure SQL Database en Azure SQL Managed Instance
Door de max degree of parallelism optie op 0 (standaard) te zetten, kan de Database Engine alle beschikbare processors gebruiken tot maximaal 64 processors in een parallelle planuitvoering. Hoewel de Database Engine een runtime-doel van 64 logische processors stelt wanneer de MAXDOP optie op 0staat, kun je indien nodig handmatig een andere waarde instellen. Door 0 voor query's en indexen in te stellen op MAXDOP, kan de Database Engine alle beschikbare processors tot maximaal 64 processors gebruiken voor de gegeven query's of indexen in een parallelle planuitvoering.
MAXDOP is geen verplichte waarde voor alle parallelle queries, maar eerder een voorlopig doel voor alle query's die in aanmerking komen voor parallelisme. Dit betekent dat als er tijdens runtime niet genoeg workerthreads beschikbaar zijn, een query mogelijk met een lagere mate van parallelisme kan worden uitgevoerd dan de MAXDOP serverconfiguratie-optie.
Aanbeveling
Voor meer informatie, zie MAXDOP-aanbevelingen voor richtlijnen voor het configureren van MAXDOP op server-, database-, query- of hintniveau.
Voorbeeld van parallelle query
De volgende query telt het aantal bestellingen dat in een specifiek kwartaal is geplaatst, beginnend op 1 april 2024, waarbij ten minste één orderregel van de bestelling later door de klant werd ontvangen dan de toegezegde datum. Deze query bevat het aantal van dergelijke orders gegroepeerd op elke volgordeprioriteit en gesorteerd in oplopende prioriteitsvolgorde.
In dit voorbeeld worden theoretische tabel- en kolomnamen gebruikt.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Stel dat de volgende indexen zijn gedefinieerd in de tabellen lineitem en orders:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Hier volgt een mogelijk parallel plan dat is gegenereerd voor de query die eerder werd weergegeven:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
De volgende illustratie toont een queryplan uitgevoerd met een mate van parallelisme gelijk aan 4 en met een twee-tabel join.
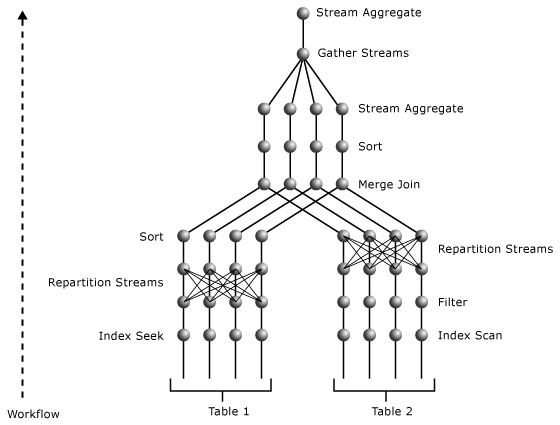
Het parallelle plan bevat drie parallellismeoperators. Zowel de operator Indexzoeken van de o_datkey_ptr-index als de indexscanoperator van de l_order_dates_idx-index worden parallel uitgevoerd. Dit proces produceert verschillende afzonderlijke stromen, die kunnen worden bepaald uit de dichtstbijzijnde Parallelisme-operatoren boven respectievelijk de Index Scan- en Index Seek-operatoren. Beide operatoren delen het uitwisselingstype opnieuw in. Ze herschikken data tussen de stromen en produceren hetzelfde aantal stromen op hun output als op hun input. Dit aantal streams is gelijk aan de mate van parallelle uitvoering.
De parallelisme-operator boven de l_order_dates_idx Index Scan-operator herpartitioneert zijn invoerstromen met de waarde van L_ORDERKEY als sleutel. Op deze manier eindigen dezelfde waarden van L_ORDERKEY in dezelfde uitvoerstroom. Tegelijkertijd behouden uitvoerstromen de volgorde op de L_ORDERKEY kolom om te voldoen aan de invoervereiste van de operator Samenvoegen.
De paralleliteitsoperator boven de Index Seek-operator herpartitioneert zijn invoerstromen met behulp van de waarde van O_ORDERKEY. Omdat de invoer niet gesorteerd is op de O_ORDERKEY kolomwaarden en deze kolom de join-kolom in de Merge Join operator is, zorgt de Sort-operator tussen de parallelisme- en Merge Join-operatoren ervoor dat de invoer gesorteerd is voor de Merge Join operator op de join-kolommen. De Sort-operator, net als de Merge Join-operator, wordt parallel uitgevoerd.
De bovenste parallelisme-operator verzamelt resultaten van verschillende stromen in één stroom. Gedeeltelijke aggregaties die worden uitgevoerd door de operator Stream Aggregate onder de operator parallellisme, worden vervolgens samengevoegd tot één SUM waarde voor elke verschillende waarde van de O_ORDERPRIORITY in de operator Stream Aggregate boven de operator parallellisme. Omdat dit plan twee uitwisselingssegmenten heeft, met een mate van parallelisme gelijk aan 4, gebruikt het acht workerthreads.
Voor meer informatie over de operatoren die in dit voorbeeld worden gebruikt, zie de referentie voor logische en fysieke showplan-operatoren.
Parallelle indexbewerkingen
Queryplannen voor indexoperaties die een index aanmaken of herbouwen, of een geclusterde index verwijderen, kunnen parallelle, multithreaded bewerkingen ondersteunen op computers met meerdere processors.
Notitie
Parallelle indexoperaties zijn alleen beschikbaar in de Enterprise-editie.
Database Engine gebruikt dezelfde algoritmen om de mate van parallelisme (het totale aantal afzonderlijke werkdraadjes die moeten draaien) voor indexbewerkingen te bepalen als voor andere queries. De maximale mate van parallelisme serverconfiguratieoptie stelt de maximale mate van parallelisme voor een indexoperatie vast. Je kunt de waarde max degree of parallelism voor individuele indexbewerkingen overschrijven door de indexoptie MAXDOP in de instructies ALTER INDEX, DROP INDEX, ALTER TABLE en CREATE INDEX in te stellen.
Wanneer de SQL Server Database Engine een indexuitvoeringsplan opstelt, wordt het aantal parallelle bewerkingen ingesteld op de laagste waarde uit deze waarden:
- Het aantal processors, of CPU's, in de computer.
- Het nummer dat is gespecificeerd in de
max degree of parallelismserverconfiguratie-optie. - Het aantal CPU's dat nog niet boven een drempel voor verricht werk komt voor SQL Server-workerthreads.
Bijvoorbeeld, op een computer met acht CPU's, maar waarbij max degree of parallelism is ingesteld op 6, gebruikt de indexoperatie niet meer dan zes parallelle workerthreads. Als vijf cpu's op de computer de drempelwaarde voor SQL Server-werk overschrijden wanneer een indexuitvoeringsplan is gebouwd, geeft het uitvoeringsplan slechts drie parallelle werkthreads op.
De belangrijkste fasen van een parallelle indexoperatie omvatten:
- Een coördinerende werkdraad scant de tabel snel en willekeurig om de verdeling van de indexsleutels in te schatten. De coördinerende workerthread stelt de sleutelgrenzen vast die een aantal sleutelbereiken creëren gelijk aan de mate van parallelle bewerkingen, waarbij elk sleutelbereik wordt geschat op een vergelijkbaar aantal rijen. Als er bijvoorbeeld vier miljoen rijen in de tabel zijn en de mate van parallelisme 4 is, bepaalt de coördinerende worker-thread de sleutelwaarden die vier sets rijen met 1 miljoen rijen per set afbakenen. Als de coördinerende workerthread niet genoeg sleutelbereiken kan instellen om alle CPU's te gebruiken, wordt de mate van parallelisme dienovereenkomstig verminderd.
- De coördinerende werkthread verzendt een aantal werkthreads dat overeenkomt met de mate van parallelle bewerkingen en wacht tot deze werkthreads klaar zijn met hun werk. Elke werkrolthread scant de basistabel met behulp van een filter waarmee alleen rijen worden opgehaald met sleutelwaarden binnen het bereik dat is toegewezen aan de werkrolthread. Elke workerthread bouwt een indexstructuur voor de rijen in zijn sleutelwaardenbereik. In het geval van een gepartitioneerde index bouwt elke worker-thread een opgegeven aantal partities. Partities worden niet gedeeld tussen de worker threads.
- Nadat alle parallelle worker-threads klaar zijn, verbindt de coördinerende worker-thread de indexsubunits tot één index. Deze fase is alleen van toepassing op offline indexbewerkingen.
Individuele CREATE TABLE of ALTER TABLE instructies kunnen meerdere beperkingen hebben die het aanmaken van een index vereisen. Deze bewerkingen voor het maken van meerdere indexen worden uitgevoerd in reeksen, hoewel elke afzonderlijke bewerking voor het maken van een index een parallelle bewerking kan zijn op een computer met meerdere CPU's.
Architectuur voor gedistribueerde query's
De Database Engine ondersteunt twee methoden om heterogene OLE DB-databronnen te refereren in T-SQL-instructies:
Namen van gekoppelde servers
Gebruik de systeemopgeslagen procedures
sp_addlinkedserverensp_addlinkedsrvloginom een servernaam aan een OLE DB-databron te geven. Je kunt in T-SQL-statements met vierdelige namen naar objecten in deze gekoppelde servers verwijzen. Als een gekoppelde servernaam vanDeptSQLSrvrbijvoorbeeld is gedefinieerd voor een ander exemplaar van SQL Server, verwijst de volgende instructie naar een tabel op die server:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Je kunt ook de gekoppelde servernaam in een
OPENQUERYinstructie specificeren om een rowset te openen vanuit de OLE DB-databron. Je kunt vervolgens net als naar een tabel naar deze rijset verwijzen in T-SQL-instructies.Ad-hoc connectornamen
Voor incidentele verwijzingen naar een databron, specificeer de
OPENROWSETofOPENDATASOURCEfuncties met de informatie die nodig is om verbinding te maken met de gekoppelde server. Je kunt dan naar de rijset verwijzen op dezelfde manier als je naar een tabel verwijst in T-SQL-instructies:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
De Database Engine gebruikt OLE DB om te communiceren tussen de relationele engine en de opslagengine. De relationele engine splitst elke T-SQL-instructie op in een reeks bewerkingen op eenvoudige OLE DB-rijsets die de opslagengine opent vanuit de basistabellen. Dit proces betekent dat de relationele engine ook basis OLE DB-rijsets kan openen op elke OLE DB-databron.
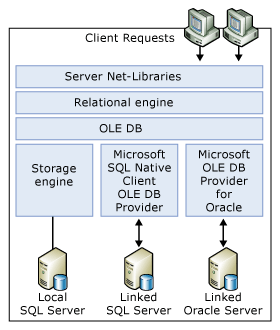
De relationele engine maakt gebruik van de OLE DB Application Programming Interface (API) om de rijensets op gekoppelde servers te openen, de rijen op te halen en transacties te beheren.
Voor elke OLE DB-databron die je als gekoppelde server gebruikt, moet de server die SQL Server draait een OLE DB-provider hebben. De verzameling T-SQL-bewerkingen die je kunt gebruiken tegen een specifieke OLE DB-databron hangt af van de mogelijkheden van de OLE DB-provider.
Voor elke instantie van SQL Server kunnen leden van de sysadmin fixed server-rol het gebruik van ad hoc connectornamen voor een OLE DB-provider in- of uitschakelen door gebruik te maken van de eigenschap DisallowAdhocAccess van SQL Server. Wanneer je ad hoc-toegang inschakelt, kan elke gebruiker die op die instantie is ingelogd T-SQL-instructies uitvoeren met ad hoc-connectornamen die verwijzen naar elke databron op het netwerk die de OLE DB-provider kan benaderen. Om de toegang tot databronnen te controleren, kunnen leden van de vaste serverrol sysadmin ad hoc-toegang voor die OLE DB-provider uitschakelen, waardoor gebruikers beperkt blijven tot alleen die databronnen waarnaar wordt verwezen door gekoppelde servernamen die door de beheerders zijn gedefinieerd. Ad-hoctoegang is standaard ingeschakeld voor de SQL Server OLE DB-provider en uitgeschakeld voor alle andere OLE DB-providers.
Gedistribueerde queries kunnen gebruikers in staat stellen toegang te krijgen tot een andere databron (bijvoorbeeld bestanden, niet-relationele databronnen zoals Active Directory, enzovoort) door gebruik te maken van de beveiligingscontext van het Windows-account waaronder de SQL Server-dienst draait. SQL Server neemt op passende wijze de identiteit van de login aan voor Windows-logins. Die impersonatie is echter niet mogelijk voor SQL Server-logins. Deze beperking kan een gebruiker van een gedistribueerde query mogelijk toestaan toegang te krijgen tot een andere databron waarvoor hij geen rechten heeft, maar het account waaronder de SQL Server-dienst draait heeft wel permissies. Gebruik sp_addlinkedsrvlogin om de specifieke aanmeldingen te definiëren die zijn geautoriseerd voor toegang tot de bijbehorende gekoppelde server. Deze controle is niet beschikbaar voor ad hoc namen, dus wees voorzichtig bij het inschakelen van een OLE DB-provider voor ad hoc toegang.
Waar mogelijk stuurt de Database Engine relationele bewerkingen zoals joins, beperkingen, projecties, sorts en GROUP BY-bewerkingen naar de OLE DB-databron. De Database Engine scant niet standaard de basistabel in SQL Server en voert de relationele bewerkingen zelf uit. De Database Engine vraagt de OLE DB-provider welk niveau van SQL-grammatica deze ondersteunt, en stuurt op basis van die informatie zoveel mogelijk relationele bewerkingen naar de provider.
De Database Engine specificeert een mechanisme waarmee een OLE DB-provider statistieken kan teruggeven die aangeven hoe sleutelwaarden binnen de OLE DB-databron zijn verdeeld. Dit mechanisme stelt de Database Engine Query Optimizer in staat om het datapatroon in de databron beter te analyseren aan de hand van de eisen van elke T-SQL-instructie, waardoor het vermogen van de Query Optimizer om optimale uitvoeringsplannen te genereren wordt vergroot.
Queryverwerking op gepartitioneerde tabellen en indexen
De Database Engine ondersteunt partitiebewuste queryverwerking voor gepartitioneerde tabellen en indexen. Deze sectie beschrijft hoe de queryprocessor omgaat met gepartitioneerde objecten, hoe uitvoeringsplannen met partitionering geïnterpreteerd moeten worden, en best practices om de queryprestaties op gepartitioneerde objecten te verbeteren.
Notitie
Gepartitioneerde tabellen en indexen worden ondersteund in de SQL Server Standard editie, beginnend met SQL Server 2016 (13.x) met Service Pack 1.
Nieuwe partitiebewuste zoekbewerking
In de Database Engine ziet de queryprocessor intern een gepartitioneerde tabel als een multikolomindex met PartitionID als leidende kolom.
PartitionID is een verborgen berekende kolom die intern wordt gebruikt om de ID van de partitie met een specifieke rij weer te geven. Stel bijvoorbeeld dat de tabel T, gedefinieerd als T(a, b, c), is gepartitioneerd op kolom a, en een geclusterde index heeft op kolom b. Deze gepartitioneerde tabel wordt behandeld als een niet-gepartitioneerde tabel met het schema T(PartitionID, a, b, c) en een geclusterde index op de samengestelde sleutel (PartitionID, b). Deze representatie stelt de Query Optimizer in staat om zoekoperaties uit te voeren op basis van PartitionID op elke gepartitioneerde tabel of index.
Partitie-verwijdering wordt nu uitgevoerd in deze zoekbewerking.
Daarnaast is de Query Optimizer zo uitgebreid dat een zoek- of scanbewerking met één voorwaarde kan worden uitgevoerd op PartitionID (als logische leidende kolom) en mogelijk andere indexsleutelkolommen. De queryprocessor voert vervolgens een tweede niveau zoekopdracht uit, met een andere voorwaarde, op één of meer extra kolommen, voor elke specifieke waarde die voldoet aan de kwalificatie voor de eerste niveau zoekoperatie. Deze operatie, een partitie-skip-scan genoemd, stelt de Query Optimizer in staat om een zoek- of scanoperatie uit te voeren op basis van één voorwaarde om te bepalen welke partities moeten worden benaderd, en een index-seek-operatie op tweede niveau binnen die operator om rijen uit deze partities te retourneren die aan een andere voorwaarde voldoen. Denk bijvoorbeeld aan de volgende query.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Voor dit voorbeeld wordt aangenomen dat tabel T, gedefinieerd als T(a, b, c), is gepartitioneerd op kolom a, en een geclusterde index heeft op kolom b. De volgende partitiefunctie definieert de partitiegrenzen voor de tabel T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Om de query op te lossen, voert de queryprocessor een zoekbewerking op het eerste niveau uit om te zoeken naar elke partitie die rijen bevat die voldoen aan de voorwaarde T.a < 10. Deze operatie identificeert de partities die moeten worden benaderd. Binnen elke geïdentificeerde partitie voert de processor vervolgens een tweede-niveau zoektocht uit in de geclusterde index op de kolom b om de rijen te vinden die aan de voorwaarde T.b = 2 en T.a < 10voldoen.
De volgende illustratie is een logische weergave van de partition skip scan-bewerking. Het toont tabel T met gegevens in kolommen a en b. De partities zijn genummerd 1 tot en met 4 met de partitiegrenzen die worden weergegeven door gestreepte verticale lijnen. Een zoekoperatie op het eerste niveau van de partities (niet getoond in de illustratie) bepaalt dat partities 1, 2 en 3 voldoen aan de zoekvoorwaarde die wordt geïmpliceerd door de opdeling gedefinieerd voor de tabel en het predikaat op kolom a (T.a < 10). Het pad dat door de seek op het tweede niveau wordt afgelegd, wordt geïllustreerd door de gebogen lijn. In wezen zoekt de operatie in elk van deze partities naar rijen die voldoen aan de voorwaarde b = 2. De totale kosten van de bewerking zijn gelijk aan die van drie afzonderlijke indexzoekacties.
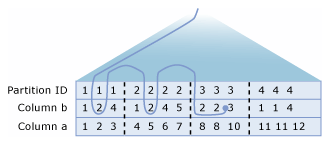
Partitioneringsgegevens weergeven in queryuitvoeringsplannen
Onderzoek de uitvoeringsplannen van query's op gepartitioneerde tabellen en indexen met behulp van de T-SQL-instructies SETSET SHOWPLAN_XML of SET STATISTICS XML, of met de grafische uitvoeringsplanuitvoer in SSMS. Je kunt bijvoorbeeld het uitvoeringsplan tijdens het compileren weergeven door Display Estimated Execution Plan te selecteren op de werkbalk van Power Query-editor en het runtimeplan door Include Actual Execution Plan te selecteren.
Door deze tools te gebruiken, kunt u de volgende informatie vinden:
- De bewerkingen zoals scans, seeks, inserts, updates, merges en deletes hebben toegang tot gepartitioneerde tabellen of indexen.
- De partities die worden geopend door de query. Run-time uitvoeringsplannen bevatten bijvoorbeeld het totale aantal geraadpleegde partities en de bereiken van aaneengesloten partities die worden geraadpleegd.
- Een partitie-skipscanbewerking wordt gebruikt in een zoek- of scanbewerking om gegevens op te halen uit een of meer partities.
Verbeteringen in partitiegegevens
De Database Engine biedt verbeterde partitioneringsinformatie voor zowel compileertijd- als runtime-uitvoeringsplannen. Uitvoeringsplannen bieden nu de volgende informatie:
- Een optioneel
Partitionedattribuut dat aangeeft dat een operator, zoals een seek, scan, insert, update, merge of delete, wordt uitgevoerd op een gepartitioneerde tabel. - Een nieuw
SeekPredicateNew-element met eenSeekKeyssubelement datPartitionIDbevat als de belangrijkste indexsleutelkolom en filtervoorwaarden waarmee het bereik wordt opgegeven opPartitionID. De aanwezigheid van tweeSeekKeyssubelementen duidt op een partitie-skip scan opPartitionID. - Samenvattende informatie die het totale aantal benaderde partities geeft. Deze informatie is alleen beschikbaar in runtime-abonnementen.
Bekijk de volgende query in de gepartitioneerde tabel fact_salesom te laten zien hoe deze informatie wordt weergegeven in zowel de uitvoer van het grafische uitvoeringsplan als de XML Showplan-uitvoer. Met deze query worden gegevens in twee partities bijgewerkt.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
In de volgende afbeelding ziet u de eigenschappen van de operator Clustered Index Seek in het runtime-uitvoeringsplan voor deze query. Om de definitie van de fact_sales tabel en de partitiedefinitie te bekijken, zie Voorbeeld.
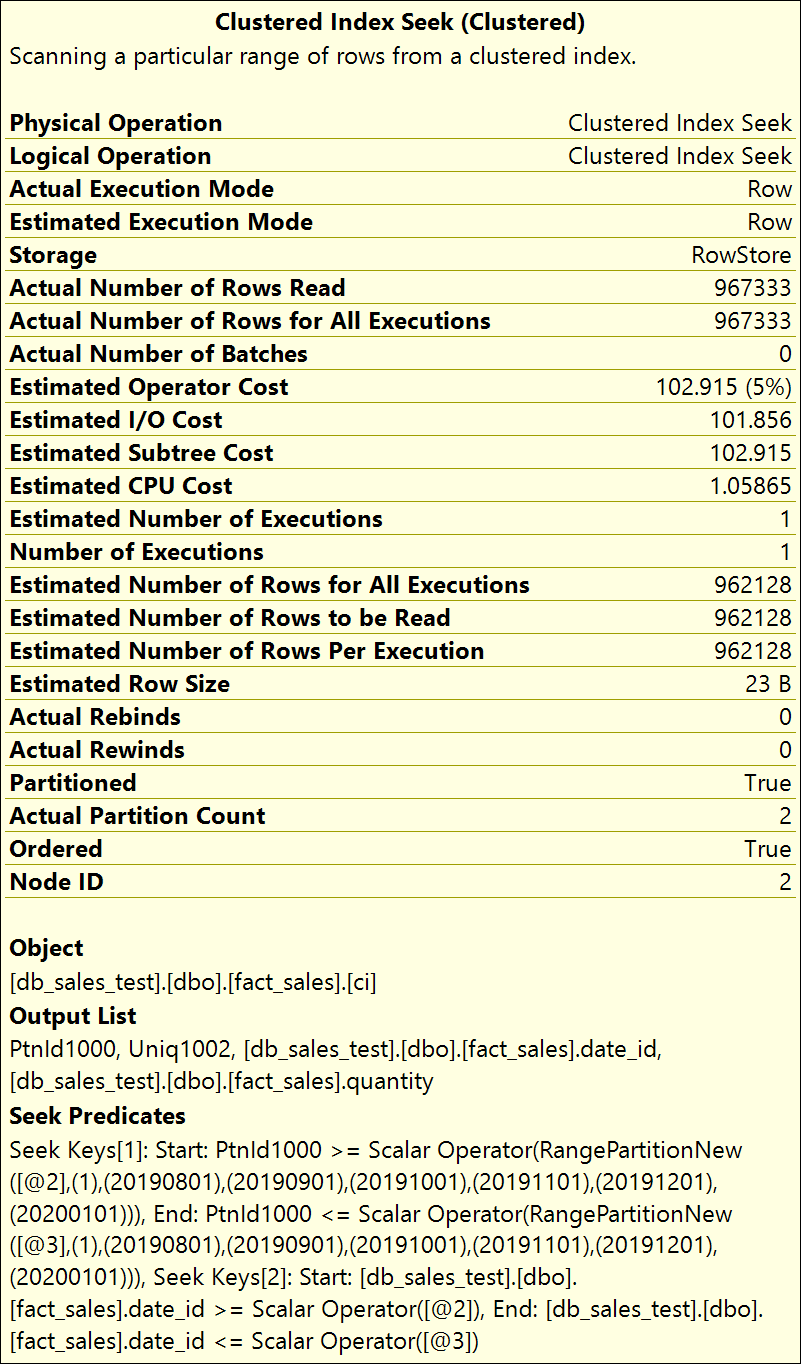
Gepartitioneerd kenmerk
Wanneer een operator zoals indexzoeken wordt uitgevoerd op een gepartitioneerde tabel of index, wordt het kenmerk Partitioned weergegeven in het compileer- en runtime-plan en wordt ingesteld op True (1). Het attribuut wordt niet weergegeven wanneer het op False (0) staat.
Het kenmerk Partitioned kan worden weergegeven in de volgende fysieke en logische operators:
- Tabelscan
- Indexscan
- Indexzoeken
- Invoegen
- Bijwerken
- Verwijderen
- Samenvoegen
Zoals getoond in de vorige illustratie, verschijnt dit attribuut in de eigenschappen van de operator waarin het is gedefinieerd. In de XML Showplan-uitvoer verschijnt dit attribuut als Partitioned="1" in de RelOp knoop van de operator waarin het is gedefinieerd.
Nieuw zoekpredicaat
In XML Showplan-uitvoer verschijnt het SeekPredicateNew element in de operator waarin het is gedefinieerd. Het kan maximaal twee exemplaren van het SeekKeys subelement bevatten. Het eerste SeekKeys item geeft de zoekbewerking op het eerste niveau op het partitie-id-niveau van de logische index aan. Dat wil zeggen, deze seek-bewerking bepaalt de partities die geraadpleegd moeten worden om aan de voorwaarden van de query te voldoen. Het tweede SeekKeys item specificeert de zoekbewerking op het tweede niveau die plaatsvindt binnen elke partitie die in de zoekbewerking op het eerste niveau is geïdentificeerd.
Samenvatting van partitie-informatie
In uitvoeringsplannen voor runtime biedt overzichtsinformatie over partities een telling van de partities die worden geopend en de identiteit van de werkelijke partities die worden geopend. U kunt deze informatie gebruiken om te controleren of de juiste partities worden geopend in de query en dat alle andere partities worden verwijderd uit overweging.
De volgende informatie wordt verstrekt: Actual Partition Counten Partitions Accessed.
Actual Partition Count is het totale aantal partities dat door de query wordt geopend.
Partitions Accessed, in XML Showplan-uitvoer, is de partitie-samenvattingsinformatie die verschijnt in het nieuwe RuntimePartitionSummary-element in het knooppunt RelOp van de operator waarin het is gedefinieerd. In het volgende voorbeeld ziet u de inhoud van het element RuntimePartitionSummary, waarmee wordt aangegeven dat er twee totale partities worden geopend (partities 2 en 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Geef partitie-informatie weer met andere showplan-methoden
De Showplan-methoden SHOWPLAN_ALL, SHOWPLAN_TEXTen STATISTICS PROFILE de partitiegegevens die in dit artikel worden beschreven, niet rapporteren, met de volgende uitzondering. Als onderdeel van het predicaat SEEK worden de te openen partities geïdentificeerd door een bereikpredicaat in de berekende kolom die de partitie-id vertegenwoordigt. In het volgende voorbeeld ziet u het predicaat SEEK voor een Clustered Index Seek operator. Partities 2 en 3 worden geopend en de zoekoperator filtert op de rijen die voldoen aan de voorwaarde date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpreteer uitvoeringsplannen voor gepartitioneerde heaps
Een gepartitioneerde heap wordt behandeld als een logische index op de partitie-ID. In een uitvoeringsplan wordt partitie-eliminatie op een gepartitioneerde heap weergegeven als een Table Scan operator met een SEEK predicaat op partitie-ID. In het volgende voorbeeld ziet u de weergegeven Showplan-informatie:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpreteer uitvoeringsplannen voor samengestelde samenvoegingen
Join collocation kan optreden wanneer twee tabellen worden gepartitioneerd met dezelfde of equivalente partitioneringsfunctie en de partitioneringskolommen van beide zijden van de join worden opgegeven in de joinvoorwaarde van de query. Query Optimizer kan een plan genereren waarbij de partities van elke tabel met gelijke partitie-id's afzonderlijk worden samengevoegd. Gecolloceerde joins kunnen sneller zijn dan niet-gecolloceerde joins, omdat ze mogelijk minder geheugen en verwerkingstijd vereisen. De Query Optimizer kiest een niet-gecolloceerd plan of een gecolloceerd plan op basis van kostenramingen.
In een gecolloceerd plan leest de Nested Loops join een of meer gekoppelde tabel- of indexpartities van de binnenzijde. De getallen binnen de Constant Scan operators vertegenwoordigen de partitienummers.
Wanneer parallelle plannen voor collocated joins worden gegenereerd voor gepartitioneerde tabellen of indexen, verschijnt er een Parallelism-operator tussen de Constant Scan- en de Nested Loops-join-operators. In dit geval leest en werkt elke werkthread aan de buitenzijde van de join op een verschillende partitie.
In de volgende afbeelding wordt een parallel queryplan voor een collocated join getoond.
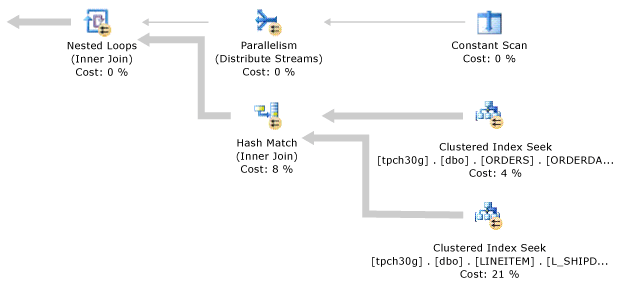
Strategie voor parallelle uitvoering van query's voor gepartitioneerde objecten
De queryprocessor maakt gebruik van een parallelle uitvoeringsstrategie voor query's die een selectie maken uit gepartitioneerde objecten. Als onderdeel van de uitvoeringsstrategie bepaalt de queryprocessor welke tabelpartities nodig zijn voor de query en de hoeveelheid werkthreads die aan elke partitie worden toegewezen. In de meeste gevallen wijst de query-processor een gelijk of bijna gelijk aantal werkthreads toe aan elke partitie en voert de query vervolgens parallel over de partities uit. In de volgende alinea's wordt de toewijzing van worker threads in meer detail uitgelegd.
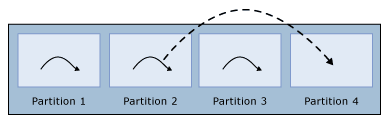
Als het aantal werkrolthreads kleiner is dan het aantal partities, wijst de queryprocessor elke werkrolthread toe aan een andere partitie, waardoor in eerste instantie een of meer partities zonder toegewezen werkrolthread worden achtergelaten. Wanneer een worker-thread klaar is met uitvoeren op een partitie, wijst de queryprocessor deze toe aan de volgende partitie totdat aan elke partitie één worker-thread is toegewezen. Deze toewijzing is het enige geval waarin de queryprocessor werkerthreads herverdeelt naar andere partities.
Toont dat de worker thread opnieuw is toegewezen nadat hij is voltooid. Als het aantal werkthreads gelijk is aan het aantal partities, kent de queryprocessor één werkthread toe aan elke partitie. Wanneer een werkdraad klaar is, wordt deze niet opnieuw ingedeeld in een andere partitie.
Als het aantal worker-threads groter is dan het aantal partities, wijst de queryprocessor een gelijk aantal worker-threads toe aan elke partitie. Als het aantal worker threads niet een exact veelvoud is van het aantal partities, wijst de queryprocessor één extra worker thread toe aan enkele partities om alle beschikbare worker threads te gebruiken. Als er maar één partitie is, worden alle worker-threads aan die partitie toegewezen. In het volgende diagram zijn er vier partities en 14 worker threads. Elke partitie heeft drie worker threads toegewezen, en twee partities hebben een extra worker thread, wat in totaal 14 worker thread toewijzingen oplevert. Wanneer een worker thread klaar is, wordt deze niet toegewezen aan een andere partitie.
Hoewel de voorgaande voorbeelden een eenvoudige manier suggereren om workerthreads toe te wijzen, is de daadwerkelijke strategie complexer en houdt rekening met andere variabelen die tijdens de query-uitvoering voorkomen. Als bijvoorbeeld de tabel gepartitioneerd is en een geclusterde index op de kolom A heeft en een query de predicaatclausule WHERE A IN (13, 17, 25)heeft, wijst de queryprocessor één of meer workerthreads toe aan elk van deze drie zoekwaarden (A = 13, A = 17, , en A = 25) in plaats van aan elke tabelpartitie. Het is alleen nodig om de query uit te voeren in de partities die deze waarden bevatten, en als al deze zoekpredicaten toevallig in dezelfde tabelpartitie zitten, worden alle workerthreads aan dezelfde tabelpartitie toegewezen.
Om een ander voorbeeld te nemen, stel dat de tabel vier partities heeft op een kolom A met randpunten (10, 20, 30), een index op kolom B, en de query een predicaatclausule WHERE B IN (50, 100, 150) heeft. Omdat de tabelpartities gebaseerd zijn op de waarden van A, kunnen de waarden van B voorkomen in elk van de tabelpartitities. De queryprocessor zoekt dus naar elk van de drie waarden van B (50, 100, 150) in elk van de vier tabelpartitities. De queryprocessor wijst workerthreads proportioneel toe zodat elk van deze 12 queryscans parallel kan worden uitgevoerd.
Tabelpartities gebaseerd op kolom A |
Zoekt naar kolom B in elke tabelpartitie |
|---|---|
Tabelpartitie 1: A < 10 |
B = 50
B = 100
B = 150
|
Tabelpartitie 2: A >= 10 AND A < 20 |
B = 50
B = 100
B = 150
|
Tabelpartitionering 3: A >= 20 AND A < 30 |
B = 50
B = 100
B = 150
|
Tabel Partition 4: A >= 30 |
B = 50
B = 100
B = 150
|
Beste werkwijzen
Om de prestaties van queries die toegang krijgen tot een grote hoeveelheid data uit grote gepartitioneerde tabellen en indexen te verbeteren, volg je deze best practices:
Streep elke partitie over veel schijven. Deze aanpak is vooral relevant bij het gebruik van draaiende schijven.
Gebruik indien mogelijk een server met voldoende hoofdgeheugen om vaak gebruikte partities of alle partities in het geheugen aan te passen om de I/O-kosten te verlagen.
Als de data die je opvraagt niet in het geheugen past, comprimer dan de tabellen en indexen om de I/O-kosten te verlagen.
Gebruik een server met snelle processors en zo veel processorkernen als u zich kunt veroorloven, om te profiteren van parallelle queryverwerkingsmogelijkheden.
Zorg ervoor dat de server voldoende I/O-controllerbandbreedte heeft.
Maak een geclusterde index op elke grote gepartitioneerde tabel om gebruik te maken van B-tree scanoptimalisaties.
Wanneer gegevens in bulk worden geladen in gepartitioneerde tabellen, volg dan de best practice-aanbevelingen in het whitepaper, The Data Loading Performance Guide.
Voorbeeld
In het volgende voorbeeld wordt een testdatabase gemaakt met één tabel met zeven partities. Om partitioneringsinformatie te bekijken voor zowel compile-time- en run-time-plannen, gebruik je de tools beschreven in Partitioneringsinformatie weergeven in query-uitvoeringsplannen bij het uitvoeren van de queries in dit voorbeeld.
Notitie
In dit voorbeeld worden meer dan 1 miljoen rijen in de tabel ingevoegd. Het uitvoeren van dit voorbeeld kan enkele minuten duren, afhankelijk van uw hardware. Controleer voordat u dit voorbeeld uitvoert of er meer dan 1,5 GB schijfruimte beschikbaar is.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Verwante inhoud
- Logische en fysieke showplan-operatorreferenties
- Overzicht van uitgebreide gebeurtenissen
- Aanbevolen procedures voor het bewaken van workloads met Query Store-
- Kardinaliteitschatting (SQL Server)
- Intelligent queryverwerking in SQL-databases
- Prioriteit van operator (Transact-SQL)
- Overzicht van uitvoeringsplan
- Performance Center voor SQL Server Database Engine en Azure SQL Database