Duplicaten en null-waarden oplossen
Problemen met gegevenskwaliteit, zoals dubbele records en null-waarden, kunnen uw analyse- en downstreamprocessen in gevaar komen. Ofwel duplicaten ontstaan als gevolg van gelijktijdige gegevensbelastingen, dan wel null-waarden verschijnen door onvolledige brongegevens, het aanpakken van deze problemen is een kernverantwoordelijkheid voor data engineers die in Azure Databricks werken.
In deze les leert u hoe u dubbele, ontbrekende en null-waarden kunt identificeren en oplossen met behulp van sql- en PySpark-benaderingen.
Dubbele records identificeren
Voordat u duplicaten kunt verwijderen, moet u deze vinden. Dubbele waarden treden meestal op wanneer dezelfde record meerdere keren in een tabel wordt weergegeven, vaak vanwege problemen met gegevensintegratie, herhaalde opname of gelijktijdige schrijfbewerkingen.
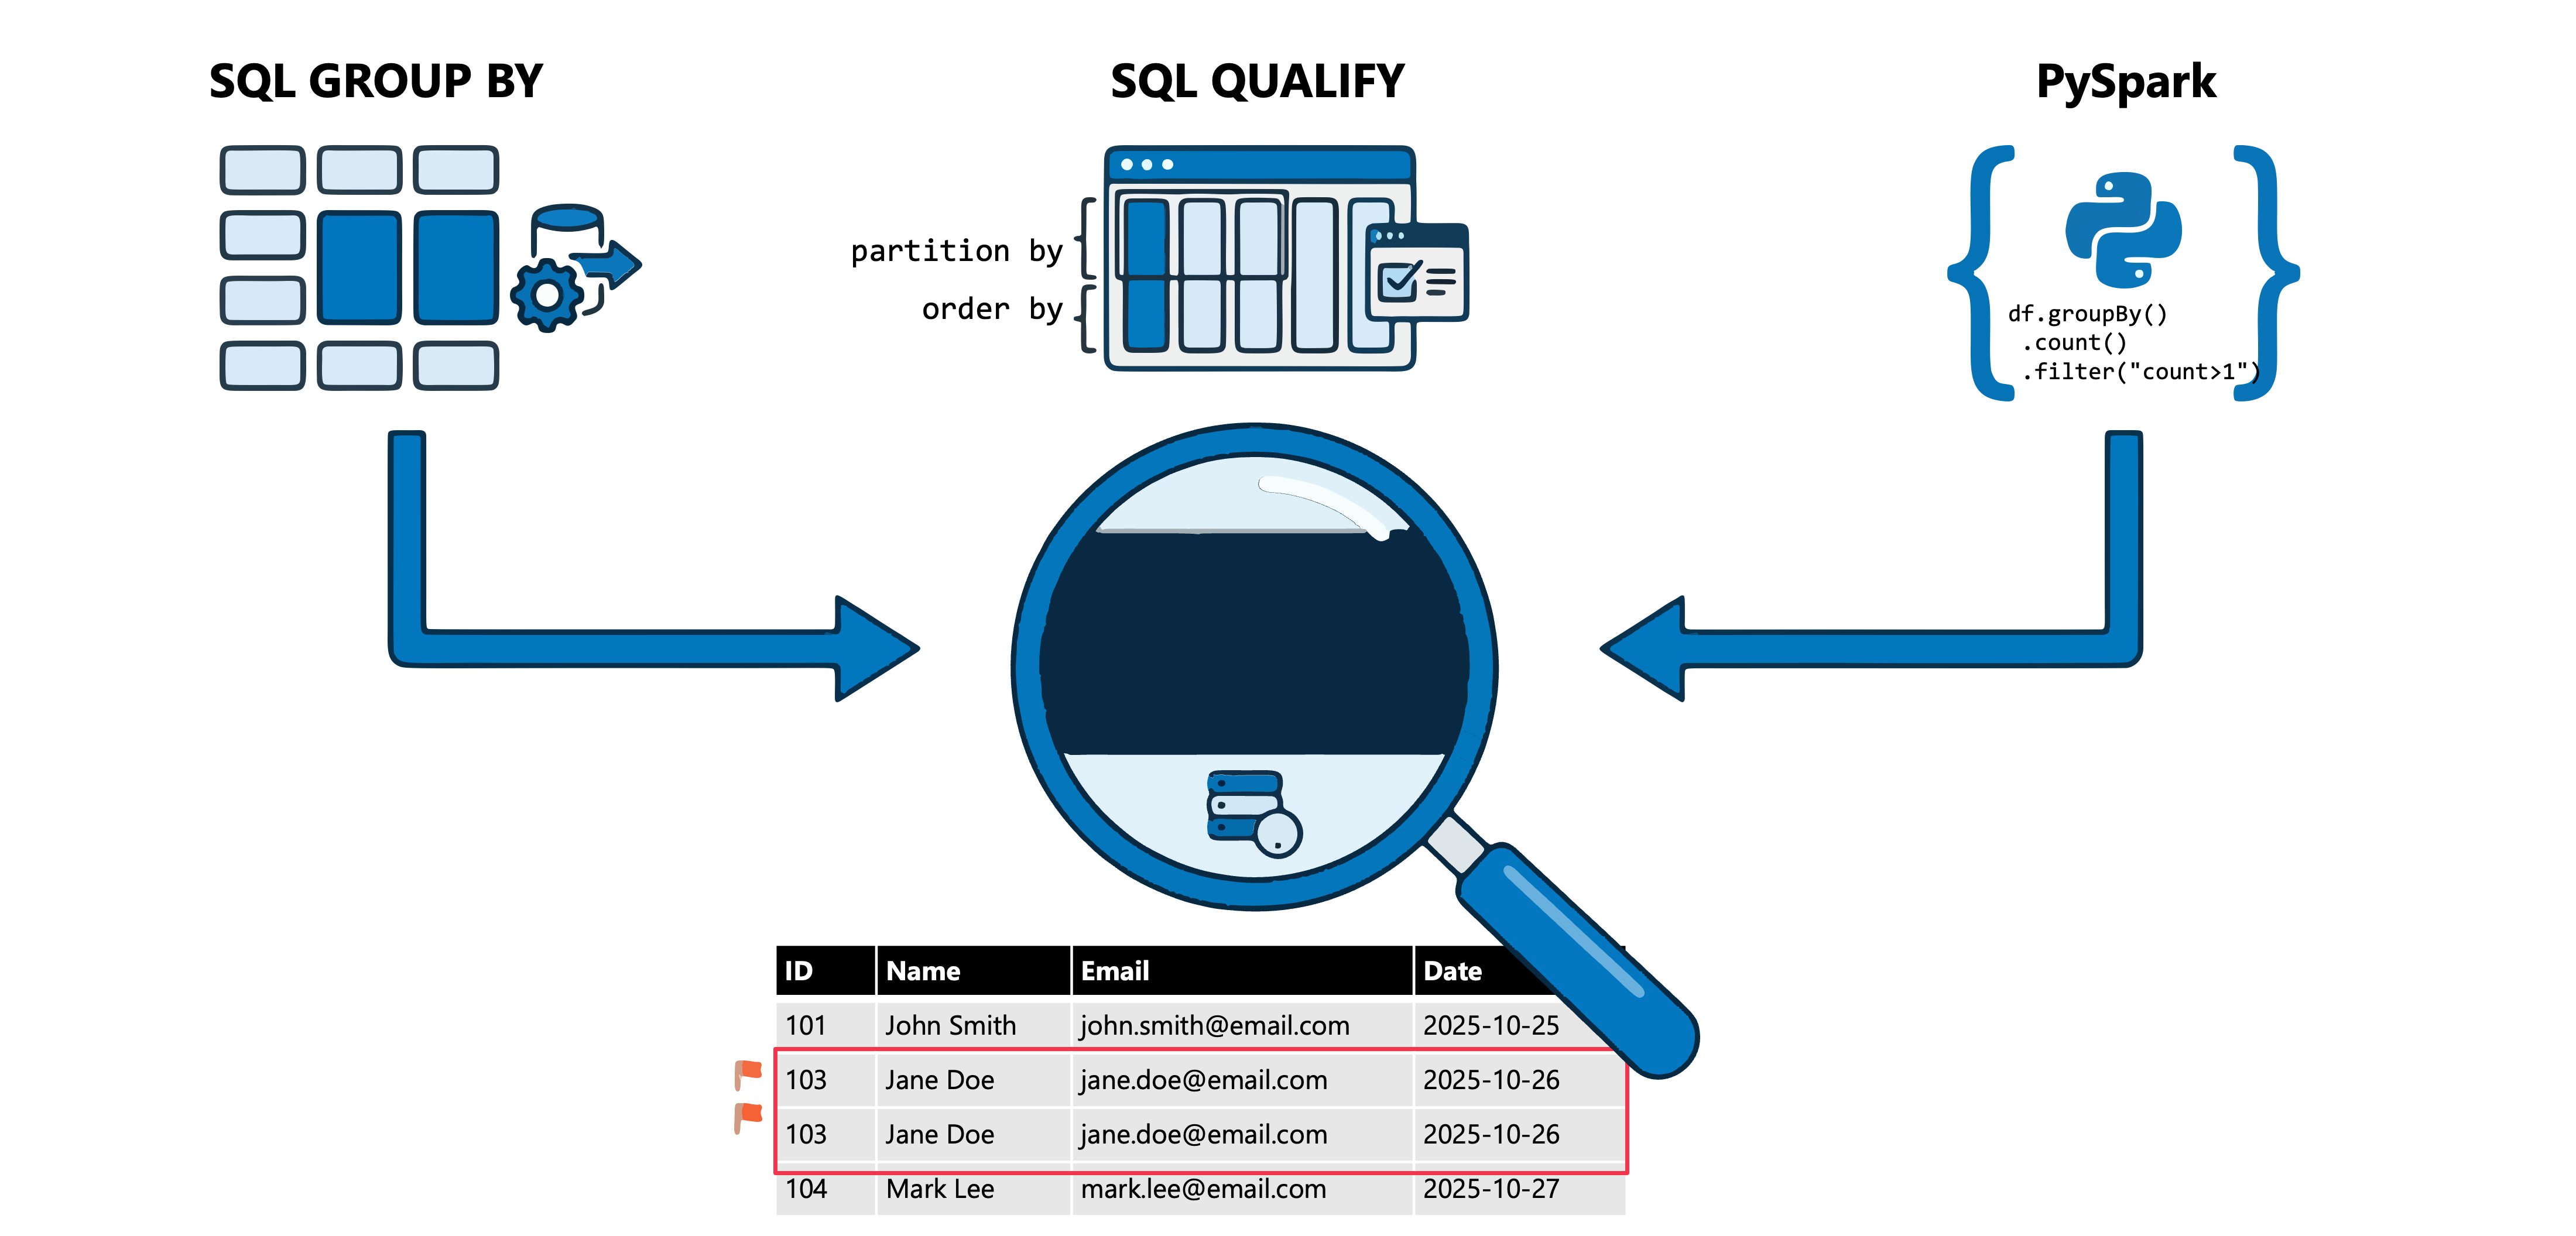
GROUP BY en HAVING gebruiken om duplicaten te vinden
De eenvoudigste manier om duplicaten te identificeren, is door records te groeperen en exemplaren te tellen. De HAVING component filtert de gegroepeerde resultaten om alleen waarden weer te geven die meerdere keren worden weergegeven.
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
Deze query retourneert alle combinaties van customer_id en email die meerdere keren in de tabel worden weergegeven, zodat u inzicht krijgt in het bereik van duplicatie.
QUALIFY gebruiken met vensterfuncties
De QUALIFY clausule biedt een eenvoudigere benadering door de resultaten van vensterfuncties rechtstreeks te filteren, zonder subquery's te vereisen. Deze benadering is met name handig wanneer u de werkelijke dubbele rijen moet zien, niet alleen aantallen.
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
Deze query retourneert mogelijk resultaten zoals:
| customer_id | e-mailadres | naam | aangemaakt_op | status |
|---|---|---|---|---|
| 1001 | jane@contoso.com | Jane Doe | 2024-01-15 | Active |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Active |
| 1002 | bob@fabrikam.com | Bob Smith | 2024-02-10 | In afwachting |
| 1002 | bob@fabrikam.com | Robert Smith | 2024-02-11 | Active |
Met dit patroon krijgt u alle kolommen uit de dubbele rijen, zodat u de bron van duplicatie gemakkelijker kunt onderzoeken.
Duplicaten zoeken met Behulp van PySpark
In PySpark kunt u vensterfuncties gebruiken in combinatie met filteren om dubbele records te identificeren:
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
U kunt ook de exceptAll() methode gebruiken om het oorspronkelijke DataFrame te vergelijken met een ontdubbelde versie:
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
De exceptAll() methode voert een vast verschil uit dat duplicaten behoudt. Het geeft alle rijen uit het eerste DataFrame die niet in het tweede DataFrame staan, waarbij dubbele vermeldingen behouden blijven. Dit werkt als volgt:
-
df.dropDuplicates(["customer_id", "email"])maakt een DataFrame met één rij per unieke combinatie -
exceptAll()vergelijkt het oorspronkelijke DataFrame met deze ontdubbelde versie - Voor elke unieke combinatie is één exemplaar 'overeenkomend' en verwijderd, waardoor alleen de extra duplicaten worden achtergelaten
Als klant 1001 bijvoorbeeld drie keer wordt weergegeven in het oorspronkelijke DataFrame en eenmaal in de ontdubbelde versie, retourneert exceptAll() twee regels (de extra voorkomens).
Opmerking
In tegenstelling tot except(), waardoor alle overeenkomende rijen worden verwijderd en afzonderlijke resultaten worden geretourneerd, exceptAll() blijft de dubbele structuur behouden. Als u drie identieke rijen in het origineel hebt en één in de ontdubbelde set, exceptAll() retourneert u precies twee rijen.
Dubbele records verwijderen
Zodra u duplicaten hebt geïdentificeerd, kunt u een oplossingsstrategie kiezen op basis van uw gegevensvereisten.
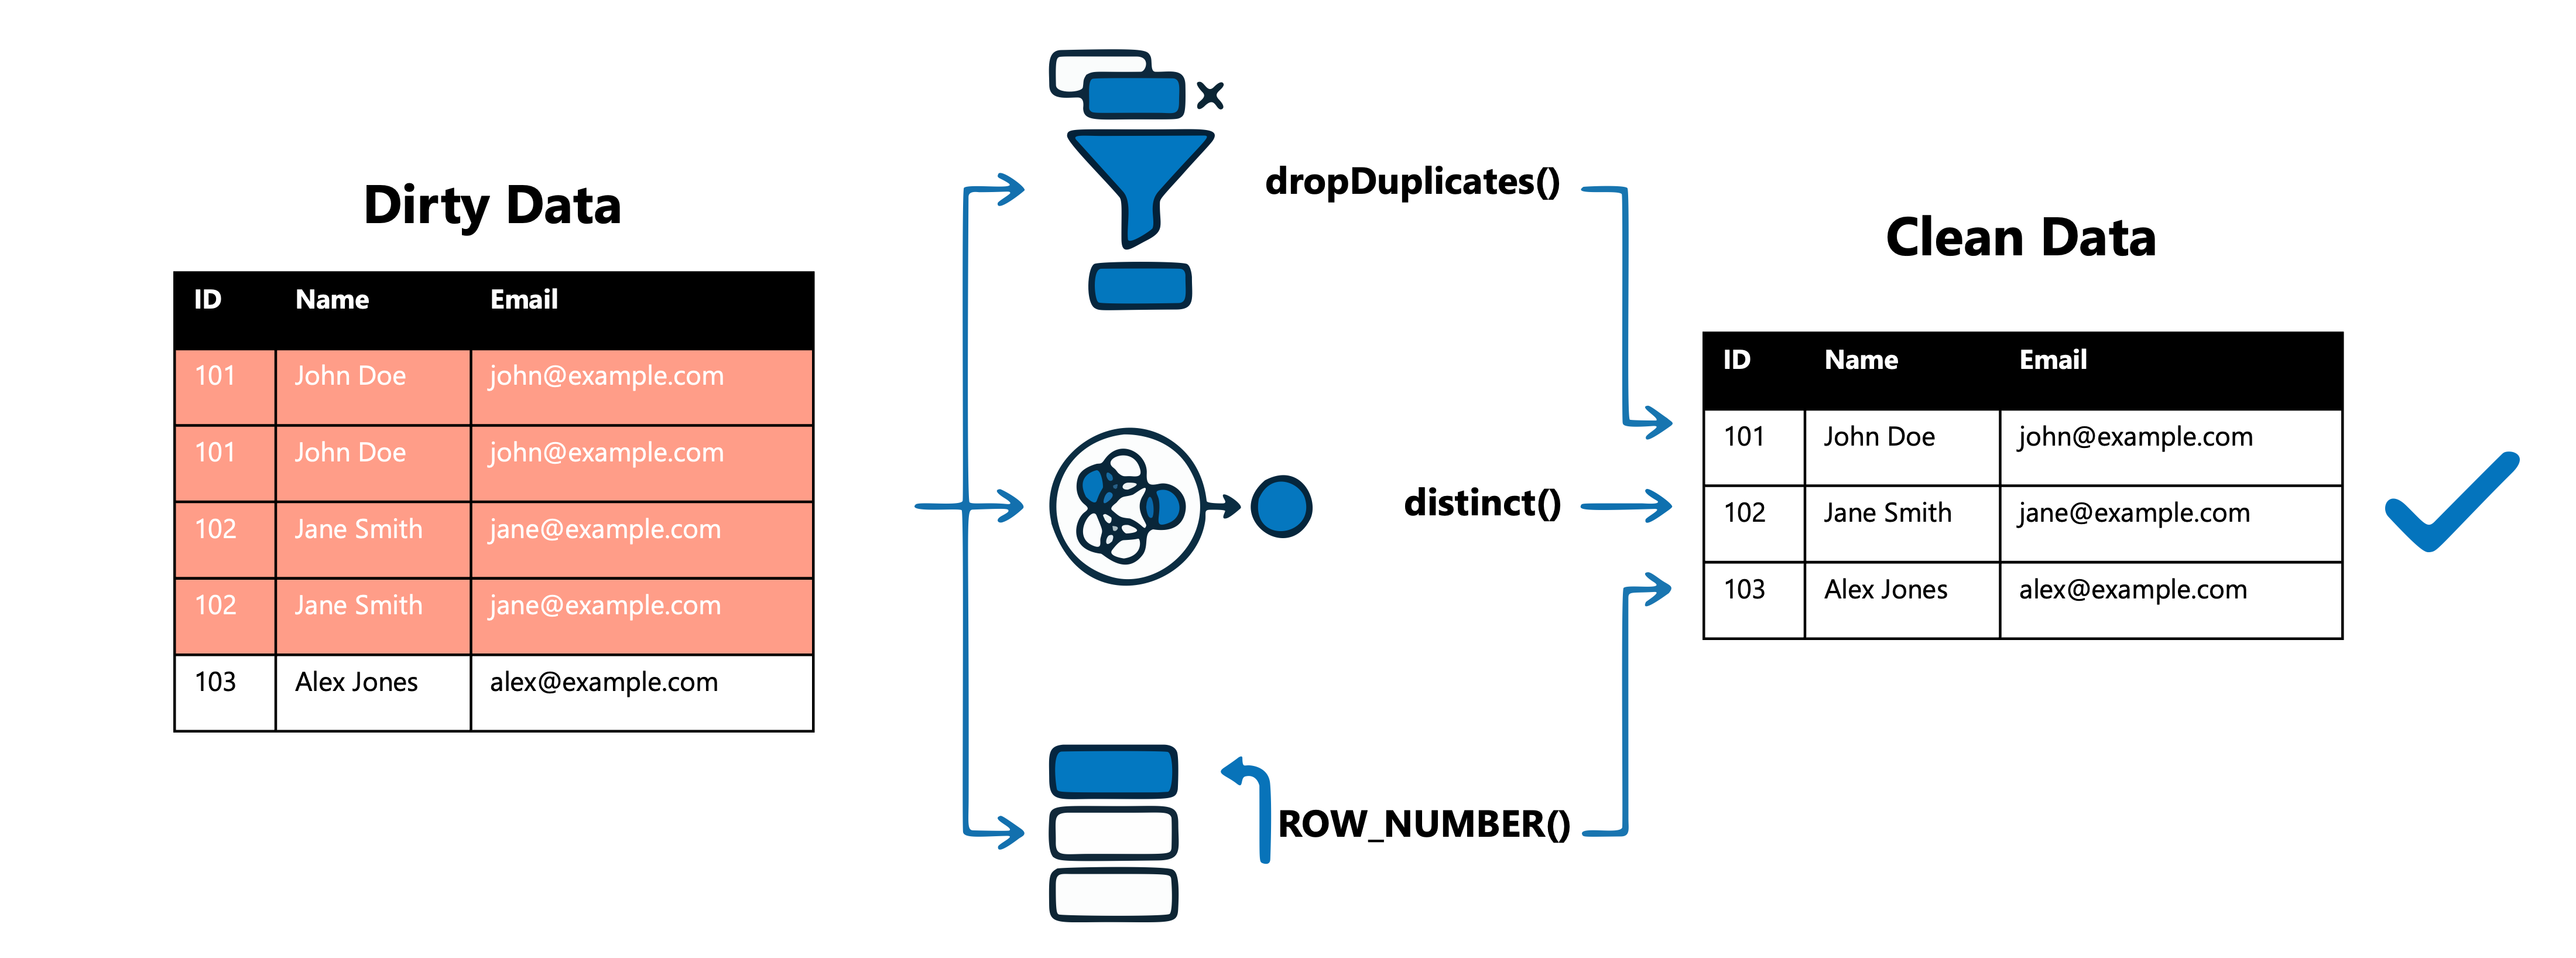
Duplicaten verwijderen in PySpark
De dropDuplicates() methode verwijdert dubbele rijen op basis van opgegeven kolommen en bewaart één rij voor elke combinatie. Wanneer rijen verschillen in andere kolommen, is de rij die overblijft niet gegarandeerd:
df_clean = df.dropDuplicates(["customer_id", "email"])
Gebruik distinct() voor volledige rijontdubbeling in alle kolommen:
df_unique = df.distinct()
Specifieke rijen behouden met ROW_NUMBER
Wanneer u wilt bepalen welk duplicaat u wilt bewaren, gebruikt u ROW_NUMBER() met QUALIFY om records te selecteren op basis van criteria zoals de meest recente update:
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
Met deze query worden records gepartitioneerd op customer_id, en in aflopende volgorde gesorteerd op updated_at, en wordt alleen de laatst bijgewerkte record voor elke klant bewaard.
Null- en ontbrekende waarden verwerken
Null-waarden vertegenwoordigen ontbrekende of onbekende gegevens. Afhankelijk van uw analysevereisten moet u mogelijk rijen verwijderen met nulls, deze vervangen door standaardwaarden of statistische imputatie gebruiken.
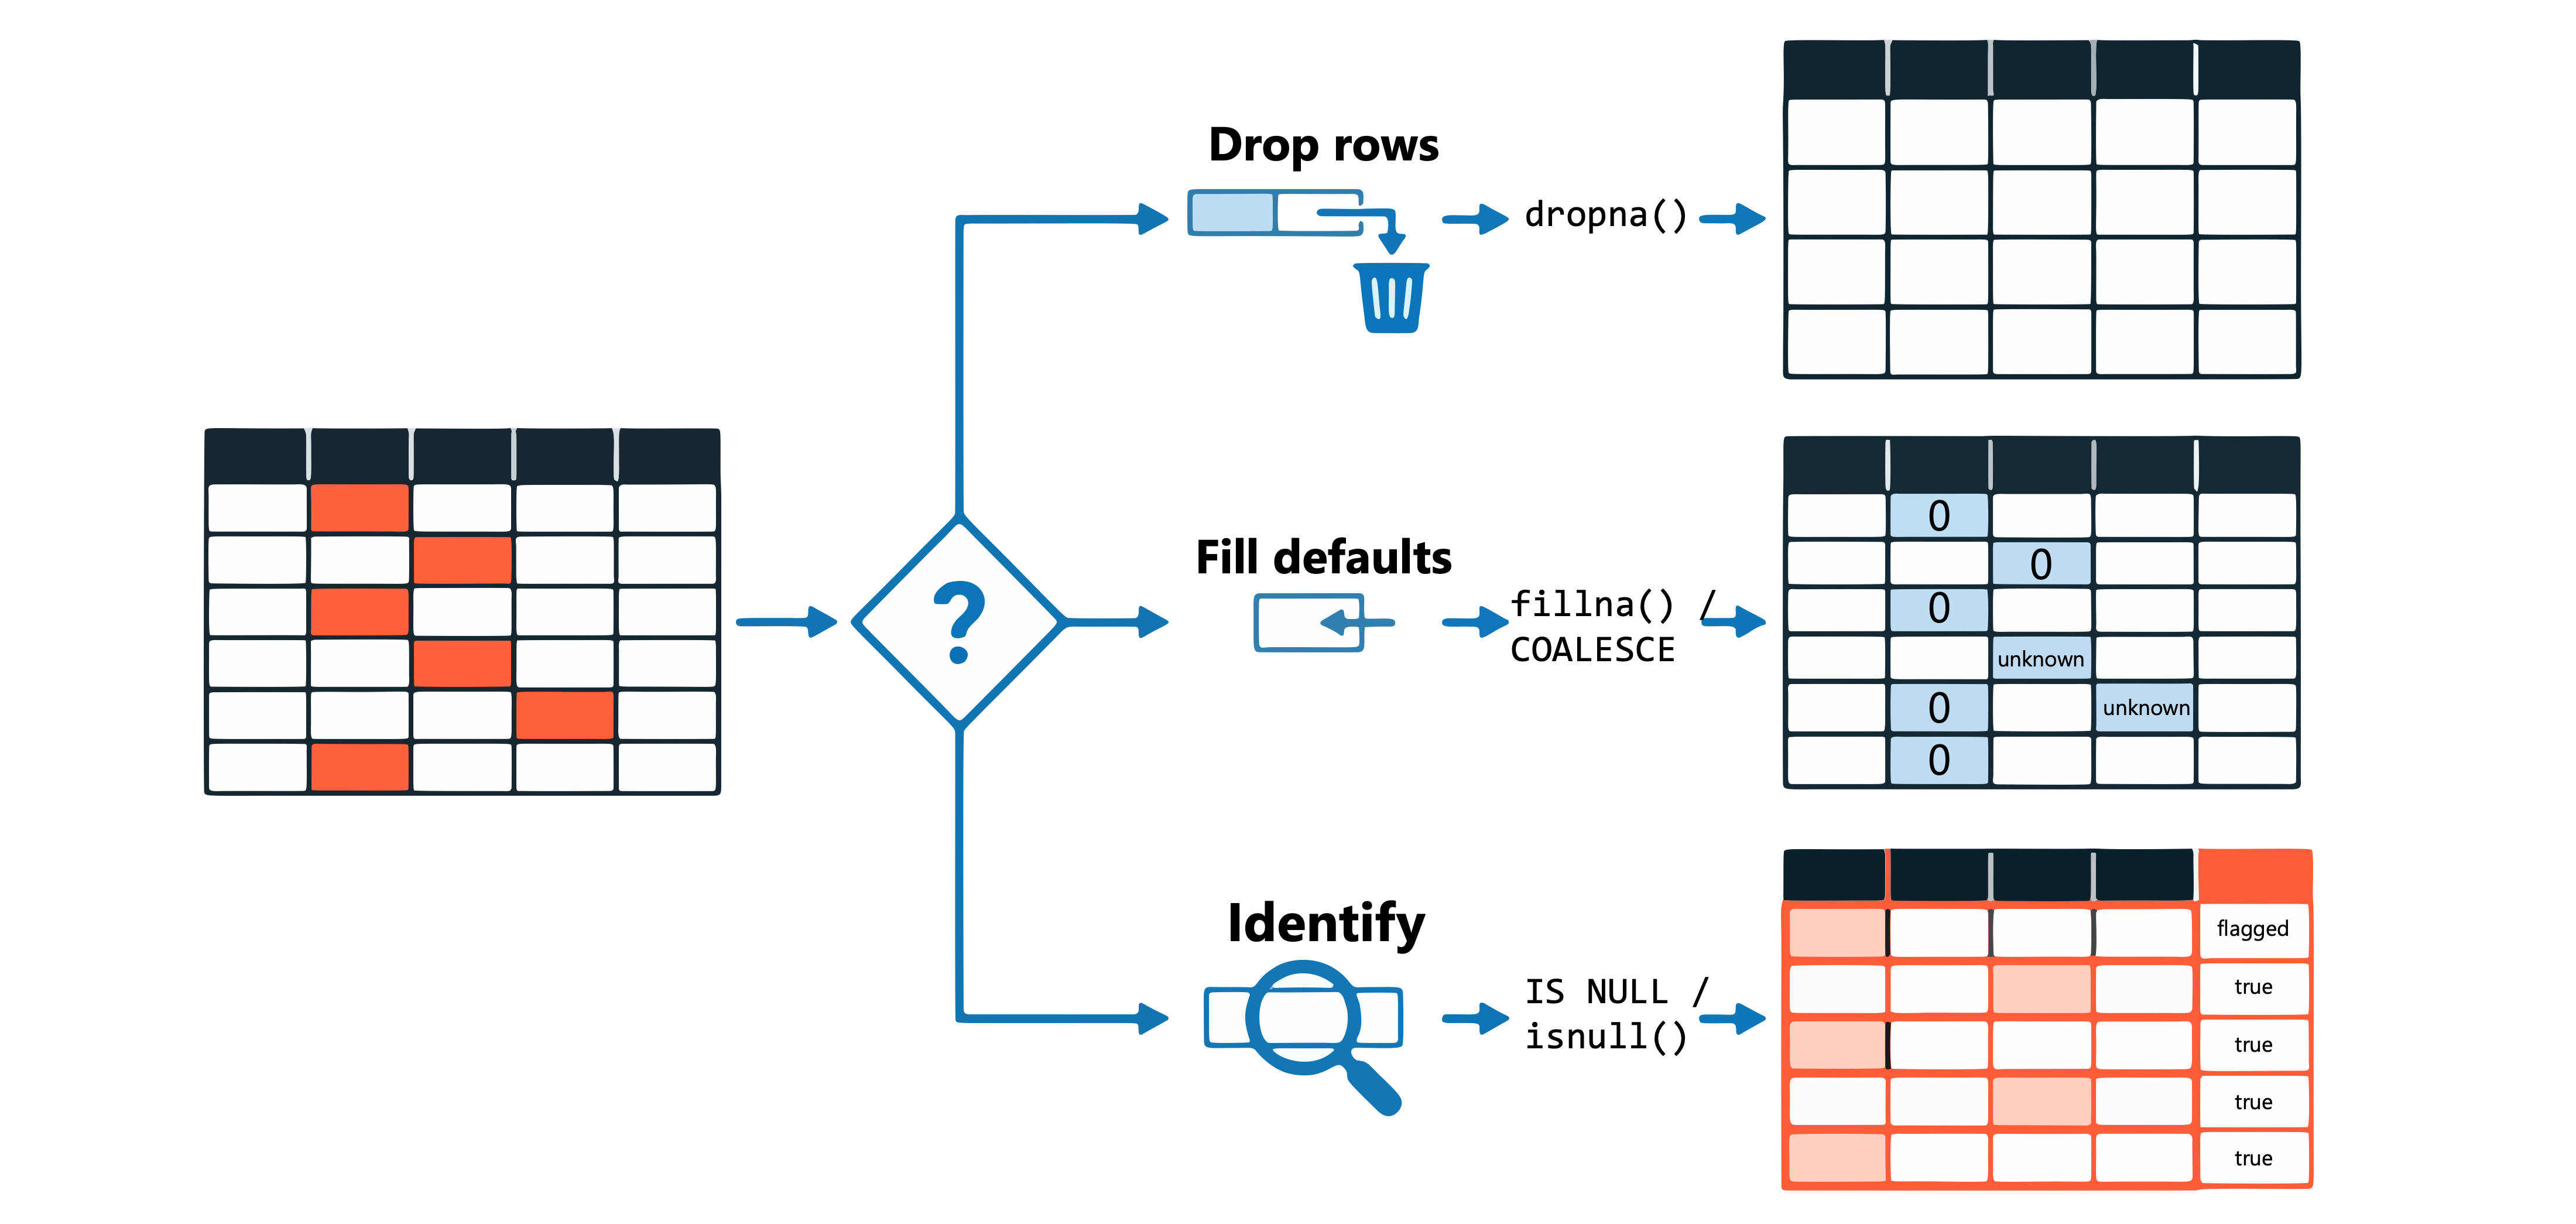
Null-waarden identificeren
Gebruik de isnull() functie of IS NULL operator om records met ontbrekende waarden te zoeken:
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
Null-waarden per kolom tellen:
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
Rijen verwijderen met lege waarden
In PySpark verwijdert de dropna() methode rijen met null-waarden:
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
De how parameter bepaalt het gedrag: "any" rijen verwijderen met ten minste één null (standaard), terwijl "all" rijen alleen worden verwijderd wanneer alle opgegeven kolommen null zijn.
Null-waarden doorvoeren met standaardwaarden
De fillna() methode vervangt null-waarden door de opgegeven standaardwaarden:
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
Gebruik in SQL de COALESCE functie om standaardwaarden op te geven:
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
De juiste strategie kiezen
De juiste null-verwerkingsstrategie is afhankelijk van uw gegevenscontext:
| Scenario | Aanbevolen aanpak |
|---|---|
| Nulls in vereiste velden, zoals identificatoren | De rijen verwijderen |
| Nullen in numerieke velden bij aggregatie | Opvulling met nul of gemiddelde |
| Nullwaarden in optionele categorische velden | Vul de tijdelijke aanduiding 'Onbekend' in |
| Null-waarden die de analyse zouden vertekenen | Neerzetten of doorvoeren op basis van domeinkennis |
Aanbeveling
Documenteer uw beslissingen voor null-verwerking. Toekomstige analisten moeten begrijpen waarom bepaalde waarden zijn vervangen of verwijderd om queryresultaten correct te interpreteren.
Als u weet hoe u deze problemen met gegevenskwaliteit kunt identificeren en oplossen, bereidt u zich voor om betrouwbaardere gegevenspijplijnen te bouwen. Met schone gegevens produceren uw downstreamtransformaties en analyses betrouwbare resultaten.