Gegevens transformeren met joins en operators instellen
Voor data engineering-werkstromen is vaak het combineren van gegevens uit meerdere gegevenssets vereist. Joins combineren tabellen horizontaal door rijen op gerelateerde kolommen te matchen, terwijl set-operators tabellen verticaal combineren door rijen toe te voegen, te snijden of uit te sluiten. Als u weet wanneer u elke benadering gebruikt, kunt u efficiënte transformatiepijplijnen bouwen.
In deze les leert u hoe u tabellen kunt samenvoegen op basis van relaties en setoperators kunt toepassen om gegevenssets te combineren met overeenkomende schema's.
Tabellen combineren met joins
Joins voegen rijen uit twee tabellen samen op basis van een gerelateerde kolom. Het jointype bepaalt welke rijen worden weergegeven in het resultaat en hoe niet-overeenkomende rijen worden verwerkt.
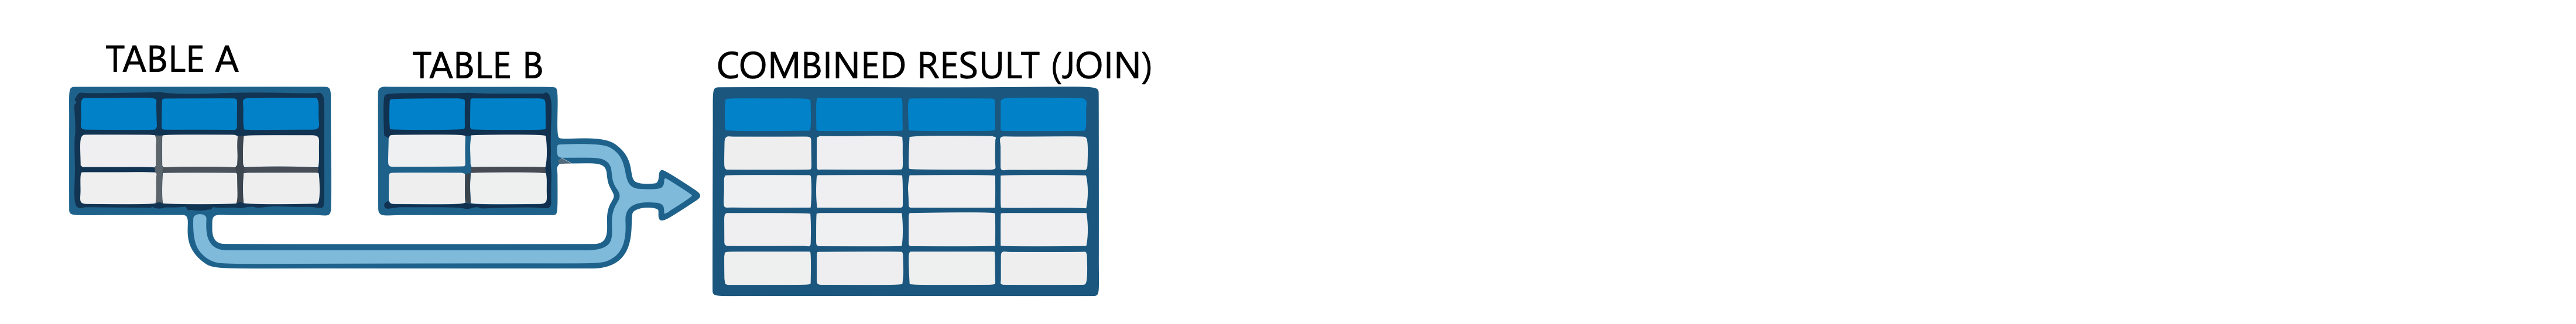
Begrijp jointypen
Elk jointype heeft een specifiek doel bij gegevenstransformatie:

| Type join | Description | Gebruiksituatie |
|---|---|---|
INNER |
Retourneert alleen overeenkomende rijen uit beide tabellen | Orders koppelen aan geldige klanten |
LEFT |
Retourneert alle linkertabelrijen; voegt NULL's toe voor de juiste tabel wanneer er geen overeenkomst is | Alle klanten opnemen, zelfs zonder orders |
RIGHT |
Retourneert alle juiste tabelrijen; voegt NULL's toe voor linkertabel als er geen overeenkomst is | Alle afdelingen opnemen, zelfs zonder werknemers |
FULL |
Retourneert alle rijen uit beide tabellen; voegt NULL-waarden toe voor niet-overeenkomende waarden | Gegevenssets combineren om hiaten aan beide zijden te vinden |
SEMI |
Retourneert linkertabelrijen met overeenkomsten in de rechtertabel | Klanten filteren die orders hebben geplaatst |
ANTI |
Retourneert linkertabelrijen die geen overeenkomst hebben in de rechtertabel | Klanten zoeken die nooit bestellingen hebben geplaatst |
CROSS |
Retourneert het Cartesisch product van alle rijen | Alle mogelijke combinaties genereren |
Tabellen samenvoegen met SQL
De JOIN component combineert tabellen op basis van een voorwaarde die is opgegeven met ON of USING. In de volgende voorbeelden worden tabellen voor werknemers en afdelingen gebruikt:
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Als u werknemers wilt koppelen aan hun afdelingen, gebruikt u een inner join:
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Een inner join retourneert slechts drie rijen: werknemers met afdelingsnummers in de afdelingstabel. Werknemers in afdelingen 4, 5 en 6 worden niet weergegeven omdat deze afdelingen zich niet in de afdelingstabel bevinden.
Wanneer u alle werknemers wilt opnemen, ongeacht afdelingsovereenkomsten, gebruikt u een left join:
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Hiermee worden alle zes werknemers geretourneerd. Degenen zonder overeenkomende afdelingen tonen NULL in de deptname kolom.
DataFrames koppelen met PySpark
De methode van join() PySpark biedt dezelfde functionaliteit. De how parameter geeft het jointype op:
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
Wijzig de how parameter voor links, rechts of volledige outer joins:
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Wanneer de joinkolom dezelfde naam heeft in beide DataFrames, geeft u de kolomnaam door als een tekenreeks. Deze methode voorkomt dubbele kolommen in het resultaat.
Gegevens filteren met semi- en anti-joins
Semi- en anti-joins filteren gegevens op basis van het al dan niet voorkomen in een andere tabel. Een semi-join retourneert rijen uit de linkertabel met overeenkomsten, zonder kolommen uit de rechtertabel op te nemen:
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Een anti-join retourneert het tegenovergestelde: rijen zonder overeenkomsten:
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
In PySpark gebruikt u how="semi" of how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Rijen combineren met setoperators
Set-operatoren werken verticaal en combineren rijen uit query's met dezelfde kolomstructuur. In tegenstelling tot joins komen setoperators niet overeen met voorwaarden. Ze stapelen of vergelijken volledige resultatensets.
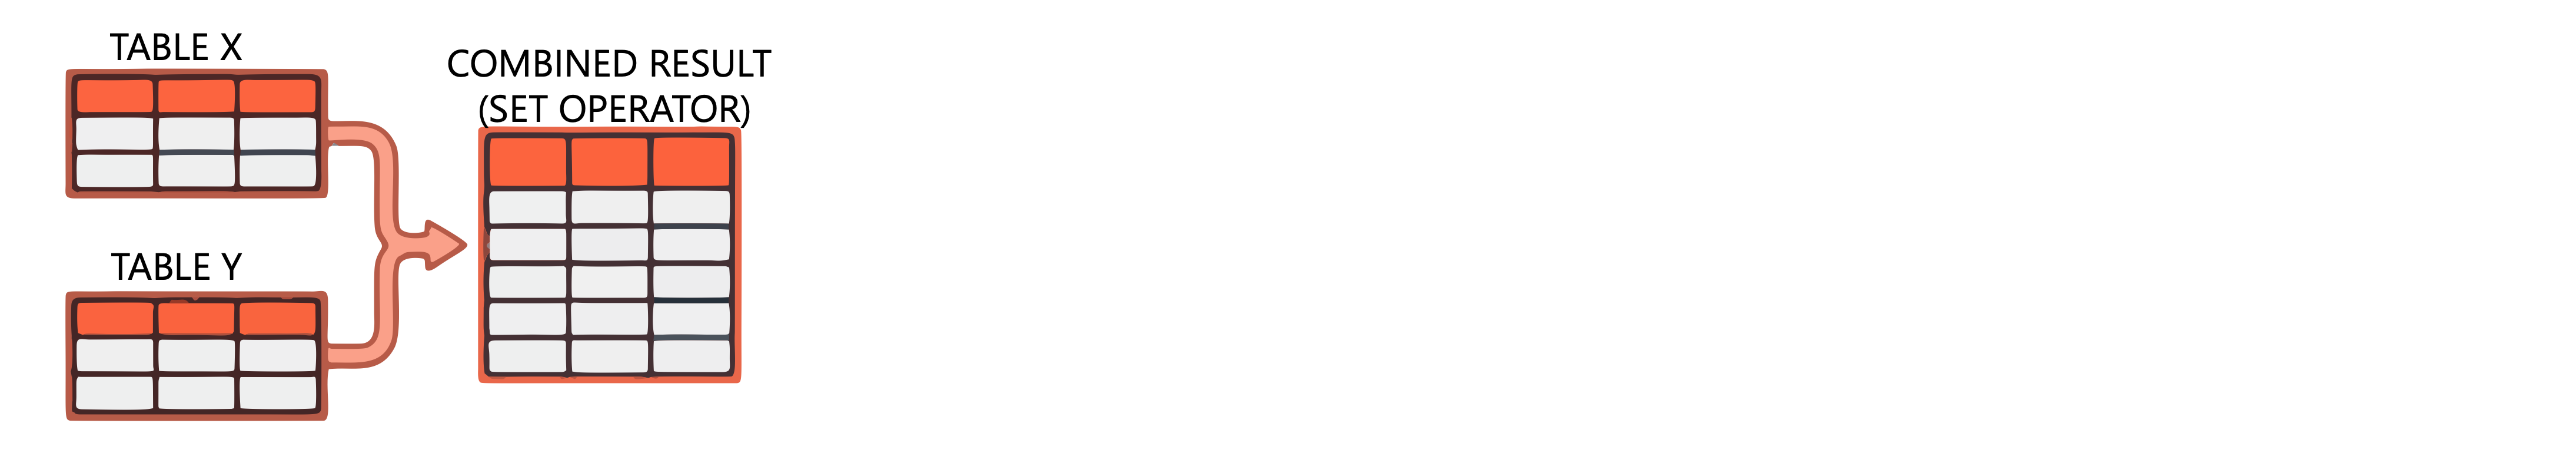
Begrijp setoperators
Azure Databricks ondersteunt drie setoperators:
| Operator | Description | Gedrag |
|---|---|---|
UNION |
Combineert rijen uit beide query's. | Verwijdert standaard duplicaten; gebruiken ALL om ze te behouden |
INTERSECT |
Retourneert rijen die aanwezig zijn in beide query's | Alleen overeenkomende rijen worden weergegeven |
EXCEPT |
Retourneert rijen uit de eerste query die niet in de tweede zitten | Dubbele waarden standaard verwijderen |
Beide query's moeten hetzelfde aantal kolommen hebben met compatibele gegevenstypen.
Gegevenssets samenvoegen met UNION
UNION voegt rijen van de ene query toe aan een andere. Standaard worden dubbele waarden verwijderd:
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Als u alle rijen inclusief duplicaten wilt behouden, gebruikt u UNION ALL:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Gebruik UNION ALL dit wanneer u weet dat er geen duplicaten zijn of wanneer duplicaten zinvol zijn. Het presteert beter omdat de ontdubbelingsstap wordt overgeslagen.
Gebruik in PySpark union() voor het combineren van DataFrames. Houd er rekening mee dat PySpark union() zich gedraagt als UNION ALL: het houdt duplicaten bij:
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Algemene rijen zoeken met INTERSECT
INTERSECT retourneert alleen rijen die worden weergegeven in beide query's. Dit helpt bij het identificeren van overlappende gegevens:
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
Deze query identificeert klanten die op de een of andere manier in beide tabellen worden weergegeven, wat handig is voor gegevenskwaliteitscontroles of het identificeren van records die afstemming nodig hebben.
Rijen uitsluiten met EXCEPT
EXCEPT retourneert rijen uit de eerste query die niet bestaan in de tweede. Dit helpt bij het identificeren van hiaten of unieke records:
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
U kunt ook als synoniem gebruiken MINUS voor EXCEPT:
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Zoals UNION, verwijderen zowel INTERSECT als EXCEPT standaard duplicaten. Voeg ALL toe om duplicaten te behouden wanneer dat nodig is.
Aanbeveling
Houd er bij het koppelen van setbewerkingen rekening mee dat deze INTERSECT hogere prioriteit heeft dan UNION en EXCEPT. Gebruik haakjes om de evaluatievolgorde te beheren.
Kiezen tussen joins en setoperators
De keuze tussen joins en setoperators is afhankelijk van uw transformatiedoel. Joins combineren kolommen uit gerelateerde tabellen horizontaal, terwijl set-operators rijen verticaal combineren.
Gebruik joins wanneer u het volgende moet doen:
- Records verrijken door kolommen uit gerelateerde tabellen toe te voegen
- Records vergelijken op basis van sleutelrelaties
- Gegevens filteren op basis van bestaan in een andere tabel (semi-/anti-joins)
Gebruik setoperators wanneer u het volgende moet doen:
- Records uit meerdere bronnen toevoegen met identieke schema's
- Algemene records zoeken in gegevenssets
- Records identificeren die uniek zijn voor één gegevensset
Beide benaderingen vormen de basis van effectieve pijplijnen voor gegevenstransformatie. In de volgende les verkent u hoe u getransformeerde gegevens laadt in doeltabellen in Unity Catalog.