Een gegevenstabelindeling kiezen
Data engineers nemen vroeg in elke gegevenspijplijn een kritieke beslissing: welke tabelindeling moet uw gegevens opslaan? Deze keuze is van invloed op queryprestaties, transactiebetrouwbaarheid, interoperabiliteit met andere platforms en langetermijnonderhoud van uw Lakehouse-architectuur.
Azure Databricks ondersteunt meerdere opslagindelingen, die elk zijn ontworpen voor verschillende scenario's. Als u de verschillen begrijpt, kunt u de juiste indeling voor uw specifieke vereisten selecteren.
Meer informatie over bestandsindelingen versus tabelindelingen
Voordat u opties vergelijkt, is het belangrijk om onderscheid te maken tussen bestandsindelingen en tabelindelingen. Een bestandsindeling zoals Parquet, CSV of JSON definieert hoe gegevens fysiek op schijf worden opgeslagen. Een tabelindeling zoals Delta Lake of Apache Iceberg bouwt voort op bestandsindelingen door een metagegevenslaag toe te voegen waarmee transacties, schemawijzigingen en locaties van gegevensbestanden worden bijgehouden.
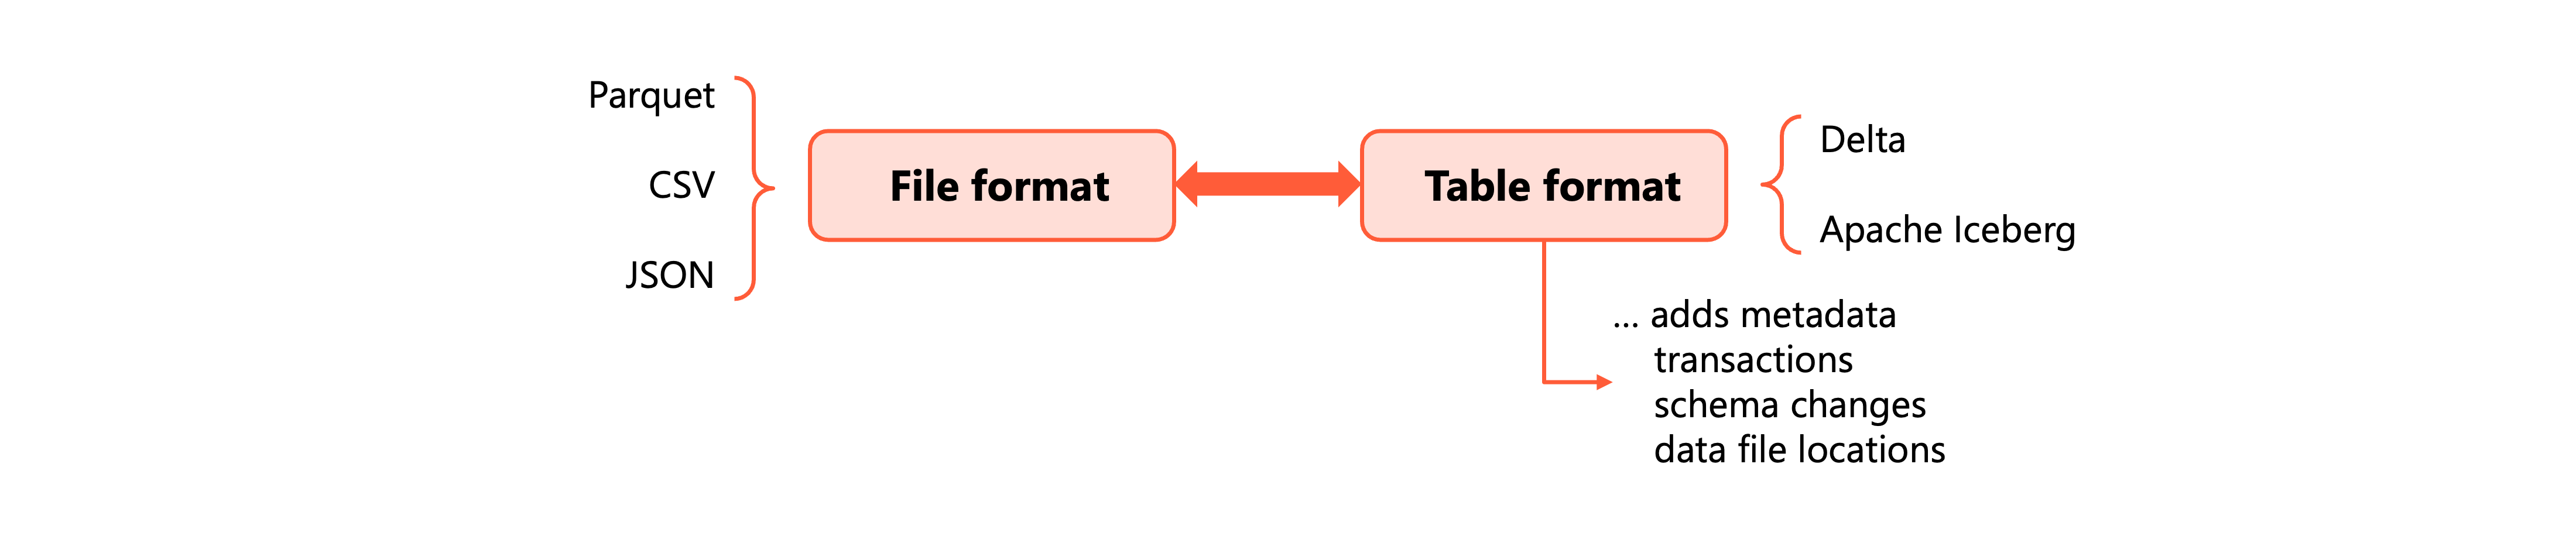
Zowel Delta Lake als Apache Iceberg gebruiken Parquet als hun onderliggende bestandsindeling. Het belangrijkste verschil is in de metagegevenslaag die geavanceerde functies mogelijk maakt, zoals ACID-transacties, tijdreizen en schemaontwikkeling.
Hoe Parquet gegevens anders opslaat
Parquet maakt gebruik van kolomopslag in plaats van opslag op basis van rijen. Dit fundamentele verschil is aanzienlijk van invloed op de prestaties van analytische query's.
In rijgebaseerde indelingen zoals CSV worden gegevens per record geordend. Voor het lezen van één kolom moet elke rij in het bestand worden gescand. In kolomindelingen zoals Parquet worden gegevens voor elke kolom samen opgeslagen. Wanneer een query alleen specifieke kolommen nodig heeft, leest Parquet alleen die kolommen en slaat de rest volledig over.
Parquet ordent gegevens in rijgroepen, elk met kolomsegmenten. In elk kolomsegment worden statistieken opgeslagen, inclusief minimum- en maximumwaarden voor dat gegevenssegment. Wanneer u een query uitvoert met een filtervoorwaarde, controleert de query-engine deze statistieken eerst. Als de filterwaarde buiten het minimum/maximumbereik van een rijgroep valt, slaat de engine het lezen van die hele sectie over.
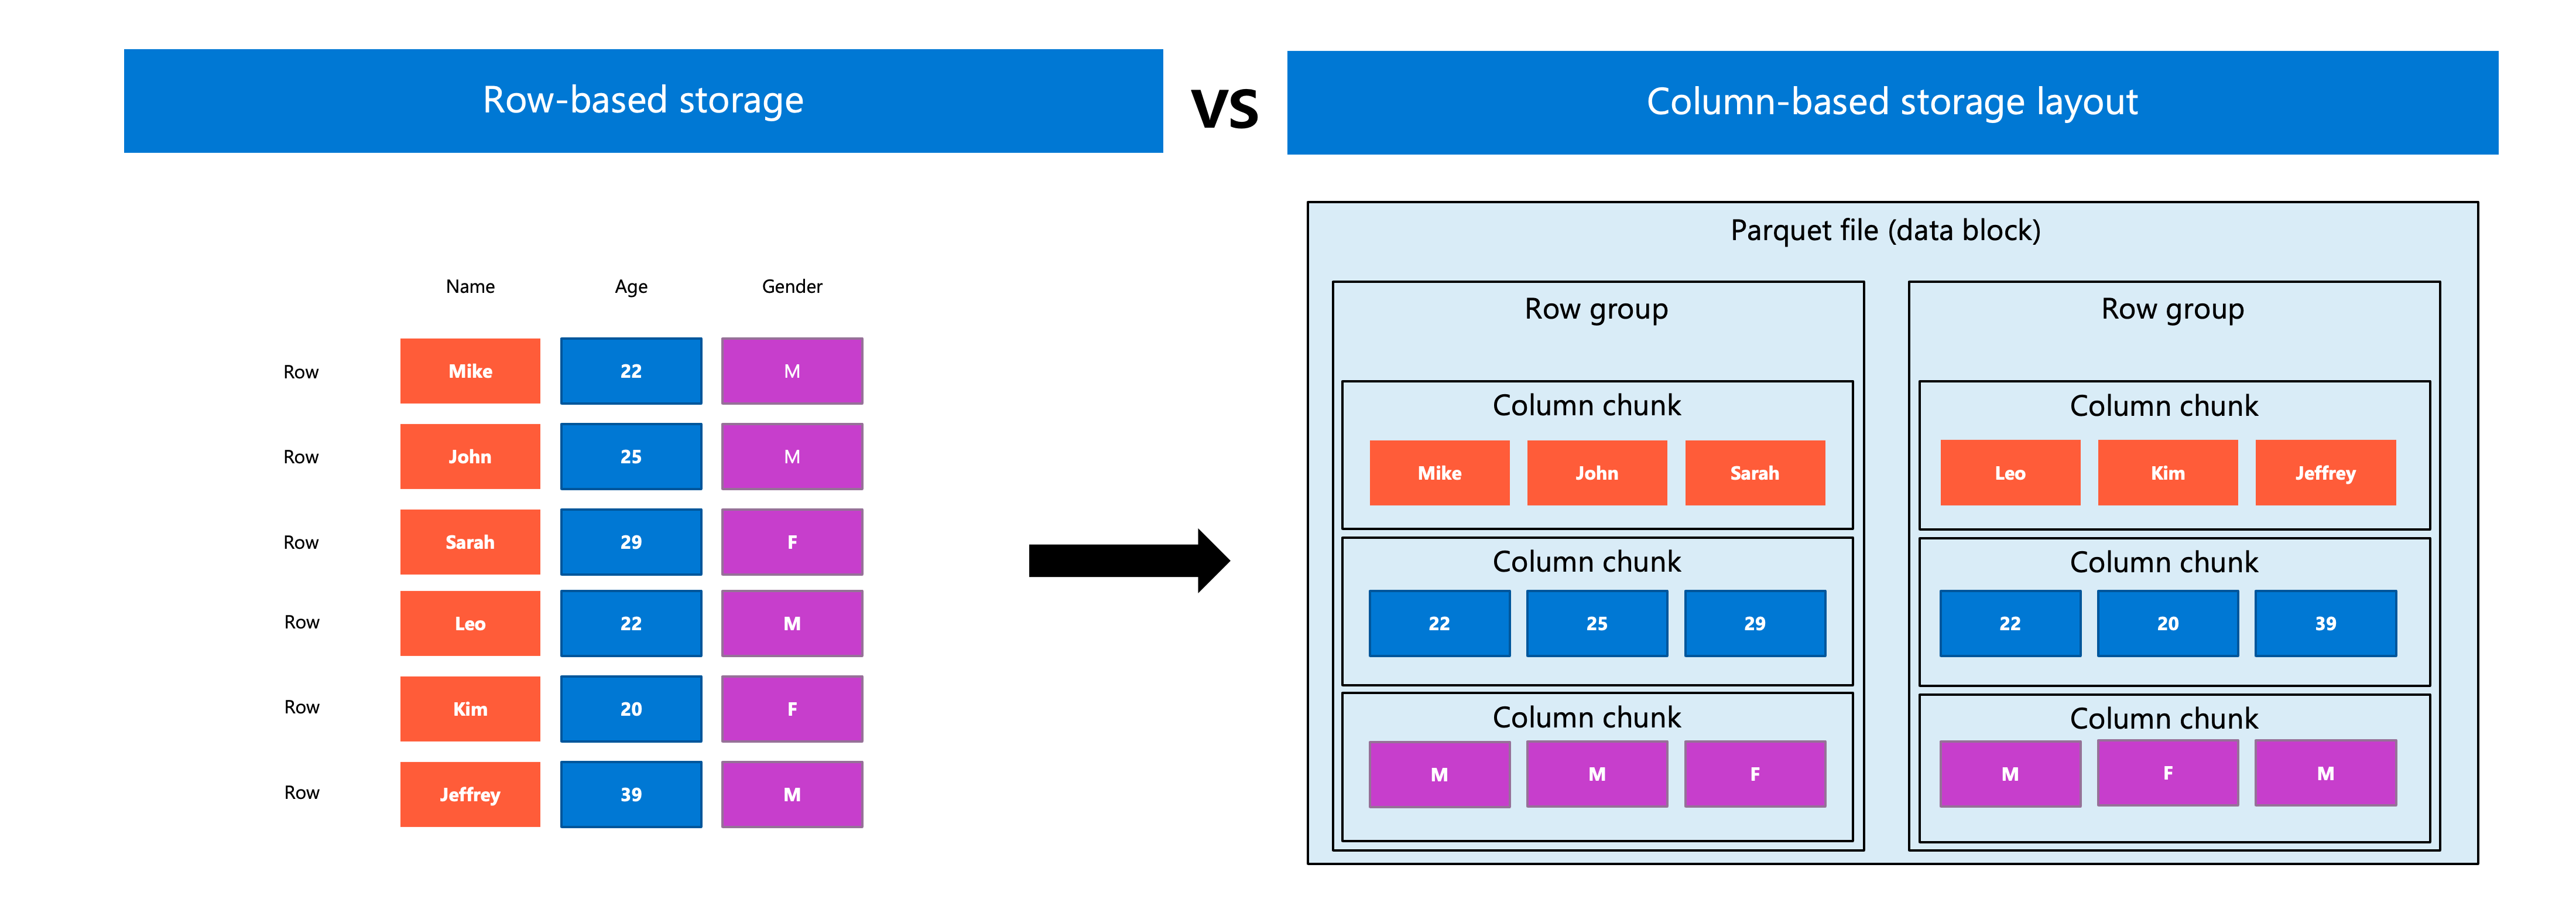
Deze kolombenadering biedt twee optimalisatietechnieken waarmee de analyseprestaties aanzienlijk worden verbeterd:
- Kolomsnoei: De engine leest alleen de kolommen waarop de query betrekking heeft, waardoor de I/O aanzienlijk wordt verminderd.
- Predicaatpushdown: Filtervoorwaarden worden geëvalueerd op basis van kolomstatistieken voordat u gegevens leest, waarbij irrelevante rijgroepen volledig worden overgeslagen.
Voor analytische workloads die doorgaans toegang hebben tot een subset kolommen in veel rijen, presteert Parquet aanzienlijk beter dan op rijen gebaseerde indelingen.
Delta Lake als standaardindeling
Delta Lake is de standaardopslagindeling voor alle tabellen in Azure Databricks. Wanneer u een tabel maakt zonder een indeling op te geven, gebruikt Azure Databricks automatisch Delta Lake.
Delta Lake breidt Parquet-bestanden uit met een transactielogboek dat elke wijziging in uw tabel registreert. Dit logboek maakt verschillende mogelijkheden mogelijk die alleen Parquet niet biedt:
ACID-transacties: meerdere gelijktijdige lezers en schrijvers hebben toegang tot dezelfde tabel zonder gegevensbeschadiging. Elke transactie wordt volledig voltooid of heeft geen effect.
Tijdreizen: Voer een query uit op eerdere versies van uw tabel met tijdstempels of versienummers. Schakel indien nodig wijzigingen terug.
Schemaafdwinging en evolutie: De tabel valideert binnenkomende gegevens op basis van het gedefinieerde schema, waardoor beschadigde of incompatibele gegevens niet in uw lakehouse kunnen worden ingevoerd. Wanneer de vereisten veranderen, kunt u nieuwe kolommen toevoegen, gegevenstypen wijzigen of kolommen hernoemen zonder bestaande gegevens opnieuw te schrijven.
Geïntegreerde batch en streaming: gebruik dezelfde tabel als zowel een batchbron als een streamingbron of sink.
Delta Lake integreert diep met het Azure Databricks-platform. Functies zoals vloeistofclustering en voorspellende optimalisatie zijn beschikbaar voor delta lake- en beheerde Apache Iceberg-tabellen in Unity Catalog. Wijzigingsgegevensfeed is echter specifiek voor Delta Lake en is afhankelijk van het transactielogboek.
Voor de meeste scenario's in Azure Databricks is Delta Lake de aanbevolen keuze. Het biedt de prestatievoordelen van Parquet met transactionele garanties die productiedatasystemen vereisen.
Apache Iceberg voor platformoverschrijdende scenario's
Apache Iceberg is een alternatief open tabelformaat dat door Azure Databricks wordt ondersteund voor beheerde en externe tabellen. Net als Delta Lake biedt Iceberg ACID-transacties, schemaontwikkeling en mogelijkheden voor tijdreizen die zijn gebouwd op Parquet-bestanden.
De hiërarchische en goed gedefinieerde logische structuur van Iceberg maakt het zeer flexibel en biedt ondersteuning voor schaalbaarheid en geavanceerde optimalisaties. Het ondersteunt het verwijderen van manifesten, statistieken op bestandsniveau, verborgen partitionering en evolutie van partities.
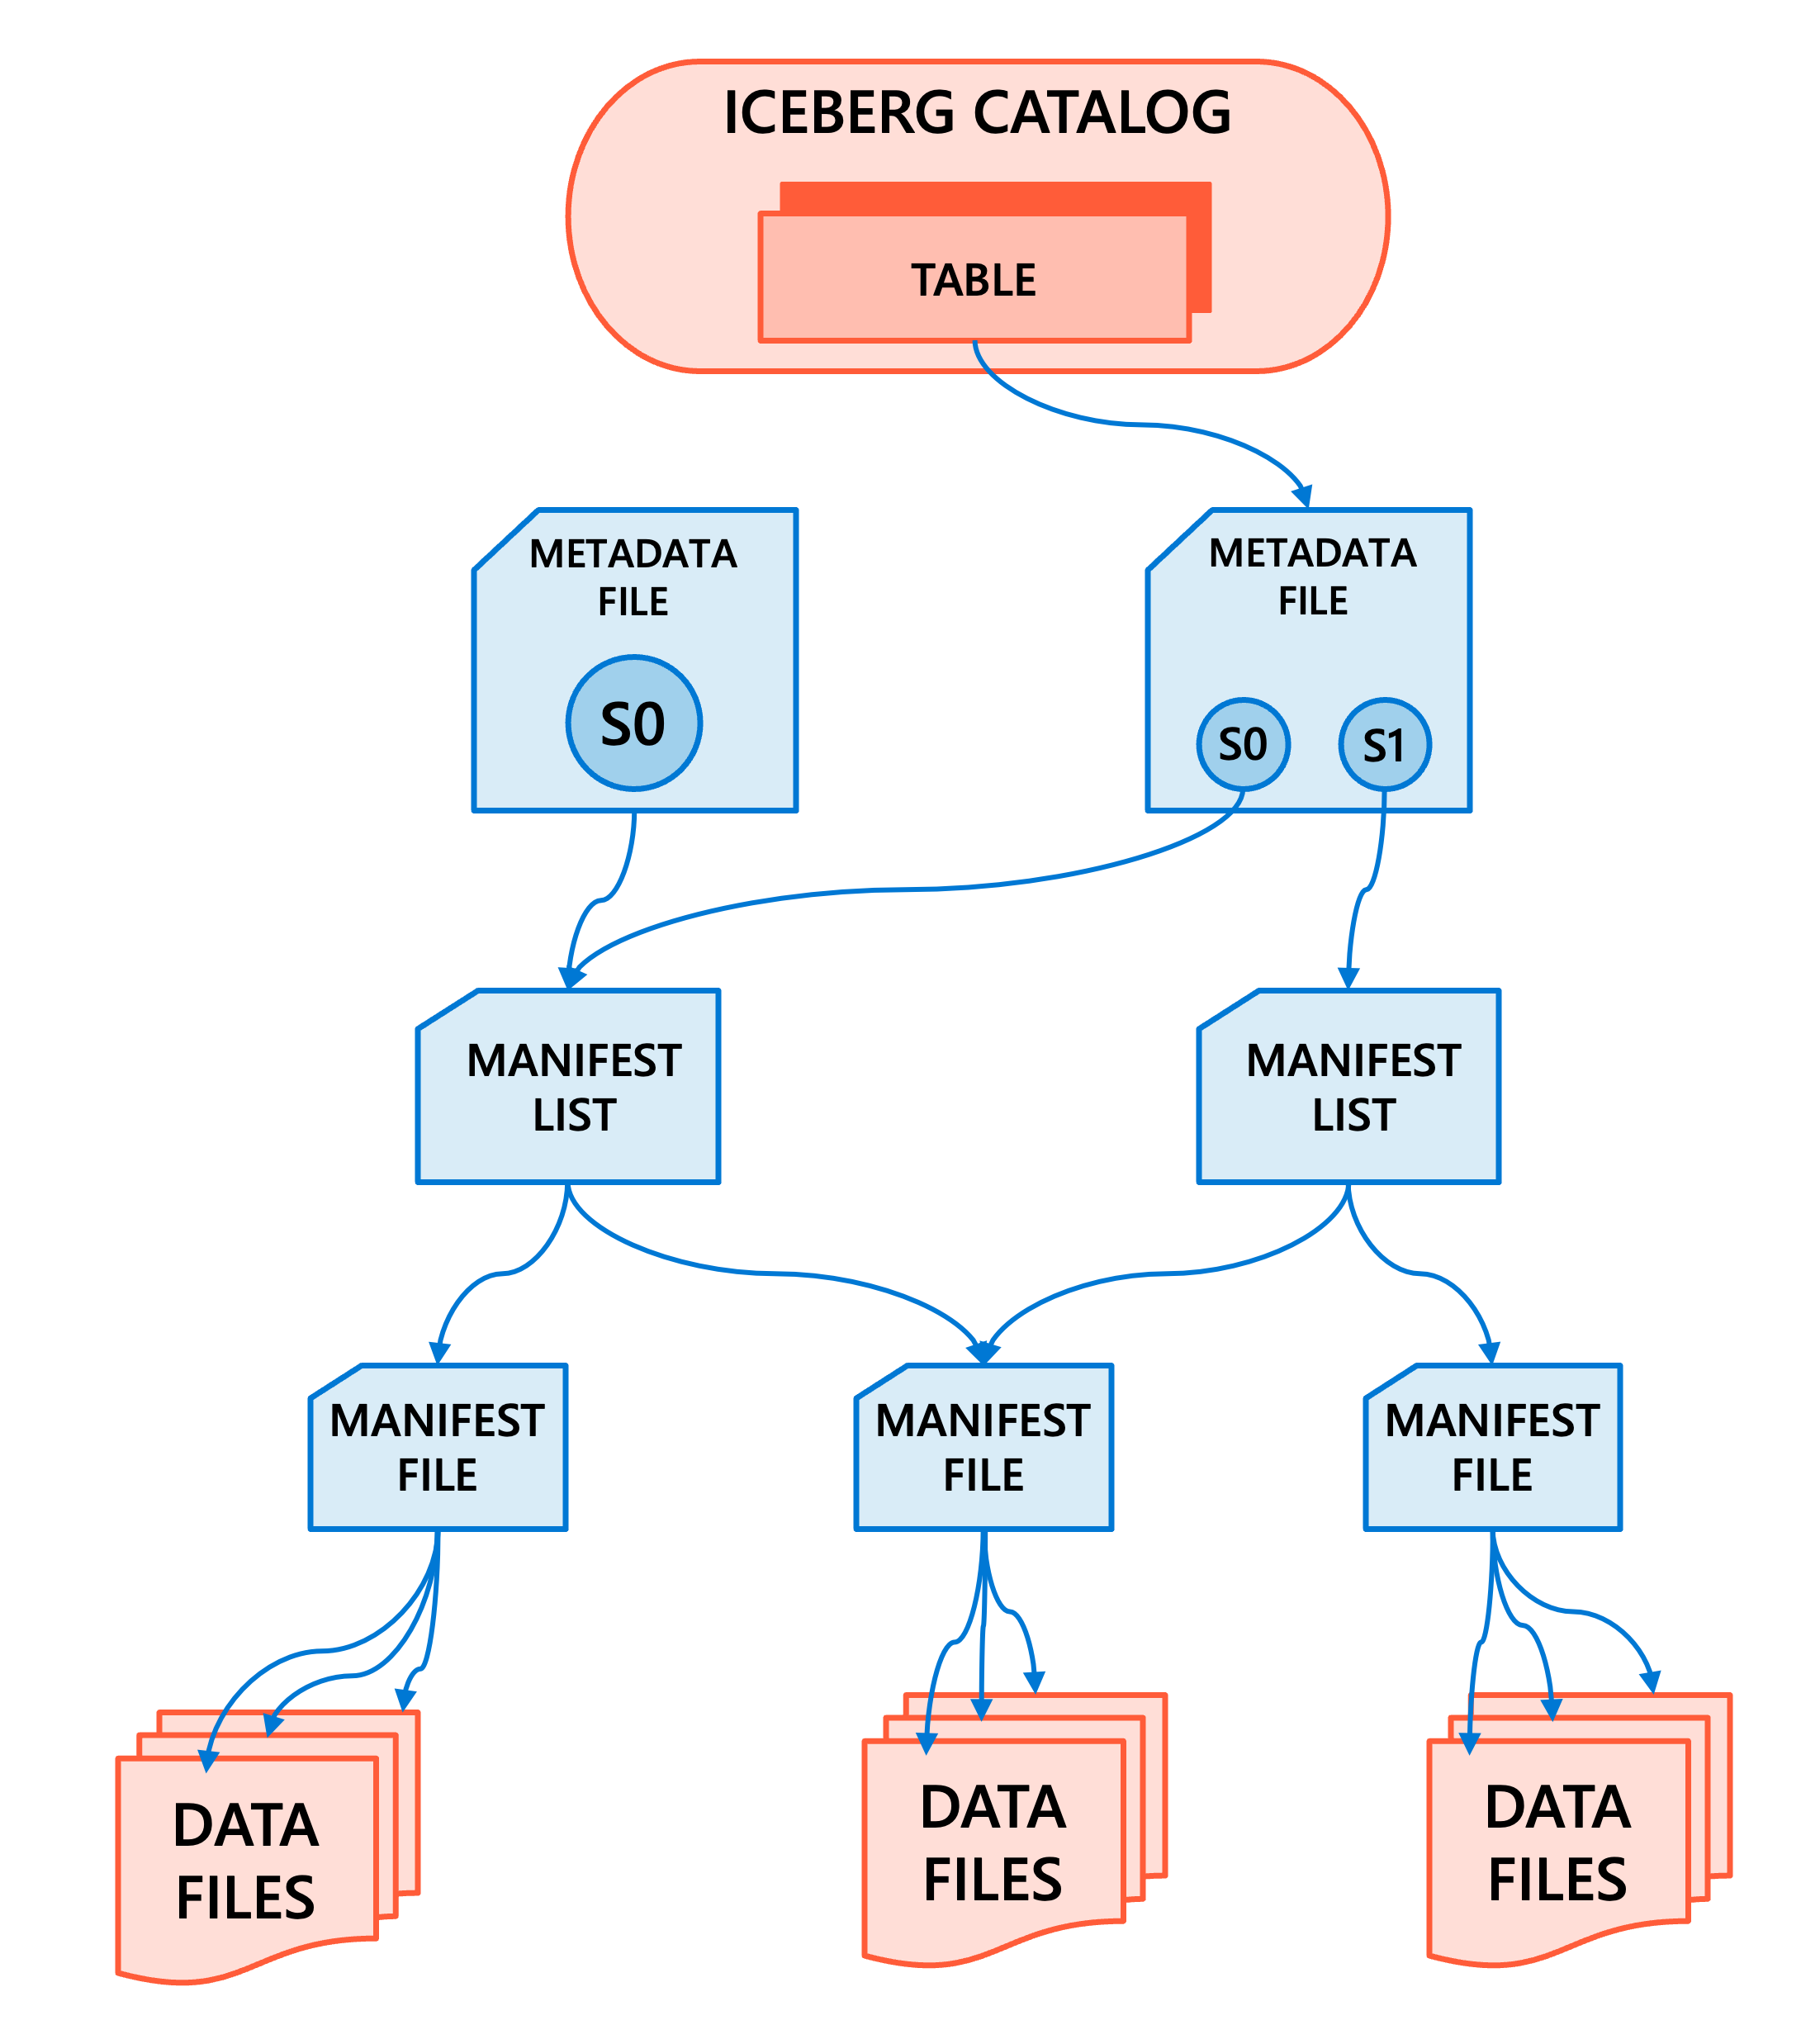
De belangrijkste reden om Iceberg te kiezen is interoperabiliteit. Iceberg wordt veel gebruikt in het gegevensecosysteem, waaronder platforms zoals Snowflake, Amazon Athene, Trino, Apache Spark en Apache Flink. Als uw organisatie workloads uitvoert op meerdere platforms die dezelfde tabellen moeten lezen en schrijven, biedt Iceberg een algemene indeling die alle platforms begrijpen.
Unity Catalog kan Iceberg-tabellen rechtstreeks beheren, zodat Azure Databricks kan fungeren als een Iceberg-catalogus voor externe engines. U kunt ook Iceberg-tabellen lezen die worden beheerd door andere catalogi, zoals AWS Glue of Snowflake Horizon Catalog via externe tabelverbindingen.
Overweeg de Iceberg wanneer:
- Uw gegevens moeten worden geopend door meerdere verwerkingsengines buiten Azure Databricks.
- Uw organisatie is gestandaardiseerd op Iceberg voor het delen van gegevens op meerdere platforms.
- U integreert met systemen die Delta Lake niet ondersteunen.
Voor workloads die voornamelijk worden uitgevoerd in Azure Databricks, blijft Delta Lake de aanbevolen indeling vanwege de diepere platformintegratie- en optimalisatiefuncties.
Wanneer opmaak op basis van rijen van toepassing is
CSV en JSON blijven geldige keuzes voor specifieke scenario's, ook al zijn ze minder efficiënt voor grootschalige analyses.
Gebruik CSV of JSON wanneer:
- U ontvangt gegevens van externe systemen in deze indelingen als een initiële landingszone.
- U hebt leesbare gegevens nodig voor foutopsporing of snelle inspectie.
- U integreert met systemen die alleen op tekst gebaseerde indelingen ondersteunen.
- Gegevensvolumes zijn klein genoeg om prestatieverschillen te verwaarlozen.
Voor permanente opslag van analytische gegevens converteert u binnenkomende CSV- of JSON-bestanden naar Delta Lake-tabellen tijdens opname. Deze conversie legt de efficiëntiewinsten van kolomopslag vast terwijl transactionele garanties worden toegevoegd.
Beslissingscriteria toepassen
Het selecteren van een tabelindeling is afhankelijk van uw specifieke vereisten. Begin met Delta Lake als uw standaardkeuze en evalueer vervolgens alleen alternatieven wanneer hiervoor specifieke beperkingen zijn vereist.
| Overweging | Delta Lake | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Analyseprestaties | Uitstekend | Uitstekend | Slecht |
| ACID-transacties | Yes | Yes | Nee. |
| Tijdreizen | Yes | Yes | Nee. |
| Azure Databricks-integratie | Hoog | Ondersteund | Eenvoudig |
| Platformoverschrijdende compatibiliteit | Groeiend | Wijd | Universal |
| Aanbevolen voor productie | Yes | Ja (wanneer interoperabiliteit vereist is) | Nee (alleen landingszone) |
Uw keuze is ook afhankelijk van organisatiestandaarden. Als uw architectuurteam conventies voor tabelindelingen heeft ingesteld, moet u deze beslissingen afstemmen om consistentie in uw gegevensplatform te behouden.