Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Tworzenie niezawodnego procesu ciągłej integracji i ciągłego dostarczania (CI/CD) dla architektury mikrousług może być trudne. Każdy zespół musi szybko i niezawodnie wydać usługi bez zakłócania działania innych zespołów lub destabilizacji aplikacji jako całości.
W tym artykule opisano przykładowy potok CI/CD do wdrażania mikrousług w usłudze Azure Kubernetes Service (AKS). Każdy zespół i projekt są różne, więc nie należy przyjmować tego artykułu jako zestawu trudnych i szybkich reguł. Zamiast tego, użyj tego jako punktu wyjścia do tworzenia własnego procesu CI/CD.
Poniższa lista podsumowuje cele potoku CI/CD dla mikrousług hostowanych w Kubernetes:
- Zespoły mogą tworzyć i wdrażać swoje usługi niezależnie.
- Zmiany kodu, które przechodzą proces ciągłej integracji, są automatycznie wdrażane w środowisku przypominającym środowisko produkcyjne.
- Każdy etap potoku wymusza bramy jakości.
- Nową wersję usługi można wdrożyć obok poprzedniej wersji.
Aby uzyskać więcej informacji, zobacz artykuł CI/CD w architekturach mikrousług.
Założenia
W tym przykładzie poniżej przedstawiono pewne założenia dotyczące zespołu deweloperów i bazy kodu:
- Repozytorium kodu to monorepo z folderami zorganizowanymi przez mikrousługę.
- Strategia rozgałęziania zespołu opiera się na rozwoju opartym na głównej gałęzi.
- Zespół używa gałęzi wydań do zarządzania wydaniami. Oddzielne wydania są tworzone dla każdej mikrousługi.
- Proces ciągłej integracji/ciągłego wdrażania używa Azure Pipelines do kompilowania, testowania i wdrażania mikrousług do AKS.
- Obrazy kontenerów dla wszystkich mikrousług są przechowywane w jednym udostępnionym wystąpieniu Azure Container Registry z oddzielnym repozytorium dla każdej mikrousługi. Użyj uprawnień ABAC repozytorium usługi Azure Container Registry, aby ograniczyć każdą tożsamość potoku do własnego repozytorium, lub użyj oddzielnych rejestrów tam, gdzie wymagane są silniejsze granice zaufania.
- Zespół używa diagramów Helm do pakowania poszczególnych mikrousług.
- Używany jest model wdrażania wypychanego, gdzie Azure Pipelines i skojarzone agenty wykonują wdrożenia, łącząc się bezpośrednio z klastrem AKS.
Te założenia napędzają wiele konkretnych szczegółów potoku CI/CD. Można jednak dostosować podstawowe podejście opisane tutaj dla innych procesów, narzędzi i usług, takich jak GitHub Actions, Jenkins lub Docker Hub.
Alternatives
Wybierając strategię CI/CD dla AKS, rozważ następujące typowe alternatywy:
Zamiast używać programu Helm jako narzędzia do zarządzania pakietami i wdrażania, można użyć narzędzia Kustomize, natywnego narzędzia do zarządzania konfiguracją platformy Kubernetes, które wprowadza bezpłatny sposób dostosowywania i parametryzacji konfiguracji aplikacji.
Zamiast używać usługi Azure DevOps do obsługi repozytoriów Git i potoków, możesz używać repozytoriów GitHub dla prywatnych i publicznych repozytoriów Git, a GitHub Actions do potoków CI/CD.
GitHub Actions zapewnia integrację z usługą AKS za pomocą szablonów przepływów pracy i obsługuje protokół OpenID Connect (OIDC) do bezpiecznego uwierzytelniania niewymagającego wpisów tajnych w usłudze Azure.
Zamiast korzystać z modelu wdrażania wypychającego, rozważ zarządzanie konfiguracją Kubernetes na dużą skalę przy użyciu podejścia GitOps (modelu wdrażania typu pull). Operator Kubernetes w klastrze, taki jak Flux lub Argo CD , synchronizuje stan klastra na podstawie konfiguracji przechowywanej w repozytorium Git. GitOps eliminuje potrzebę bezpośredniego dostępu potoków do klastra, zmniejsza powierzchnię ataku oraz zapewnia mechanizmy samonaprawiania i wykrywania rozbieżności.
Wskazówka
Podczas oceniania modeli wdrażania opartych na wypychaniach i opartych na ściąganiu (GitOps) należy wziąć pod uwagę wymagania dotyczące obciążenia. Wdrożenia typu push oferują deterministyczne aktualizacje i bezpośrednią kontrolę nad potokiem wdrożeniowym, co sprzyja bezpiecznym praktykom wdrożeniowym. Wdrożenia w modelu pull (GitOps) zapewniają spójność, możliwość audytu i samonaprawę, co sprawia, że są idealnym rozwiązaniem w środowiskach, w których klastry muszą doprowadzać swój stan do stanu pożądanego bez bezpośredniego dostępu z potoku CI/CD do klastra.
Weryfikacyjne kompilacje
Załóżmy, że deweloper pracuje nad mikrousługą o nazwie Delivery Service. Podczas tworzenia nowej funkcji deweloper sprawdza kod w gałęzi funkcji. Zgodnie z konwencją gałęzie funkcji mają nazwę feature/*.
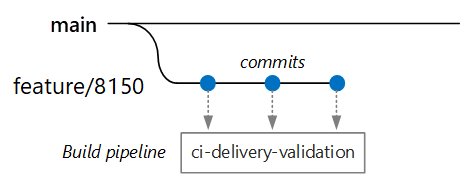
Na diagramie przedstawiono dwie poziome linie gałęzi Git oraz potok kompilowania poniżej tych linii. U góry znajduje się gałąź główna reprezentowana jako linia pozioma. Gałąź feature/8150 różni się od głównej. Ta gałąź ma trzy kropki znajdujące się na niej, łącznie oznaczone jako commity. Z każdego z trzech zatwierdzeń strzałka wskazuje w dół w kierunku pola u dołu diagramu. Pole ma etykietę Potok kompilacji i zawiera nazwę potoku ci-delivery-validation. Wszystkie trzy przerywane strzałki zbiegają się w tym pojedynczym polu procesu kompilacji, co oznacza, że każdy commit do gałęzi feature/8150 powoduje uruchomienie potoku ci-delivery-validation.
Plik definicji kompilacji zawiera wyzwalacz filtrujący według nazwy gałęzi i ścieżki źródłowej:
trigger:
  batch: true
  branches:
    include:
    # for new release to production: release flow strategy
    - release/delivery/v*
    - refs/release/delivery/v*
    - main
    - feature/delivery/*
    - topic/delivery/*
  paths:
    include:
    - /src/shipping/delivery/
Gdy stosujesz to podejście, każdy zespół może mieć własny potok kompilacji. Tylko kod zatwierdzony w folderze /src/shipping/delivery uruchamia kompilację usługi Delivery Service. Wypychanie zatwierdzeń do gałęzi zgodnej z filtrem uruchamia pipeline CI. W tym momencie w workflow kompilacja CI uruchamia podstawową weryfikację kodu:
- Skompiluj kod.
- Uruchamianie testów jednostkowych.
Celem jest skrócenie czasu kompilacji, aby deweloper mógł uzyskać szybką opinię. Gdy zmiana jest gotowa do połączenia z gałęzią main, deweloper otwiera PR. Ta operacja wyzwala kolejną kompilację ciągłej integracji (CI), która przeprowadza kilka dodatkowych kontroli.
- Skompiluj kod.
- Uruchamianie testów jednostkowych.
- Uruchom testy zabezpieczeń aplikacji statycznych (SAST) w kodzie źródłowym.
- Skompiluj obraz kontenera środowiska uruchomieniowego.
- Uruchom skanowanie luk w zabezpieczeniach na obrazie.
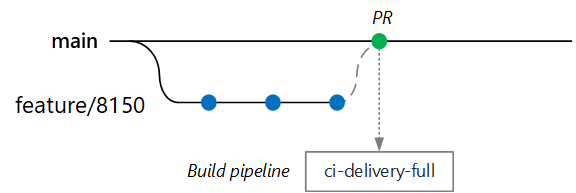
Na diagramie przedstawiono dwie poziome linie gałęzi Git oraz potok kompilacji pod nimi. U góry znajduje się gałąź główna reprezentowana jako linia pozioma. Poniżej niej gałąź feature/8150 biegnie równolegle i ma na niej trzy kropki oznaczające commity. Na prawym końcu gałęzi feature/8150 strzałka kreskowana łączy się z punktem w gałęzi głównej. Ten punkt jest oznaczony dodatkową kropką z etykietą PR, co wskazuje, że otwarto pull request względem gałęzi main. Od punktu PR w gałęzi głównej kreskowana strzałka prowadzi w dół do pola oznaczonego etykietą „Build pipeline”, które zawiera nazwę potoku ci-delivery-full. Ten wiersz pokazuje, że otwarcie pull requestu z gałęzi funkcjonalnej do gałęzi main uruchamia pipeline ci-delivery-full, który wykonuje rozszerzony zestaw kontroli CI.
Note
W Azure Repos jednej z usług w Azure DevOps można zdefiniować zasady ochrony gałęzi. Na przykład polityka może wymagać pomyślnego kompilowania w CI oraz akceptacji osoby zatwierdzającej przed scaleniem do gałęzi main.
Pełne procesy CI/CD
Gdy zespół jest gotowy do wdrożenia nowej wersji usługi Delivery Service, kierownik wydania tworzy gałąź na podstawie gałęzi głównej, zgodnie z następującym wzorcem nazewnictwa: release/<microservice name>/<semver>. Na przykład release/delivery/v1.0.2.
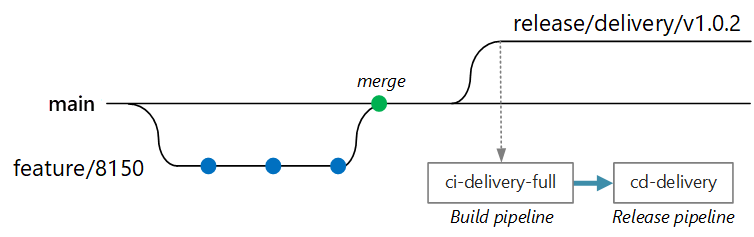
Utworzenie tej gałęzi uruchamia pełny proces CI, który obejmuje wszystkie poprzednie kroki oraz następujące kroki:
- Wypchnij obraz kontenera do usługi Container Registry. Obraz jest oznaczony numerem wersji w nazwie gałęzi.
- Uruchom
helm package, aby spakować chart Helm dla usługi. Wykres jest również oznaczony numerem wersji. - Prześlij pakiet Helm do Container Registry.
Jeśli ta kompilacja zakończy się pomyślnie, wyzwala proces wdrażania (CD) przy użyciu potoku wydania Azure Pipelines. Ten potok zawiera następujące kroki:
- Wdróż Helm chart w środowisku testowym QA.
- Osoba zatwierdzająca zatwierdza pakiet przed przeniesieniem do produkcji. Zobacz Kontrola wdrażania wersji przy użyciu aprobat.
- Oznacz ponownie obraz Docker w produkcyjnej przestrzeni nazw w usłudze Container Registry. Jeśli na przykład bieżący tag to
myrepo.azurecr.io/delivery:v1.0.2, tag produkcyjny tomyrepo.azurecr.io/prod/delivery:v1.0.2. - Wdróż wykres Helm w środowisku produkcyjnym.
Nawet w ramach monorepo ogranicz zakres tych zadań do poszczególnych mikrousług, aby zespoły mogły wdrażać je niezależnie. Proces obejmuje kilka ręcznych kroków: zatwierdzanie PR-ów, tworzenie gałęzi wydań oraz zatwierdzanie wdrożeń do klastra produkcyjnego. Zespoły ds. obciążeń mogą zautomatyzować te kroki, jeśli chcą.
Izolacja środowisk
Wdrażasz usługi w wielu środowiskach, w tym w środowiskach deweloperskich, do testów dymnych, integracyjnych, obciążeniowych oraz produkcyjnych. Te środowiska wymagają pewnego poziomu izolacji. Na platformie Kubernetes można wybrać między izolacją fizyczną a izolacją logiczną. Izolacja fizyczna jest wdrażana w oddzielnych klastrach. Izolacja logiczna wykorzystuje przestrzenie nazw i polityki.
Naszym zaleceniem jest utworzenie dedykowanego klastra produkcyjnego wraz z oddzielnym klastrem dla środowisk deweloperskich/testowych. Użyj izolacji logicznej, aby oddzielić środowiska w klastrze deweloperskim/testowym. Usługi wdrożone w klastrze deweloperskim/testowym nigdy nie powinny mieć dostępu do magazynów danych, które przechowują dane biznesowe.
Aby wymusić izolację w klastrze, wykonaj następujące czynności:
-
Przestrzenie nazw: użyj przestrzeni nazw Platformy Kubernetes do logicznego oddzielenia środowisk (na przykład ,
dev,stagingqa). - Zasady sieci: zastosuj zasady sieci Kubernetes, aby zablokować komunikację między zasobnikami w różnych przestrzeniach nazw.
- Przydziały zasobów: stosowanie przydziałów zasobów na przestrzeń nazw, aby zapobiec problemom z hałaśliwymi sąsiadami w udostępnionych klastrach.
- Integracja Microsoft Entra ID: Połącz uwierzytelnianie Microsoft Entra ID z mechanizmem RBAC platformy Kubernetes i usługą Microsoft Entra ID, aby określić, którzy użytkownicy i grupy Microsoft Entra ID mogą uzyskać dostęp do każdej przestrzeni nazw.
Uwierzytelnianie i autoryzacja
W miarę możliwości używaj uwierzytelniania bez użycia sekretów, zarówno w przypadku potoków wdrażających mikrousługi, jak i obciążeń roboczych wdrażanych przez te potoki:
- Federacja tożsamości obciążeń dla potoków: W usłudze Azure Pipelines użyj połączenia usługi opartego na federacji tożsamości obciążeń, aby uwierzytelniać się na platformie Azure bez przechowywania długoterminowych wpisów tajnych nazwy głównej usługi. W przypadku GitHub Actions skonfiguruj funkcję OIDC, aby osiągnąć to samo uwierzytelnianie bezskryte.
- Tożsamość obciążeń Microsoft Entra dla wdrożonych obciążeń roboczych: Skonfiguruj mikrousługi wdrażane przez potok tak, aby korzystały z Tożsamość obciążeń Microsoft Entra zamiast wstrzykiwania poświadczeń za pomocą manifestów, wartości Helm lub wpisów tajnych Kubernetes. Identyfikator obciążenia sfederuje konta usługi Kubernetes z Microsoft Entra ID, dzięki czemu zasobniki mogą uwierzytelniać się w usługach Azure (takich jak Azure Key Vault, Container Registry lub Azure SQL) bez zarządzania wpisami tajnymi przez potok.
Zarządzanie tajemnicami
Nigdy nie osadzaj sekretów (parametrów połączeń, kluczy API, haseł do bazy danych) bezpośrednio w kodzie źródłowym, plikach Dockerfile, plikach values Helm ani w definicjach potoków. Zamiast:
- Przechowuj tajemnice w usłudze Key Vault.
- Użyj dostawcy usługi Key Vault dla sterownika Secrets Store CSI Driver, aby zamontować wpisy tajne bezpośrednio w podach w postaci woluminów lub zmiennych środowiskowych. Takie podejście sprawia, że sekrety nie są przechowywane w obiektach Kubernetes
Secret, które są kodowane w base64, a domyślnie nie są szyfrowane. - W przypadku wpisów tajnych potoku użyj integracji usługi Key Vault z usługą Azure Pipelines lub wpisów tajnych GitHub Actions.
- Włącz funkcje Key Vault: usuwanie niejawne i ochronę przed trwałym usunięciem, aby chronić przed przypadkowym lub złośliwym usunięciem wpisu tajnego.
Ważna
Unikaj przechowywania długoterminowych poświadczeń (kluczy tajnych klienta, certyfikatów lub haseł) w zmiennych potoku, zmiennych środowiskowych lub sekretach Kubernetes. Zamiast tego stosuj tożsamości zarządzane i poświadczenia federacyjne, aby zmniejszyć nakład pracy związany z rotacją poświadczeń i ograniczyć powierzchnię ataku.
Proces kompilacji
Jeśli to możliwe, spakuj proces kompilacji do kontenera platformy Docker. Ta konfiguracja umożliwia tworzenie artefaktów kodu przy użyciu platformy Docker bez konfigurowania środowiska kompilacji na każdej maszynie kompilacji. Konteneryzowany proces kompilacji upraszcza skalowanie potoku ciągłej integracji przez dodanie nowych agentów kompilacji. Ponadto każdy deweloper zespołu może skompilować kod, uruchamiając kontener kompilacji.
Korzystając z wieloetapowych kompilacji w Dockerze, można zdefiniować środowisko kompilacji i obraz uruchomieniowy w jednym pliku Dockerfile. Na przykład następujący plik Dockerfile tworzy aplikację .NET 10:
FROM mcr.microsoft.com/dotnet/aspnet:10.0 AS base
USER app
WORKDIR /app
EXPOSE 8080

FROM mcr.microsoft.com/dotnet/sdk:10.0 AS build
WORKDIR /src/Fabrikam.Workflow.Service

COPY Fabrikam.Workflow.Service/Fabrikam.Workflow.Service.csproj .
RUN dotnet restore Fabrikam.Workflow.Service.csproj

COPY Fabrikam.Workflow.Service/. .
RUN dotnet build Fabrikam.Workflow.Service.csproj -c Release -o /app/build --no-restore

FROM build AS testrunner
WORKDIR /src/tests

COPY Fabrikam.Workflow.Service.Tests/*.csproj .
RUN dotnet restore Fabrikam.Workflow.Service.Tests.csproj

COPY Fabrikam.Workflow.Service.Tests/. .
ENTRYPOINT ["dotnet", "test", "--logger:trx"]

FROM build AS publish
RUN dotnet publish Fabrikam.Workflow.Service.csproj -c Release -o /app/publish

FROM base AS final
WORKDIR /app
COPY --from=publish /app/publish .
ENTRYPOINT ["dotnet", "Fabrikam.Workflow.Service.dll"]
Ten plik Dockerfile definiuje kilka etapów kompilacji. Zwróć uwagę, że etap o nazwie base używa obrazu środowiska uruchomieniowego ASP.NET dla platformy .NET 10, podczas gdy etap o nazwie build używa pełnego zestawu SDK platformy .NET 10. Etap build kompiluje projekt .NET. Jednak końcowy kontener środowiska uruchomieniowego jest tworzony z base, który zawiera tylko środowisko uruchomieniowe i jest znacznie mniejszy niż pełny obraz zestawu SDK.
Ważna
Począwszy od .NET 8, oficjalne obrazy kontenerów .NET oparte na systemie Linux obejmują użytkownika innego niż główny o nazwie app. Instrukcja USER app w pliku Dockerfile uruchamia kontener jako tego nieuprzywilejowanego użytkownika, zgodnie z zasadą najmniejszych uprawnień. Obrazy kontenerów platformy ASP.NET Core również zmieniły domyślny port nasłuchiwania z 80 na 8080.
Tworzenie uruchamiacza testów
Innym dobrym rozwiązaniem jest uruchamianie testów jednostkowych w kontenerze. Na przykład poniższy kod przedstawia część pliku Dockerfile, który kompiluje moduł uruchamiający testy:
FROM build AS testrunner
WORKDIR /src/tests

COPY Fabrikam.Workflow.Service.Tests/*.csproj .
RUN dotnet restore Fabrikam.Workflow.Service.Tests.csproj

COPY Fabrikam.Workflow.Service.Tests/. .
ENTRYPOINT ["dotnet", "test", "--logger:trx"]
Deweloper może użyć tego pliku Dockerfile do uruchamiania testów lokalnie:
docker build . -t delivery-test:1 --target=testrunner
docker run delivery-test:1
Pipeline CI powinien również uruchamiać testy w ramach etapu weryfikacji kompilacji.
Ten plik używa polecenia Docker ENTRYPOINT, a nie polecenia Docker RUN, do uruchamiania testów.
- Jeśli używasz
RUNpolecenia , testy są uruchamiane za każdym razem, gdy kompilujesz obraz. Jeśli używaszENTRYPOINT, testy są opcjonalne. Są one uruchamiane tylko w przypadku jawnego określania celu etaputestrunner. - Test kończący się niepowodzeniem nie powoduje niepowodzenia polecenia platformy Docker
build. To zachowanie umożliwia odróżnienie niepowodzeń kompilacji kontenera od niepowodzeń testów. - Wyniki testów można zapisać na zainstalowanym woluminie.
Najlepsze rozwiązania dotyczące kontenerów
Oto kilka innych najlepszych rozwiązań, które należy wziąć pod uwagę w przypadku kontenerów:
- Zdefiniuj konwencje dla całej organizacji dotyczące tagów kontenerów, przechowywania wersji i konwencji nazewnictwa zasobów wdrożonych w klastrze (na przykład zasobników i usług). Użycie tych konwencji może ułatwić diagnozowanie problemów z wdrażaniem.
- Podczas cyklu rozwoju i testowania proces ciągłej integracji/ciągłego wdrażania tworzy wiele obrazów kontenerów. Tylko niektóre z tych obrazów są kandydatami do wydania, a tylko niektórzy z tych kandydatów do wydania awansują do produkcji. Miej jasną strategię wersjonowania, aby wiedzieć, które obrazy są obecnie wdrożone w środowisku produkcyjnym, oraz aby w razie potrzeby móc łatwo przywrócić poprzednią wersję.
- Zawsze wdrażaj określone tagi wersji kontenera, a nie
latest. - Użyj przestrzeni nazw w usłudze Container Registry, aby oddzielić obrazy dopuszczone do środowiska produkcyjnego od obrazów, które są nadal testowane. Nie przenosij obrazu do produkcyjnej przestrzeni nazw, dopóki nie będzie można go wdrożyć w środowisku produkcyjnym. Połączenie tej praktyki z semantycznym wersjonowaniem obrazów kontenerów może zmniejszyć ryzyko przypadkowego wdrożenia wersji, która nie została zatwierdzona do publikacji.
- Postępuj zgodnie z zasadą najniższych uprawnień, uruchamiając kontenery jako nieuprzywilejowanego użytkownika. W Kubernetes użyj Pod Security Standards wraz z mechanizmem Pod Security admission (który zastąpił wycofane Pod Security Policies w Kubernetes 1.25), aby wymuszać ograniczenia, na przykład uniemożliwiać uruchamianie kontenerów jako użytkownik root. Użyj profilu
restricteddla obciążeń produkcyjnych. - Użyj minimalnych lub distroless obrazów bazowych (na przykład obrazów opartych na Alpine, obrazów bazowych Azure Linux lub obrazów distroless albo okrojonych obrazów platformy .NET), aby zmniejszyć powierzchnię ataku obrazów kontenerów.
- W przypadku rejestrów w warstwie Premium skonfiguruj zasady przechowywania usługi Container Registry , aby usunąć nieotagowane manifesty. Aby usuwać tagi według wieku lub nazwy, zaplanuj zadanie rejestru kontenerów uruchamiające polecenie acr purge. Zachowaj obrazy, do których odwołują się aktywne wdrożenia i plany wycofywania.
Tabele Helm
Rozważ użycie programu Helm do zarządzania tworzeniem i wdrażaniem usług. Następujące funkcje Helm wspierają proces CI/CD:
- Pojedyncza mikrousługa jest często definiowana przez wiele obiektów Kubernetes. Helm umożliwia spakowanie tych obiektów w pojedynczy chart Helm.
- Wykres można wdrożyć przy użyciu jednego polecenia helm, a nie serii poleceń kubectl.
- Wykresy są jawnie wersjonowane. Użyj programu Helm, aby wydać wersję, przeglądać wydania i przywrócić poprzednią wersję. Helm używa wersjonowania semantycznego do śledzenia aktualizacji i zmian.
- Wykresy programu Helm używają szablonów, aby uniknąć duplikowania informacji, takich jak etykiety i selektory, w wielu plikach.
- Program Helm może zarządzać zależnościami między wykresami.
- Wykresy można przechowywać w repozytorium programu Helm, takim jak Usługa Container Registry, i integrować je z potokiem kompilacji.
Aby uzyskać więcej informacji, zobacz Use Container Registry as a Helm repository for your application charts (Używanie usługi Container Registry jako repozytorium Helm dla wykresów aplikacji).
Pojedyncza mikrousługa może wymagać wielu plików konfiguracji platformy Kubernetes. Aby zaktualizować usługę, może być konieczne edytowanie wszystkich tych plików w celu zaktualizowania selektorów, etykiet i tagów obrazów. Helm traktuje te pliki jako pojedynczy pakiet nazywany chart i ułatwia aktualizowanie plików YAML za pomocą zmiennych. Program Helm używa języka szablonu (opartego na szablonach języka Go), który umożliwia pisanie sparametryzowanych plików konfiguracji YAML.
Oto na przykład część pliku YAML definiującego wdrożenie:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: {{ include "package.fullname" . | replace "." "" }}
  labels:
    app.kubernetes.io/name: {{ include "package.name" . }}
    app.kubernetes.io/instance: {{ .Release.Name }}
  annotations:
    kubernetes.io/change-cause: {{ .Values.reason }}

...

spec:
  template:
    spec:
      containers:
      - name: &package-container_name fabrikam-package
        image: {{ .Values.dockerregistry }}/{{ .Values.image.repository }}:{{ .Values.image.tag }}
        imagePullPolicy: {{ .Values.image.pullPolicy }}
        env:
        - name: LOG_LEVEL
          value: {{ .Values.log.level }}
Zobaczysz, że nazwa wdrożenia, etykiety i specyfikacje kontenera używają wszystkich parametrów szablonu, które podajesz w czasie wdrażania. Na przykład z wiersza polecenia:
helm install <release-name> oci://<registry>/<repository>/<package-chart-name> --version <desiredVersion> \
     --set image.tag=0.1.0 \
     --set image.repository=package \
     --set dockerregistry=$ACR_SERVER \
     --namespace backend
Chociaż potok CI/CD może zainstalować chart bezpośrednio w Kubernetes, utwórz archiwum chartu (plik .tgz) i wypchnij chart do repozytorium Helm, takiego jak Container Registry. Aby uzyskać więcej informacji, zobacz Tworzenie pakietów i wdrażanie wykresów Helm (zadanie HelmDeploy).
Revisions
Charty Helm zawsze mają numer wersji, który musi być zgodny z wersjonowaniem semantycznym. Wykres może również mieć element appVersion. To pole jest opcjonalne i nie musi być powiązane z wersją wykresu. Niektóre zespoły mogą chcieć wersjonować aplikacje niezależnie od aktualizacji wykresów. Prostszą metodą jest użycie jednego numeru wersji, więc istnieje relacja 1:1 między wersją wykresu a wersją aplikacji. Dzięki temu można przechowywać jeden wykres na wydanie i łatwo wdrożyć odpowiednią wersję:
helm install <package-chart-name> --version <desiredVersion>
Innym dobrym rozwiązaniem jest zapewnienie adnotacji powodującej zmianę w szablonie wdrożenia:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: {{ include "delivery.fullname" . | replace "." "" }}
  labels:
     ...
  annotations:
    kubernetes.io/change-cause: {{ .Values.reason }}
Ta adnotacja umożliwia wyświetlenie pola przyczyny zmiany dla każdej wersji za pomocą polecenia kubectl rollout history. W poprzednim przykładzie przyczyna zmiany jest podawana jako parametr wykresu Helm.
kubectl rollout history deployments/delivery-v010 -n backend
deployment.apps/delivery-v010
REVISION  CHANGE-CAUSE
1         Initial deployment
Możesz również użyć helm list polecenia , aby wyświetlić historię poprawek:
helm list -n backend
NAME              NAMESPACE   REVISION    UPDATED                                 STATUS      CHART               APP VERSION
delivery-v0.1.0   backend     1           2024-04-07 00:25:30.000000 +0000 UTC    deployed    delivery-v0.1.0     v0.1.0
Azure Pipelines
Azure Pipelines, usługa w Azure DevOps, ma dwa typy potoków: potoki kompilacji i potoki wdrażania. Potok kompilacji uruchamia proces CI i tworzy artefakty kompilacji. W przypadku architektury mikrousług na platformie Kubernetes te artefakty to obrazy kontenerów i wykresy helm definiujące każdą mikrousługę. Potok wdrażania uruchamia proces ciągłego dostarczania (CD), który wdraża mikrousługę do klastra.
Na podstawie przepływu CI opisanego wcześniej w tym artykule pipeline kompilacji może składać się z następujących zadań:
- Zbuduj kontener programu uruchamiającego testy za pomocą zadania
Docker. - Uruchom testy, wywołując
docker runw kontenerze uruchamiającym testy za pomocą zadaniaDocker. - Opublikuj wyniki testu przy użyciu
PublishTestResultszadania . Aby uzyskać więcej informacji, zobacz Tworzenie obrazu. - Uruchom SAST w kodzie źródłowym.
- Skompiluj kontener uruchomieniowy, używając lokalnego środowiska
docker buildi zadaniaDockerlub kompilacji w usłudze Container Registry i zadaniaAzureCLI. Wygeneruj wykaz składników oprogramowania (SBOM) dla obrazu, na przykład za pomocą narzędzia Microsoft SBOM, a następnie opublikuj go jako artefakt potoku skojarzony ze skrótem obrazu lub dołącz go do obrazu w usłudze Container Registry. - Uruchom skanowanie w poszukiwaniu luk w zabezpieczeniach obrazu kontenera (na przykład przy użyciu Microsoft Defender dla kontenerów lub narzędzia innego niż Microsoft, takiego jak Trivy), aby wykryć znane luki w zabezpieczeniach przed opublikowaniem obrazu.
- Wypchnij obraz kontenera do usługi Container Registry (lub innego rejestru kontenerów) za pomocą zadania
DockerlubAzureCLI. - Podpisz przesłany obraz za pomocą niezmiennego skrótu, aby zapewnić jego integralność i autentyczność. W przypadku usługi Azure Pipelines postępuj zgodnie ze wskazówkami dotyczącymi podpisywania Notation.
- Spakuj chart Helm za pomocą zadania
HelmDeploy. - Wypchnij pakiet Helm do rejestru kontenerów Container Registry (lub innego repozytorium Helm) za pomocą zadania
HelmDeploy.
Dane wyjściowe z pipeline CI to obraz kontenera gotowy do produkcji i zaktualizowany Helm chart dla mikrousługi. W tym momencie pipeline wdrażania może zająć się procesem. Każda mikrousługa ma oddzielny potok wdrożeniowy. Potok wydawniczy jest skonfigurowany tak, aby źródło wyzwalacza zostało ustawione na pipeline ciągłej integracji, który opublikował artefakt. Ten potok umożliwia niezależne wdrażanie każdej mikrousługi. Potok wdrażania wykonuje następujące czynności:
- Wdróż pakiet Helm w środowiskach deweloperskich/testowych/przygotowawczych. Możesz użyć
helm upgradepolecenia z flagą--install, aby obsługiwać pierwszą instalację i kolejne uaktualnienia. - Poczekaj na zatwierdzenie lub odrzucenie wdrożenia przez osoby zatwierdzające.
- Ponownie zataguj obraz kontenera na potrzeby wydania.
- Prześlij tag wydania do rejestru kontenerów.
- Wdróż wykres Helm w klastrze produkcyjnym. Użyj Ratify with Azure Policy, aby weryfikować podpisy obrazów podczas kontroli dopuszczenia, a następnie oddzielnie skonfiguruj zasadę dozwolonych obrazów, aby ograniczyć obrazy do tych pochodzących z zaufanych rejestrów.
Note
Aby umożliwić usłudze AKS ściąganie obrazów z usługi Container Registry bez oddzielnych poświadczeń ściągania obrazów, użyj integracji AKS z Container Registry w przypadku rejestru korzystającego z mechanizmu RBAC obejmującego cały rejestr. W przypadku rejestru z włączoną usługą ABAC ta integracja nie jest obsługiwana. Zamiast tego przypisz rolę Container Registry Repository Reader do tożsamości zarządzanej przez kubelet klastra.
Aby uzyskać więcej informacji na temat tworzenia potoku wydania, zobacz Release pipelines, draft releases, and release options (Potoki wydania, wersje robocze i opcje wydania).
Na poniższym diagramie przedstawiono pełny proces ciągłej integracji/ciągłego wdrażania opisany w tym artykule:
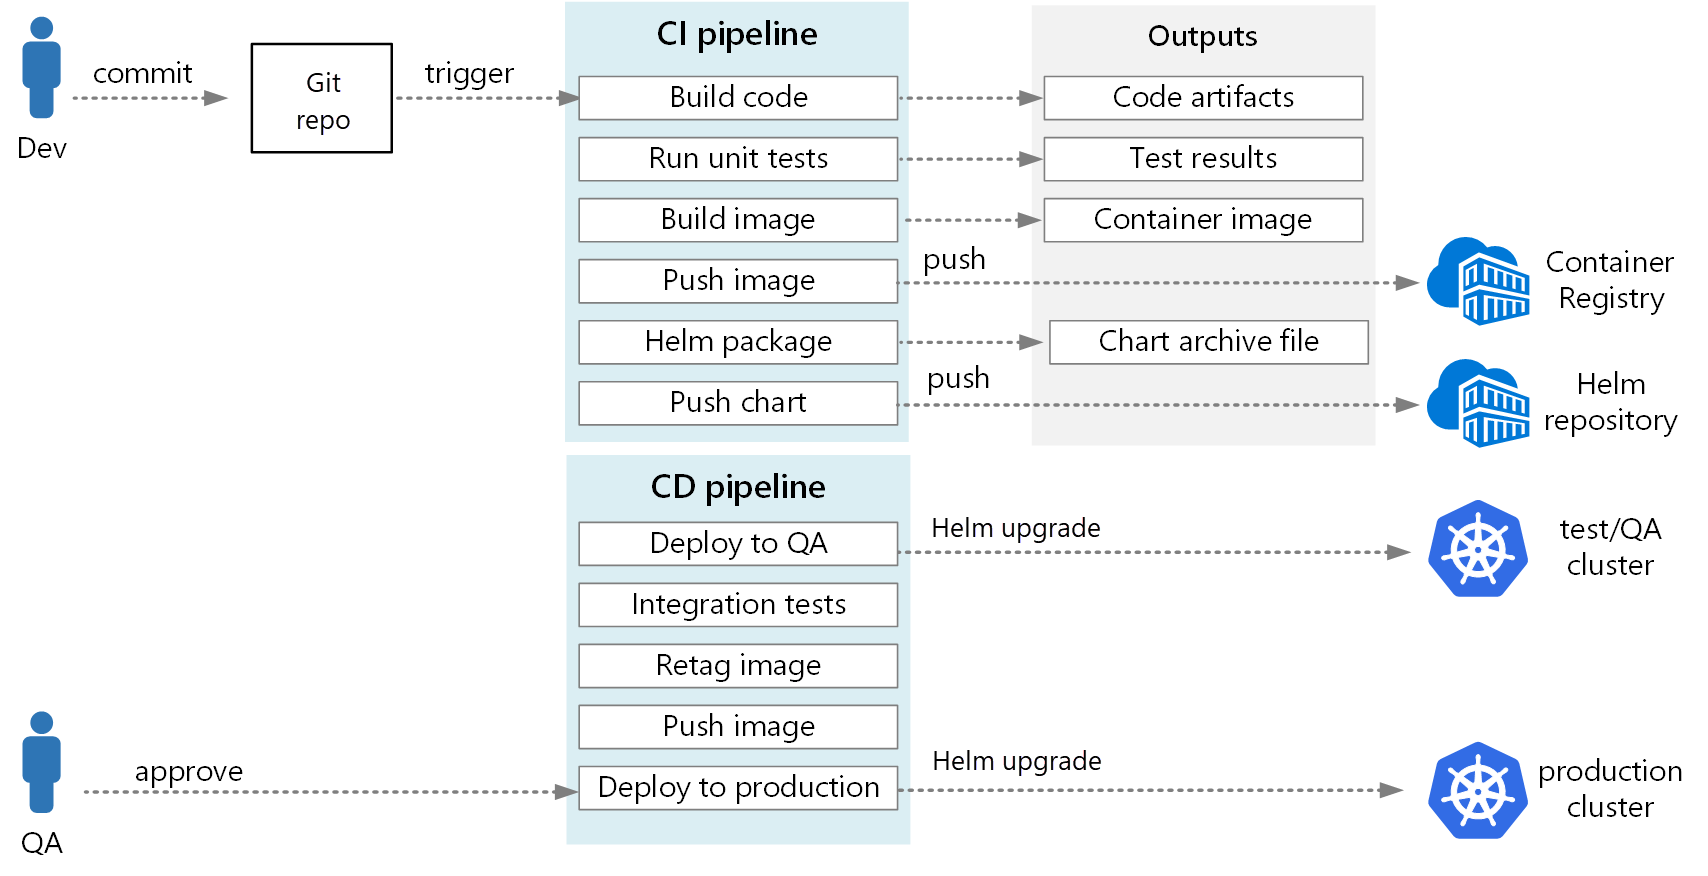
alternatywa dla GitHub Actions
Jeśli Twój zespół używa GitHuba do kontroli wersji, GitHub Actions oferuje równoważną platformę CI/CD. Oprócz wspomnianych wcześniej początkowych przepływów pracy i uwierzytelniania OIDC należy wziąć pod uwagę następujące funkcje specyficzne dla GitHub, gdy celem jest usługa AKS:
- Środowiska i reguły ochrony. Jeśli GitHub plan i widoczność repozytorium obsługują je, użyj środowisk GitHub z wymaganymi recenzentami, czasomierzami oczekiwania i gałęziami wdrażania, aby zaimplementować bramy zatwierdzania.
- Skanowanie kontenerów. Użyj akcji z GitHub Actions Marketplace dla narzędzi Trivy, Microsoft Defender dla DevOps lub podobnych narzędzi do skanowania obrazów kontenerów bezpośrednio w swoim przepływie pracy.
Obserwowanie i monitorowanie
Wdróż monitorowanie i obserwowalność w całym potoku CI/CD oraz w środowisku uruchomieniowym:
- Monitorowanie potoku. Śledź czasy trwania kompilacji, współczynniki testów, częstotliwość wdrażania i współczynniki błędów. Azure DevOps zapewnia wbudowaną analizę. GitHub Actions mogą korzystać z pulpitów nawigacyjnych innych firm niż Microsoft.
- Monitorowanie środowiska uruchomieniowego. Użyj usługi zarządzanej Azure Monitor dla rozwiązania Prometheus i Azure Managed Grafana, aby monitorować kondycję i metryki obciążenia klastra usługi AKS.
- Telemetria aplikacji. Instrumentuj mikrousługi przy użyciu Azure Monitor Application Insights na potrzeby śledzenia rozproszonego, rejestrowania żądań i monitorowania zależności.
- Alarmowanie. Skonfiguruj alerty o niepowodzeniach wdrażania, ponownych uruchomieniach zasobników, wysokim wskaźniku błędów i przeciążeniu zasobów, aby umożliwić szybką reakcję na incydenty.
Zgodność z Well-Architected Framework
Projektując potok ciągłej integracji i ciągłego wdrażania dla mikrousług w Kubernetes, weź pod uwagę filary Struktury Azure Well-Architected:
| Filar | Considerations |
|---|---|
| Niezawodność | Strategie automatycznego wycofywania zmian, sondy kondycji wdrożeń, strategie wdrażania blue-green lub canary, budżety zakłóceń dla podów. |
| Security | Uwierzytelnianie bez wpisów tajnych (identyfikator obciążenia, OIDC), podpisywanie obrazów, zabezpieczenia łańcucha dostaw, kontrola dostępu oparta na rolach z najmniejszymi uprawnieniami, zasady sieciowe. |
| Optymalizacja kosztów | Właściwy dobór rozmiaru agentów kompilacji, korzystanie z efemerycznych, samodzielnie hostowanych modułów uruchamiających, wdrożenie zasad przechowywania obrazów w rejestrze kontenerów oraz używanie pul węzłów typu spot wyłącznie na potrzeby nieprodukcyjnych obciążeń tolerujących przerwy w działaniu. |
| Doskonałość operacyjna | GitOps dla wdrożeń deklaratywnych, Infrastructure as Code, Pipeline as Code (YAML), observability oraz automatyzacji runbooków. |
| wydajność | Równoległe etapy potoków, buforowanie kompilacji (buforowanie warstw platformy Docker, buforowanie zależności), automatyczne skalowanie zasobników w poziomie. |
Współautorzy
Microsoft utrzymuje ten artykuł. Następujący współautorzy napisali ten artykuł.
Główny autor:
- Ray Kao | Główny inżynier rozwiązań
Aby wyświetlić niepubliczne profile serwisu LinkedIn, zaloguj się do serwisu LinkedIn.
Następne kroki
- Adopt a Git branching strategy (Stosowanie strategii rozgałęziania systemu Git)
- Co to jest Azure Pipelines?
- Potoki wydania, wersje robocze i opcje wydania
- Kontrola wdrożenia przy użyciu zatwierdzeń
- Wprowadzenie do usługi Azure Container Registry
- Tożsamość obciążeń Microsoft Entra z usługą AKS
- Dostawca Azure Key Vault dla sterownika Secrets Store CSI
- Metodyka DevSecOps w usłudze AKS