Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Kontroluj szybkość wysyłania żądań do usługi przez aplikację, aby utrzymać się w granicach ograniczania przepustowości usługi i ogólnej pojemności. Takie podejście pomaga uniknąć lub zminimalizować błędy ograniczania przepustowości i dokładniej przewidywać przepływność.
Ograniczanie szybkości jest odpowiednie w wielu scenariuszach, ale jest szczególnie przydatne w przypadku dużych, powtarzalnych zautomatyzowanych zadań, takich jak przetwarzanie wsadowe.
Kontekst i problem
Wykonywanie dużej liczby operacji względem usługi z ograniczaną przepustowością może skutkować zwiększonym ruchem i zmniejszoną przepustowością, ponieważ trzeba śledzić odrzucone żądania, a następnie ponawiać operacje. W miarę wzrostu liczby operacji limit ograniczania przepustowości może wymagać wielu przebiegów ponownego uwierzytelniania danych, co skutkuje większym wpływem na wydajność.
Na przykład rozważmy następujący problematyczny proces ponawiania prób po wystąpieniu błędu podczas ładowania danych do usługi Azure Cosmos DB:
Aplikacja musi pozyskiwać 10 000 rekordów do usługi Azure Cosmos DB. Każdy rekord kosztuje 10 jednostek żądań (RU) do zaimportowania, więc do ukończenia zadania łącznie potrzeba 100 000 RU.
Instancja usługi Azure Cosmos DB ma przydzieloną przepustowość 20 000 jednostek RU.
Wszystkie 10 000 rekordów jest wysyłanych do usługi Azure Cosmos DB. 2000 rekordów zostało zapisanych pomyślnie, a 8000 rekordów zostało odrzuconych.
Do usługi Azure Cosmos DB wysyłasz pozostałe 8000 rekordów. 2000 rekordów zostało zapisanych pomyślnie, a 6000 rekordów zostało odrzuconych.
Do usługi Azure Cosmos DB wysyłasz pozostałe 6000 rekordów. 2000 rekordów zostało zapisanych pomyślnie, a 4000 rekordów zostało odrzuconych.
Do usługi Azure Cosmos DB wysyłasz pozostałe 4000 rekordów. 2000 rekordów zostało zapisanych pomyślnie, a 2000 rekordów zostało odrzuconych.
Do usługi Azure Cosmos DB wysyłasz pozostałe 2000 rekordów. Wszystkie zostały zapisane pomyślnie.
Zadanie pozyskiwania danych kończy się powodzeniem, ale dopiero po wysłaniu 30 000 rekordów do Azure Cosmos DB. Cały zestaw danych składa się tylko z 10 000 rekordów.
W tym przykładzie należy wziąć pod uwagę inne czynniki:
Duża liczba błędów może również spowodować dodatkową pracę w celu zarejestrowania tych błędów i przetworzenia wynikowych danych dziennika. Powyższe podejście obsługuje 20 000 błędów, a rejestrowanie tych błędów może wiązać się z obciążeniem zasobów obliczeniowych, pamięci lub przestrzeni dyskowej.
Ponieważ nie znasz limitów ograniczania przepustowości usługi pozyskiwania, nie masz możliwości określenia oczekiwań dotyczących czasu przetwarzania danych. Ograniczanie przepustowości może pozwolić obliczyć czas wymagany do pozyskiwania danych.
Rozwiązanie
Ograniczanie szybkości może zmniejszyć ruch i potencjalnie zwiększyć przepływność, zmniejszając liczbę rekordów wysyłanych do usługi w danym okresie.
Usługa może ograniczać liczbę żądań na podstawie różnych metryk w czasie, takich jak:
- Liczba operacji (na przykład 20 żądań na sekundę).
- Ilość danych (na przykład 2 GiB na minutę).
- Względny koszt operacji (na przykład 20 000 jednostek RU na sekundę).
Niezależnie od metryki używanej do ograniczania szybkości implementacja ograniczania szybkości będzie obejmować kontrolowanie liczby i/lub rozmiaru operacji wysyłanych do usługi w określonym przedziale czasu. Ograniczanie szybkości optymalizuje korzystanie z usługi bez przekraczania pojemności ograniczania przepustowości.
W scenariuszach, w których interfejsy API mogą obsługiwać żądania szybciej niż zezwalają na to ograniczone usługi pozyskiwania, musisz zarządzać szybkością korzystania z usługi. Traktowanie ograniczania przepustowości tylko jako niezgodności tempa przesyłu danych i buforowanie zapytań dotyczących pobierania danych do czasu, aż usługa wróci do normy, stwarza ryzyko. Jeśli aplikacja przestanie odpowiadać w tym scenariuszu, wszelkie buforowane dane mogą zostać utracone.
Aby uniknąć tego ryzyka, rozważ przesyłanie rekordów do trwałego systemu komunikatów, który może obsługiwać pełne tempo pozyskiwania danych. (Usługi takie jak Azure Event Hubs mogą obsługiwać miliony operacji na sekundę). Następnie można użyć jednego lub większej liczby procesorów zadań, aby odczytać rekordy z systemu obsługi komunikatów z kontrolowaną szybkością, która mieści się w granicach usługi z ograniczeniami. Przesyłanie rekordów do systemu obsługi komunikatów może zapisywać pamięć wewnętrzną, umożliwiając oddzielenie tylko rekordów, które mogą być przetwarzane w danym interwale czasu.
Platforma Azure udostępnia kilka trwałych usług obsługi komunikatów, których można używać z tym wzorcem, w tym:
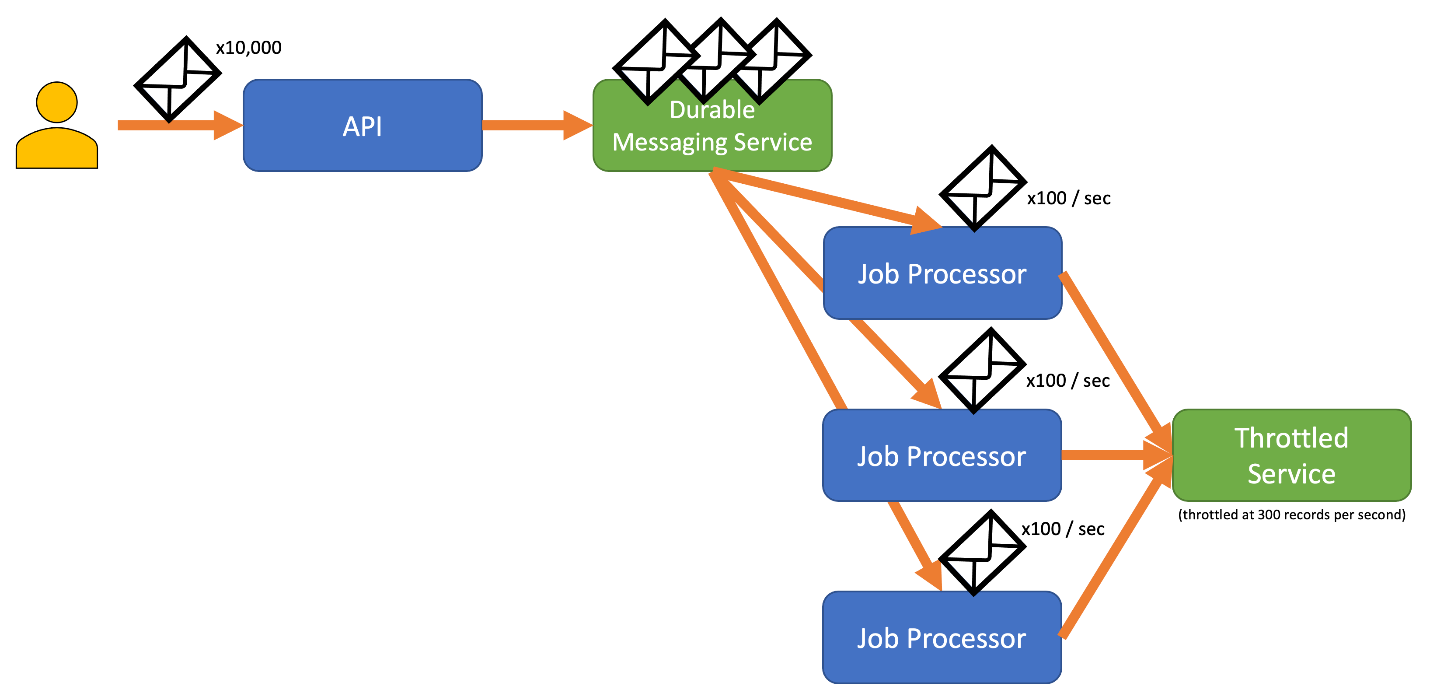
Podczas wysyłania rekordów okres używany do wydawania rekordów może być bardziej szczegółowy niż okres ograniczania usługi. Systemy często ustawiają ograniczenia na podstawie przedziałów czasu, które można łatwo zrozumieć i stosować. Jednak w przypadku komputera z uruchomioną usługą te przedziały czasowe mogą być bardzo długie w porównaniu z szybkością przetwarzania informacji. Na przykład system może ograniczać liczbę operacji na sekundę lub na minutę, ale kod często działa w skali nanosekund lub milisekund.
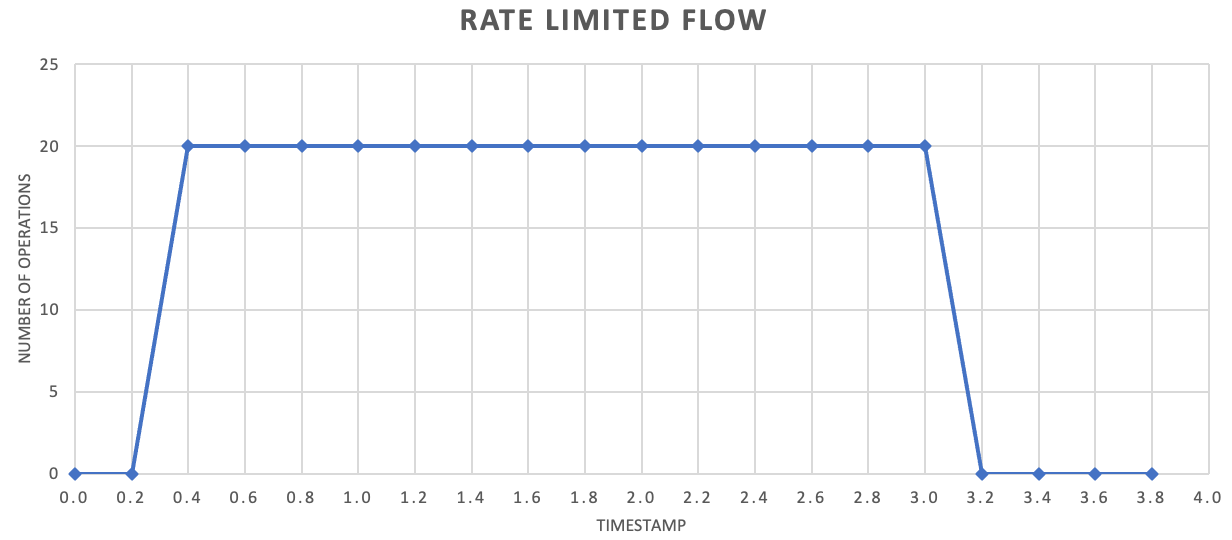
Chociaż nie jest to wymagane, często zaleca się wysyłanie mniejszej liczby rekordów częściej w celu zwiększenia przepływności. Zamiast więc próbować grupować rekordy do wysłania raz na sekundę lub raz na minutę, możesz stosować drobniejsze interwały, aby zużycie zasobów (pamięci, CPU i sieci) utrzymywało się na bardziej równomiernym poziomie. Takie podejście zapobiega potencjalnym wąskim gardłom spowodowanym nagłymi skokami liczby żądań. Na przykład, jeśli usługa zezwala na 100 operacji na sekundę, implementacja ogranicznika szybkości może wyrównać żądania, przeprowadzając 20 operacji co 200 milisekund, jak pokazano na poniższym wykresie.
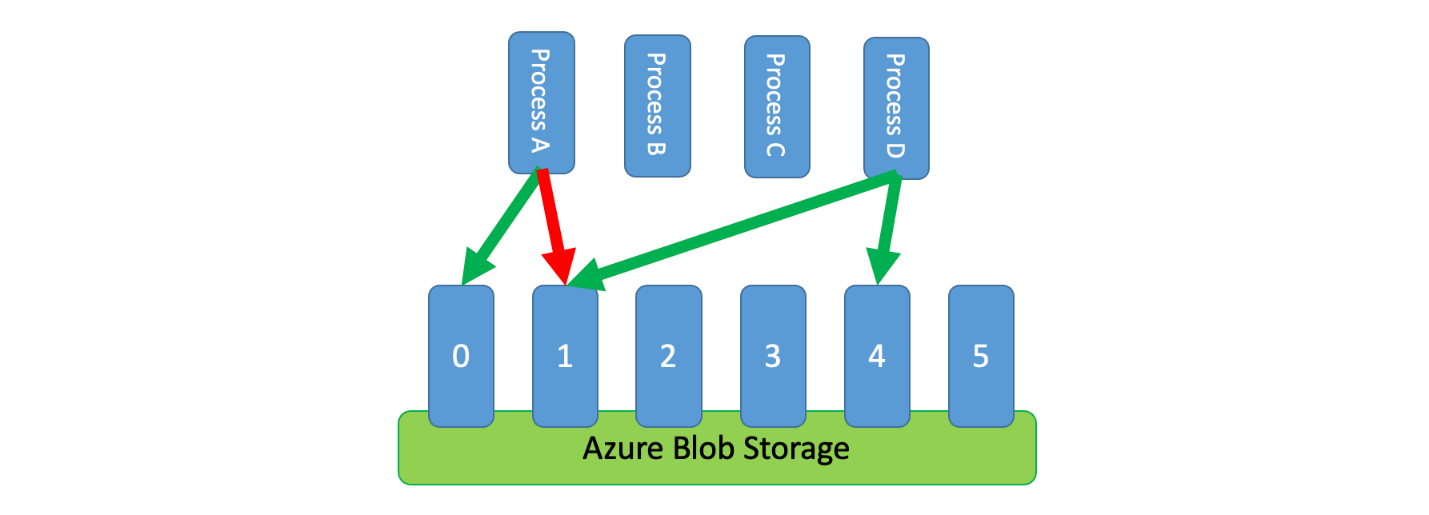
Ponadto czasami konieczne jest, aby wiele nieskoordynowanych procesów współdzieliło usługę z ograniczoną przepustowością. Aby zaimplementować ograniczanie szybkości w tym scenariuszu, można logicznie podzielić pojemność usługi, a następnie użyć rozproszonego systemu wzajemnego wykluczania do zarządzania blokadami wyłączności na tych partycjach. Nieskoordynowane procesy mogą następnie rywalizować o blokady na tych partycjach, ilekroć potrzebują dodatkowej przepustowości. Dla każdej partycji, dla której proces utrzymuje blokadę, przydzielana jest określona ilość przepustowości.
Jeśli na przykład system ograniczony zezwala na 500 żądań na sekundę, możesz utworzyć 20 partycji o wartości 25 żądań na sekundę. Jeśli proces musiał wysłać 100 żądań, mógłby poprosić rozproszony system wzajemnego wykluczania o cztery partycje. System może udzielić dwóch partycji przez 10 sekund. Następnie proces ogranicza liczbę żądań do 50 żądań na sekundę, wykonuje zadanie w ciągu dwóch sekund, a następnie zwalnia blokadę.
Jednym ze sposobów zaimplementowania tego wzorca jest użycie Azure Storage. W tym scenariuszu tworzysz jeden obiekt blob o rozmiarze 0 bajtów dla każdej partycji logicznej w kontenerze. Aplikacje mogą następnie uzyskiwać dzierżawy na wyłączność bezpośrednio względem tych obiektów blob przez krótki czas (na przykład 15 sekund). Każda aplikacja, której przyznano dzierżawę, może korzystać z pojemności przypisanej do tej partycji. Następnie aplikacja musi śledzić czas dzierżawy, aby po wygaśnięciu czasu aplikacja mogła przestać korzystać z przyznanej pojemności. Podczas implementowania tego wzorca często każdy proces próbuje dzierżawić losową partycję, gdy potrzebuje pojemności.
Aby jeszcze bardziej zmniejszyć opóźnienie, możesz przydzielić niewielką ilość wyłącznej pojemności dla każdego procesu. Następnie proces będzie dążył tylko do uzyskania dzierżawy pojemności udostępnionej, jeśli będzie konieczne przekroczenie jej pojemności zarezerwowanej.
Jako alternatywę dla usługi Azure Storage można również wdrożyć tego rodzaju system zarządzania dzierżawami przy użyciu technologii takich jak ZooKeeper, etcd i Redis/Redsync.
Problemy i zagadnienia
Podczas podejmowania decyzji o zaimplementowaniu tego wzorca należy wziąć pod uwagę następujące kwestie:
Mimo że wzorzec ograniczania szybkości może zmniejszyć liczbę błędów ograniczania przepustowości, aplikacja nadal musi prawidłowo obsługiwać wszelkie błędy ograniczania przepustowości, które mogą wystąpić.
Upewnij się, że ponawianie prób jest koordynowane z ograniczaniem szybkości. Bezrefleksyjne lub nadmiernie agresywne ponawianie prób może zwiększyć obciążenie i wywoływać burze ponowień, dlatego przekazuj sygnały ograniczania przepływu (na przykład HTTP 429 z
Retry-After) i stosuj ograniczoną liczbę ponowień z niewielkimi losowymi opóźnieniami między próbami.Jeśli aplikacja ma wiele strumieni pracy, które uzyskują dostęp do tej samej usługi objętej ograniczaniem przepustowości, należy uwzględnić je wszystkie w strategii limitowania szybkości żądań. Na przykład można obsługiwać zbiorcze ładowanie rekordów do bazy danych, ale także wykonywanie zapytań dotyczących rekordów w tej samej bazie danych. Można zarządzać wydajnością, zapewniając, że wszystkie strumienie pracy są kontrolowane przez ten sam mechanizm ograniczania przepustowości. Alternatywnie można zarezerwować oddzielne pule pojemności dla każdego strumienia roboczego.
Usługa ograniczona może być używana w wielu aplikacjach. W niektórych przypadkach można koordynować to użycie (jak pokazano wcześniej w tym artykule). Jeśli zaczniesz widzieć większą niż oczekiwano liczbę błędów ograniczania przepustowości, zwiększenie liczby może wskazywać na rywalizację między aplikacjami, które uzyskują dostęp do usługi. W takim przypadku może być konieczne tymczasowe zmniejszenie limitu przepustowości ustawionego przez mechanizm ograniczania szybkości, dopóki obciążenie ze strony innych aplikacji nie spadnie.
Kiedy należy używać tego wzorca
Użyj tego wzorca, gdy:
Należy zmniejszyć liczbę błędów ograniczania przepustowości zgłaszanych przez usługę z ograniczoną szybkością.
Chcesz zminimalizować ruch w porównaniu z naiwnymi podejściami polegającymi na ponawianiu prób po wystąpieniu błędu.
Należy zmniejszyć zużycie pamięci, pobierając rekordy z kolejki tylko wtedy, gdy dostępne są wystarczające zasoby do ich przetworzenia.
Ten wzorzec może nie być odpowiedni w następujących przypadkach:
Operacja wymaga natychmiastowego, synchronicznego ukończenia z bardzo małym opóźnieniem i nie może tolerować kolejkowania ani odroczonego przetwarzania.
Głównym wąskim gardłem nie jest częstotliwość żądań, lecz współbieżność lub rywalizacja o zasoby (na przykład przeciążenie procesora lub długotrwałe operacje w toku). W takich przypadkach kontrolki skalowania lub współbieżności są bardziej odpowiednie.
Projektowanie obciążenia pracy
Oceń, jak zastosować wzorzec ograniczania szybkości w projekcie obciążenia roboczego, aby uwzględnić cele i zasady omówione w filarach Azure Well-Architected Framework. Poniższa tabela zawiera wskazówki dotyczące tego, jak ten wzorzec obsługuje cele poszczególnych filarów.
| Filar | Jak ten wzorzec obsługuje cele filaru |
|---|---|
| Decyzje projektowe dotyczące niezawodności pomagają obciążeniom stały się odporne na awarię i zapewniają, że zostanie ono przywrócone do w pełni funkcjonalnego stanu po wystąpieniu awarii. | Ta taktyka chroni klienta, uznając i przestrzegając ograniczeń i kosztów komunikacji z usługą, gdy usługa woli uniknąć nadmiernego użycia. - RE:07 Instynkt samozachowawczy |
Jeśli ten wzorzec wprowadza kompromisy w ramach filaru, rozważ je przed celami innych filarów.
Example
Poniższa przykładowa aplikacja umożliwia użytkownikom przesyłanie rekordów różnych typów do interfejsu API. Każdy typ rekordu ma unikatowy procesor zadań, który wykonuje następujące kroki:
- Walidacja
- Wzbogacenie
- Wstawianie rekordu do bazy danych
Wszystkie składniki aplikacji (interfejs API, procesor zadań A i procesor zadań B) są oddzielnymi procesami, które można skalować niezależnie. Procesy nie komunikują się bezpośrednio ze sobą.
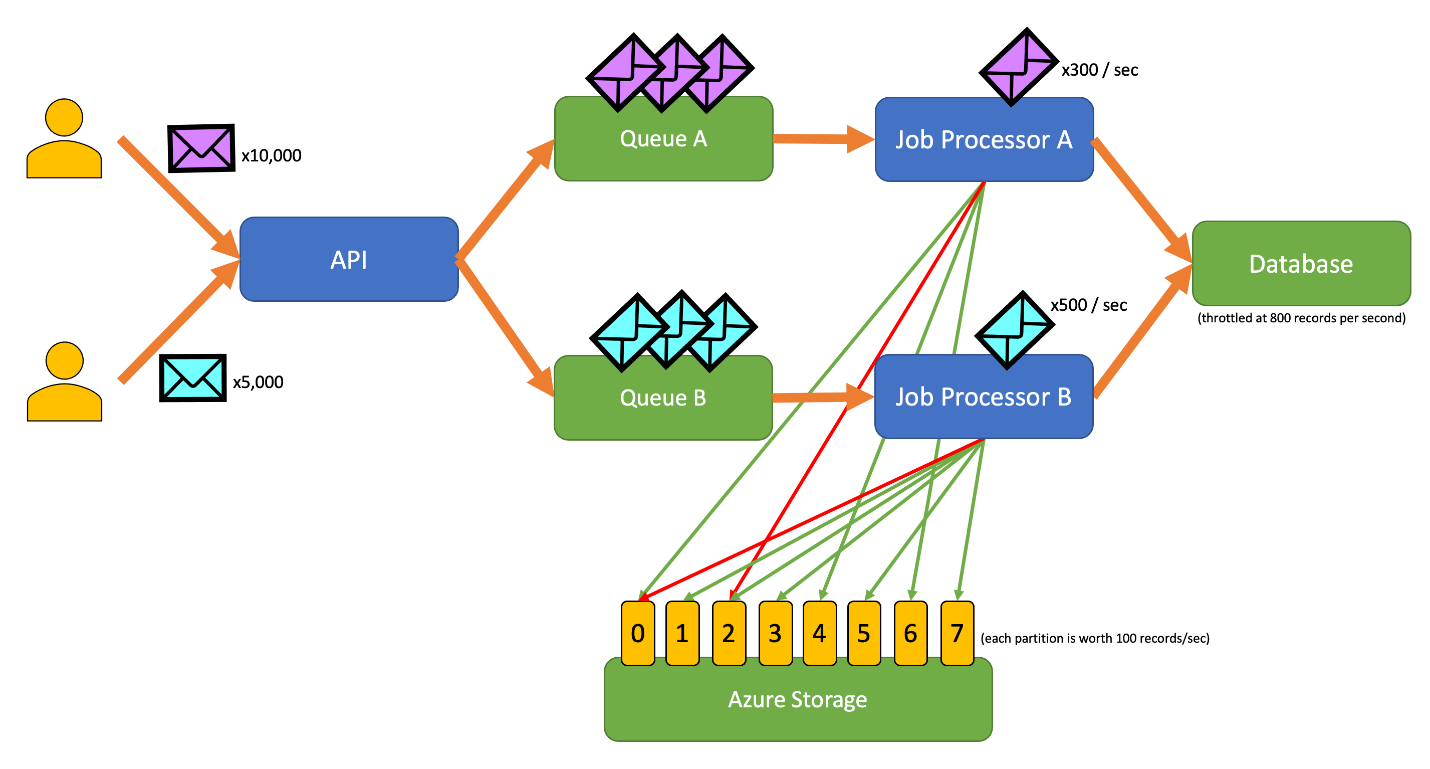
W tym przykładzie każda dzierżawa obiektu blob stanowi stałą część dozwolonej przepustowości bazy danych. Procesor może pobierać z kolejki i zapisywać dane tylko z łączną szybkością wynikającą z dzierżaw, które obecnie posiada. W miarę jak z czasem procesory zyskują lub tracą dzierżawy, ich dozwolona szybkość zapisu zmienia się, co utrzymuje całkowity ruch w bazie danych w granicach skonfigurowanego limitu, a jednocześnie umożliwia postęp wszystkich zadań oczekujących w kolejce.
Ten diagram zawiera następujący przepływ pracy:
- Użytkownik przesyła do interfejsu API 10 000 rekordów typu A.
- Interfejs API umieszcza te 10 000 rekordów w kolejce A.
- Użytkownik przesyła do interfejsu API 5000 rekordów typu B.
- Interfejs API umieszcza te 5 000 rekordów w kolejce B.
- Procesor zadań A widzi, że kolejka A zawiera rekordy i próbuje uzyskać wyłączną dzierżawę obiektu blob 2.
- Procesor zadań B widzi, że kolejka B zawiera rekordy i próbuje uzyskać wyłączną dzierżawę obiektu blob 2.
- Procesor zadań A nie może uzyskać dzierżawy.
- Procesor zadań B uzyskuje dzierżawę bloba 2 na 15 sekund. Teraz może ograniczać liczbę żądań do bazy danych w tempie 100 na sekundę.
- Procesor zadań B pobiera z kolejki B 100 rekordów i zapisuje je.
- Jedna sekunda przechodzi.
- Procesor zadań A widzi, że w kolejce A jest więcej rekordów, i próbuje uzyskać wyłączną dzierżawę blobu 6.
- Procesor zadań B widzi, że kolejka B zawiera więcej rekordów, i próbuje uzyskać wyłączną dzierżawę obiektu blob nr 3.
- Procesor zadań A uzyskuje dzierżawę obiektu blob 6 przez 15 sekund. Teraz może ograniczać liczbę żądań do bazy danych w tempie 100 na sekundę.
- Procesor zadań B uzyskuje dzierżawę obiektu blob 3 przez 15 sekund. Teraz może ograniczać liczbę żądań do bazy danych w tempie 200 na sekundę. (Utrzymuje również dzierżawę obiektu blob 2.)
- Procesor zadań A usuwa 100 rekordów z kolejki A i zapisuje je.
- Procesor zadań B pobiera z kolejki B 200 rekordów i zapisuje je.
- Jedna sekunda przechodzi.
- Procesor zadań A widzi, że kolejka A ma więcej rekordów i próbuje uzyskać wyłączną dzierżawę obiektu blob 0.
- Procesor zadań B widzi, że kolejka B zawiera więcej rekordów, i próbuje uzyskać wyłączną dzierżawę obiektu blob 1.
- Procesor zadań A uzyskuje dzierżawę obiektu blob 0 przez 15 sekund. Teraz może ograniczać liczbę żądań do bazy danych w tempie 200 na sekundę. (Zawiera również dzierżawę obiektu blob 6).
- Procesor zadań B uzyskuje dzierżawę obiektu blob 1 przez 15 sekund. Teraz może ograniczać liczbę żądań do bazy danych z szybkością 300 na sekundę. (Ma również dzierżawę blobów 2 i 3.)
- Procesor zadań A pobiera z kolejki A 200 rekordów i je zapisuje.
- Procesor zadań B pobiera z kolejki B 300 rekordów i zapisuje je.
- I tak dalej.
Po 15 sekundach jedno lub oba zadania nadal nie zostaną ukończone. W miarę wygasania dzierżaw procesor powinien również zmniejszyć liczbę żądań, które usuwa i zapisuje.
 Implementacje tego wzorca są dostępne w różnych językach programowania:
- Implementacja języka Go jest dostępna w witrynie GitHub.
- Implementacja języka Java jest dostępna w witrynie GitHub.
Następne kroki
Poniższe wskazówki mogą być również istotne podczas implementowania tego wzorca:
Zaawansowane ograniczanie żądań przy użyciu Azure API Management. Użyj tego jako uzupełniającego mechanizmu kontroli dopuszczania na brzegu sieci, aby egzekwować limity liczby wywołań i limity użycia dla poszczególnych kluczy oraz zwracać klientom spójne sygnały przeciążenia.
Wybierz między usługami obsługi komunikatów platformy Azure. Wybierz najlepszą trwałą sieć szkieletową obsługi komunikatów na potrzeby buforowania i kontrolowanego pozyskiwania.
Obsługa błędów przejściowych w aplikacjach Azure. Zaprojektuj zachowanie ponawiania prób, aby klienci wycofali się prawidłowo po osiągnięciu limitów.
Powiązane zasoby
Podczas implementowania tego wzorca mogą być również istotne następujące wzorce i wskazówki:
Throttling. Wzorzec ograniczania szybkości jest zwykle implementowany w odpowiedzi na usługę z ograniczeniami.
Retry. Gdy żądania do usługi ograniczonej powodują błędy ograniczania przepustowości, zazwyczaj zaleca się ponowienie próby tych żądań po odpowiednim interwale.
Równoważenie obciążenia oparte na kolejce jest podobne do wzorca ograniczania szybkości, ale różni się pod kilkoma istotnymi względami:
Ograniczanie szybkości nie musi używać kolejek do zarządzania obciążeniem, ale musi korzystać z trwałej usługi obsługi komunikatów. Na przykład wzorzec ograniczania szybkości może używać usług, takich jak Apache Kafka lub Event Hubs.
Wzorzec ograniczania przepustowości wprowadza koncepcję rozproszonego systemu wzajemnego wykluczania opartego na partycjach, który umożliwia zarządzanie przepustowością dla wielu nieskoordynowanych procesów komunikujących się z tą samą usługą o ograniczonej przepustowości.
Wzorzec równoważenia obciążenia opartego na kolejce sprawdza się wszędzie tam, gdzie występuje rozbieżność wydajnościowa między usługami lub gdy chcesz zwiększyć odporność. Jest to więc szerszy wzorzec niż ograniczanie szybkości, co jest bardziej szczegółowo związane z wydajnym uzyskiwaniem dostępu do usługi z ograniczeniami.