Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Azure Blob Storage
Azure Functions
Azure Queue Storage
Podziel zadanie wykonujące złożone przetwarzanie na serię oddzielnych elementów, które mogą być używane ponownie. Może to poprawić wydajność, skalowalność i możliwość ponownego wykorzystania początkowych etapów, umożliwiając niezależne wdrażanie i skalowanie elementów zadania wykonujących przetwarzanie. Takie podejście zapewnia wysoki poziom modułowości.
Kontekst i problem
Masz ciąg następujących po sobie zadań, który musisz przetworzyć. Proste, ale nieelastyczne podejście do implementowania tej aplikacji polega na wykonaniu tego przetwarzania w module monolitycznym. Jednak takie podejście może zmniejszyć możliwości refaktoryzacji kodu, optymalizacji go lub ponownego korzystania z niego, jeśli części tego samego przetwarzania są wymagane w innym miejscu w aplikacji.
Na poniższym diagramie przedstawiono jeden z problemów z przetwarzaniem danych przy użyciu podejścia monolitycznego, brak możliwości ponownego użycia kodu w wielu potokach. W tym przykładzie aplikacja odbiera i przetwarza dane z dwóch źródeł. Oddzielny moduł przetwarza dane z każdego źródła, wykonując szereg zadań w celu przekształcenia danych przed przekazaniem wyniku do logiki biznesowej aplikacji.
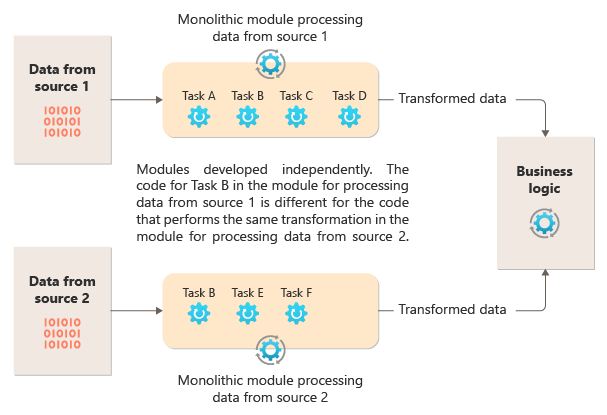
Niektóre zadania wykonywane przez moduły monolityczne są funkcjonalnie podobne, ale kod musi być powtarzany w obu modułach i prawdopodobnie ściśle powiązany w ramach modułu. Oprócz braku możliwości ponownego użycia logiki to podejście wprowadza ryzyko, gdy wymagania się zmienią. Pamiętaj, aby zaktualizować kod w obu miejscach.
Istnieją inne wyzwania związane z implementacją monolityczną, niezwiązane z wieloma potokami ani ponownym wykorzystaniem. W przypadku monolitu nie masz możliwości uruchamiania określonych zadań w różnych środowiskach ani skalowania ich niezależnie. Niektóre zadania mogą być intensywne obliczeniowo i skorzystać na uruchamianiu na wydajnym sprzęcie lub na uruchamianiu wielu instancji równolegle. Inne zadania mogą nie mieć tych samych wymagań. Ponadto, w przypadku monolitów trudno jest zmienić kolejność zadań lub dodać nowe zadania do potoku przetwarzania. Te zmiany wymagają ponownego przetestowania całego pipeline’u.
Rozwiązanie
Podziel przetwarzanie wymagane dla każdego strumienia na zestaw oddzielnych składników (filtrów), z których każdy wykonuje jedno zadanie. Zadania złożone powinny używać wielu filtrów, a nie jednego. Filtry składają się z potoków przez połączenie filtrów z potokami. Filtry są niezależne, samodzielne i zwykle bezstanowe. Filtry odbierają komunikaty z potoku wejściowego i przekazują je do innego potoku wyjściowego. Filtry mogą przekształcać komunikat lub testować go pod kątem co najmniej jednego kryterium, aby uwzględnić logikę warunkową. Potoki nie wykonują routingu ani żadnej innej logiki. Łączą tylko filtry, przekazując komunikat wyjściowy z jednego filtru jako dane wejściowe do następnego.
Filtry działają niezależnie i nie znają innych filtrów. Są oni świadomi tylko ich schematów wejściowych i wyjściowych. W związku z tym filtry można rozmieścić w dowolnej kolejności, o ile schemat wejściowy dla dowolnego filtru jest zgodny ze schematem wyjściowym poprzedniego filtru. Użycie standardowego schematu dla wszystkich filtrów zwiększa możliwość zmiany kolejności filtrów. Architektura potoków i filtrów sprzyja kompozycyjnemu ponownemu wykorzystaniu.
Luźne sprzężenie filtrów ułatwia:
- Tworzenie nowych potoków składających się z istniejących filtrów
- Aktualizowanie lub zastępowanie logiki w poszczególnych filtrach
- Zmień kolejność filtrów, w razie potrzeby
- Uruchamianie filtrów na różnym sprzęcie, jeśli jest to wymagane
- Równoległe uruchamianie filtrów
Ten diagram przedstawia rozwiązanie zaimplementowane za pomocą potoków i filtrów:

Czas przetwarzania pojedynczego żądania zależy od szybkości najwolniejszych filtrów w potoku. Jeden lub więcej filtrów może stanowić wąskie gardła, zwłaszcza jeśli w strumieniu z określonego źródła danych występuje duża liczba żądań. Możliwość uruchamiania równoległych instancji wolnych filtrów pozwala systemowi rozłożyć obciążenie i zwiększyć przepustowość.
Możliwość uruchamiania filtrów na różnych wystąpieniach obliczeniowych umożliwia ich niezależne skalowanie i korzystanie z elastyczności zapewnianej przez wiele środowisk w chmurze. Filtr intensywnie korzystający z obliczeń może działać na sprzęcie o wysokiej wydajności, podczas gdy inne mniej wymagające filtry mogą być hostowane na mniej kosztownym sprzęcie. Filtry nie muszą nawet znajdować się w tym samym centrum danych lub lokalizacji geograficznej, co umożliwia uruchamianie każdego elementu w potoku w środowisku zbliżonym do potrzebnych zasobów. Te działania wymagają określonych technik projektowych, takich jak komunikacja i wielowątkowość, aby maksymalizować elastyczność każdego potoku lub filtru. Na tym diagramie przedstawiono przykład zastosowany do potoku dla danych ze źródła 1:

Jeśli dane wejściowe i wyjściowe filtru mają strukturę strumienia, można wykonać przetwarzanie dla każdego filtru równolegle. Pierwszy filtr w potoku może rozpocząć pracę i wyświetlić wyniki, które są przekazywane bezpośrednio do następnego filtru w sekwencji przed ukończeniem pracy pierwszego filtru.
Użycie wzorca „Potoki i filtry” wraz z wzorcem transakcji kompensacyjnej jest alternatywnym podejściem do wdrażania transakcji rozproszonych. Transakcję rozproszoną można podzielić na oddzielne, możliwe do wykonania zadania, z których każdy można zaimplementować za pomocą filtru, który implementuje również wzorzec transakcji wyrównywalnej. Filtry można zaimplementować w potoku jako oddzielne hostowane zadania, które działają blisko danych, którymi zarządzają.
Problemy i kwestie do rozważenia
Podczas podejmowania decyzji o zaimplementowaniu tego wzorca należy wziąć pod uwagę następujące kwestie:
Monolityczny charakter. Ten wzorzec jest zwykle implementowany jako potok monolityczny, więc w przypadku każdej zmiany cały łańcuch filtrów powinien zostać przetestowany na końcu. Ponadto należy wziąć pod uwagę odporność na błędy całego procesu; jeśli filtr lub kanał ulegnie awarii, cały potok przetwarzania najprawdopodobniej również ulegnie awarii.
Złożoność. Zwiększona elastyczność oferowana przez ten wzorzec może również wprowadzać dodatkową złożoność, zwłaszcza jeśli filtry w potoku przetwarzania są rozproszone na różnych serwerach.
Niezawodność. Użyj infrastruktury, która zapewnia, że dane przepływające między filtrami w potoku nie zostaną utracone.
Idempotencja. Jeśli filtr w potoku zakończy się niepowodzeniem po otrzymaniu komunikatu, a praca zostanie ponownie zaplanowana na inne wystąpienie filtru, część pracy może już zostać ukończona. Jeśli praca aktualizuje jakiś aspekt stanu globalnego (na przykład informacje przechowywane w bazie danych), można powtórzyć pojedynczą aktualizację. Podobny problem może wystąpić, jeśli filtr ulegnie awarii po przekazaniu swoich wyników do następnego filtru, ale zanim zasygnalizuje, że zakończył działanie pomyślnie. W takich przypadkach inne wystąpienie filtru może powtórzyć tę pracę, powodując dwukrotne opublikowanie tych samych wyników. Ten scenariusz może spowodować dwukrotne przetworzenie tych samych danych przez kolejne filtry w potoku. W związku z tym filtry w potoku powinny być projektowane tak, aby były idempotentne. Aby uzyskać więcej informacji, zobacz Idempotency Patterns na blogu Jonathana Olivera.
Powtórzone komunikaty. Jeśli filtr w potoku ulegnie awarii po wysłaniu komunikatu do następnego etapu potoku, może zostać uruchomione inne wystąpienie tego filtru, które wyśle kopię tego samego komunikatu w potoku. Ten scenariusz może spowodować przekazanie dwóch wystąpień tego samego komunikatu do następnego filtru. Aby uniknąć tego problemu, potok powinien wykrywać i usuwać zduplikowane komunikaty.
Uwaga
Jeśli zaimplementujesz potok przy użyciu kolejek komunikatów (takich jak kolejki usługi Azure Service Bus), infrastruktura kolejkowania komunikatów może zapewniać automatyczne wykrywanie i usuwanie duplikatów komunikatów.
Kontekst i stan. Zasadniczo każdy filtr w potoku działa w izolacji i nie powinny być w nim przyjmowane żadne założenia co do sposobu jego wywołania. W związku z tym każdy filtr powinien być dostarczany z wystarczającą ilością kontekstu, aby wykonać swoją pracę. Ten kontekst może zawierać znaczną ilość informacji o stanie. Jeśli filtry używają stanu zewnętrznego, takiego jak dane w bazie danych lub magazynie zewnętrznym, należy wziąć pod uwagę wpływ na wydajność. Każdy filtr musi ładować, przetwarzać i zapisywać ten stan, co powoduje większy narzut niż w przypadku rozwiązań, które ładują stan zewnętrzny tylko raz.
Tolerancja komunikatów. Filtry muszą być odporne na dane w komunikacie przychodzącym, względem których nie działają. Działają one na danych odpowiednich dla nich i ignorują inne dane i przekazują je bez zmian w komunikacie wyjściowym.
Obsługa błędów - każdy filtr musi zdecydować, co zrobić w przypadku błędu krytycznego. Filtr musi określić, czy powoduje niepowodzenie potoku, czy propaguje wyjątek.
Kiedy używać tego wzorca
Użyj tego wzorca, gdy:
Przetwarzanie wymagane przez aplikację można łatwo podzielić na zestaw niezależnych kroków.
Kroki przetwarzania wykonywane przez aplikację mają różne wymagania w zakresie skalowalności.
Uwaga
Można grupować filtry, które powinny być skalowane razem w tym samym procesie. Aby uzyskać więcej informacji, zobacz Compute Resource Consolidation Pattern (Wzorzec konsolidacji zasobów obliczeniowych).
Wymagana jest elastyczność umożliwiająca zmienianie kolejności kroków przetwarzania, które wykonuje aplikacja, lub umożliwienie możliwości dodawania i usuwania kroków.
System może odnieść korzyści z rozproszenia przetwarzania poszczególnych kroków na różne serwery.
Potrzebujesz niezawodnego rozwiązania, które minimalizuje skutki awarii w kroku podczas przetwarzania danych.
Ten wzorzec może nie być przydatny w następujących sytuacjach:
Aplikacja jest zgodna ze wzorcem żądania-odpowiedzi.
Przetwarzanie zadania musi zostać ukończone w ramach początkowego żądania, takiego jak scenariusz żądania/odpowiedzi.
Kroki przetwarzania wykonywane przez aplikację nie są niezależne lub muszą być wykonywane razem w ramach jednej transakcji.
Ilość informacji o kontekście lub stanie, których wymaga krok, sprawia, że takie podejście jest nieefektywne. Może być możliwe utrwalanie informacji o stanie w bazie danych, ale nie należy używać tej strategii, jeśli dodatkowe obciążenie bazy danych powoduje nadmierne rywalizacje.
Projektowanie obciążeń
Architekt powinien ocenić, w jaki sposób wzorzec potoków i filtrów może być używany w projekcie obciążenia, aby sprostać celom i zasadom opisanym w filarach platformy Azure Well-Architected Framework. Na przykład:
| Filar | Jak ten wzorzec obsługuje cele filaru |
|---|---|
| Decyzje projektowe dotyczące niezawodności pomagają obciążeniu stać się odporne na awarię i zapewnić, że zostanie przywrócony do w pełni funkcjonalnego stanu po wystąpieniu awarii. | Pojedyncza odpowiedzialność każdego etapu umożliwia skoncentrowanie uwagi i pozwala uniknąć rozproszenia procesów przetwarzania danych. - RE:01 Prostota - RE:07 Zadania w tle |
Podobnie jak w przypadku każdej decyzji projektowej, należy rozważyć wszelkie kompromisy w stosunku do celów innych filarów, które mogą zostać wprowadzone przy użyciu tego wzorca.
Przykład
Możesz użyć sekwencji kolejek komunikatów, aby zapewnić infrastrukturę wymaganą do wdrożenia potoku przetwarzania. Początkowa kolejka wiadomości przyjmuje nieprzetworzone komunikaty, które stanowią punkt wyjścia dla implementacji wzorca potoków i filtrów. Składnik zaimplementowany jako zadanie filtru nasłuchuje komunikatów w tej kolejce, wykonuje swoje zadanie, a następnie umieszcza nowy lub przekształcony komunikat w następnej kolejce sekwencji. Innym zadaniem filtrowania może być nasłuchiwanie komunikatów w tej kolejce, przetwarzanie ich, publikowanie wyników w innej kolejce i wykonywanie innych kroków aż do ostatniego kroku, który finalizuje proces potoków i filtrów. Ten schemat ilustruje potok przetwarzania wykorzystujący kolejki komunikatów:

Potok przetwarzania obrazów można zaimplementować przy użyciu tego wzorca. Jeśli obciążenie robocze wykorzystuje obraz, może on przechodzić przez serię w dużej mierze niezależnych filtrów, których kolejność można zmieniać, aby wykonać działania, takie jak:
- moderowanie treści
- zmiana rozmiaru
- znakowanie wodne
- Reorientacja
- Usuwanie metadanych exif
- Publikacja usługi Content Delivery Network (CDN)
W tym przykładzie filtry można zaimplementować jako pojedynczo wdrożoną usługę Azure Functions, a nawet pojedynczą aplikację funkcji platformy Azure zawierającą każdy filtr jako izolowane wdrożenie. Użycie wyzwalaczy usługi Azure Functions, powiązań wejściowych i powiązań wyjściowych może uprościć kod filtru i umożliwić automatyczną współpracę z potokiem opartym na kolejce, wykorzystującym element claim check dla obrazu przeznaczonego do przetworzenia.

Oto przykład tego, jak może wyglądać filtr zaimplementowany jako funkcja platformy Azure, wyzwalany z potoku usługi Queue Storage przy użyciu claim check dla obrazu i zapisujący nowy claim check do innego potoku usługi Queue Storage. Zastąpiliśmy implementację pseudokodem w komentarzach w celu zwięzłości. Więcej takich kodów można znaleźć w pokazie wzorca potoków i filtrów dostępnych w usłudze GitHub.
// This is the "Resize" filter. It handles claim checks from input pipe, performs the
// resize work, and places a claim check in the next pipe for anther filter to handle.
[Function(nameof(ResizeFilter))]
[QueueOutput("pipe-fjur", Connection = "pipe")]  // Destination pipe claim check
public async Task<string> RunAsync(
  [QueueTrigger("pipe-xfty", Connection = "pipe")] string imageFilePath,  // Source pipe claim check
  [BlobInput("{QueueTrigger}", Connection = "pipe")] BlockBlobClient imageBlob)  // Image to process
{
  _logger.LogInformation("Processing image {uri} for resizing.", imageBlob.Uri);

  // Idempotency checks
  // ...

  // Download image based on claim check in queue message body
  // ...

  // Resize the image
  // ...

  // Write resized image back to storage
  // ...

  // Create claim check for image and place in the next pipe
  // ...

  _logger.LogInformation("Image resizing done or not needed. Adding image {filePath} into the next pipe.", imageFilePath);
  return imageFilePath;
}
Uwaga
Struktura Spring Integration Framework zawiera implementację wzorca potoków i filtrów.
Następne kroki
Podczas implementowania tego wzorca mogą być przydatne następujące zasoby:
- Demonstracja wzorca potoków i filtrów przy użyciu scenariusza przetwarzania obrazów jest dostępna w usłudze GitHub.
- Wzorce idempotentności na blogu Jonathana Olivera.
Powiązane zasoby
Podczas implementowania tego wzorca mogą być również istotne następujące wzorce:
- Wzorzec Claim Check. Potok zaimplementowany przy użyciu kolejki może nie zawierać rzeczywistego elementu wysyłanego przez filtry, ale zamiast tego odniesienie do danych, które trzeba przetworzyć. W tym przykładzie użyto ewidencjonowania oświadczeń w usłudze Azure Queue Storage dla obrazów przechowywanych w usłudze Azure Blob Storage.
- Wzorzec konkurujących odbiorców. Potok może zawierać wiele wystąpień co najmniej jednego filtru. To podejście jest przydatne do uruchamiania równoległych instancji wolno działających filtrów. Umożliwia systemowi rozłożenie obciążenia i zwiększenie przepływności. Każde wystąpienie filtru konkuruje o dane wejściowe z innymi wystąpieniami, ale dwa wystąpienia filtru nie powinny być w stanie przetworzyć tych samych danych. W tym artykule wyjaśniono podejście.
- Wzorzec konsolidacji zasobów obliczeniowych. Może być możliwe grupowanie filtrów, które powinny być skalowane razem w jeden proces. Ten artykuł zawiera więcej informacji na temat korzyści i kompromisów tej strategii.
- Wzorzec transakcji wyrównującej. Filtr można zaimplementować jako operację, która może zostać odwrócona lub ma operację wyrównywczą, która przywraca stan do poprzedniej wersji, jeśli wystąpi awaria. W tym artykule wyjaśniono, jak można zaimplementować ten wzorzec, aby zachować lub osiągnąć spójność ostateczną.
- Potoki i filtry - wzorce integracji przedsiębiorstw.