Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Azure Data Explorer (ADX) to w pełni zarządzana platforma analityczna umożliwiająca analizę danych telemetrycznych na dużą skalę i danych dzienników w czasie rzeczywistym. W tym artykule wyjaśniono, jak koszt na GB pozyskany jest obliczany w usłudze Azure Data Explorer, jakie czynniki go napędzają i jak można zoptymalizować klaster pod kątem wydajności kosztów. Platformy analizy danych big data używają różnych modeli cenowych. Wiele platform opiera ceny na czynnikach, takich jak wolumin zapytań, pozyskiwanie danych, czas trwania magazynu i zasoby obliczeniowe. Ta złożoność utrudnia porównywanie cen między produktami.
Aby ułatwić zrozumienie kosztów korzystania z usługi Azure Data Explorer, w tym artykule użyto metryki koszt za GB przetworzonego. Ta metryka jest łącznym kosztem klastra (obliczenia, przechowywanie, sieć i narzut za usługi) podzielonym przez łączną ilość danych w oryginalnym rozmiarze pobranych w tym okresie.
Reprezentatywna migawka klastrów ADX z czerwca 2025 r. stanowi podstawę dla przykładowej analizy. W poniższych sekcjach przedstawiono główne wyniki analizy, wyjaśniono, co wpływa na zmiany kosztów i jak użytkownicy mogą optymalizować koszt na GB pozyskiwane bez naruszania wydajności.
Uwaga / Notatka
- Wszystkie koszty w tym artykule pokazują ceny katalogowe i nie obejmują rabatów ani oszczędności związanych z zobowiązaniami.
- Na potrzeby tej przykładowej analizy koszt na GB jest wyrażony w przykładowych jednostkach kosztów (SCU), gdzie każda jednostka SCU reprezentuje ogólną jednostkę kosztu, na przykład jeden cent AMERYKAŃSKI.
- Aby uzyskać cennik i sposób ich obliczania, zobacz Kalkulator cen usługi Azure Data Explorer.
Analiza kosztów na GB pobranych danych
Na poniższym wykresie przedstawiono medianę dziennie wczytywanych GB w oryginalnym rozmiarze (na osi Y) oraz medianę kosztu na GB wczytanego (na osi X) dla każdej grupy kosztowej. Rozmiar bąbla oznacza udział grupy w całkowitej ilości danych przetworzonych przez usługę.
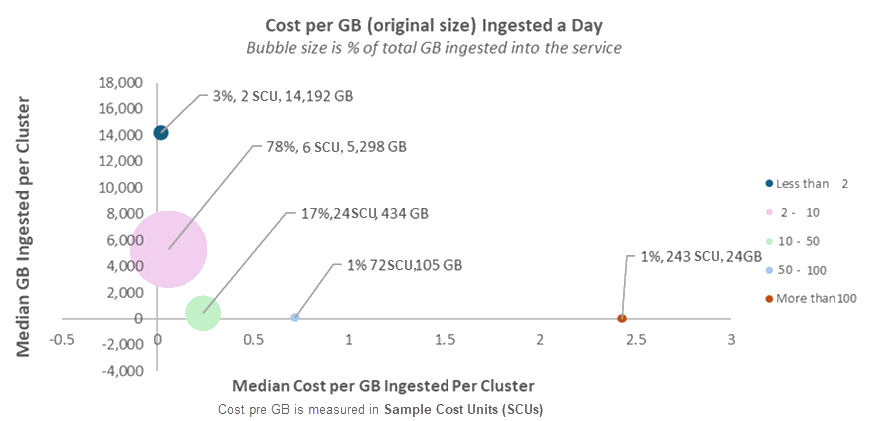
Koszt na GB pozyskany różni się w zależności od klastrów, ale wyróżnia się kilka wzorców:
Większość danych (>75%) jest pozyskiwana kosztem od 2 do 10 jednostek SCU na GB (przed rabatami).
Mniej niż 5% danych jest pozyskiwanych przy mniej niż 2 SCU na GB.
Nawet w tej samej kategorii użycia (lub "bąbelku"), widoczne są znaczące zmiany. Na przykład w największej bańce jeden klaster przetwarza 2 jednostki SCU na GB, a drugi przetwarza 10 jednostek SCU na GB. Jest to różnica 5X. W następnych sekcjach wyjaśniono kluczowe przyczyny tej odmiany.
Klastry o wyższych kosztach na GB są mniej powszechne i zwykle mają mniejsze woluminy pozyskiwania. Ogólnie rzecz biorąc, mniejsze woluminy danych oznaczają wyższy koszt na GB.
Ważne
Wykres bąbelkowy pokazuje, że koszt za GB danych różni się między klastrami. Ta odmiana nie wskazuje dobrych lub złych rozwiązań. Odzwierciedla różne scenariusze, konfiguracje i wzorce użycia usługi.
Na przykład jeden klaster może dłużej przechowywać dane pod kątem zgodności, co zwiększa koszty magazynowania. Innym rozwiązaniem może być użycie zasad aktualizacji, które przetwarzają dane podczas pozyskiwania, co powoduje zwiększenie użycia zasobów obliczeniowych. Te scenariusze są celowymi wyborami projektowymi zgodnymi z określonymi celami i naturalnie wpływają na koszt na GB.
Co wpływa na koszt za GB wprowadzonego danych
Te kluczowe czynniki stoją za różnicami w kosztach na GB zaimportowanego na klaster.
Czas trwania magazynu: im dłużej przechowujesz dane, tym wyższy koszt. Zobacz zasady przechowywania.
Wysokie użycie procesora CPU: akcje, takie jak duże zapytania, przetwarzanie danych lub przekształcenia powodują wysokie użycie procesora CPU.
Ustawienia pamięci podręcznej: buforowanie większej ilości danych zwiększa wydajność, ale może zwiększyć koszty. Zobacz zasady pamięci podręcznej.
Wykorzystanie zimnych danych: zapytania, które uzyskują dostęp do zimnych danych, wyzwalają transakcje odczytu i zwiększają koszty. Zobacz gorącą i zimną pamięć podręczną.
Przekształcanie i optymalizacja danych: funkcje, takie jak zasady aktualizacji, zmaterializowane widoki i partycjonowanie zużywają zasoby procesora CPU i mogą zwiększyć koszty. Zobacz Polityki aktualizacji, Widoki zmaterializowane i partycji.
Wolumin pozyskiwania: klastry działają bardziej opłacalnie przy większych ilościach pozyskiwania.
Pozyskiwanie strumieniowe a pozyskiwanie w kolejce: każdy z nich ma inny profil kosztów w zależności od przypadku użycia. Zobacz Streaming i Kolejkowane.
Projekt schematu: Szerokie tabele z wieloma kolumnami wymagają większej ilości zasobów obliczeniowych i magazynu, co zwiększa koszty.
Funkcje zaawansowane: opcje, takie jak osoby obserwujące, prywatne punkty końcowe i piaskownice języka Python zużywają więcej zasobów i mogą zwiększać koszty.
Wybór potoku danych: Niektóre ścieżki przetwarzania kosztują mniej. Na przykład przesyłanie danych do Event Grid jest zazwyczaj tańsze niż przesyłanie danych do Event Hubs.
Autoskalowanie: klastry bez autoskalowania często kosztują więcej, ponieważ nie dostosowują rozmiaru na podstawie zapotrzebowania.
Większość tych czynników można skonfigurować pod kątem optymalizacji zarówno wydajności, jak i kosztów.
Bliższe spojrzenie na kluczowe czynniki kosztowe
W tej sekcji opisano kluczowe czynniki wpływające na koszt na GB pozyskany w usłudze Azure Data Explorer, zapewniając wgląd w sposób, w jaki można zarządzać tymi kosztami i optymalizować je.
Wpływ przechowywania danych na koszt
W usłudze ADX wszystkie pozyskane dane są przechowywane w magazynie trwałym. Każda tabela i zmaterializowany widok mają zasady przechowywania , które określają czas przechowywania danych. Im dłużej dane są przechowywane, tym wyższy koszt jest oparty na cenach usługi Azure Storage. Jeśli potrzebujesz długoterminowego przechowywania danych, na przykład dla zgodności, koszt na GB przechowywanych danych wzrasta, ponieważ uwzględnia bieżące koszty przechowywania.
Oprócz rozmiaru zakresu zgłoszonego przez klaster istnieją dwa dodatkowe sterowniki kosztów:
- Bufor przechowywania: domyślnie przechowywane są dodatkowe 7 dni danych w celu ochrony przed przypadkową utratą danych.
- Obciążenie związane z odzyskiwaniem: w przypadku tabel, w których ustawienie możliwości odzyskiwania jest włączone (ustawienie domyślne), dane są przechowywane przez dodatkowe 14 dni. Obejmuje to pośrednie obiekty blob generowane podczas operacji scalania i ponownego kompilowanie.
Rozmiar klastra
Rozmiar klastra to liczba maszyn (węzłów) w klastrze. Każda maszyna generuje koszty w zależności od typu (SKU). Autoskalowanie dostosowuje rozmiar klastra na podstawie użycia procesora CPU, dzięki czemu system może zoptymalizować koszty i wydajność, unikając bezczynnych lub nadmiarowych zasobów.
Autoskalowanie dostosowuje rozmiar klastra, aby zapewnić, że buforowane dane mieszczą się w dostępnym obszarze SSD. W związku z tym duża pamięć podręczna może zwiększyć rozmiar klastra, a jeśli użycie CPU jest niskie, może to prowadzić do wyższych kosztów za GB. Aby uzyskać więcej informacji na temat optymalizowania rozmiaru pamięci podręcznej, zobacz kartę Pamięć podręczna w narzędziu Wgląd w klastry.
Klastry, które uruchamiają wiele zapytań lub wykonują zadania z dużym obciążeniem procesora CPU, takie jak zmaterializowane widoki, zasady aktualizacji lub partycjonowanie, mogą skalować klaster, co zwiększa koszt za GB. Należy pamiętać, że te funkcje mogą znacznie zwiększyć wydajność zapytań i zmniejszyć użycie procesora CPU zapytań, a tym samym zwiększyć ogólną wydajność.
Ilość pozyskanych danych
W miarę rozrastania się klastra dodawane są kolejne węzły, co zwiększa całkowity koszt. Ten koszt jest rozłożony na wszystkie pozyskane dane, więc im więcej danych pozyskasz, tym niższy koszt za GB.
Użycie zimnych danych
Gdy zapytania często uzyskują dostęp do zimnych danych przechowywanych na dysku, powodują one transakcje odczytu korzystające z większej ilości zasobów i mogą zwiększyć całkowity koszt klastra.
Przesyłanie strumieniowe a ładowanie danych z kolejki
Każda metoda pozyskiwania ma różne właściwości kosztów, opóźnień i funkcjonalności, dlatego każda z nich jest lepsza w różnych scenariuszach. W przypadku kosztów strumieniowe pozyskiwanie danych jest tańsze w przypadku pozyskiwania wielu małych tabel z wolno napływającymi danymi, podczas gdy pozyskiwanie w kolejce jest bardziej kosztowo efektywne dla dużych tabel.
Wskazówka
Optymalizacja kosztów na GB zaimportowanych danych
Sprawdź konfiguracje kluczowych czynników kosztów , aby upewnić się, że spełniają potrzeby klastra i wymagania dotyczące usług pod kątem wydajności. W szczególności:
- Zminimalizuj zapytania dotyczące zimnych danych, aby ograniczyć liczbę transakcji odczytu.
- Umożliwia skalowanie automatyczne w celu dynamicznego dopasowania rozmiaru klastra do zapotrzebowania.