Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Important
Elementy oznaczone podglądem w tym artykule są obecnie w wersji zapoznawczej. Ta wersja zapoznawcza jest udostępniana bez umowy dotyczącej poziomu usług, a Microsoft nie zaleca korzystania z niej w przypadku obciążeń produkcyjnych. Niektóre funkcje mogą nie być obsługiwane lub mogą mieć ograniczone możliwości. Aby uzyskać więcej informacji, zobacz Warunki dodatkowe korzystania z testowych wersji Microsoft Azure.
Important
Szkolenie interaktywne wymaga wyraźnej zgody na dostęp. Zażądaj dostępu za pośrednictwem formularza rejestracji w wersji zapoznawczej i poczekaj na zatwierdzenie przed utworzeniem sesji szkoleniowej.
Interaktywne trenowanie (wersja zapoznawcza) to interfejs API umożliwiający tworzenie własnej pętli dostrajania po treningu na modelach open-weight w usłudze Microsoft Foundry. Kontrolujesz eksperyment w Pythonie. Narzędzie Foundry uruchamia próbkowanie modeli i aktualizacje adaptacji niskiego rzędu (LoRA) na bezserwerowych procesorach GPU.
W przypadku uczenia przez wzmacnianie (RL) kod steruje zbieraniem rolloutów, nagrodami, estymatami advantage i planowaniem aktualizacji. Te same prymitywy obsługują uczenie nadzorowane, uczenie preferencji, destylację i przepływy pracy z niestandardową funkcją straty.
Kiedy należy go używać
Użyj interaktywnego trenowania, gdy sama pętla trenowania jest częścią badań:
- Potrzebujesz niestandardowego sygnału uczenia. Dostarczanie demonstracji, obliczanie nagród i przewag lub tworzenie lokalnej funkcji straty na potrzeby uczenia preferencji lub innych celów.
- Model współdziała ze środowiskiem. Koordynuj odpowiedzi modelu, wywołania narzędzi, obserwacje i nagrody w twoim sterowniku.
- Potrzebujesz kontroli nad poszczególnymi aktualizacjami. Wybierz partie danych, maski tokenów, ustawienia funkcji straty i parametry optymalizatora. Zdecyduj, kiedy należy gromadzić gradienty i stosować aktualizację.
- Chcesz sprawdzić i dostosować eksperyment. Pobierz próbkę z bieżącego adaptera, oceń na wydzielonych promptach i wybierz kolejne prompty na podstawie obserwowanych wyników.
- Musisz zachować postęp i kontynuować działania. Zapisz stan adaptera i optymalizatora, a następnie wznów w zgodnej sesji. Zachowaj pozycję zestawu danych i inny stan eksperymentu w driverze.
Zarządzane dostrajanie obsługuje również oceniacze do dostrajania ze wzmocnieniem. Wybierz trenowanie interakcyjne, gdy potrzebujesz kontroli nad pętlą, a nie tylko ustawienia oceniającego lub zadania. Zobacz Wybierz podejście szkoleniowe.
Kto robi to, co
Twój program w Pythonie jest sterownikiem treningu. Przygotowuje dane wejściowe i koordynuje eksperyment. Usługa Foundry utrzymuje stan modelu i adaptera i wykonuje żądane operacje.
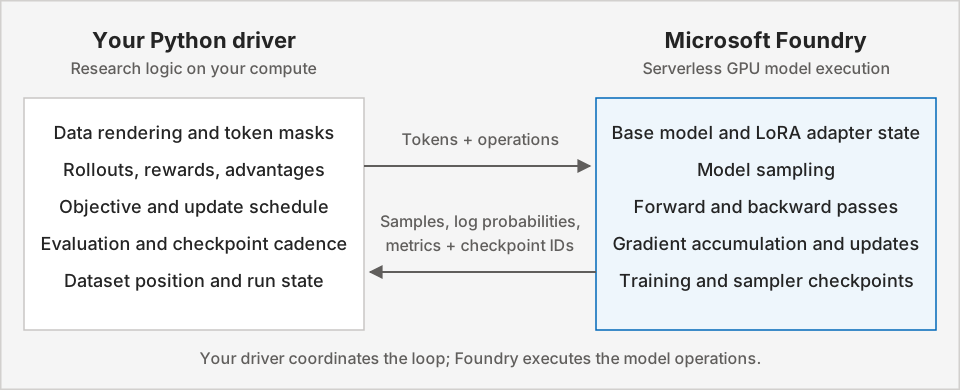
Twój sterownik może działać na CPU, w tym na własnej maszynie lub w środowisku obliczeniowym. Model nagród lub środowisko, które dodajesz, może mieć własne wymagania obliczeniowe. Pozostaw sterownik uruchomiony, gdy zarządza pętlą.
Podstawowe pojęcia i prymitywy
Sesja jest stanowa: obliczenia gradientu, aktualizacje optymalizatora i próbkowanie to oddzielne operacje na wybranym modelu i adapterze. To rozdzielenie pozwala wybrać, kiedy zbierać dane, gromadzić gradienty, aktualizować i oceniać.
| Blok konstrukcyjny | Do czego służy |
|---|---|
| Sesja szkoleniowa i adapter LoRA |
FineTuningSession.create Inicjuje obsługiwany model podstawowy z konfiguracją adaptera. Sesja przechowuje stan używany przez kolejne operacje. |
| Tokenizowane wsady i maski |
Datum przenosi dane wejściowe modelu i wejścia funkcji straty. Maski wybierają tokeny, które przyczyniają się do uczenia, takie jak tokeny asystenta, a nie prompty lub obserwacje narzędzi. |
| Pobieranie próbek |
sample generuje odpowiedzi z wybranego checkpointu próbkatora. Dane wejściowe RL łączą w pary przykładowe tokeny z ich logarytmicznymi prawdopodobieństwami rolloutu i przewagami wyprowadzonymi z nagrody. |
| Przebiegi w przód i w tył |
forward zwraca dane wyjściowe funkcji straty dla każdego przykładu bez gromadzenia gradientów.
forward_backward oblicza wybraną funkcję celu i gromadzi gradienty. Nie aktualizuje optymalizatora. |
| Aktualizacja optymalizatora |
optim_step stosuje skumulowane gradienty z parametrami Adama. Należy wybrać, kiedy zaktualizować i który współczynnik uczenia ma być używany. |
| Punkt kontrolny samplera |
save_weights_for_sampler przygotowuje wagi adaptera do generowania. Odśwież te wagi po aktualizacji przed próbkowaniem ze zaktualizowanego adaptera. |
| Punkt zapisu treningu |
save_weights utrwala wagi adaptera i stan optymalizatora.
FineTuningSession.create_from_checkpoint wznawia szkolenie w kompatybilnej sesji. |
Zestaw SDK obejmuje cross_entropy do nadzorowanych aktualizacji i straty RL, takie jak importance_sampling i ppo. Te straty są prymitywami strat, a nie wstępnie zdefiniowanymi algorytmami end-to-end. Aby uzyskać informacje o kontraktach wejściowych i składzie niestandardowej funkcji straty, zobacz Kluczowe pojęcia.
Jak działa pętla RL
Rozważ eksperyment rozumowania matematycznego: model generuje kilka odpowiedzi na każdy problem, a program ocenia ich poprawność. Aby zapoznać się z przykładem, przejdź do Zacznij.
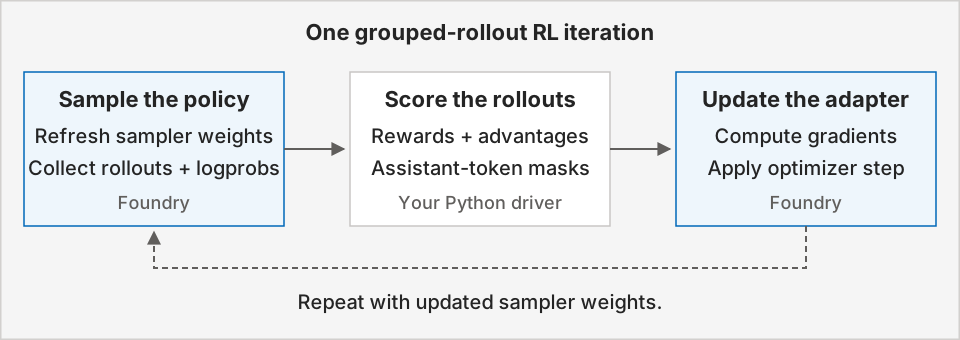
Ustanów wydzielony punkt odniesienia i przetestuj funkcję nagrody przed pierwszą aktualizacją. Następnie powtórz:
- Przygotuj bieżącą politykę do próbkowania. Zapisz wagi samplera z adaptera treningowego, a następnie zbierz kilka odpowiedzi lub rolloutów dla każdego monitu.
- Oceń i porównaj odpowiedzi. Funkcja nagrody przypisuje wynik do każdego przebiegu. Odejmij średnią nagrodę grupy promptów, aby uzyskać przewagę każdego przebiegu.
- Przygotuj sygnał szkoleniowy. Wyrównaj przykładowe tokeny asystenta z logarytmicznymi prawdopodobieństwami rolloutu i estymatami advantage. Wyklucz polecenia i obserwacje środowiska z sygnału uczenia.
- Oblicz gradienty. Prześlij partię do
forward_backwardza pomocąimportance_sampling. Ukończ obliczenia gradientu przed aktualizacją, która go wykorzystuje. - Zaktualizuj adapter. Wywołaj metodę
optim_step, a następnie odśwież wagi próbnika przed zebraniem odpowiedzi ze zaktualizowanej polityki. - Oceń i zachowaj postęp. Porównaj poprawność zbioru walidacyjnego z punktem odniesienia i zapisuj punkty kontrolne treningu z wybraną częstotliwością.
Wprowadzenie
Wybierz punkt początkowy pasujący do zadania:
- Szybki start: Postępuj zgodnie z przykładem „Szybki start”, aby sklonować repozytorium i uruchomić krótki przykład uczenia przez wzmacnianie.
- Wypróbuj inne przepisy: Zapoznaj się z repozytorium przykładów dostrajania , aby uzyskać więcej przykładów szkoleniowych.
- Wyszukaj operację: Użyj ściągawki zestawu SDK (wersja zapoznawcza) dla funkcji i kluczowych parametrów.
- Zrozum pętlę trenowania: Przeczytaj kluczowe pojęcia dotyczące nagród, korzyści, masek tokenów i punktów kontrolnych.
Obsługiwane modele i regiony
Zapoznaj się z omówieniem dostosowywania obsługiwanych modeli i obsługiwanych regionów.