Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Przetwarzanie priorytetowe zapewnia wydajność o małych opóźnieniach dzięki elastyczności płatności zgodnie z rzeczywistym użyciem. W tym artykule włączysz przetwarzanie priorytetów we wdrożeniu modelu, sprawdzisz, która warstwa usługi przetworzyła żądania i monitorowała skojarzone koszty.
Wymagania wstępne
- Subskrypcja Azure — Utwórz ją bezpłatnie.
- Projekt Microsoft Foundry z modelem typu wdrożenia
GlobalStandardlubDataZoneStandardzostał wdrożony. - Wersje
2025-12-01modelu lub nowsze.
Kluczowe przypadki użycia
- Spójne, małe opóźnienia w przypadku dynamicznych środowisk użytkownika.
- Prostota płatności w modelu pay-as-you-go bez długoterminowych zobowiązań.
- Ruch występujący w godzinach biznesowych lub skokowy, który korzysta ze skalowalnej i kosztowo efektywnej wydajności. Opcjonalnie można połączyć przetwarzanie priorytetowe z aprowizowaną jednostką przepływności (PTU) w celu zapewnienia stałej wydajności i optymalizacji kosztów.
Docelowy parametr opóźnienia
W poniższej tabeli wymieniono wartość docelową opóźnienia dla każdego modelu, który obsługuje przetwarzanie priorytetowe. Wartość docelowa opóźnienia jest obliczana jako opóźnienie żądania p50 na 5 minut i wyrażona jako próg percentylu. Na przykład "99% > 50 tokenów na sekundę (TPS)" oznacza, że 99% żądań jest przetwarzanych przy ponad 50 tokenach na sekundę.
| Model | Wartość docelowa opóźnienia |
|---|---|
| gpt-6-sol, 2026-09-22 | 99% > 80 TPS |
| gpt-5.6-terra, 2026-07-09 | 99% > 70 TPS |
| gpt-5.6-sol, 2026-07-09 | 99% > 80 TPS |
| gpt-5.5, 2026-04-24 | 99% > 50 TPS |
| gpt-5.4-mini, 2026-03-17 | 99% > 100 TPS |
| gpt-5.4, 2026-03-051 | 99% > 50 TPS |
| gpt-5.2, 2025-12-11 | 99% > 50 TPS |
| gpt-5.1, 2025-11-13 | 99% > 50 TPS |
| gpt-4.1, 2025-04-141 | 99% > 80 TPS |
1Wydłużony kontekst dla tego modelu, to znaczy żądania, których liczba 128 tys. tokenów promptu według szacunków zostanie przekroczona, są przenoszone do przetwarzania standardowego, a opłaty są naliczane według stawki poziomu standardowego.
Priorytetowa dostępność przetwarzania według typu wdrożenia
Przetwarzanie priorytetowe można włączyć w globalnych wdrożeniach standardowych lub wdrożeniach standardowych strefy danych (USA). Aby uzyskać informacje o cenach, zobacz strona cennika Azure OpenAI.
Globalna dostępność modelu standardowego
| Region | gpt-6-sol, 2026-09-22 | gpt-5.6-terra, 2026-07-09 | gpt-5.6-sol, 2026-07-09 | gpt-5.5, 2026-04-24 | gpt-5.4-mini, 2026-03-17 | gpt-5.4, 2026-03-05 | gpt-5.2, 2025-12-11 | gpt-5.1, 2025-11-13 | gpt-4.1, 2025-04-14 |
|---|---|---|---|---|---|---|---|---|---|
| australiaeast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| brazilsouth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| canadacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| canadaeast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| centralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| eastus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| eastus2 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| francecentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| germanywestcentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| italynorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| japaneast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| koreacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| northcentralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| northeurope | - | - | - | ✅ | ✅ | ✅ | - | - | - |
| norwayeast | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| polandcentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southafricanorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| southcentralus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| południowo-wschodnia Azja | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Południowe Indie | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| hiszpaniacentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| swedencentral | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| Szwajcaria Północ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| szwajcariawest | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| uaenorth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| uksouth | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westeurope | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westus | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
| westus3 | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ |
Włącz przetwarzanie priorytetowe na poziomie wdrożenia
Możesz włączyć przetwarzanie priorytetów na poziomie wdrożenia i (opcjonalnie) na poziomie żądania.
Uwaga
Przetwarzanie priorytetowe można włączyć we wdrożeniach globalnych standardowych lub w standardzie strefy danych (USA). Przetwarzanie priorytetowe używa tego samego limitu przydziału co standardowe przetwarzanie.
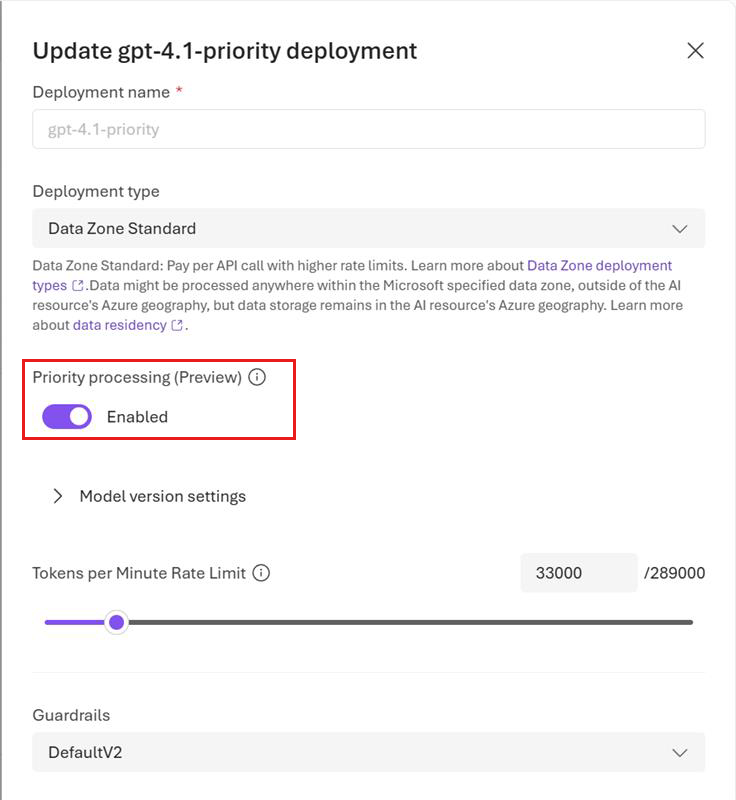
W portalu Microsoft Foundry, włącz przełącznik Przetwarzanie priorytetowe na stronie szczegółów wdrożenia podczas tworzenia wdrożenia. Możesz także zaktualizować ustawienie wdrożonego modelu, edytując szczegóły wdrożenia.
Uwaga
Jeśli wolisz użyć kodu w celu włączenia przetwarzania priorytetów na poziomie wdrożenia, możesz to zrobić za pośrednictwem interfejsu API REST do wdrożenia, ustawiając service_tier atrybut w następujący sposób: "properties" : {"service_tier" : "priority"}. Dozwolone wartości atrybutu service_tier to default i priority.
default oznacza standardowe przetwarzanie, a jednocześnie priority umożliwia przetwarzanie priorytetowe.
Po skonfigurowaniu wdrożenia modelu do korzystania z przetwarzania priorytetowego można rozpocząć wysyłanie żądań do modelu.
Wyświetlanie metryk użycia
Miarę wykorzystania zasobu można wyświetlić w sekcji Azure Monitor w portalu Azure.
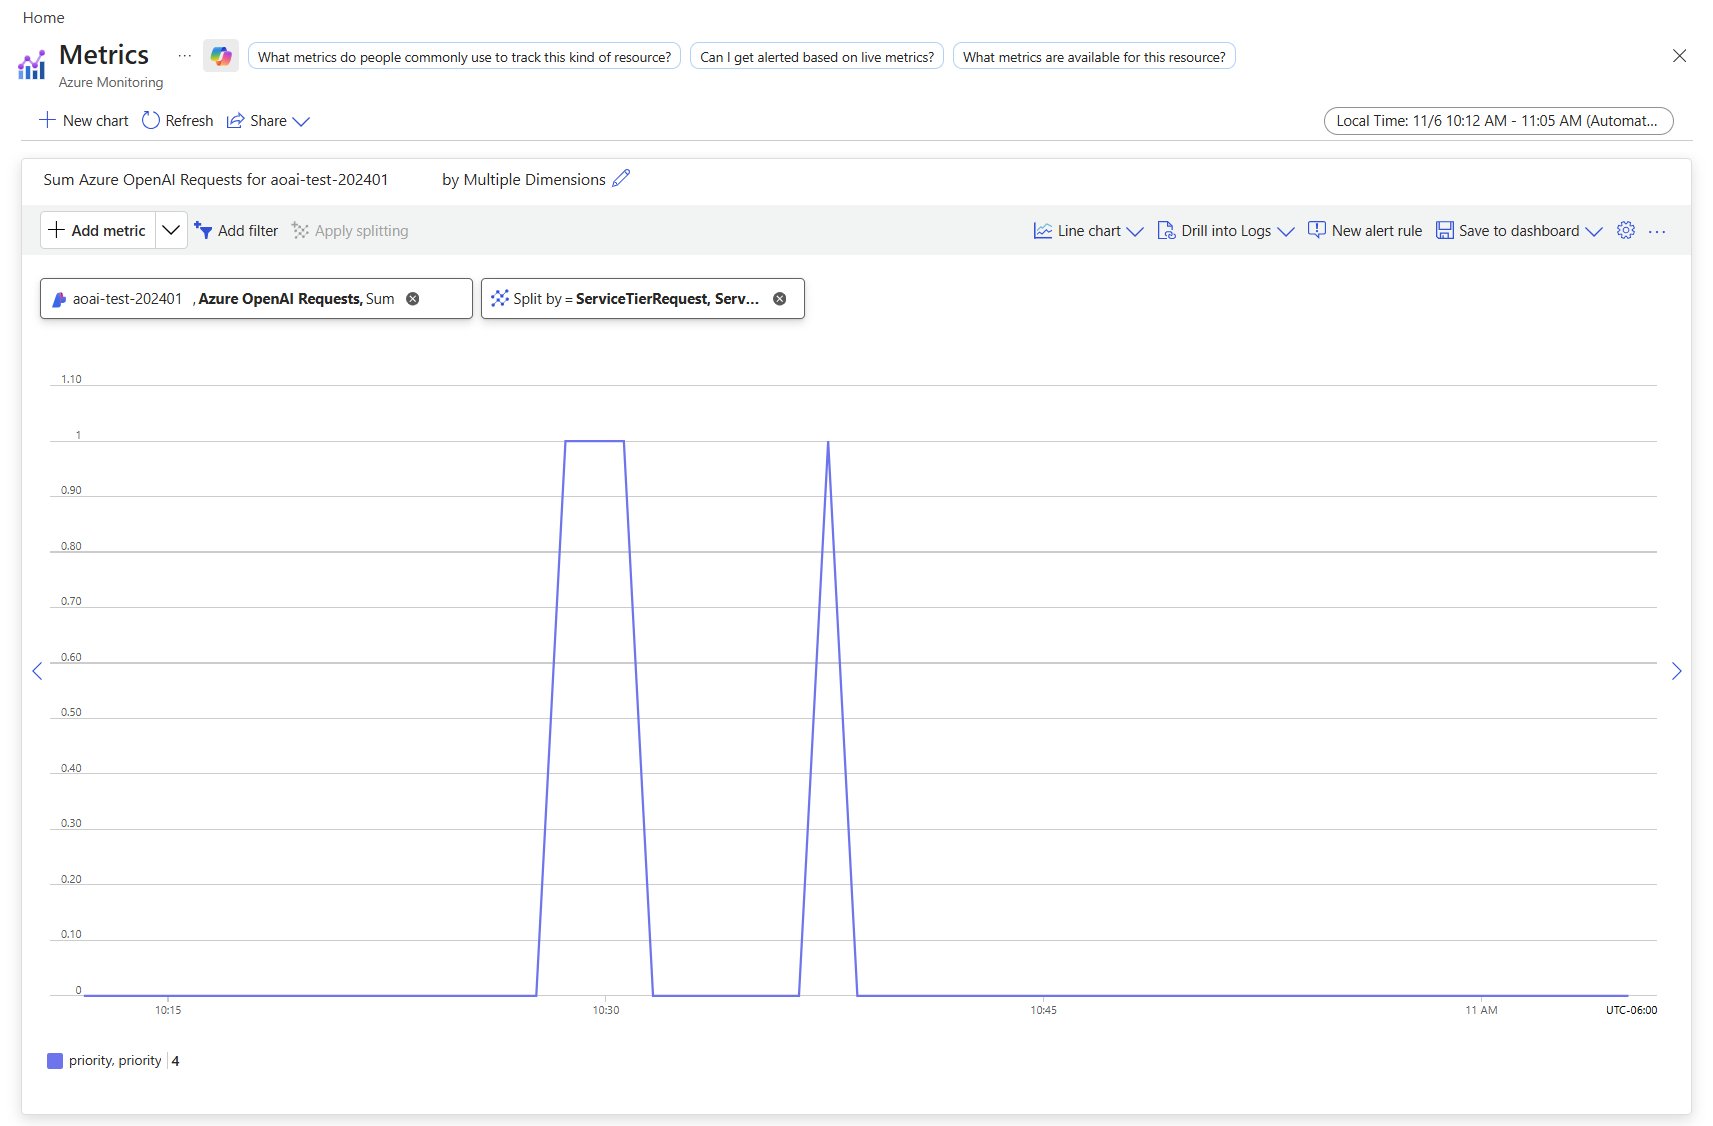
Aby wyświetlić liczbę żądań przetwarzanych przez standardowe przetwarzanie w porównaniu z przetwarzaniem priorytetowym, podzieloną przez warstwę usługi (standard lub priorytet), która znajdowała się w oryginalnym żądaniu:
- Zaloguj się do https://portal.azure.com.
- Przejdź do zasobu Azure OpenAI i wybierz opcję Metrics w obszarze nawigacji po lewej stronie.
- Na stronie metryk dodaj metrykę Azure OpenAI requests. Możesz również wybrać inne metryki, takie jak Azure opóźnienie interfejsu OpenAI, Azure użycie interfejsu OpenAI i inne.
- Wybierz pozycję Dodaj filtr , aby wybrać standardowe wdrożenie, dla którego zostały przetworzone żądania przetwarzania priorytetów.
- Wybierz pozycję Zastosuj dzielenie , aby podzielić wartości według parametrów ServiceTierRequest i ServiceTierResponse.
Aby uzyskać więcej informacji na temat monitorowania wdrożeń, zobacz Monitor Azure OpenAI.
Monitorowanie kosztów
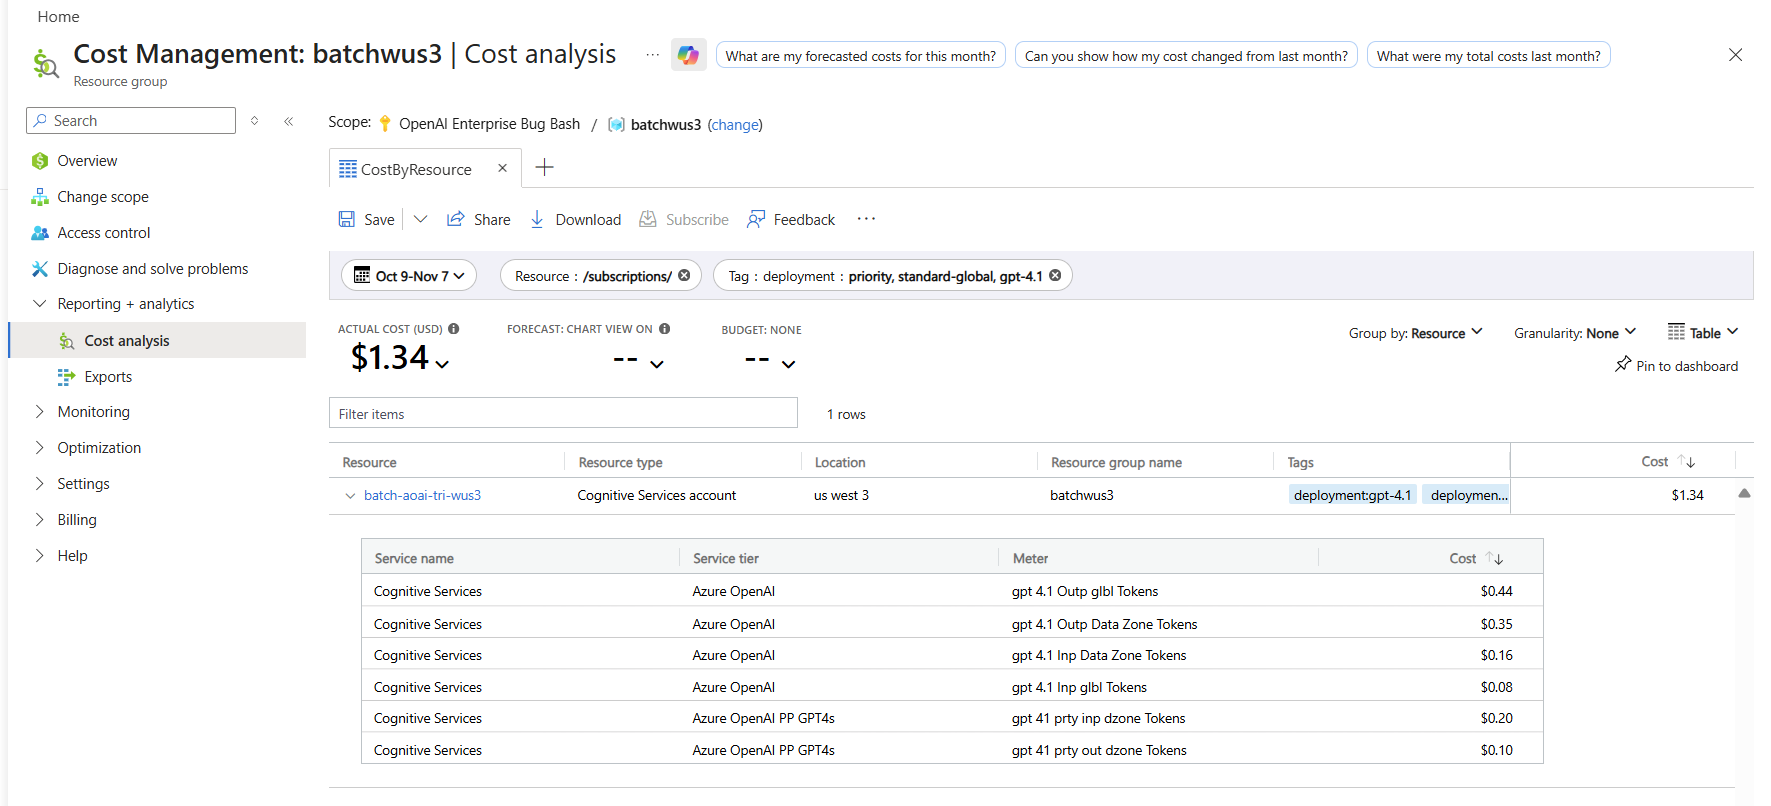
Na stronie analizy kosztów w portalu Azure można zobaczyć podział kosztów dla żądań priorytetowych i standardowych, filtrując według nazwy wdrożenia i tagów rozliczeń w następujący sposób:
- Przejdź do strony analizy kosztów w portalu Azure.
- (Opcjonalnie) Filtruj według zasobu.
- Aby filtrować według nazwy wdrożenia: Dodaj filtr dla tagu rozliczeń>, wybierz wdrożenie jako jego wartość, a następnie wybierz nazwę wdrożenia.
Aby uzyskać informacje o cenach przetwarzania priorytetów, zobacz omówienie cennika Azure OpenAI Service.
Włączanie przetwarzania priorytetu na poziomie żądania
Ważna
Od 25 września 2026 r. żądania kierowane do modeli, które nie obsługują przetwarzania Flex, zwracają kod HTTP 400 z elementem invalid_request_error. Foundry nie przełącza się automatycznie z flex na Standardowe przetwarzanie. Przed wysłaniem żądania sprawdź, czy model obsługuje przetwarzanie Flex. Jeśli standardowe przetwarzanie jest akceptowalne, zamiast tego ustaw service_tier na default. Aby zapoznać się z obsługiwanymi modelami i wskazówkami dotyczącymi mechanizmu rezerwowego, zobacz Korzystanie z przetwarzania Flex w usłudze Azure OpenAI.
Włączanie przetwarzania priorytetu na poziomie żądania jest opcjonalne. Interfejs API uzupełniania czatu i interfejs API odpowiedzi mają opcjonalny atrybut service_tier określający typ przetwarzania, który ma być używany podczas obsługi żądania. W poniższym przykładzie pokazano, jak ustawić wartość service_tier na priority w żądaniu odpowiedzi.
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $AZURE_OPENAI_AUTH_TOKEN" \
  -d '{
     "model": "gpt-4.1",
     "input": "This is a test",
     "service_tier": "priority"
    }'
Użyj atrybutu service_tier , aby zastąpić ustawienie na poziomie wdrożenia. W przypadku przetwarzania service_tier standardowego i priorytetowego można użyć wartości auto, defaulti priority.
Jeśli atrybut nie zostanie ustawiony, wartość domyślna to
auto.service_tier = autooznacza, że żądanie używa warstwy usługi skonfigurowanej we wdrożeniu.service_tier = defaultoznacza, że żądanie używa standardowych cen i wydajności dla wybranego modelu.service_tier = priorityoznacza, że żądanie używa warstwy usługi przetwarzania priorytetowego.
W poniższej tabeli podsumowano trasowanie standardowe i priorytetowe na podstawie ustawień na poziomie wdrożenia i żądania dla service_tier.
| Ustawienie na poziomie wdrożenia | Ustawienie na poziomie żądania | Żądanie przetworzone przez warstwę usługi |
|---|---|---|
| domyślny | auto, wartość domyślna | Standard |
| domyślny | Priorytet | Przetwarzanie priorytetowe |
| Priorytet | auto, priorytet | Przetwarzanie priorytetowe |
| Priorytet | domyślny | Standard |
Ograniczenia
Obecnie usługa nie obsługuje regionalnych wdrożeń standardowych i wdrożeń standardowych strefy danych UE.
Usługa może ponownie kierować żądania o priorytecie do standardowego przetwarzania* w następujących scenariuszach:
- Jeśli szybkie zwiększenie liczby tokenów przetwarzania priorytetu na minutę doprowadzi do osiągnięcia granic wzrostu przepustowości. Obecnie limit szybkości rampy jest definiowany jako zwiększenie ruchu o ponad 50% tokenów na minutę w mniej niż 15 minut.
- W okresach szczytowych żądań przetwarzania priorytetowego.
- Żądania długiego kontekstu wysyłane do niektórych modeli wymienionych w tabeli docelowej Opóźnienie.
Wskazówka
Jeśli rutynowo napotykasz limity przyrostu prędkości, rozważ zakup PTU zamiast lub oprócz przetwarzania priorytetowego.
* Opłaty za usługi są naliczane według standardowej warstwy usług zgodnie ze standardowymi stawkami. Żądania przetwarzane przez standardową warstwę usługi w ich odpowiedziach zawierają
service_tier = default, podczas gdy żądania przetwarzane przez warstwę przetwarzania priorytetowego w ich odpowiedziach zawierająservice_tier = priority.
Rozwiązywanie problemów
| Problem | Przyczyna | Rozdzielczość |
|---|---|---|
| Żądania zdegradowane do warstwy standardowej | Jedna z następujących sytuacji: - Ruch sieciowy zwiększał się o ponad 50% tokenów na minutę w mniej niż 15 minut, osiągając limit wzrostu szybkości. — Żądania wysyłane w okresach szczytowych żądań do przetwarzania priorytetowego. — Żądania długiego kontekstu wysyłane do niektórych modeli wymienionych w tabeli docelowych opóźnień. |
- Stopniowo zwiększaj ruch, jeśli napotkałeś ograniczenia prędkości narastania. - Rozważ zakup PTU w celu uzyskania stałej wydajności. |