Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
pg_durable to trwały mechanizm wykonywania w usłudze Azure HorizonDB. Umożliwia definiowanie długotrwałych, wieloetapowych przepływów pracy SQL (osadzanie potoków, zadań ETL, wywołań sztucznej inteligencji, zaplanowanych zadań, przepływów zatwierdzania) i uruchamianie ich z tymi samymi gwarancjami niezawodności, których można oczekiwać od dedykowanego koordynatora, takiego jak Durable Functions bez opuszczania bazy danych Postgres.
pg_durable jest również warstwą wykonawczą u podstaw trwałych potoków AI. Jeśli używasz pipeline’ów AI, pg_durable to właśnie ono sprawia, że przetrwają awarie, ponawiają działanie po niepowodzeniu i wznawiają pracę od ostatniego zakończonego kroku.
Note
pg_durable jest w wersji zapoznawczej.
Co oznacza "trwałe"
Trwała funkcja w systemie pg_durable jest utrwalana na dysku na każdym kroku. Zapewnia to określony zestaw gwarancji, które nie są uzyskiwane z zwykłego BEGIN ... COMMIT bloku lub zadania cron:
- Przetrwa awarie bazy danych i jej ponowne uruchomienia. Zakończone kroki nie są wykonywane ponownie, gdy serwer ponownie się uruchomi. Trwające kroki są wznawiane od ostatniego punktu kontrolnego. Oczekujące kroki są wykonywane, gdy worker ponownie połączy się z siecią.
- Wytrzymuje długie okresy bezczynności. Przepływ pracy może spać godzinami, czekać na harmonogram cron lub na sygnał zewnętrzny i nadal wznowić działanie od miejsca, w którym został przerwany.
- Jest odporny na awarie. Kroki, które zakończyły się niepowodzeniem, można ponowić automatycznie bez ponownego uruchamiania całej funkcji.
- Rejestruje tożsamość. Funkcja jest wykonywana z uprawnieniami użytkownika, który go uruchomił, a nie z uprawnieniami procesu roboczego w tle. Obciążenia wielodzierżawne pozostają odizolowane.
- Pozostaje zauważalny z bazy danych SQL. Możesz sprawdzać status, historię, liczbę wykonań i wyniki za pomocą tego samego interfejsu, którego używasz do wszystkiego innego w HorizonDB: instrukcji
SELECT.
Czego trwałość nie robi automatycznie: sama z siebie nie sprawia, że nieidempotentne operacje zewnętrzne są bezpieczne do ponawiania. Jeśli dany krok wywołuje zewnętrzny interfejs API, którego użycie wiąże się z opłatami, zaprojektuj ten krok tak, aby był idempotentny (na przykład przekazując klucz idempotentności).
Kiedy należy używać pg_durable
Użyj pg_durable, gdy musisz nad tym pracować:
- Trwa na tyle długo, że może ulec awarii w trakcie (generowanie embeddingów dla milionów wierszy, wieloetapowe zadanie ETL, uzupełnianie danych historycznych).
- Należy ponowić próbę w przypadku niepowodzenia bez ponownego wykonywania części, które zostały już pomyślnie wykonane.
- Musi być uruchamiany zgodnie z harmonogramem (co godzinę, co dzień powszedni o 9:00).
- Musi poczekać na zewnętrzne zdarzenie (zatwierdzenie, webhook, sygnał z innego systemu).
- Koordynuje wiele kroków z rozgałęzianiem, łączeniem lub rywalizacją.
- Jest obecnie implementowany jako zewnętrzny koordynator i baza danych Postgres, gdzie większość pracy jest częścią bazy danych.
Jeśli obciążenie robocze składa się z jednej krótkiej instrukcji transakcyjnej, nie potrzebujesz pg_durable. Użyj zwykłego INSERT / UPDATE.
Jak to działa
Funkcja trwała to graf kroków, które tworzysz przy użyciu języka SQL DSL i przesyłasz za pomocą polecenia df.start(). Graf jest zapisywany, a następnie wykonywany przez proces roboczy działający w tle.
Dwa kluczowe pomysły:
-
Graf funkcji i stan wykonywania są przechowywane w samej HorizonDB, w schematach
dfiduroxide. Kopie zapasowe, przywracanie do punktu w czasie i wysoka dostępność mają zastosowanie automatycznie do stanu przepływu pracy. Nie ma potrzeby zarządzania oddzielnym stanem orkiestratora. - Proces działający w tle jest uruchamiany przez
shared_preload_libraries. Wykrywa rozszerzenie poCREATE EXTENSIONi rozpoczyna wykonywanie funkcji. Jeśli baza danych zostanie ponownie uruchomiona, proces roboczy ponownie połączy się z uruchomionymi instancjami i wznowi ich działanie.
Note
Silnik wykonawczy wewnątrz pg_durable jest oparty na Duroxide, otwartoźródłowym środowisku uruchomieniowym trwałego wykonywania firmy Microsoft dla języka Rust (inspirowanym frameworkiem Durable Task Framework i Temporal). Nazwa duroxide schematu odzwierciedla to: w tym miejscu duroxide utrwala historię aranżacji, identyfikatory korelacji i stan odtwarzania. Gwarancje deterministycznego odtwarzania, skorelowanych identyfikatorów zdarzeń i trwałych czasomierzy, które zapewnia pg_durable, pochodzą bezpośrednio z Duroxide.
Włącz pg_durable
Aby włączyć pg_durable w usłudze Azure HorizonDB, najpierw skonfiguruj grupę parametrów, a następnie utwórz rozszerzenie w każdej bazie danych.
Skorzystaj z następujących artykułów dotyczących konfiguracji:
- Utwórz grupę parametrów dla serwera.
- Ustaw
shared_preload_librariestak, aby uwzględnićpg_durable. - Ustaw
azure.extensionstak, aby uwzględnićpg_durable. - Zastosuj grupę parametrów do serwera.
- Połącz się z każdą docelową bazą danych i uruchom polecenie:
Utwórz rozszerzenie w każdej bazie danych, w której chcesz go użyć:
CREATE EXTENSION IF NOT EXISTS pg_durable;
CREATE EXTENSION udostępnia schemat df (grafy funkcji i widoki monitorowania) oraz schemat duroxide (stan wykonania). Proces roboczy w tle wykrywa rozszerzenie w ciągu kilku sekund i jest gotowy do uruchomienia funkcji.
Twoja pierwsza funkcja trwała
-- Start a one-step durable function
SELECT df.start('SELECT ''Hello, durable world!''');
-- Returns an 8-character instance ID, for example: a1b2c3d4

-- Check status
SELECT df.status('a1b2c3d4');

-- Get the result
SELECT df.result('a1b2c3d4');
Nawet funkcja jednoetapowa jest odporna: jeśli baza danych zrestartuje się po df.start() i zanim proces roboczy ją podejmie, funkcja i tak zostanie wykonana.
Note
df.start() przesyła przepływ pracy asynchronicznie i zwraca natychmiast. W przypadku wieloetapowych przepływów pracy użyj polecenia df.list_instances(), df.instance_info(), df.status()lub df.result() , aby potwierdzić ukończenie przed zweryfikowaniem skutków ubocznych.
Model programu
Funkcja trwała to graf zbudowany na podstawie kroków, operatorów i wbudowanych funkcji. Zwykłe ciągi SQL są automatycznie opakowywane, więc nie trzeba jawnie wywoływać df.sql().
Operatorów
| Obsługujący | Meaning | Przykład |
|---|---|---|
~> |
Sekwencja — uruchom w lewo, a następnie w prawo | 'SELECT 1' ~> 'SELECT 2' |
& |
Dołącz — uruchom równolegle, czekaj na wszystkie | 'SELECT 1' & 'SELECT 2' |
| |
Wyścig - bieg równolegle, pierwsze zwycięstwa | fast_query | df.sleep(30) |
?>
!>
|
if / else — rozgałęzienie na podstawie warunku logicznego | cond ?> then_branch !> else_branch |
@> |
Pętla — powtarzaj w nieskończoność (operator przedrostkowy) | @> body |
|=> |
Nazwa — przechwyć wynik kroku | 'SELECT id FROM users LIMIT 1' |=> 'user_id' |
Przydatne wbudowane funkcje
| Function | Purpose |
|---|---|
df.sleep(seconds) |
Wstrzymaj na N sekund. Trwałe w przypadku ponownych uruchomień. |
df.wait_for_schedule(cron) |
Poczekaj, aż wyrażenie cron zostanie spełnione następnym razem. |
df.wait_for_signal(name, timeout) |
Blokuj do momentu nadejścia zewnętrznego df.signal() . |
df.http(url, method, body, headers, timeout) |
Wykonaj wywołanie HTTP jako trwałe działanie, a następnie ponów próbę w przypadku błędu przejściowego. |
df.if(cond, then, else) |
Gałąź warunkowa. |
df.loop(body, cond) |
Powtarzaj, gdy warunek SQL jest prawdziwy. |
df.join(a, b) / df.race(a, b) |
Wykonanie równoległe i wyścigowe. |
df.join3(a, b, c) |
Do trójkierunkowego wykonywania równoległego. |
df.start(body, label, database) |
Prześlij funkcję trwałą i zwróć jej identyfikator wystąpienia. |
df.cancel(id, reason) |
Anuluj uruchomione wystąpienie. |
df.status(id) / df.result(id) |
Sprawdź wynik. |
df.explain(input) |
Renderowanie grafu funkcji na potrzeby wizualizacji. |
Przeczytaj więcej na temat wszystkich funkcji pg_durable.
Variables
|=> przechwytuje wynik kroku o nazwie; późniejsze kroki odwołują się do niego jako $name.
SELECT df.start(
    'SELECT 100 AS amount' |=> 'total'
    ~> 'SELECT $total * 2 AS doubled'
);
Przykłady użycia
Wieloetapowy proces ETL z ponownymi próbami
Codzienny proces ETL, który czyści, ładuje, indeksuje i rejestruje:
SELECT df.start(
    'DELETE FROM target WHERE loaded_at < now() - INTERVAL ''1 day'''
    ~> 'INSERT INTO target SELECT * FROM staging'
    ~> 'REINDEX TABLE target'
    ~> 'INSERT INTO etl_log (job, finished_at) VALUES (''nightly'', now())',
    'nightly-etl'
);
Jeśli baza danych zrestartuje się między DELETE a INSERT, worker wznowi działanie od INSERT — nie wykona ponownie DELETE.
Zaplanowane zadanie (cron)
Uruchom zadanie konserwacji każdego dnia tygodnia o 9:00:
SELECT df.start(
    @> (
        df.wait_for_schedule('0 9 * * 1-5')
        ~> 'CALL refresh_materialized_views()'
    ),
    'weekday-refresh'
);
Jeśli chcesz zatrzymać to zadanie, możesz uruchomić cancel funkcję .
SELECT df.cancel('a1b2c3d4', 'stop test cron job');
Obieg zatwierdzania z limitem czasu
Poczekaj do 24 godzin na sygnał zatwierdzenia zewnętrznego, a następnie zatwierdź lub odrzuć:
SELECT df.start(
    'SELECT order_id, total FROM orders WHERE id = 1' |=> 'order'
    ~> df.wait_for_signal('approval', 86400) |=> 'sig'
    ~> df.if(
        'SELECT NOT ($sig::jsonb->>''timed_out'')::boolean
            AND ($sig::jsonb->''data''->>''approved'')::boolean',
        'UPDATE orders SET status = ''approved'' WHERE id = $order_id',
        'UPDATE orders SET status = ''rejected'' WHERE id = $order_id'
    ),
    'order-approval'
);

-- Later, approve from anywhere
SELECT df.signal('a1b2c3d4', 'approval',
                 '{"approved": true, "approver": "jane@contoso.com"}');
Trwałe wywołanie HTTP
df.http() wykonuje wywołania zewnętrzne jako trwałe działania — odpowiedzi 5xx, błędy sieci i przekroczenia limitu czasu są automatycznie ponawiane.
SELECT df.start(
    df.http('https://api.example.com/users/123', 'GET') |=> 'user'
    ~> 'INSERT INTO users_cache (data) VALUES (($user::jsonb->>''body'')::jsonb)',
    'fetch-user'
);
Przeczytaj więcej na temat dozwolonych zabezpieczeń HTTP w pg_durable.
Obserwacja i sterowanie
Wszystko można odpytać w SQL. Do nauki nie ma oddzielnego interfejsu użytkownika ani usługi.
-- All instances
SELECT * FROM df.list_instances();

-- Filter by status
SELECT * FROM df.list_instances() WHERE status = 'Running';
SELECT * FROM df.list_instances() WHERE status = 'Failed';

-- Detail for one instance
SELECT * FROM df.instance_info('a1b2c3d4');

-- Execution history (useful for retried or looped functions)
SELECT * FROM df.instance_executions('a1b2c3d4', 20);

-- The function graph as it ran
SELECT * FROM df.instance_nodes('a1b2c3d4');

-- System-wide metrics
SELECT * FROM df.metrics();
Aby sprawdzić, czy proces roboczy jest aktywny:
SELECT epoch_id, last_seen_at, now() - last_seen_at AS time_since_last_heartbeat
FROM df._worker_epoch;
time_since_last_heartbeat poniżej 15 sekund oznacza, że worker działa prawidłowo. Każda większa wartość lub brak jakichkolwiek wierszy oznacza, że proces roboczy nie działa lub nie został zainicjowany.
Monitorowanie przepływów pracy w Visual Studio Code
Rozszerzenie PostgreSQL dla Visual Studio Code zawiera kartę Przepływy pracy w widoku Pipelines & Workflows, w którym można przeglądać pg_durable instancje przepływów pracy i monitorować stan wykonania bezpośrednio w edytorze.
Otwórz okienko Przepływy pracy
- W Visual Studio Code otwórz rozszerzenie PostgreSQL.
- W Eksplorator obiektów kliknij prawym przyciskiem myszy bazę danych.
- Wybierz pozycję Potoki i przepływy pracy.
- Wybierz kartę Przepływy pracy .
W okienku po lewej stronie znajduje się lista Pg Durable Runs, a środkowe okienko zawiera szczegóły wybranego wystąpienia przepływu pracy.
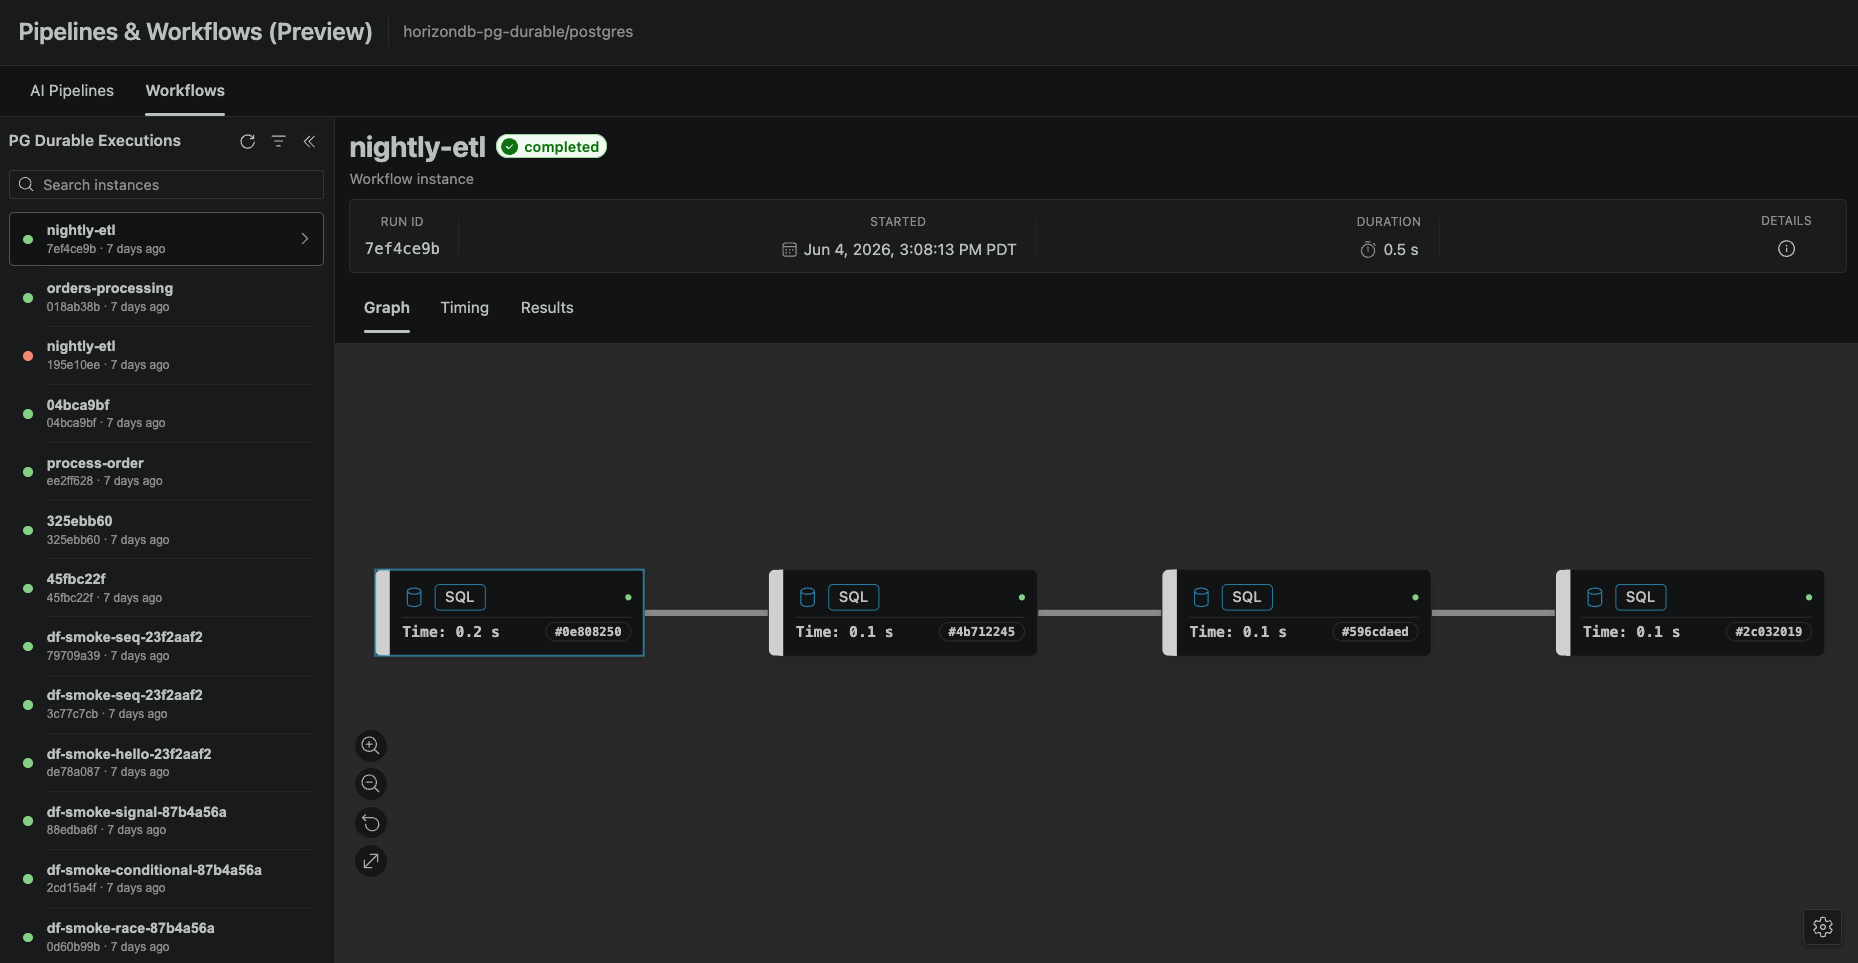
Sprawdzanie przebiegów przepływu pracy
Po wybraniu przebiegu przepływu pracy przejrzyj podsumowanie, aby sprawdzić poprawność:
-
Stan:
completed,runninglubfailed. - Identyfikator uruchomienia: unikatowy identyfikator wystąpienia.
- Czas rozpoczęcia i czas trwania: Śledzenie postępu wykonywania i wydajności.
- Panel szczegółów: dodatkowe metadane wykonania.
Użyj dostępnych kart, aby zagłębić się w temat:
- Wykres: wizualny widok przedstawiający wykonywanie krok po kroku, pokazujący strukturę przepływu pracy i kolejność kroków.
- Chronometraż: widok ukierunkowany na czas trwania na potrzeby analizy wydajności i identyfikacji wąskich gardeł.
- Wyniki: dane wyjściowe i szczegóły dotyczące wyników wykonania przepływu pracy.
W przypadku przepływów pracy związanych z potokami AI akcja Wyświetl definicję potoku (jeśli jest dostępna) umożliwia przejście z uruchomienia przepływu pracy do definicji potoku, co jest przydatne do porównywania zachowania między uruchomieniami lub badania regresji.
Tożsamość i izolacja
Funkcje Durable Functions są wykonywane z uprawnieniami użytkownika, który je przesłał, a nie z uprawnieniami procesu roboczego.
pg_durable przechwytuje zarówno session_user, jak i current_user w momencie przesłania, więc funkcje przesłane w kontekście SET ROLE są uruchamiane z tą efektywną rolą.
Oznacza to, że:
- Użytkownicy widzą i modyfikują tylko dane, do których już mają uprawnienia dostępu.
- Użytkownicy niebędący superużytkownikami nie mogą eskalować uprawnień poprzez przesłanie funkcji trwałej.
- Obciążenia wielodzierżawne pozostają odizolowane, o ile stosowane role oraz model uprawnień są poprawne.
Interakcja z replikami, kopiami zapasowymi i PITR
- Kopia zapasowa i PITR. Wykres funkcji (
dfschemat) i stan wykonywania (duroxideschemat) są przechowywane w zwykłych tabelach i są uwzględniane w kopiach zapasowych bazy danych HorizonDB. Przywracanie do punktu w czasie przywraca oba elementy. - Repliki do odczytu. Proces roboczy w tle działa tylko na serwerze podstawowym. Repliki do odczytu mogą odpytywać widoki monitorowania
df.*, ale nie uruchamiają funkcji. - Failover. Po przełączeniu awaryjnym proces roboczy na nowym serwerze podstawowym kontynuuje pracę w miejscu, w którym zakończył ją poprzedni serwer podstawowy. Działające instancje wznawiają działanie od ostatniego punktu kontrolnego.
W porównaniu z zewnętrznymi orchestratorami
| Aspect | Zewnętrzny koordynator | pg_durable |
|---|---|---|
| Deployment | Oddzielna usługa, oddzielna tożsamość, oddzielny magazyn stanu | Jedna baza danych |
| Trwałość stanu | Warstwa przechowywania Orchestratora | Te same kopie zapasowe, wysoka dostępność i PITR jak Twoje dane |
| Identity | Procesy robocze działają z użyciem tożsamości usługi | Funkcje są wykonywane jako użytkownik przesyłający |
| Tryby uszkodzeń | Sieć między orkiestratorem a bazą danych | Brak - ten sam proces |
| Najlepsze dla | Orkiestracja międzysystemowa obejmująca wiele usług | Obciążenia robocze, w których większość pracy odbywa się w Postgresie lub w jego pobliżu |
pg_durable Program nie próbuje zastąpić zewnętrznych orkiestratorów dla potoków między systemami. Jest to właściwy wybór, gdy większość pracy to praca z bazą danych — osadzanie, transformacje, wywołania sztucznej inteligencji, zaplanowana konserwacja — a dodanie kolejnej usługi jest bardziej kosztowne niż korzyści.
Ograniczenia podczas korzystania z wersji zapoznawczej
-
df.http()ponawia próby w przypadku błędów 5xx i błędów sieciowych. Odpowiedzi 4xx są zwracane do przepływu pracy, aby można było je obsłużyć; nie są automatycznie ponawiane. - Usługa działająca w tle obsługuje jedną bazę danych na instancję. Obsługa rozgałęziania na wiele baz danych jest realizowana za pomocą funkcji
df.start(..., database => 'other_db'), uruchomionej w bazie danych workera. - Definicje funkcji i stan wykonywania nie są przenośne między głównymi wersjami
pg_durablew okresie wersji zapoznawczej. Opróżnianie lub anulowanie uruchomionych wystąpień przed uaktualnieniem.
Treści powiązane
- Tworzenie trwałych potoków AI w Azure HorizonDB (wersja zapoznawcza)
- funkcje AI w rozszerzeniu azure_ai dla Azure HorizonDB (wersja zapoznawcza)
- Generowanie osadzania wektorów przy użyciu funkcji create_embeddings() AI (wersja zapoznawcza)
- Zezwalaj na rozszerzenia w usłudze Azure HorizonDB (wersja zapoznawcza)
- Duroxide w GitHub