Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Integracja usługi Azure Machine Learning z usługą Azure Synapse Analytics zapewnia łatwy dostęp do rozproszonych zasobów obliczeniowych za pośrednictwem platformy Apache Spark. Ta integracja oferuje następujące środowiska obliczeniowe platformy Apache Spark:
- Bezserwerowe obliczenia platformy Spark
- Dołączona pula Apache Spark w usłudze Synapse
Bezserwerowe obliczenia platformy Spark
W przypadku platformy Apache Spark obliczenia bezserwerowe platformy Spark w usłudze Azure Machine Learning to najprostszy sposób wykonywania zadań przetwarzania rozproszonego w środowisku usługi Azure Machine Learning. Usługa Azure Machine Learning oferuje w pełni zarządzany, bezserwerowy klaster obliczeniowy platformy Apache Spark. Nie musisz tworzyć ani obszaru roboczego Azure Synapse, ani puli Synapse Spark.
Możesz zdefiniować zasoby, w tym typ wystąpienia i wersję środowiska uruchomieniowego platformy Apache Spark. Użyj tych zasobów, aby uzyskać dostęp do bezserwerowych zasobów obliczeniowych platformy Spark w notesach usługi Azure Machine Learning dla:
- Interaktywne programowanie kodu platformy Spark
- Uruchamianie potoków uczenia maszynowego za pomocą składnika Spark
- Przesyłanie zadań wsadowych platformy Spark
Kwestie do rozważenia
Przetwarzanie bezserwerowe platformy Spark działa dobrze w przypadku większości scenariuszy użytkownika, które wymagają szybkiego dostępu do rozproszonych zasobów obliczeniowych za pośrednictwem platformy Apache Spark. Jednak w celu podjęcia świadomej decyzji należy wziąć pod uwagę zalety i wady tego podejścia.
Zalety:
- Brak zależności od tworzenia innych zasobów platformy Azure dla platformy Apache Spark (infrastruktura usługi Azure Synapse działa pod maską).
- Brak wymaganych uprawnień subskrypcji do tworzenia zasobów związanych z usługą Azure Synapse.
- Nie są potrzebne limity puli SQL.
Wady:
- Brak trwałego magazynu metadanych Hive. Bezserwerowe zasoby obliczeniowe Spark obsługują tylko mechanizm Spark SQL działający w pamięci.
- Brak dostępnych tabel ani baz danych.
- Brak integracji usługi Azure Purview.
- Brak dostępnych połączonych usług.
- Mniej źródeł danych i łączników.
- Brak konfiguracji na poziomie puli.
- Brak zarządzania bibliotekami na poziomie puli.
- Tylko częściowa obsługa programu
mssparkutils.
Konfiguracja sieci
Aby użyć izolacji sieciowej z usługą Azure Machine Learning i bezserwerowymi obliczeniami platformy Spark, użyj zarządzanej sieci wirtualnej.
Okresy braku aktywności i mechanizm zamykania
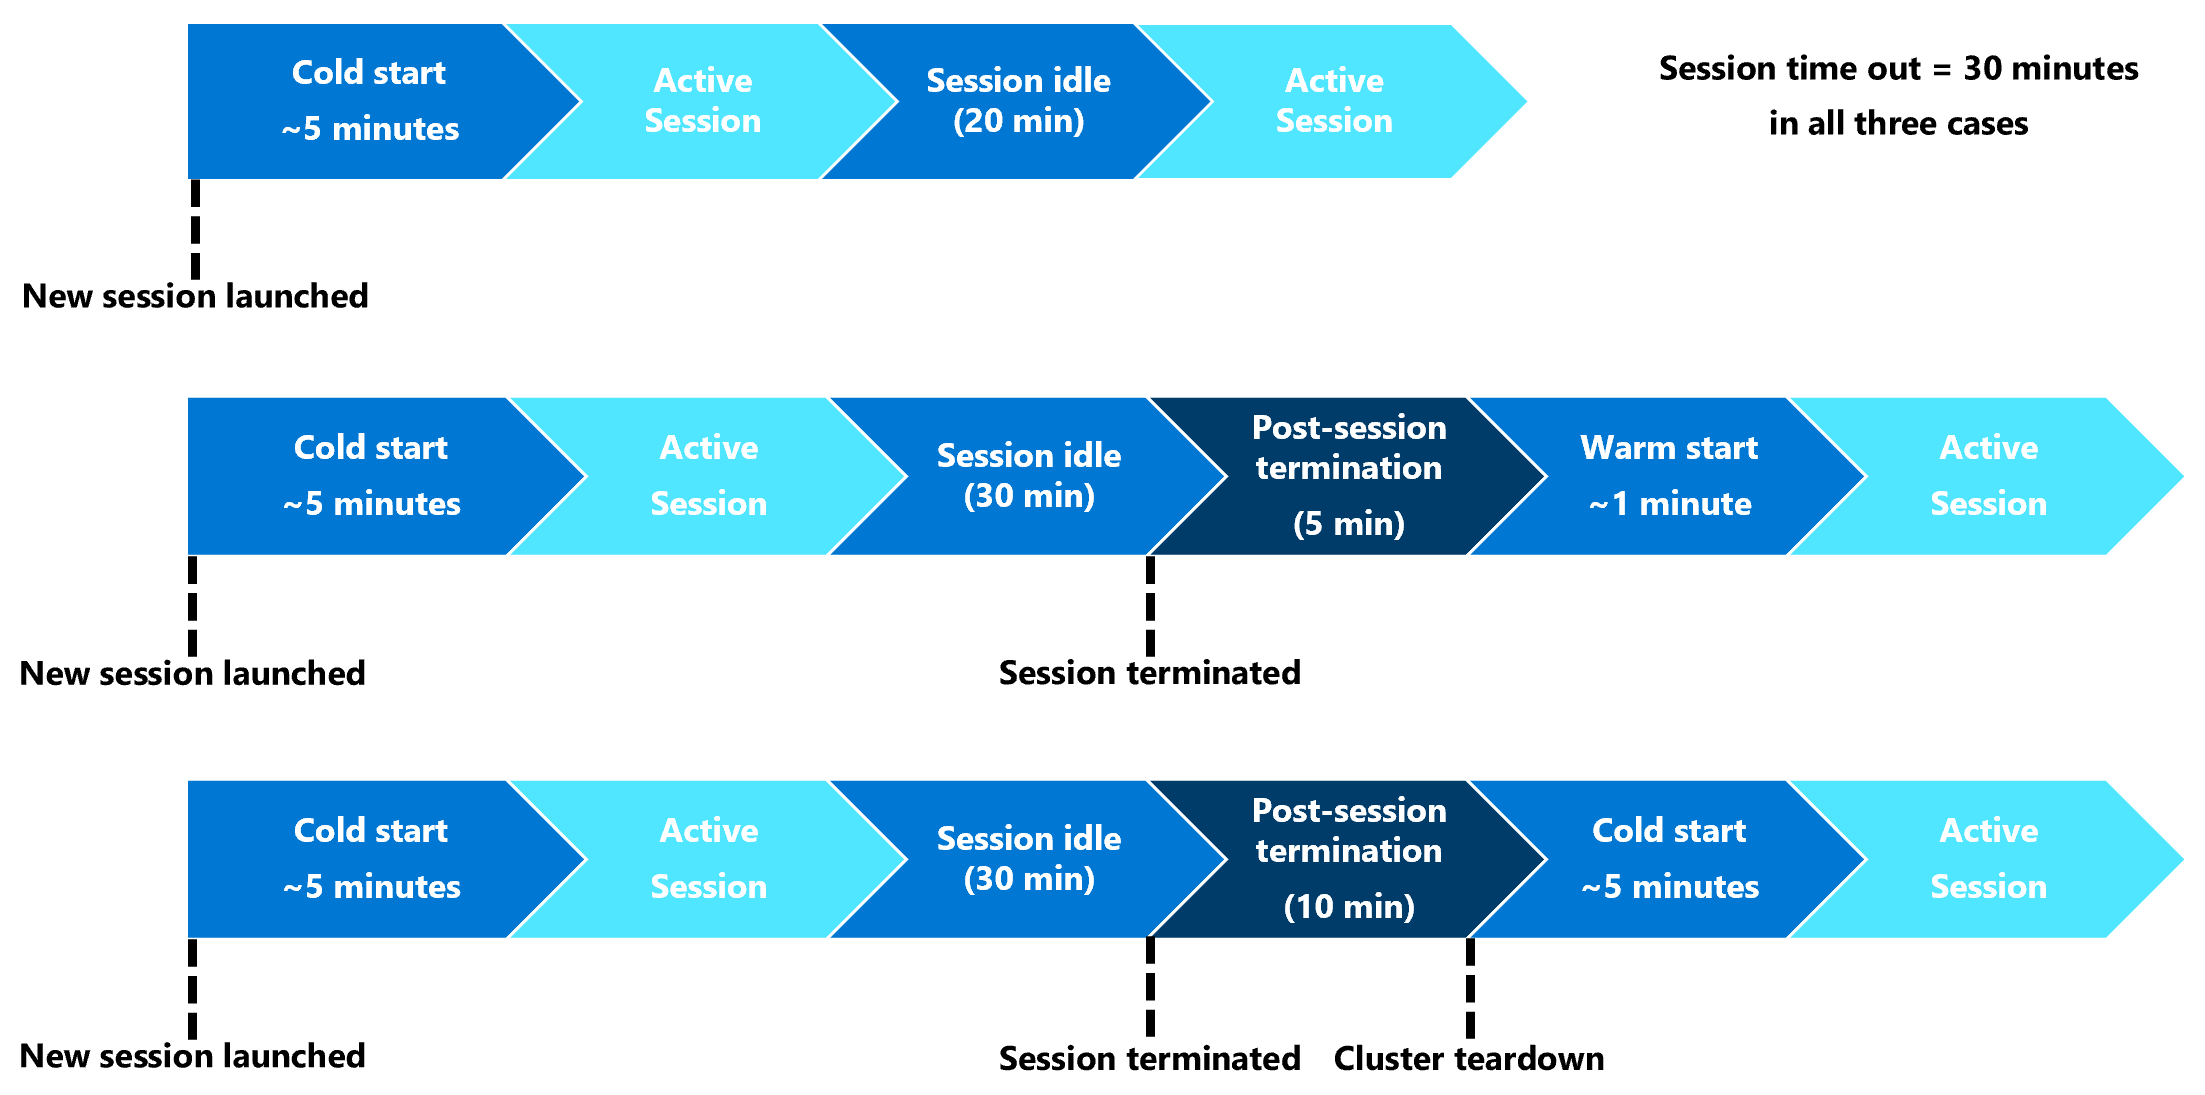
Przy pierwszym uruchomieniu zasób obliczeniowy platformy Spark bezserwerowy (zimny start) może wymagać od trzech do pięciu minut, aby uruchomić samą sesję platformy Spark. To opóźnienie występuje, ponieważ zautomatyzowany bezserwerowy zasób obliczeniowy Spark wspierany przez usługę Azure Synapse wymaga czasu na aprowizację. Po udostępnieniu bezserwerowego zasobu Spark i rozpoczęciu sesji Apache Spark, kolejne wykonania kodu (ciepły start) nie doświadczają tego opóźnienia.
Konfiguracja sesji platformy Spark oferuje opcję, która definiuje limit czasu sesji (w minutach). Sesja platformy Spark kończy się po okresie braku aktywności, który przekracza limit czasu zdefiniowany przez użytkownika. Jeśli kolejna sesja platformy Spark nie zostanie uruchomiona w ciągu następnych 10 minut, system usuwa zasoby przydzielone dla bezserwerowego przetwarzania Spark.
Po usunięciu bezserwerowego zasobu obliczeniowego Spark przesłanie następnego zadania wymaga zimnego startu. Poniższa wizualizacja przedstawia niektóre scenariusze okresów bezczynności sesji i likwidacji klastra.
Pakiety Conda na poziomie sesji
Plik YAML z zależnościami Conda może określać wiele pakietów Conda na poziomie sesji w konfiguracji sesji. Sesja wygasa, jeśli instalacja pakietów Conda zdefiniowanych w pliku YAML trwa dłużej niż 15 minut. Sprawdź, czy wymagany pakiet jest już dostępny w obrazie podstawowym usługi Azure Synapse. W tym celu odwiedź te zasoby, aby określić pakiety dostępne na obrazie podstawowym dla używanej wersji platformy Apache Spark:
- Środowisko uruchomieniowe usługi Azure Synapse dla platformy Apache Spark 3.5
- Środowisko uruchomieniowe usługi Azure Synapse dla platformy Apache Spark 3.4
Uwaga
W przypadku pakietu Conda na poziomie sesji:
- Zimny start trwa około 10 do 15 minut.
- Ciepły początek, używając tego samego pakietu Conda, wymaga około jednej minuty.
- Ciepły początek, z innym pakietem Conda, potrzebuje około 10 do 15 minut.
- Jeśli zainstalujesz duży pakiet lub pakiet, którego instalacja zajmuje dużo czasu, może to wpłynąć na czas uruchamiania instancji Spark.
- Modyfikacja wersji PySpark, Python, Scala/Java, .NET lub Spark nie jest obsługiwana.
- Obrazy Docker nie są obsługiwane.
Skrócenie czasu zimnego startu sesji podczas korzystania z pakietów Conda na poziomie sesji
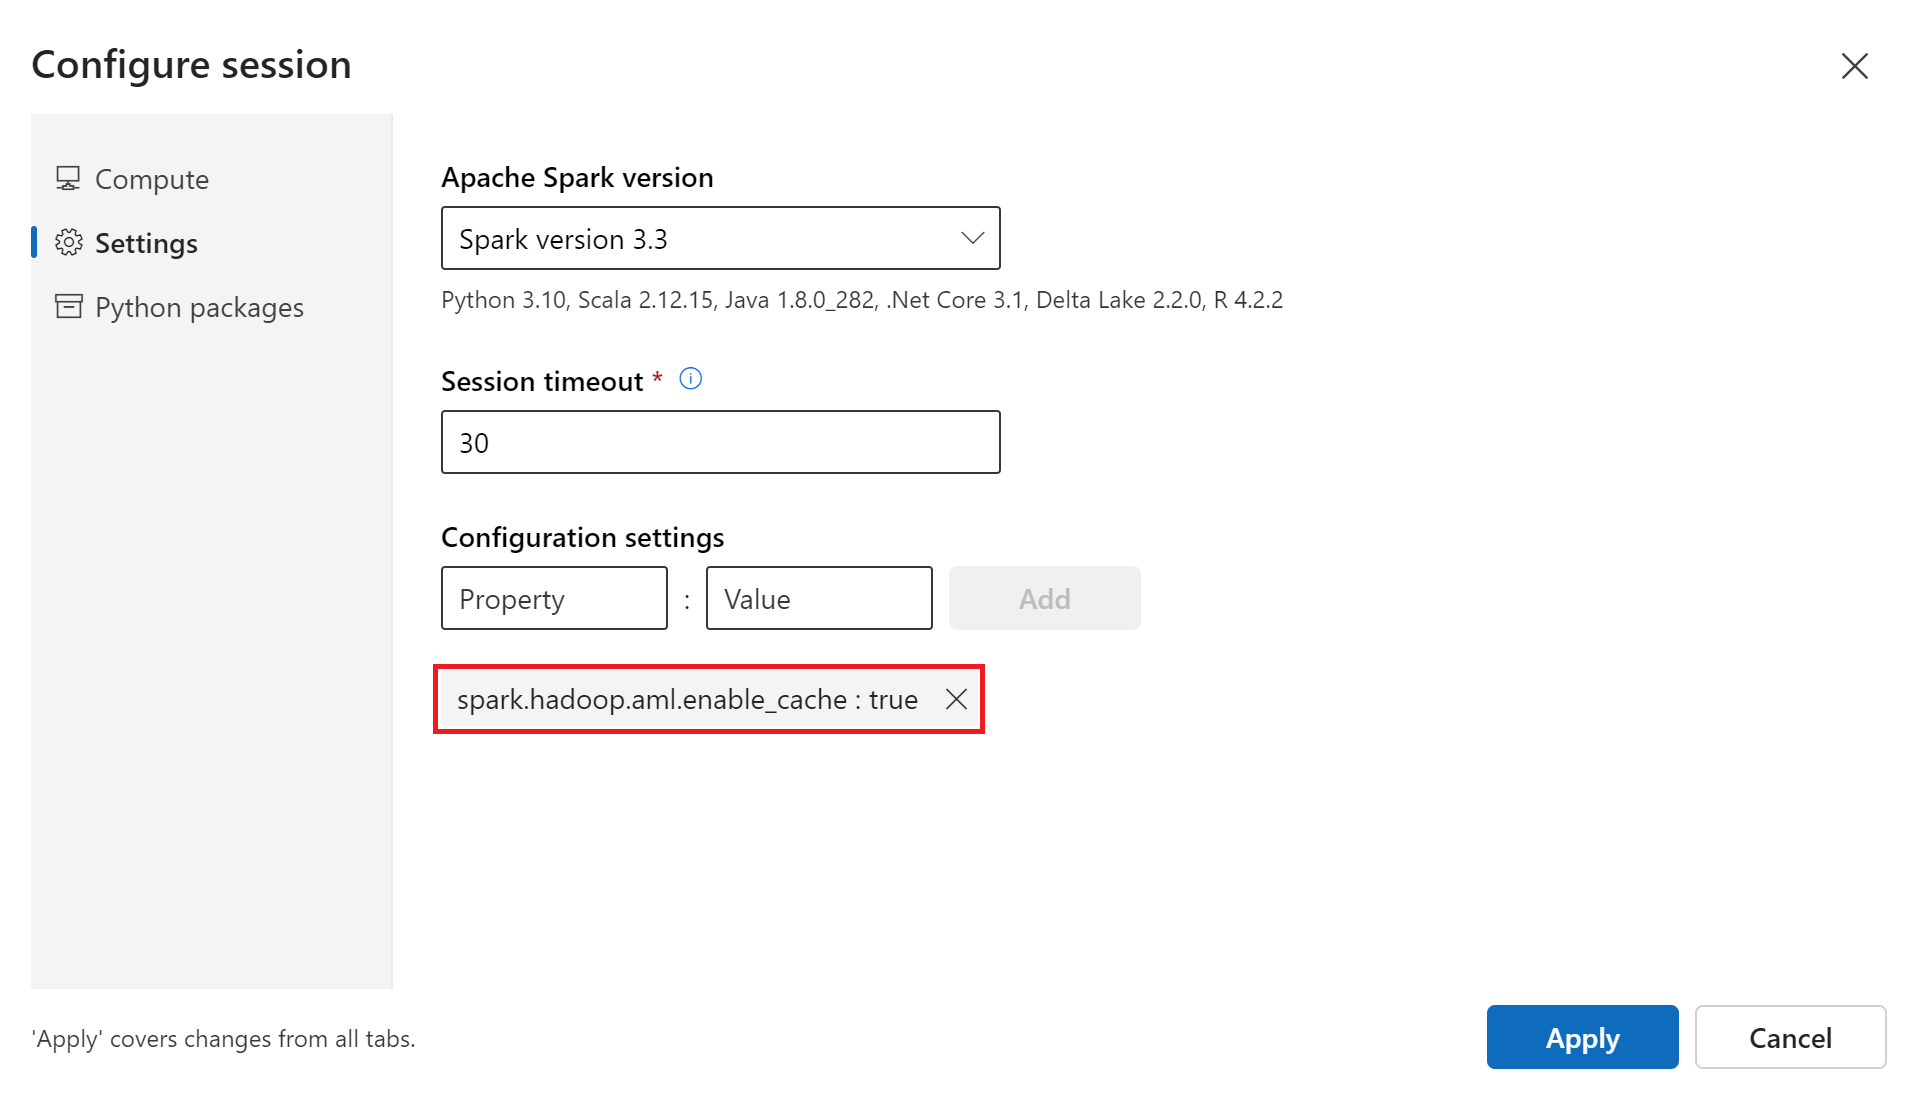
Ustaw zmienną konfiguracji spark.hadoop.aml.enable_cache na wartość true w celu poprawy czasu zimnego rozruchu sesji Spark. W przypadku pakietów Conda na poziomie sesji zimny start zazwyczaj trwa od 10 do 15 minut, gdy sesja rozpoczyna się po raz pierwszy. Jednak kolejne zimne rozpoczęcie sesji trwa od trzech do pięciu minut. Zdefiniuj zmienną konfiguracyjną w interfejsie użytkownika Konfigurowanie sesji, w sekcji Ustawienia konfiguracji.
Dołączona pula platformy Synapse Spark
Podczas tworzenia puli Spark w obszarze roboczym usługi Azure Synapse możesz uzyskać do niej dostęp w obszarze roboczym usługi Azure Machine Learning przy użyciu dołączonej puli usługi Synapse Spark. Ta opcja jest dobra dla użytkowników, którzy chcą ponownie użyć istniejącej puli usługi Synapse Spark.
Aby dołączyć pulę usługi Synapse Spark do obszaru roboczego usługi Azure Machine Learning, przed użyciem puli w usłudze Azure Machine Learning należy wykonać więcej kroków :
- Interaktywne programowanie kodu platformy Spark
- Przesyłanie wsadowych zadań Spark
- Uruchamianie potoków uczenia maszynowego za pomocą składnika Spark
Dołączona pula platformy Synapse Spark zapewnia dostęp do natywnych funkcji usługi Azure Synapse. Odpowiadasz za przygotowywanie, dołączanie, konfigurowanie i zarządzanie pulą Synapse Spark.
Konfiguracja sesji platformy Spark dla dołączonej puli platformy Synapse Spark oferuje również opcję zdefiniowania limitu czasu sesji (w minutach). Zachowanie po przekroczeniu limitu czasu sesji jest podobne do opisu w poprzedniej sekcji, z tą różnicą, że powiązane zasoby nigdy nie są zwalniane po upływie limitu czasu sesji.
Definiowanie rozmiaru klastra Spark
W zadaniach platformy Spark usługi Azure Machine Learning można zdefiniować rozmiar klastra Spark z trzema wartościami parametrów:
- Liczba wykonawców
- Rdzenie wykonawcze
- Pamięć executora
Rozważ funkcję wykonawczą Apache Spark w usłudze Azure Machine Learning jako odpowiednik węzłów roboczych Azure Spark. Przykład może wyjaśnić te parametry. Jeśli zdefiniujesz liczbę funkcji wykonawczych jako 6 (co odpowiada sześciu węzłom roboczym), liczba rdzeni funkcji wykonawczej jako 4, a pamięć wykonawcza wynosi 28 GB, zadanie platformy Spark ma dostęp do klastra z 24 rdzeniami w sumie i 168 GB pamięci.
Zapewnianie dostępu do zasobów dla zadań platformy Spark
Aby uzyskać dostęp do danych i innych zasobów, zadanie Spark może korzystać z tożsamości zarządzanej lub mechanizmu przekazywania tożsamości użytkownika. W tej tabeli przedstawiono podsumowanie mechanizmów używanych przez zadania platformy Spark do uzyskiwania dostępu do zasobów.
| pula zadań platformy Spark | Obsługiwane tożsamości | Tożsamość domyślna |
|---|---|---|
| Bezserwerowe obliczenia platformy Spark | Tożsamość użytkownika, tożsamość zarządzana przypisana przez użytkownika dołączona do obszaru roboczego | Tożsamość użytkownika |
| Dołączona pula platformy Synapse Spark | Tożsamość użytkownika, tożsamość zarządzana przypisana przez użytkownika dołączona do dołączonej puli Synapse Spark, tożsamość zarządzana przypisana przez system dołączonej puli Synapse Spark | Tożsamość zarządzana przypisana przez system dla dołączonej puli Synapse Spark |
W tym artykule opisano dostęp do zasobów dla zadań platformy Spark. W sesji notesnika zarówno bezserwerowe środowisko obliczeniowe Spark, jak i dołączona pula Synapse Spark korzystają z przekazywania tożsamości użytkownika do uzyskiwania dostępu do danych podczas interaktywnego przygotowywania danych.
Uwaga
- Aby zapewnić pomyślne wykonanie zadania platformy Spark, przypisz role Współautor i Współautor danych obiektu blob usługi Storage (na koncie usługi Azure Storage używanym na potrzeby danych wejściowych i wyjściowych) do tożsamości używanej do przesyłania zadania platformy Spark.
- Jeśli dołączona pula Apache Spark usługi Synapse wskazuje na pulę Apache Spark usługi Synapse w obszarze roboczym Azure Synapse, a ten obszar roboczy ma skojarzoną zarządzaną sieć wirtualną, skonfiguruj zarządzany prywatny punkt końcowy do konta magazynu. Ta konfiguracja pomaga zapewnić dostęp do danych.
Następne kroki
- Dołączanie puli platformy Spark w usłudze Azure Synapse i zarządzanie nią w usłudze Azure Machine Learning
- Interakcyjne uzdatnianie danych za pomocą platformy Apache Spark w usłudze Azure Machine Learning
- Przesyłanie zadań platformy Spark w usłudze Azure Machine Learning
- Przykłady kodu dla zadań platformy Spark przy użyciu interfejsu wiersza polecenia usługi Azure Machine Learning
- Przykłady kodu dla zadań platformy Spark przy użyciu zestawu SDK języka Python usługi Azure Machine Learning