Usuwanie duplikatów i wartości pustych
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Problemy z jakością danych, takie jak zduplikowane rekordy i wartości null, mogą naruszyć bezpieczeństwo analiz i procesów podrzędnych. Niezależnie od tego, czy duplikaty wynikają z współbieżnych obciążeń danych, czy wartości null pojawiają się z powodu niekompletnych danych źródłowych, rozwiązanie tych problemów jest główną odpowiedzialnością inżynierów danych pracujących w usłudze Azure Databricks.
W tej lekcji dowiesz się, jak identyfikować i rozwiązywać zduplikowane, brakujące i null wartości przy użyciu metod SQL i PySpark.
Identyfikowanie zduplikowanych rekordów
Przed usunięciem duplikatów należy je znaleźć. Duplikaty zwykle występują, gdy ten sam rekord pojawia się wiele razy w tabeli, często z powodu problemów z integracją danych, wielokrotnego pozyskiwania lub współbieżnych operacji zapisu.
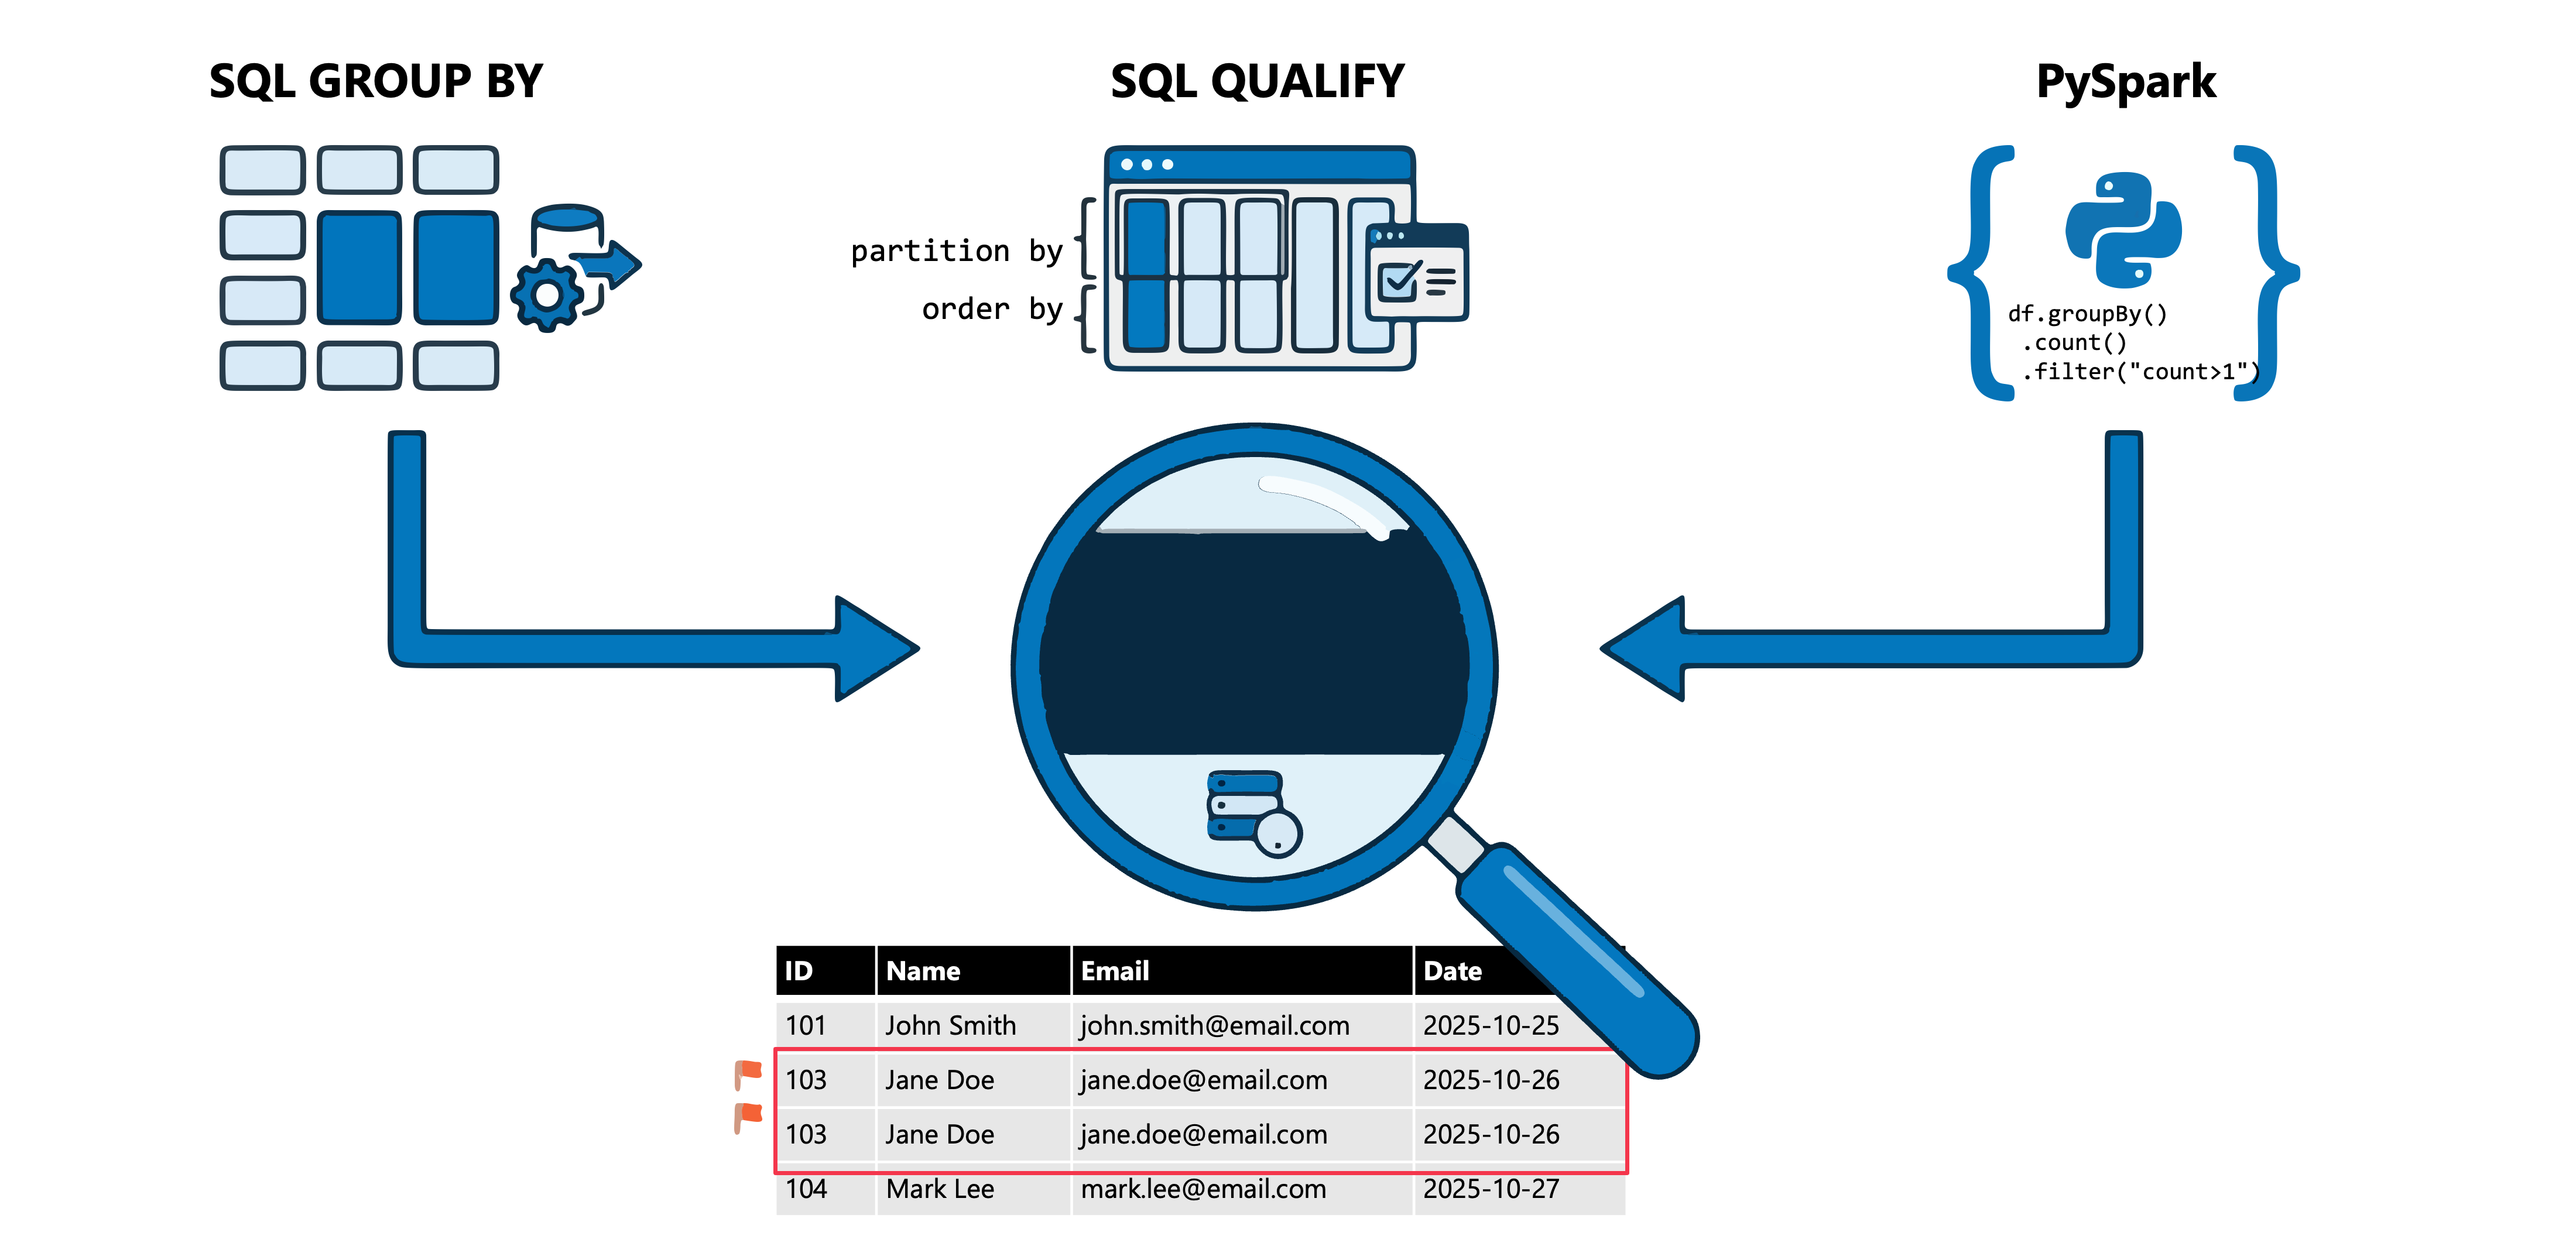
Używanie funkcji GROUP BY i HAVING do znajdowania duplikatów
Najprostszym sposobem identyfikowania duplikatów jest grupowanie rekordów i zliczanie wystąpień. Klauzula HAVING filtruje pogrupowane wyniki, aby wyświetlić tylko wartości, które pojawiają się więcej niż raz.
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
To zapytanie zwraca wszystkie kombinacje customer_id i email, które występują wielokrotnie w tabeli, pomagając zrozumieć zakres duplikacji.
Korzystanie z QUALIFY z funkcjami okienkowymi
Klauzula QUALIFY zapewnia prostsze podejście przez bezpośrednie filtrowanie wyników funkcji okna bez konieczności stosowania podzapytania. Takie podejście jest szczególnie przydatne, gdy trzeba zobaczyć faktyczne zduplikowane wiersze, a nie tylko ich liczby.
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
To zapytanie może zwracać wyniki, takie jak:
| customer_id | nazwa | utworzono_o | stan | |
|---|---|---|---|---|
| 1001 | jane@contoso.com | Jane Doe | 2024-01-15 | Aktywna |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Aktywna |
| 1002 | bob@fabrikam.com | Bob Smith | 2024-02-10 | W oczekiwaniu |
| 1002 | bob@fabrikam.com | Robert Smith | 2024-02-11 | Aktywna |
Za pomocą tego wzorca uzyskasz wszystkie kolumny z zduplikowanych wierszy, co ułatwia badanie źródła duplikacji.
Znajdowanie duplikatów przy użyciu narzędzia PySpark
W programie PySpark można używać funkcji okien połączonych z filtrowaniem w celu identyfikowania zduplikowanych rekordów:
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
Alternatywnie użyj exceptAll() metody , aby porównać oryginalną ramkę danych z deduplikowaną wersją:
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
Metoda exceptAll() wykonuje określoną różnicę, która zachowuje duplikaty. Zwraca wszystkie wiersze z pierwszej ramki danych, które nie są w drugiej ramce danych, zachowując zduplikowane wystąpienia. Oto, jak to działa:
-
df.dropDuplicates(["customer_id", "email"])tworzy ramkę danych z jednym wierszem na unikatową kombinację -
exceptAll()porównuje oryginalną ramkę danych z tą deduplikowaną wersją - Dla każdej unikatowej kombinacji jedno wystąpienie jest "dopasowane" i usunięte, pozostawiając tylko dodatkowe duplikaty
Jeśli na przykład klient 1001 pojawia się trzy razy w oryginalnej ramce danych, a raz w wersji deduplikowanej zwraca exceptAll() dwa wiersze (dodatkowe wystąpienia).
Uwaga / Notatka
W przeciwieństwie do except()elementu , który usuwa wszystkie pasujące wiersze i zwraca odrębne wyniki, exceptAll() zachowuje zduplikowaną strukturę. Jeśli masz trzy identyczne wiersze w oryginalnym zestawie i jeden w zestawie deduplikowanym, exceptAll() zwraca dokładnie dwa wiersze.
Usuwanie zduplikowanych rekordów
Po zidentyfikowaniu duplikatów możesz wybrać strategię rozwiązywania na podstawie wymagań dotyczących danych.
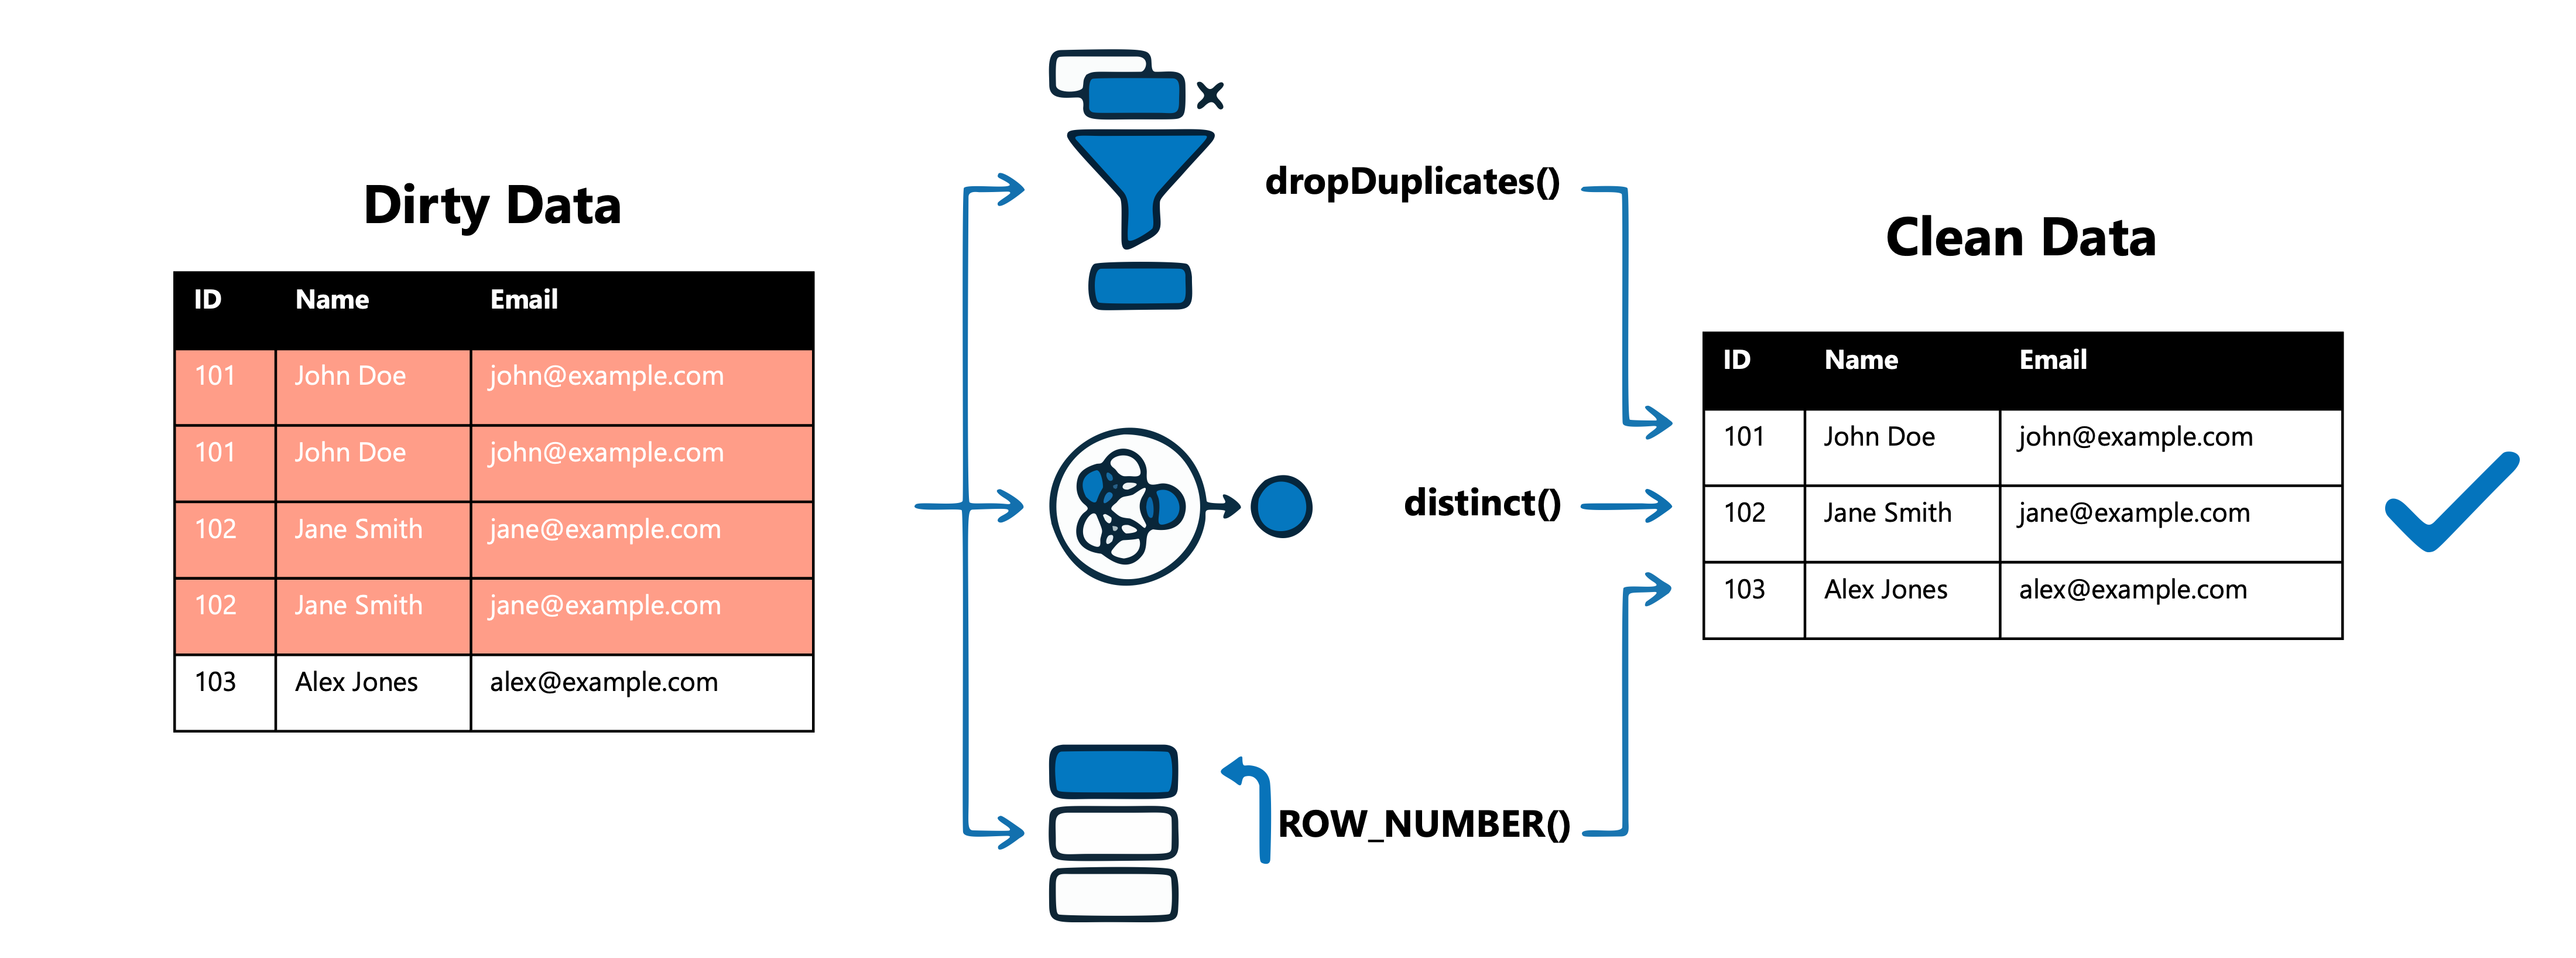
Usuwanie duplikatów w narzędziu PySpark
Metoda dropDuplicates() usuwa zduplikowane wiersze na podstawie określonych kolumn i przechowuje jeden wiersz dla każdej kombinacji. Gdy wiersze różnią się w innych kolumnach, nie ma gwarancji, który wiersz pozostanie:
df_clean = df.dropDuplicates(["customer_id", "email"])
Aby uzyskać pełną deduplikację wierszy we wszystkich kolumnach, użyj polecenia distinct():
df_unique = df.distinct()
Zachowaj określone wiersze przy użyciu ROW_NUMBER
Jeśli potrzebujesz kontroli nad tym, które duplikaty zachować, użyj polecenia ROW_NUMBER() , QUALIFY aby wybrać rekordy na podstawie kryteriów, takich jak najnowsza aktualizacja:
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
To zapytanie partycjonuje rekordy według customer_id, porządkuje je updated_at w kolejności malejącej i przechowuje tylko ostatnio zaktualizowany rekord dla każdego klienta.
Obsługa wartości null oraz braków danych
Wartości null reprezentują brakujące lub nieznane dane. W zależności od wymagań analizy może być konieczne usunięcie wierszy z wartościami null, zastąpienie ich wartościami domyślnymi lub użycie imputacji statystycznej.
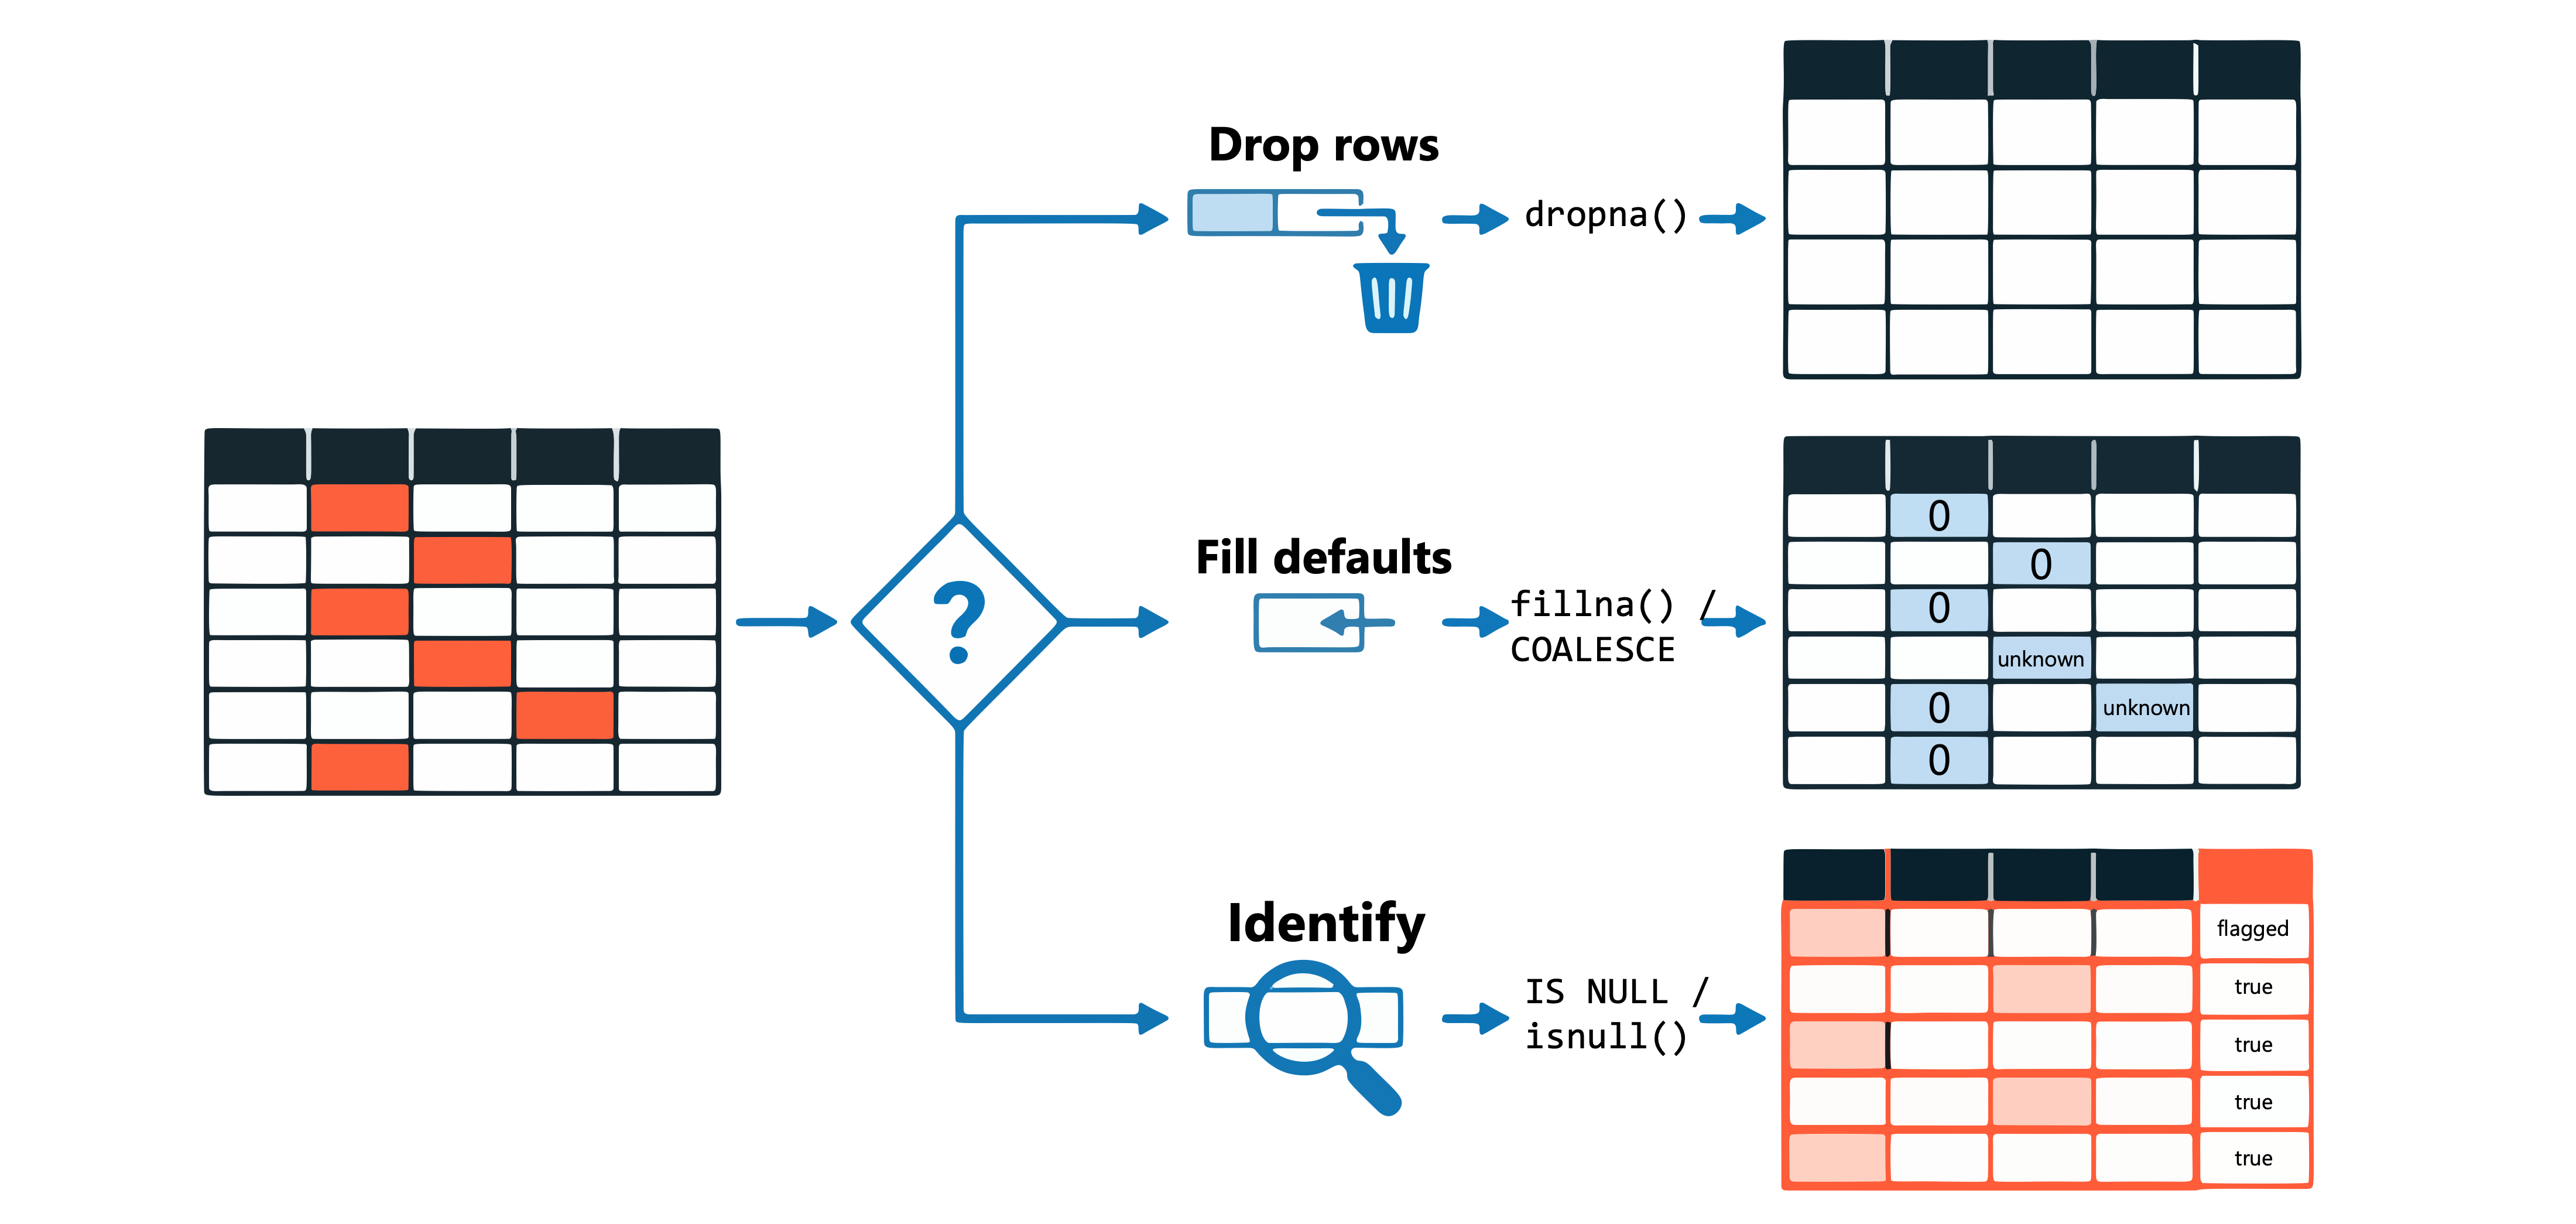
Identyfikowanie wartości null
isnull() Użyj funkcji lub IS NULL operatora, aby znaleźć rekordy z brakującymi wartościami:
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
Aby zliczyć wystąpienia wartości NULL w kolumnie:
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
Usuwanie wierszy z wartościami null
W narzędziu dropna() PySpark metoda usuwa wiersze zawierające wartości null:
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
Parametr how steruje zachowaniem: "any" porzuca wiersze z co najmniej jedną wartością null (wartość domyślna), a wiersze "all" są porzucane tylko wtedy, gdy wszystkie określone kolumny mają wartość null.
Wypełnianie wartości null wartościami domyślnymi
Metoda fillna() zastępuje wartości null określonymi wartościami domyślnymi:
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
W języku SQL użyj COALESCE funkcji , aby podać wartości domyślne:
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
Wybieranie właściwej strategii
Odpowiednia strategia obsługi wartości null zależy od kontekstu danych:
| Scenario | Zalecane podejście |
|---|---|
| Wartości null w wymaganych polach, takich jak identyfikatory | Usuwanie wierszy |
| Wartości null w polach liczbowych na potrzeby agregacji | Wypełnij zerem lub średnią |
| Wartości null w opcjonalnych polach kategorii | Uzupełnij symbolem zastępczym, na przykład "Nieznany" |
| Wartości null, które mogłyby wypaczyć analizę | Upuszczanie lub wypełnianie na podstawie wiedzy o domenie |
Wskazówka
Dokumentowanie decyzji dotyczących obsługi wartości null. Przyszli analitycy muszą zrozumieć, dlaczego niektóre wartości zostały zastąpione lub usunięte, aby prawidłowo interpretować wyniki zapytania.
Zrozumienie sposobu identyfikowania i rozwiązywania tych problemów z jakością danych przygotowuje Cię do tworzenia bardziej niezawodnych potoków danych. W przypadku czystych danych przekształcenia podrzędne i analiza generują wiarygodne wyniki.