Przekształcanie danych za pomocą sprzężeń i operatorów zestawów
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Przepływy pracy inżynierii danych często wymagają łączenia informacji z wielu zestawów danych. Złączenia łączą tabele poziomo przez dopasowywanie wierszy na powiązanych kolumnach, podczas gdy operatory zbiorów łączą tabele pionowo, dodając, przecinając lub wykluczając wiersze. Zrozumienie, kiedy należy używać każdego podejścia, ułatwia tworzenie wydajnych potoków transformacji.
W tej lekcji dowiesz się, jak łączyć tabele na podstawie relacji i stosować operatory zestawu w celu łączenia zestawów danych z pasującymi schematami.
Łączenie tabel ze sprzężeniami
Sprzężenia scalają wiersze z dwóch tabel na podstawie powiązanej kolumny. Typ sprzężenia określa, które wiersze są wyświetlane w wyniku i jak niepasowane wiersze są obsługiwane.
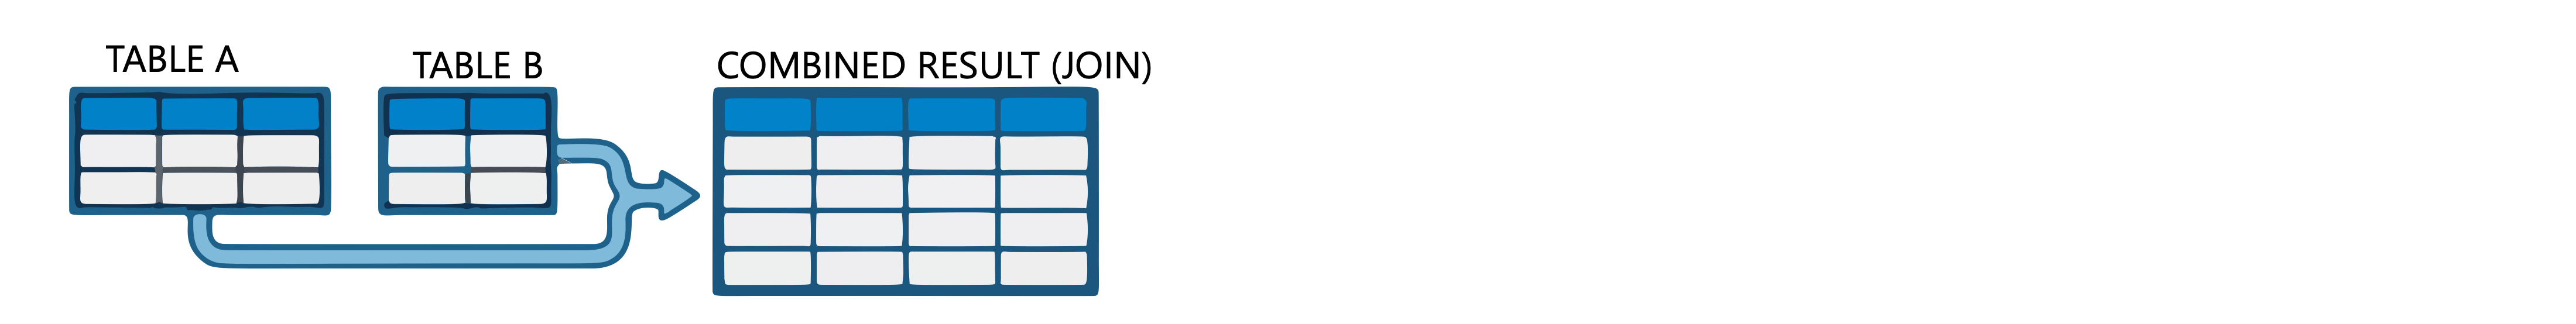
Omówienie typów sprzężenia
Każdy typ sprzężenia służy do określonego celu w przekształcaniu danych:

| Typ łączenia | Description | Przypadek użycia |
|---|---|---|
INNER |
Zwraca tylko pasujące wiersze z obu tabel | Łączenie zamówień z prawidłowymi klientami |
LEFT |
Zwraca wszystkie wiersze z lewej tabeli; dodaje wartości NULL dla prawej tabeli, gdy nie ma dopasowania. | Uwzględnij wszystkich klientów, nawet bez zamówień |
RIGHT |
Zwraca wszystkie wiersze prawej tabeli; dodaje wartości NULL dla lewej tabeli, gdy brak dopasowania. | Uwzględnij wszystkie działy, nawet bez pracowników |
FULL |
Zwraca wszystkie wiersze z obu tabel; dodaje wartości NULL dla niedopasowanych. | Łączenie zestawów danych w celu znalezienia luk po obu stronach |
SEMI |
Zwraca wiersze z lewej tabeli, które mają dopasowania w prawej tabeli | Filtrowanie klientów, którzy składali zamówienia |
ANTI |
Zwraca wiersze tabeli po lewej stronie, które nie są zgodne w prawej tabeli | Znajdowanie klientów, którzy nigdy nie składali zamówień |
CROSS |
Zwraca produkt kartezjański wszystkich wierszy | Generowanie wszystkich możliwych kombinacji |
Łączenie tabel z bazą danych SQL
Klauzula JOIN łączy tabele na podstawie warunku określonego przez ON lub USING. W poniższych przykładach są używane tabele pracowników i działów:
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Aby dopasować pracowników do swoich działów, użyj sprzężenia wewnętrznego:
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Złączenie wewnętrzne zwraca tylko trzy wiersze — pracownicy, których numery działów istnieją w tabeli działów. Pracownicy z działów 4, 5 i 6 nie pojawiają się, ponieważ te działy nie są uwzględnione w tabeli działów.
Jeśli musisz uwzględnić wszystkich pracowników niezależnie od dopasowania działu, użyj lewego sprzężenia:
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Zwraca to wszystkich sześciu pracowników. Te bez pasujących działów pokazują wartość NULL w kolumnie deptname .
Dołączanie ramek danych za pomocą narzędzia PySpark
Metoda PySpark join() zapewnia tę samą funkcjonalność. Parametr how określa typ sprzężenia:
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
W przypadku zewnętrznych sprzężeń lewych, prawych lub pełnych zmień parametr how.
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Gdy kolumna łączenia ma taką samą nazwę w obu ramkach danych, podaj nazwę kolumny jako ciąg. Takie podejście pozwala uniknąć zduplikowanych kolumn w wyniku.
Filtrowanie danych za pomocą półłączeń i antyłączeń
Półzłączenia i antyzłączenia filtrują dane na podstawie istnienia w innej tabeli. Półłączenie zwraca wiersze z lewej tabeli, które mają pasujące wartości, bez dołączania kolumn z prawej tabeli.
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Antysprzężenie zwraca odwrotne — wiersze bez dopasowań:
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
W programie PySpark użyj polecenia how="semi" lub how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Łączenie wierszy przy użyciu operatorów zestawu
Operatory ustawiania działają w pionie, łącząc wiersze z zapytań z tą samą strukturą kolumn. W przeciwieństwie do sprzężeń, operatory zbioru nie porównują na podstawie warunków — łączą lub porównują całe zestawy wyników.
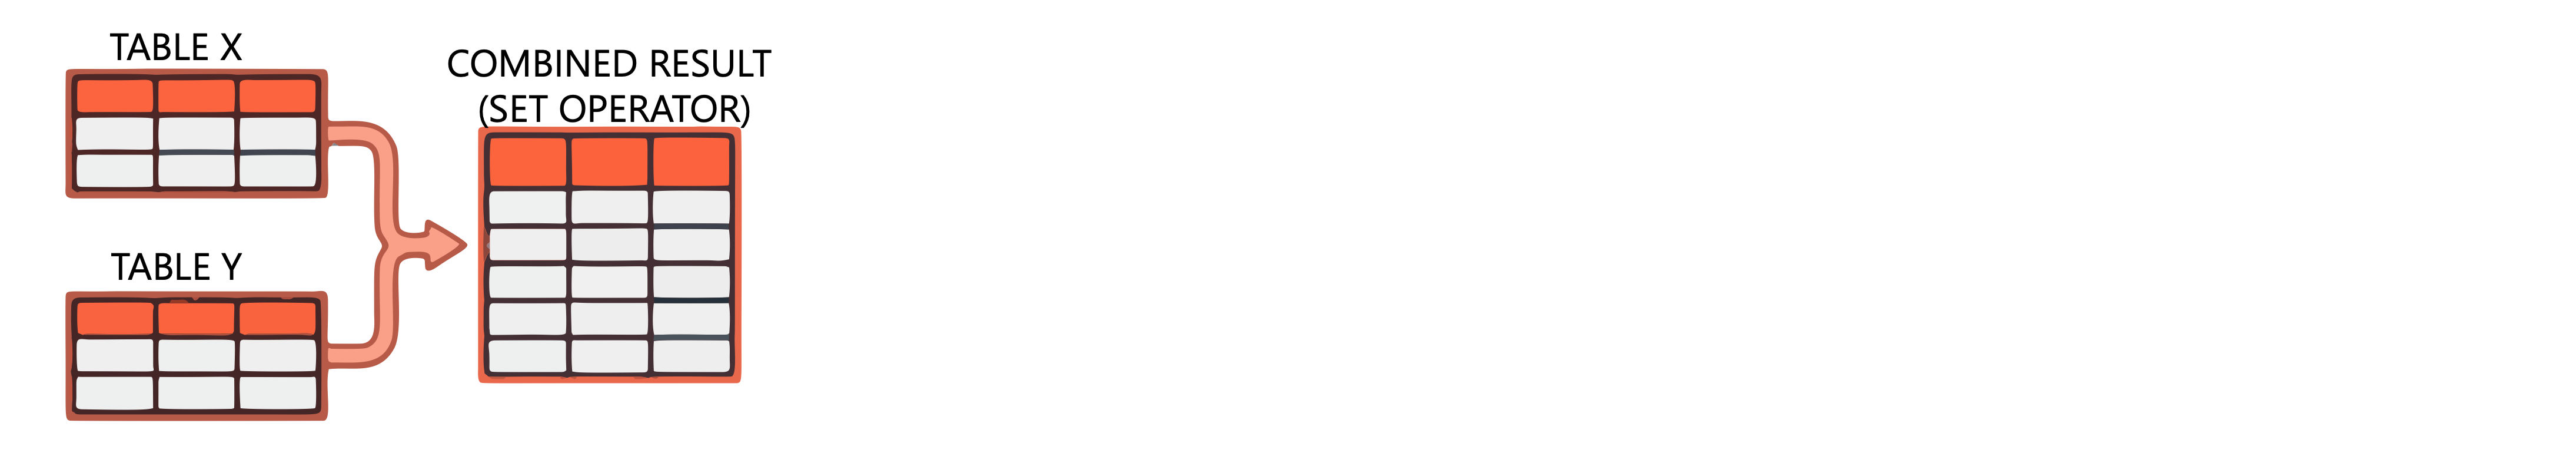
Omówienie operatorów zestawu
Usługa Azure Databricks wspiera trzy operatory zestawu:
| Operator | Description | Zachowanie |
|---|---|---|
UNION |
Łączy wiersze z obu zapytań | Domyślnie usuwa duplikaty; użyj ALL, aby zachować |
INTERSECT |
Zwraca wiersze, które istnieją w obu zapytaniach | Wyświetlane są tylko pasujące wiersze |
EXCEPT |
Zwraca wiersze z pierwszego zapytania, które nie występują w drugim. | Domyślnie usuwa duplikaty |
Oba zapytania muszą mieć taką samą liczbę kolumn z zgodnymi typami danych.
Scalanie zestawów danych za pomocą UNION
UNION Dołącza wiersze z jednego zapytania do drugiego. Domyślnie usuwa duplikaty:
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Aby zachować wszystkie wiersze, w tym duplikaty, użyj polecenia UNION ALL:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Użyj UNION ALL, jeśli wiesz, że nie ma duplikatów lub gdy duplikaty są istotne. Działa lepiej, ponieważ pomija krok deduplikacji.
W narzędziu PySpark użyj polecenia union() do łączenia ramek danych. Należy pamiętać, że union() w PySpark działa tak samo jak UNION ALL — zachowuje duplikaty.
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Znajdowanie typowych wierszy za pomocą funkcji INTERSECT
INTERSECT Zwraca tylko wiersze wyświetlane w obu zapytaniach. Pomaga to zidentyfikować nakładające się dane:
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
To zapytanie identyfikuje klientów, którzy w jakiś sposób pojawiają się w obu tabelach — przydatne w przypadku kontroli jakości danych lub identyfikowania rekordów wymagających uzgodnień.
Wyklucz wiersze za pomocą EXCEPT
EXCEPT Zwraca wiersze z pierwszego zapytania, które nie istnieją w drugim. Pomaga to zidentyfikować luki lub unikatowe rekordy:
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
Można również użyć MINUS jako synonimu dla EXCEPTelementu :
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Podobnie jak UNION, zarówno INTERSECT, jak i EXCEPT usuwają duplikaty domyślnie. Dodaj ALL , aby zachować duplikaty w razie potrzeby.
Wskazówka
Podczas tworzenia łańcuchów operacji zestawu należy pamiętać, że INTERSECT ma wyższy priorytet niż UNION i EXCEPT. Użyj nawiasów, aby kontrolować kolejność oceny.
Wybieranie między sprzężeniami i operatorami zestawów
Wybór między łączeniami a operatorami zbioru zależy od celu transformacji. Sprzężenia łączą kolumny z powiązanych tabel w poziomie, podczas gdy operatory ustawiania łączą wiersze w pionie.
Użyj złączeń gdy musisz:
- Wzbogacanie rekordów przez dodawanie kolumn z powiązanych tabel
- Dopasowywanie rekordów na podstawie relacji kluczy
- Filtrowanie danych na podstawie istnienia w innej tabeli (pół-sprzężenia/anty-sprzężenia)
Użyj operatorów zestawu gdy musisz:
- Dołączanie rekordów z wielu źródeł z identycznymi schematami
- Znajdowanie typowych rekordów w zestawach danych
- Identyfikowanie rekordów unikatowych dla jednego zestawu danych
Oba podejścia stanowią podstawę skutecznych potoków przekształcania danych. W następnej jednostce dowiesz się, jak załadować przekształcone dane do tabel docelowych w Unity Catalog.