Ładowanie danych za pomocą scalania, wstawiania i dołączania
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Po przekształceniu i oczyszczeniu danych ostatnim krokiem w potoku jest załadowanie danych do tabel docelowych. Usługa Azure Databricks udostępnia trzy podstawowe strategie załadowania: dołączanie, zastępowanie i scalanie. Każda strategia obsługuje różne przypadki użycia i wybór odpowiedniego zależy od tego, jak dane źródłowe odnoszą się do istniejących rekordów.
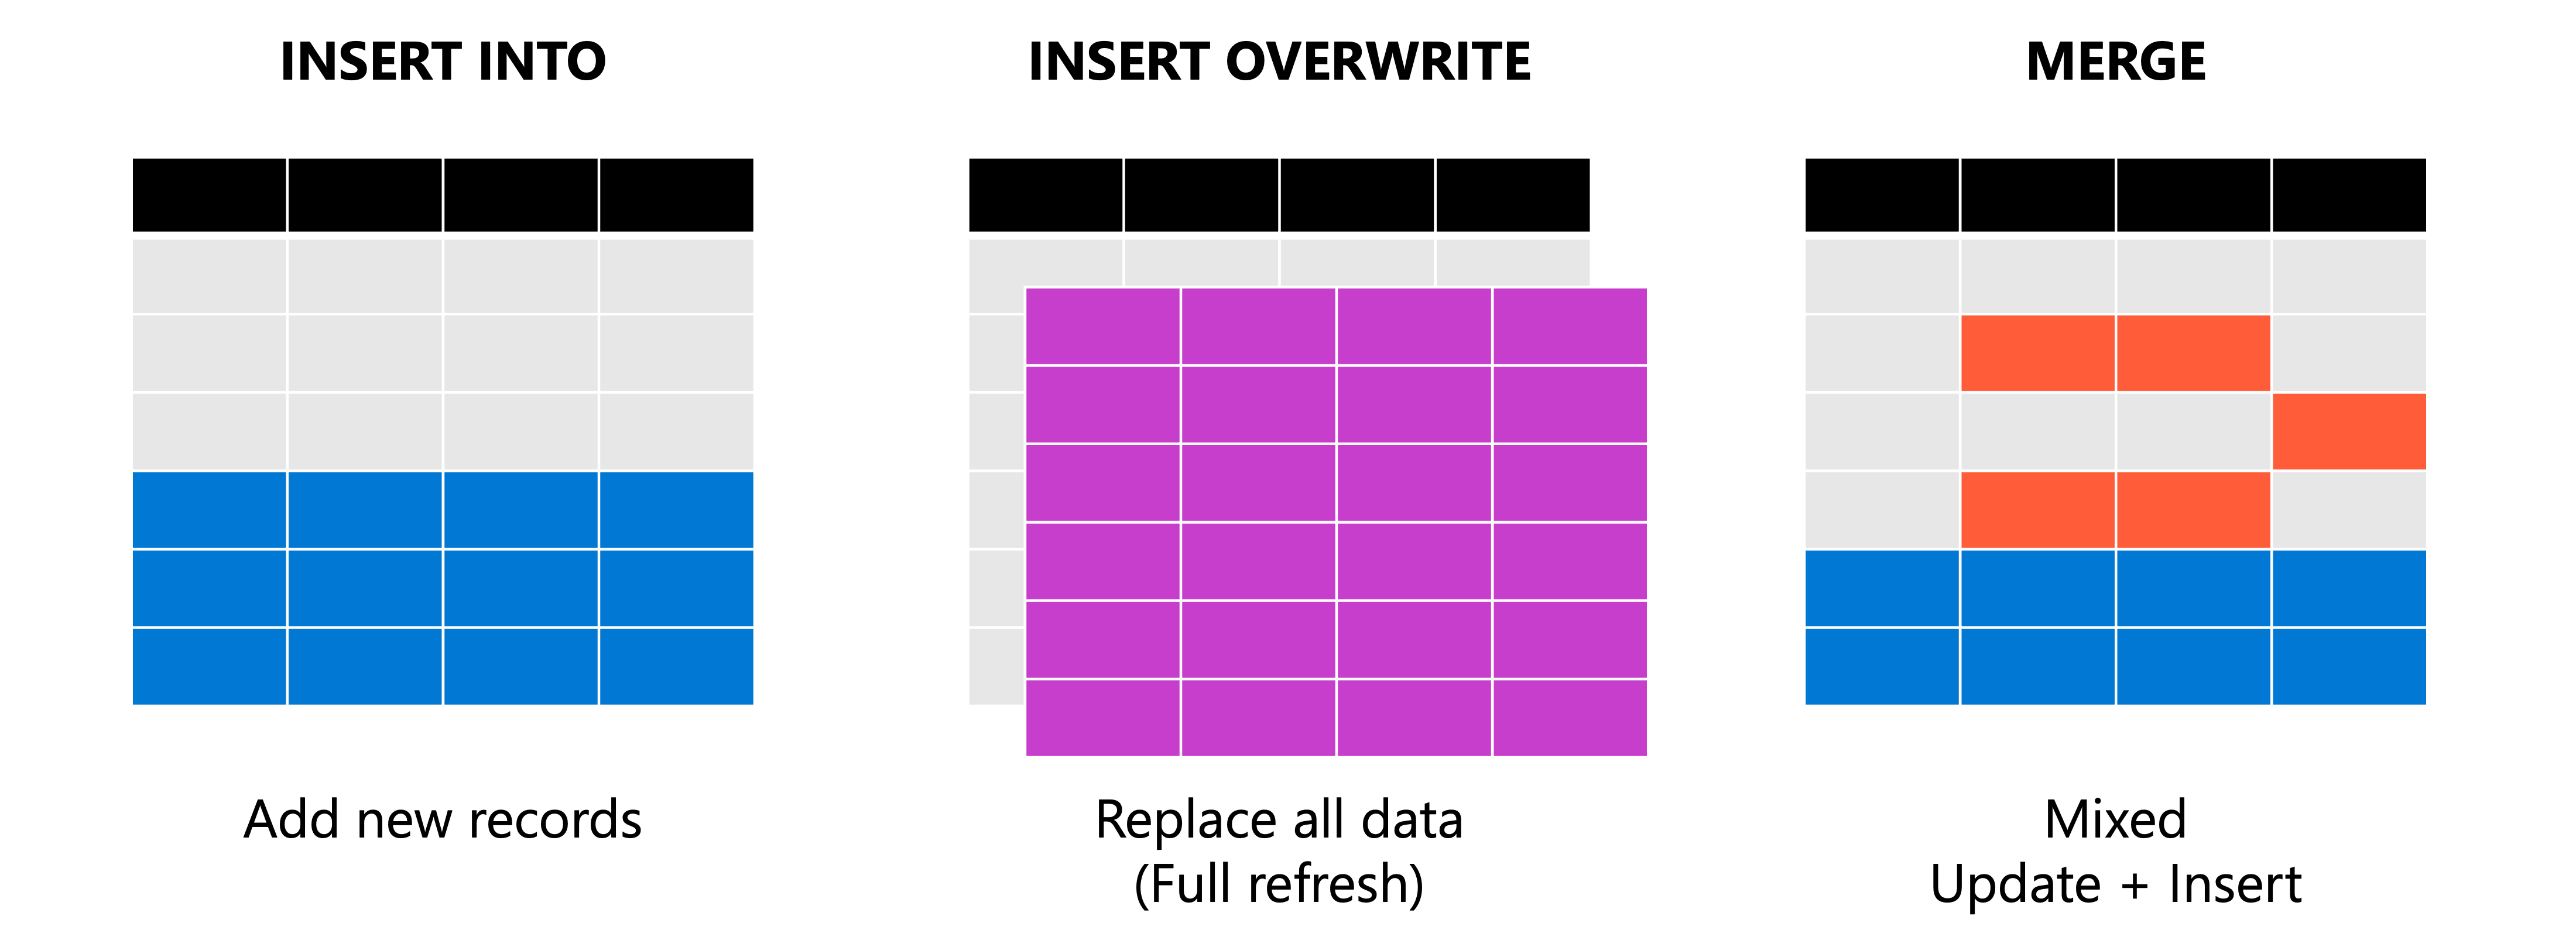
W tej lekcji dowiesz się, jak dołączać nowe wiersze za pomocą polecenia INSERT, zastępować dane, przepisując operacje, i synchronizować zmiany przy użyciu polecenia MERGE w scenariuszach upsert.
Dołączanie danych za pomocą funkcji INSERT INTO
Najprostsza operacja ładowania dodaje nowe wiersze do istniejącej tabeli bez modyfikowania bieżących danych. Użyj funkcji INSERT INTO, gdy ładujesz nowe partie danych, które nie nakładają się na istniejące rekordy — takie jak codzienne dzienniki transakcji, nowe strumienie zdarzeń lub przyrostowe wyodrębniania danych.
FUNKCJA INSERT INTO współpracuje zarówno z językiem SQL, jak i rozwiązaniem PySpark. W poniższych przykładach pokazano, jak dodać wiersze do tabeli sprzedaży.
-- Append new records using VALUES
INSERT INTO sales.transactions (transaction_id, amount, transaction_date)
VALUES
    ('TXN001', 150.00, '2026-01-15'),
    ('TXN002', 275.50, '2026-01-15');

-- Append from a staging table or query
INSERT INTO sales.transactions
SELECT * FROM staging.daily_transactions
WHERE transaction_date = current_date();
W programie PySpark dołączasz dane, zapisując ramkę danych w append trybie:
# Append DataFrame to existing table
df_new_transactions.write.mode("append").saveAsTable("sales.transactions")

# Or use insertInto for existing tables
df_new_transactions.write.insertInto("sales.transactions")
Wskazówka
Podczas dołączania danych upewnij się, że dane źródłowe są deduplikowane przed załadowaniem. Funkcja INSERT INTO nie sprawdza duplikatów — jeśli ładujesz tę samą partię dwukrotnie, otrzymujesz zduplikowane wiersze.
Zastąp dane za pomocą polecenia INSERT OVERWRITE
Czasami trzeba zastąpić istniejące dane, a nie dodać do niego. INSERT OVERWRITE obcina tabelę docelową lub partycję przed wstawieniem nowych wierszy. Takie podejście dobrze sprawdza się w przypadku ponownego przetwarzania nieudanych partii, odświeżania tabel odnośników lub ponownego kompilowania agregacji.
-- Replace entire table contents
INSERT OVERWRITE sales.daily_summary
SELECT
    region,
    SUM(amount) as total_sales,
    COUNT(*) as transaction_count
FROM sales.transactions
WHERE transaction_date = current_date()
GROUP BY region;
W przypadku tabel podzielonych na partycje można zastąpić określone partycje, pozostawiając inne bez zmian:
-- Replace only January 2026 partition
INSERT OVERWRITE sales.monthly_report
PARTITION (report_month = '2026-01')
SELECT region, product_category, SUM(amount) as revenue
FROM sales.transactions
WHERE transaction_date BETWEEN '2026-01-01' AND '2026-01-31'
GROUP BY region, product_category;
Delta Lake obsługuje również selektywne nadpisywanie za pomocą klauzuli REPLACE WHERE, która usuwa wiersze pasujące do warunku przed wstawieniem.
-- Replace transactions for a specific date range
INSERT INTO sales.transactions
REPLACE WHERE transaction_date >= '2026-01-01' AND transaction_date <= '2026-01-07'
SELECT * FROM staging.corrected_transactions;
Domyślnie każdy wiersz zwracany przez zapytanie musi być zgodny z predykatem REPLACE WHERE . Jeśli jakikolwiek wiersz nie spełnia predykatu, instrukcja kończy się niepowodzeniem i nic nie zapisuje.
W programie PySpark użyj trybu overwrite do pełnej zamiany tabeli i dodaj opcję replaceWhere, aby zastąpić tylko wiersze zgodne z warunkiem:
# Overwrite entire table
df_refreshed.write.mode("overwrite").saveAsTable("sales.daily_summary")

# Replace only the January 2026 rows
(df_january.write
    .mode("overwrite")
    .option("replaceWhere", "report_month = '2026-01'")
    .saveAsTable("sales.monthly_report"))
Ważne
Składnia SQL INSERT OVERWRITE PARTITION połączona z partitionOverwriteMode=dynamic jest ograniczona tylko do klasycznych obliczeń — nie działa w magazynach SQL usługi Databricks ani w bezserwerowych obliczeniach. Zapisy DataFrame w Pythonie i Scali przy użyciu partitionOverwriteMode=dynamic działają na wszystkich typach obliczeniowych. W przypadku nowych potoków usługa Databricks zaleca REPLACE USING zastąpienie partycji, ponieważ zastępowanie partycji może używać nieaktualnych danych podczas partycjonowania zmian.
Dynamiczne zastępowanie danych za pomocą funkcji REPLACE USING
REPLACE USING jest zalecanym podejściem do nadpisywania dynamicznych danych. Działa ona we wszystkich typach obliczeniowych— w tym w magazynach SQL usługi Databricks i bezserwerowych obliczeniach — i nie wymaga konfiguracji sesji platformy Spark. W przeciwieństwie do partitionOverwriteModeprogramu REPLACE USING obsługuje tabele partycjonowane, tabele niepartycyjne i tabele z klastrowaniem płynnym.
-- Replace only the partitions touched by the incoming data
INSERT INTO sales.monthly_report
  REPLACE USING (report_month)
  SELECT region, product_category, SUM(amount) AS revenue, report_month
  FROM staging.corrected_transactions
  GROUP BY region, product_category, report_month;
Klauzula REPLACE USING niepodzielnie usuwa wiersze w sales.monthly_report, które pasują do przychodzących wierszy na report_month, a następnie wstawia nowe wiersze. Wiersze, które nie są zgodne z określonymi kolumnami, pozostają niezmienione. W środowisku Databricks Runtime 16.3–17.1 USING kolumny muszą stanowić pełny zestaw kolumn partycji tabeli (zachowanie starszej wersji). W środowisku Databricks Runtime 17.2 lub nowszym obsługiwane są wszystkie kolumny dowolnego typu tabeli, w tym niepartycjonowane tabele i tabele z klastrowaniem płynnym. Klauzula SQL REPLACE USING wymaga środowiska Databricks Runtime 16.3 lub nowszego, a opcja Python i scala replaceUsing wymaga środowiska Databricks Runtime 18.2 lub nowszego. Ponieważ REPLACE USING używa zwykłego porównania równości, wiersze z wartościami NULL w kolumnach USING nie pasują do siebie i nie są usuwane z tabeli docelowej.
Jeśli potrzebujesz bardziej elastycznego dopasowywania — takiego jak zastępowanie wierszy na podstawie warunku niestandardowego lub traktowanie wartości NULL jako równych — użyj REPLACE ON zamiast tego:
-- Replace rows matching a user-defined condition across source and target
INSERT INTO sales.transactions AS target
  REPLACE ON (target.transaction_id = source.transaction_id)
  (SELECT * FROM staging.corrected_transactions) AS source;
REPLACE ON wymaga środowiska Databricks Runtime 17.1 lub nowszego dla SQL oraz środowiska Databricks Runtime 18.2 lub nowszego dla opcji Python i Scala replaceOn. Użyj REPLACE WHERE (omówionego wcześniej) w przypadku potrzeby zastąpienia opartego na warunku bez odwołania do tabeli źródłowej.
Scalanie danych dla operacji upsert
Potoki danych w świecie rzeczywistym często muszą podczas wstawiania nowych aktualizować istniejące rekordy. Instrukcja MERGE obsługuje ten wzorzec — często nazywany "upsert" — przez dopasowywanie wierszy źródłowych do wierszy docelowych i stosowanie różnych akcji na podstawie tego, czy istnieje dopasowanie.
Funkcja MERGE jest niezbędna do powoli zmieniających się wymiarów, synchronizowania danych z systemów źródłowych i przetwarzania strumieni przechwytywania zmian danych (CDC).
MERGE INTO customers AS target
USING customer_updates AS source
ON target.customer_id = source.customer_id
WHEN MATCHED THEN
    UPDATE SET
        target.email = source.email,
        target.phone = source.phone,
        target.last_updated = current_timestamp()
WHEN NOT MATCHED THEN
    INSERT (customer_id, name, email, phone, created_date, last_updated)
    VALUES (source.customer_id, source.name, source.email, source.phone,
            current_timestamp(), current_timestamp());
To zapytanie aktualizuje pocztę e-mail i telefon dla istniejących klientów podczas wstawiania całkowicie nowych rekordów klientów. Klauzula ON definiuje pasujący klucz — zazwyczaj klucz podstawowy lub identyfikator biznesowy.
Scalanie z logiką warunkową
Dodaj warunki do klauzul WHEN, aby obsługiwać bardziej złożone scenariusze. Na przykład można aktualizować tylko rekordy, które rzeczywiście uległy zmianie:
MERGE INTO products AS target
USING product_feed AS source
ON target.sku = source.sku
WHEN MATCHED AND source.price <> target.price THEN
    UPDATE SET target.price = source.price, target.updated_at = current_timestamp()
WHEN MATCHED AND source.discontinued = true THEN
    DELETE
WHEN NOT MATCHED THEN
    INSERT *;
Składnia INSERT * wstawia wszystkie kolumny ze źródła, gdy są zgodne ze schematem docelowym.
Scalanie z rozwiązaniem PySpark
Aby kontrolować programowo, użyj interfejsu API języka Python usługi Delta Lake:
from delta.tables import DeltaTable

target_table = DeltaTable.forName(spark, "customers")

target_table.alias("target").merge(
    source_df.alias("source"),
    "target.customer_id = source.customer_id"
).whenMatchedUpdate(set={
    "email": "source.email",
    "phone": "source.phone",
    "last_updated": "current_timestamp()"
}).whenNotMatchedInsert(values={
    "customer_id": "source.customer_id",
    "name": "source.name",
    "email": "source.email",
    "phone": "source.phone",
    "created_date": "current_timestamp()",
    "last_updated": "current_timestamp()"
}).execute()
W przypadku prostszych przypadków, w których są zgodne schematy źródłowe i docelowe, użyj metod wygody:
target_table.alias("target").merge(
    source_df.alias("source"),
    "target.customer_id = source.customer_id"
).whenMatchedUpdateAll(
).whenNotMatchedInsertAll(
).execute()
Wybieranie właściwej strategii ładowania
Wybór operacji ładowania zależy od relacji między danymi źródłowymi i docelowymi:
| Scenario | Operation | Kiedy należy używać |
|---|---|---|
| Tylko nowe rekordy | INSERT INTO / dołącz | Dzienniki, strumienie zdarzeń, wyciągi przyrostowe |
| Pełne odświeżanie | WSTAW ZASTĘPOWANIE | Tablice wyszukiwania, agregacje, ponowne przetwarzanie wsadowe się nie powiodło |
| Mieszane aktualizacje i wstawki | POŁĄCZYĆ | Źródła danych CDC, tabele wymiarów, synchronizacja danych |
| Selektywne zastępowanie przez predykat | ZAMIEŃ GDZIE | Poprawianie określonych zakresów dat lub warunków logicznych |
| Nadpisywanie danych dynamicznych (wszystkie typy obliczeniowe) | ZAMIEŃ PRZY UŻYCIU | Zalecane w przypadku zastępowania na poziomie wiersza dla dowolnego typu tabeli (partycjonowane, niepartycyjne, płynne klastrowanie) |
| Zamiana wiersza niestandardowego warunku | Funkcja zamiany włączona | Nadpisywanie na poziomie wiersza z warunkami zgodności bezpiecznymi dla NULL lub złożonymi warunkami dopasowania |
Ważne
Operacje MERGE kończą się niepowodzeniem, jeśli więcej niż jeden wiersz źródłowy jest zgodny z tym samym wierszem docelowym, ponieważ nie jest jasne, który wiersz źródłowy ma być stosowany. Bezwarunkowe DELETE akcje są wyjątkiem. Deduplikuj dane źródłowe przed scaleniem.
Zrozumienie tych wzorców ładowania przygotowuje Cię do tworzenia niezawodnych potoków danych, które utrzymują integralność danych, jednocześnie efektywnie przetwarzając zarówno nowe, jak i zmienione rekordy.