Wybieranie formatu tabeli danych
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Inżynierowie danych muszą podjąć kluczową decyzję na wczesnym etapie każdego potoku danych: który format tabeli powinien przechowywać dane? Ten wybór ma wpływ na wydajność zapytań, niezawodność transakcji, współdziałanie z innymi platformami i długoterminową konserwację architektury typu lakehouse.
Usługa Azure Databricks obsługuje wiele formatów przechowywania, z których każdy jest przeznaczony dla różnych scenariuszy. Zrozumienie ich różnic pomaga wybrać odpowiedni format dla określonych wymagań.
Informacje o formatach plików a formatach tabel
Przed porównaniem opcji należy rozróżnić formaty plików i formaty tabel. Format pliku, taki jak Parquet, CSV lub JSON, definiuje sposób przechowywania danych fizycznie na dysku. Format tabeli, taki jak Delta Lake lub Apache Iceberg, jest oparty na formatach plików, dodając warstwę metadanych, która śledzi transakcje, zmiany schematu i lokalizacje plików danych.
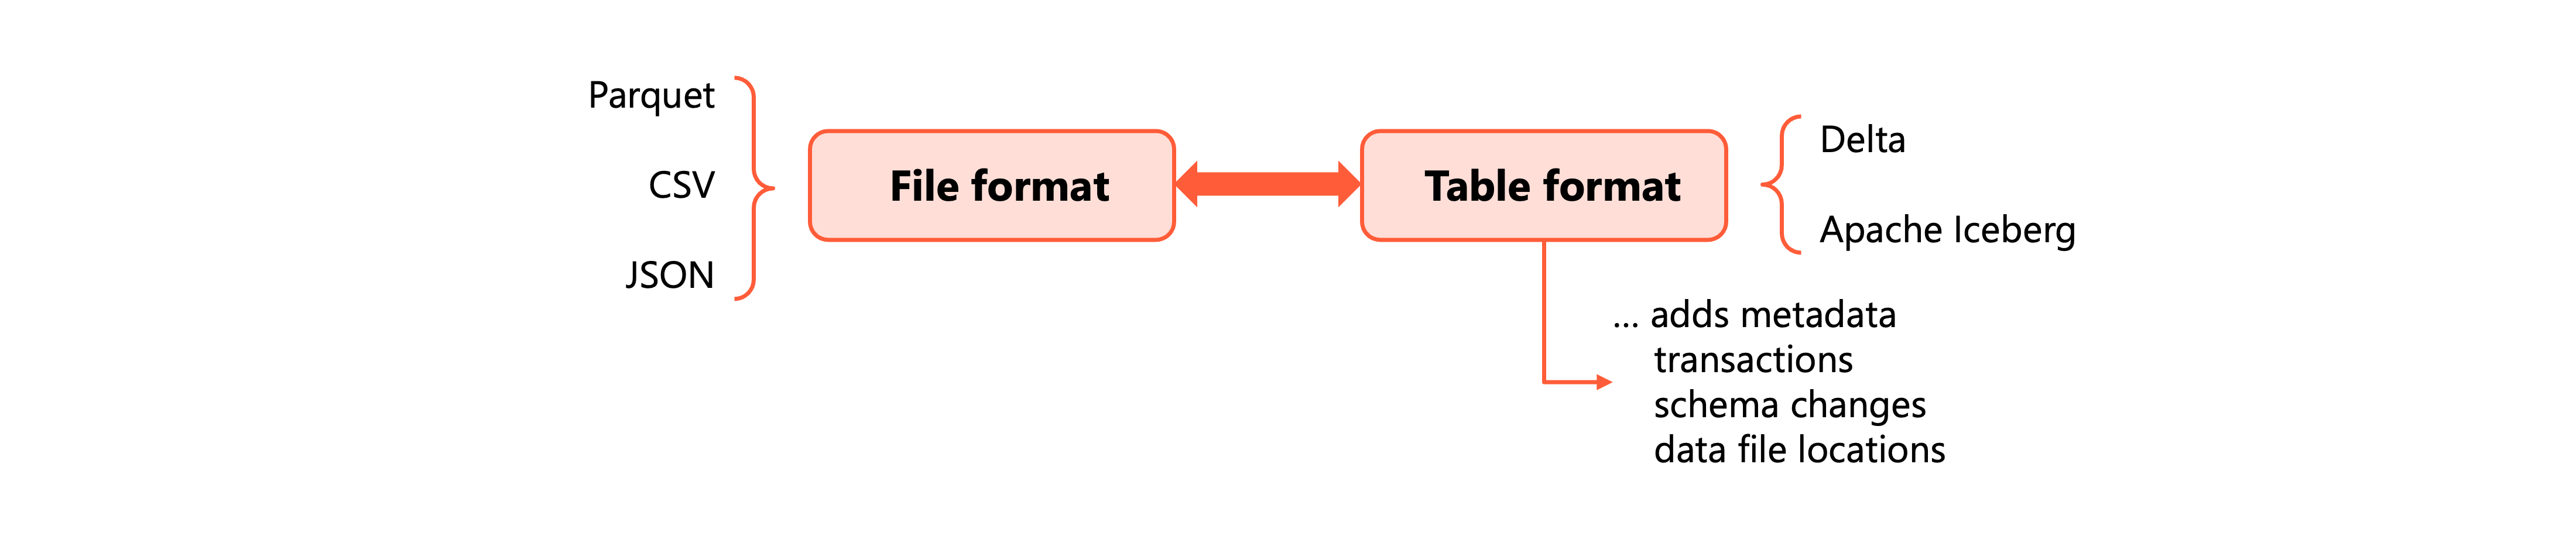
Zarówno Delta Lake, jak i Apache Iceberg używają Parquet jako podstawowego formatu pliku. Kluczową różnicą jest warstwa metadanych, która umożliwia zaawansowane funkcje, takie jak transakcje ACID, podróż w czasie i ewolucja schematu.
Sposób, w jaki Parquet przechowuje dane inaczej
Parquet używa przechowywania kolumnowego zamiast przechowywania wierszowego. Ta podstawowa różnica znacząco wpływa na wydajność zapytań analitycznych.
W formatach opartych na wierszach, takich jak CSV, dane są uporządkowane według rekordu. Odczytywanie pojedynczej kolumny wymaga skanowania każdego wiersza w pliku. W formatach kolumnowych, takich jak Parquet, dane dla każdej kolumny są przechowywane razem. Gdy zapytanie wymaga tylko określonych kolumn, Parquet odczytuje tylko te kolumny i całkowicie pomija resztę.
Parquet organizuje dane w grupy wierszy, z których każda zawiera fragmenty kolumn. Każdy fragment kolumny przechowuje statystyki, w tym minimalne i maksymalne wartości dla tego segmentu danych. Podczas wykonywania zapytania z warunkiem filtru aparat zapytań najpierw sprawdza te statystyki. Jeśli wartość filtru wykracza poza zakres min/maksymalny grupy wierszy, aparat pomija odczytywanie całej sekcji.
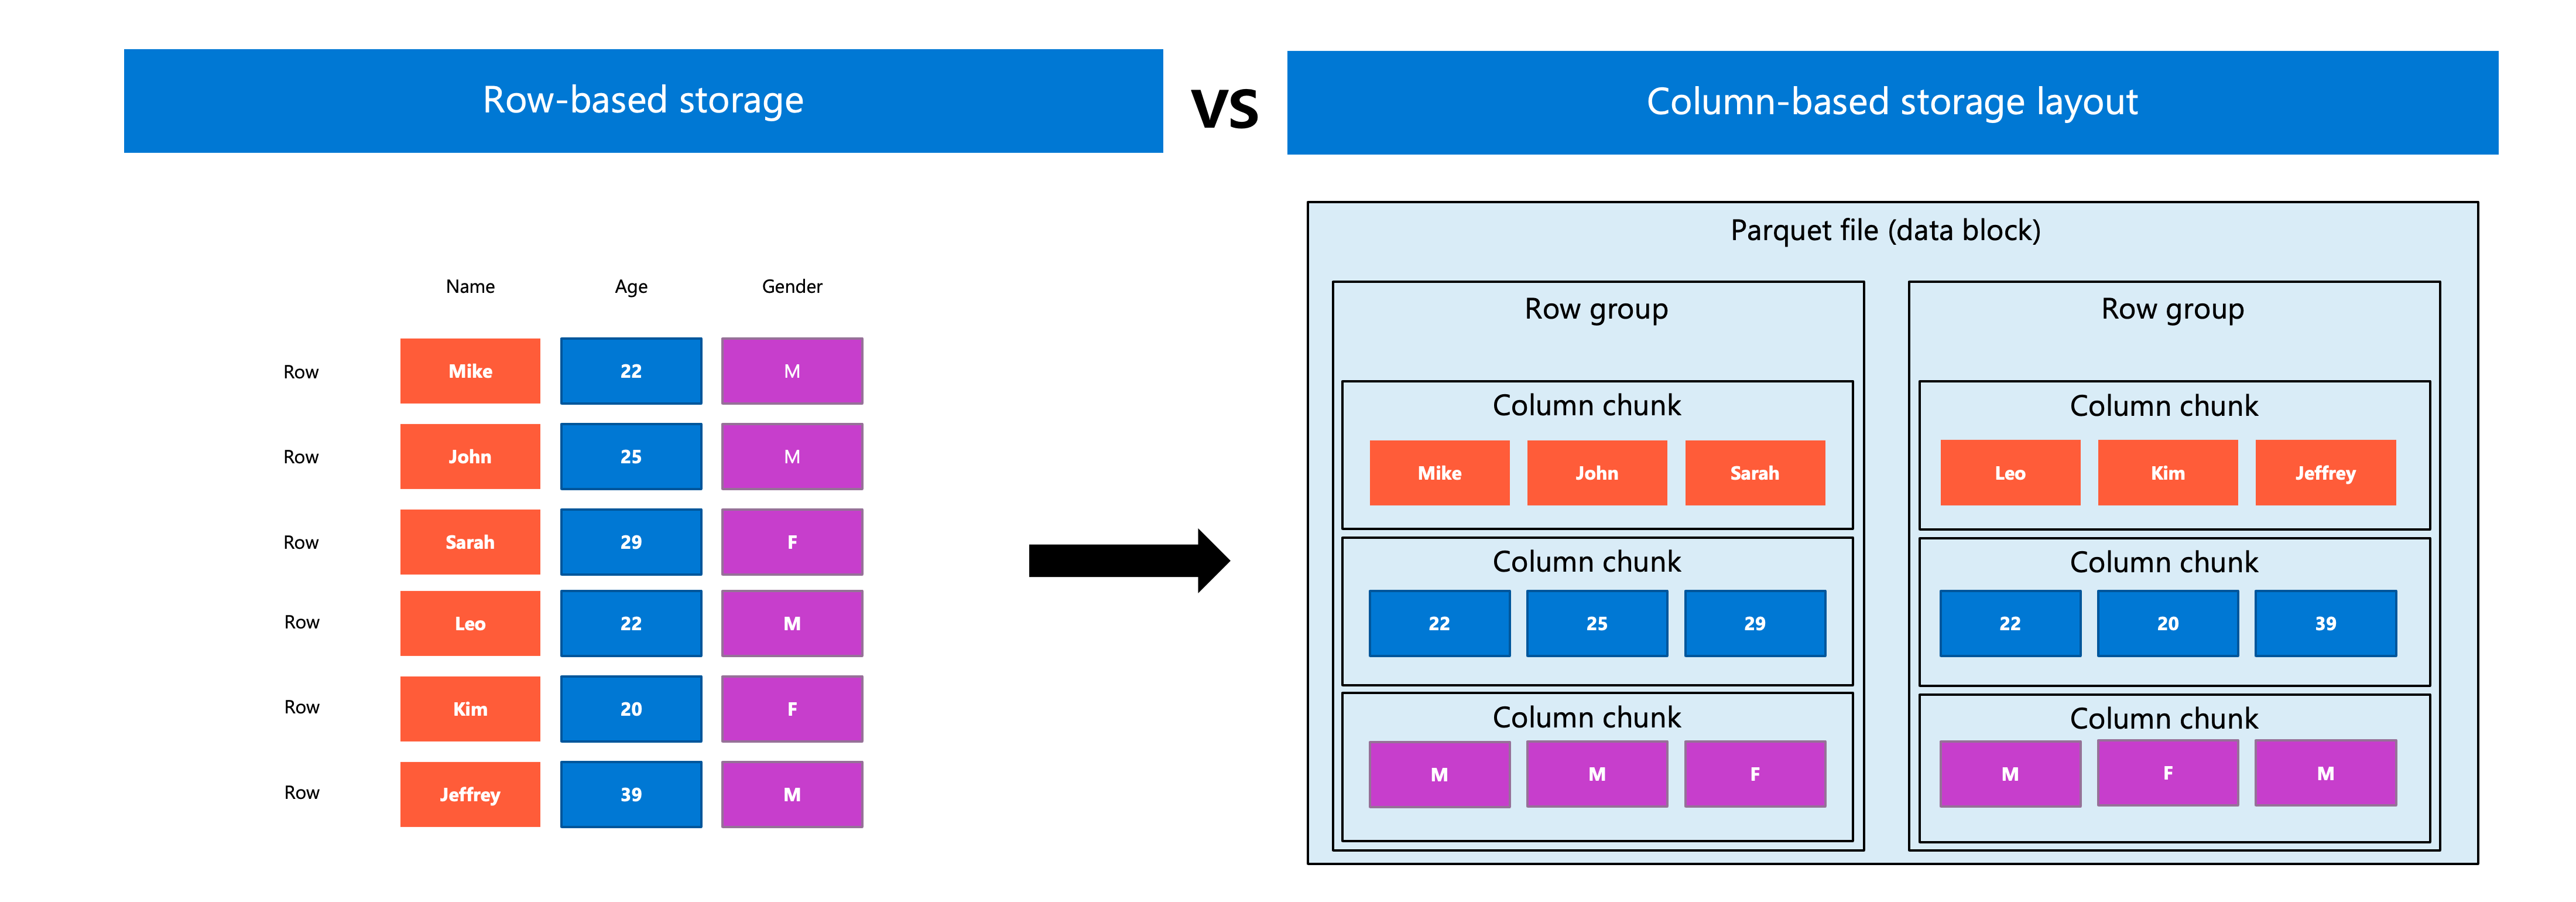
To podejście kolumnowe zapewnia dwie techniki optymalizacji, które znacznie zwiększają wydajność analizy:
- Oczyszczanie kolumn: aparat odczytuje tylko kolumny, do których odwołuje się zapytanie, co znacznie zmniejsza liczbę operacji we/wy.
- Predicate pushdown: warunki filtrowania są weryfikowane na podstawie statystyk kolumn przed odczytem danych, całkowicie pomijając nieistotne grupy wierszy.
W przypadku obciążeń analitycznych, które zazwyczaj uzyskują dostęp do podzbioru kolumn w wielu wierszach, Parquet znacznie przewyższa formaty oparte na wierszach.
Usługa Delta Lake jako format domyślny
Usługa Delta Lake jest domyślnym formatem magazynu dla wszystkich tabel w usłudze Azure Databricks. Podczas tworzenia tabeli bez określania formatu usługa Azure Databricks automatycznie używa usługi Delta Lake.
Usługa Delta Lake rozszerza pliki Parquet przy użyciu dziennika transakcji , który rejestruje każdą zmianę w tabeli. Ten dziennik umożliwia wiele funkcji, których sam Parquet nie zapewnia.
Transakcje ACID: Wiele równoczesnych procesów odczytujących i zapisujących może uzyskać dostęp do tego samego obiektu tabeli bez uszkodzenia danych. Każda transakcja kończy się całkowicie lub nie ma wpływu.
Podróż w czasie: wykonaj zapytanie względem poprzednich wersji tabeli przy użyciu sygnatur czasowych lub numerów wersji. W razie potrzeby wycofaj zmiany.
Wymuszanie schematu i ewolucja: tabela weryfikuje dane przychodzące względem zdefiniowanego schematu, zapobiegając wprowadzaniu uszkodzonych lub niezgodnych danych do lakehouse. W przypadku zmiany wymagań można dodawać nowe kolumny, modyfikować typy danych lub zmieniać nazwy kolumn bez ponownego zapisywania istniejących danych.
Ujednolicone przetwarzanie wsadowe i przesyłanie strumieniowe: używaj tej samej tabeli jako źródła do przetwarzania wsadowego oraz jako źródła lub ujścia przesyłania strumieniowego.
Usługa Delta Lake integruje się głęboko z platformą Azure Databricks. Funkcje jak klastrowanie cieczy i optymalizacja predykcyjna są dostępne zarówno dla tabel Delta Lake, jak i zarządzanych tabel Apache Iceberg w katalogu Unity. Zmiana strumienia danych jest jednak specyficzna dla usługi Delta Lake i opiera się na dzienniku transakcji.
W przypadku większości scenariuszy w usłudze Azure Databricks usługa Delta Lake jest zalecanym wyborem. Zapewnia ona korzyści wydajnościowe formatu Parquet z transakcyjnymi gwarancjami, których wymagają systemy danych w środowisku produkcyjnym.
Apache Iceberg dla scenariuszy międzyplatformowych
Apache Iceberg to alternatywny format otwartej tabeli, który usługa Azure Databricks obsługuje dla tabel zarządzanych i obcych. Podobnie jak usługa Delta Lake, Iceberg zapewnia transakcje ACID, ewolucję schematu i możliwości podróży w czasie oparte na plikach Parquet.
Hierarchiczna i dobrze zdefiniowana struktura logiczna góry lodowej sprawia, że jest wysoce elastyczna, obsługując skalowalność i zaawansowane optymalizacje. Obsługuje oczyszczanie manifestu, statystyki na poziomie plików, ukryte partycjonowanie i ewolucję partycji.
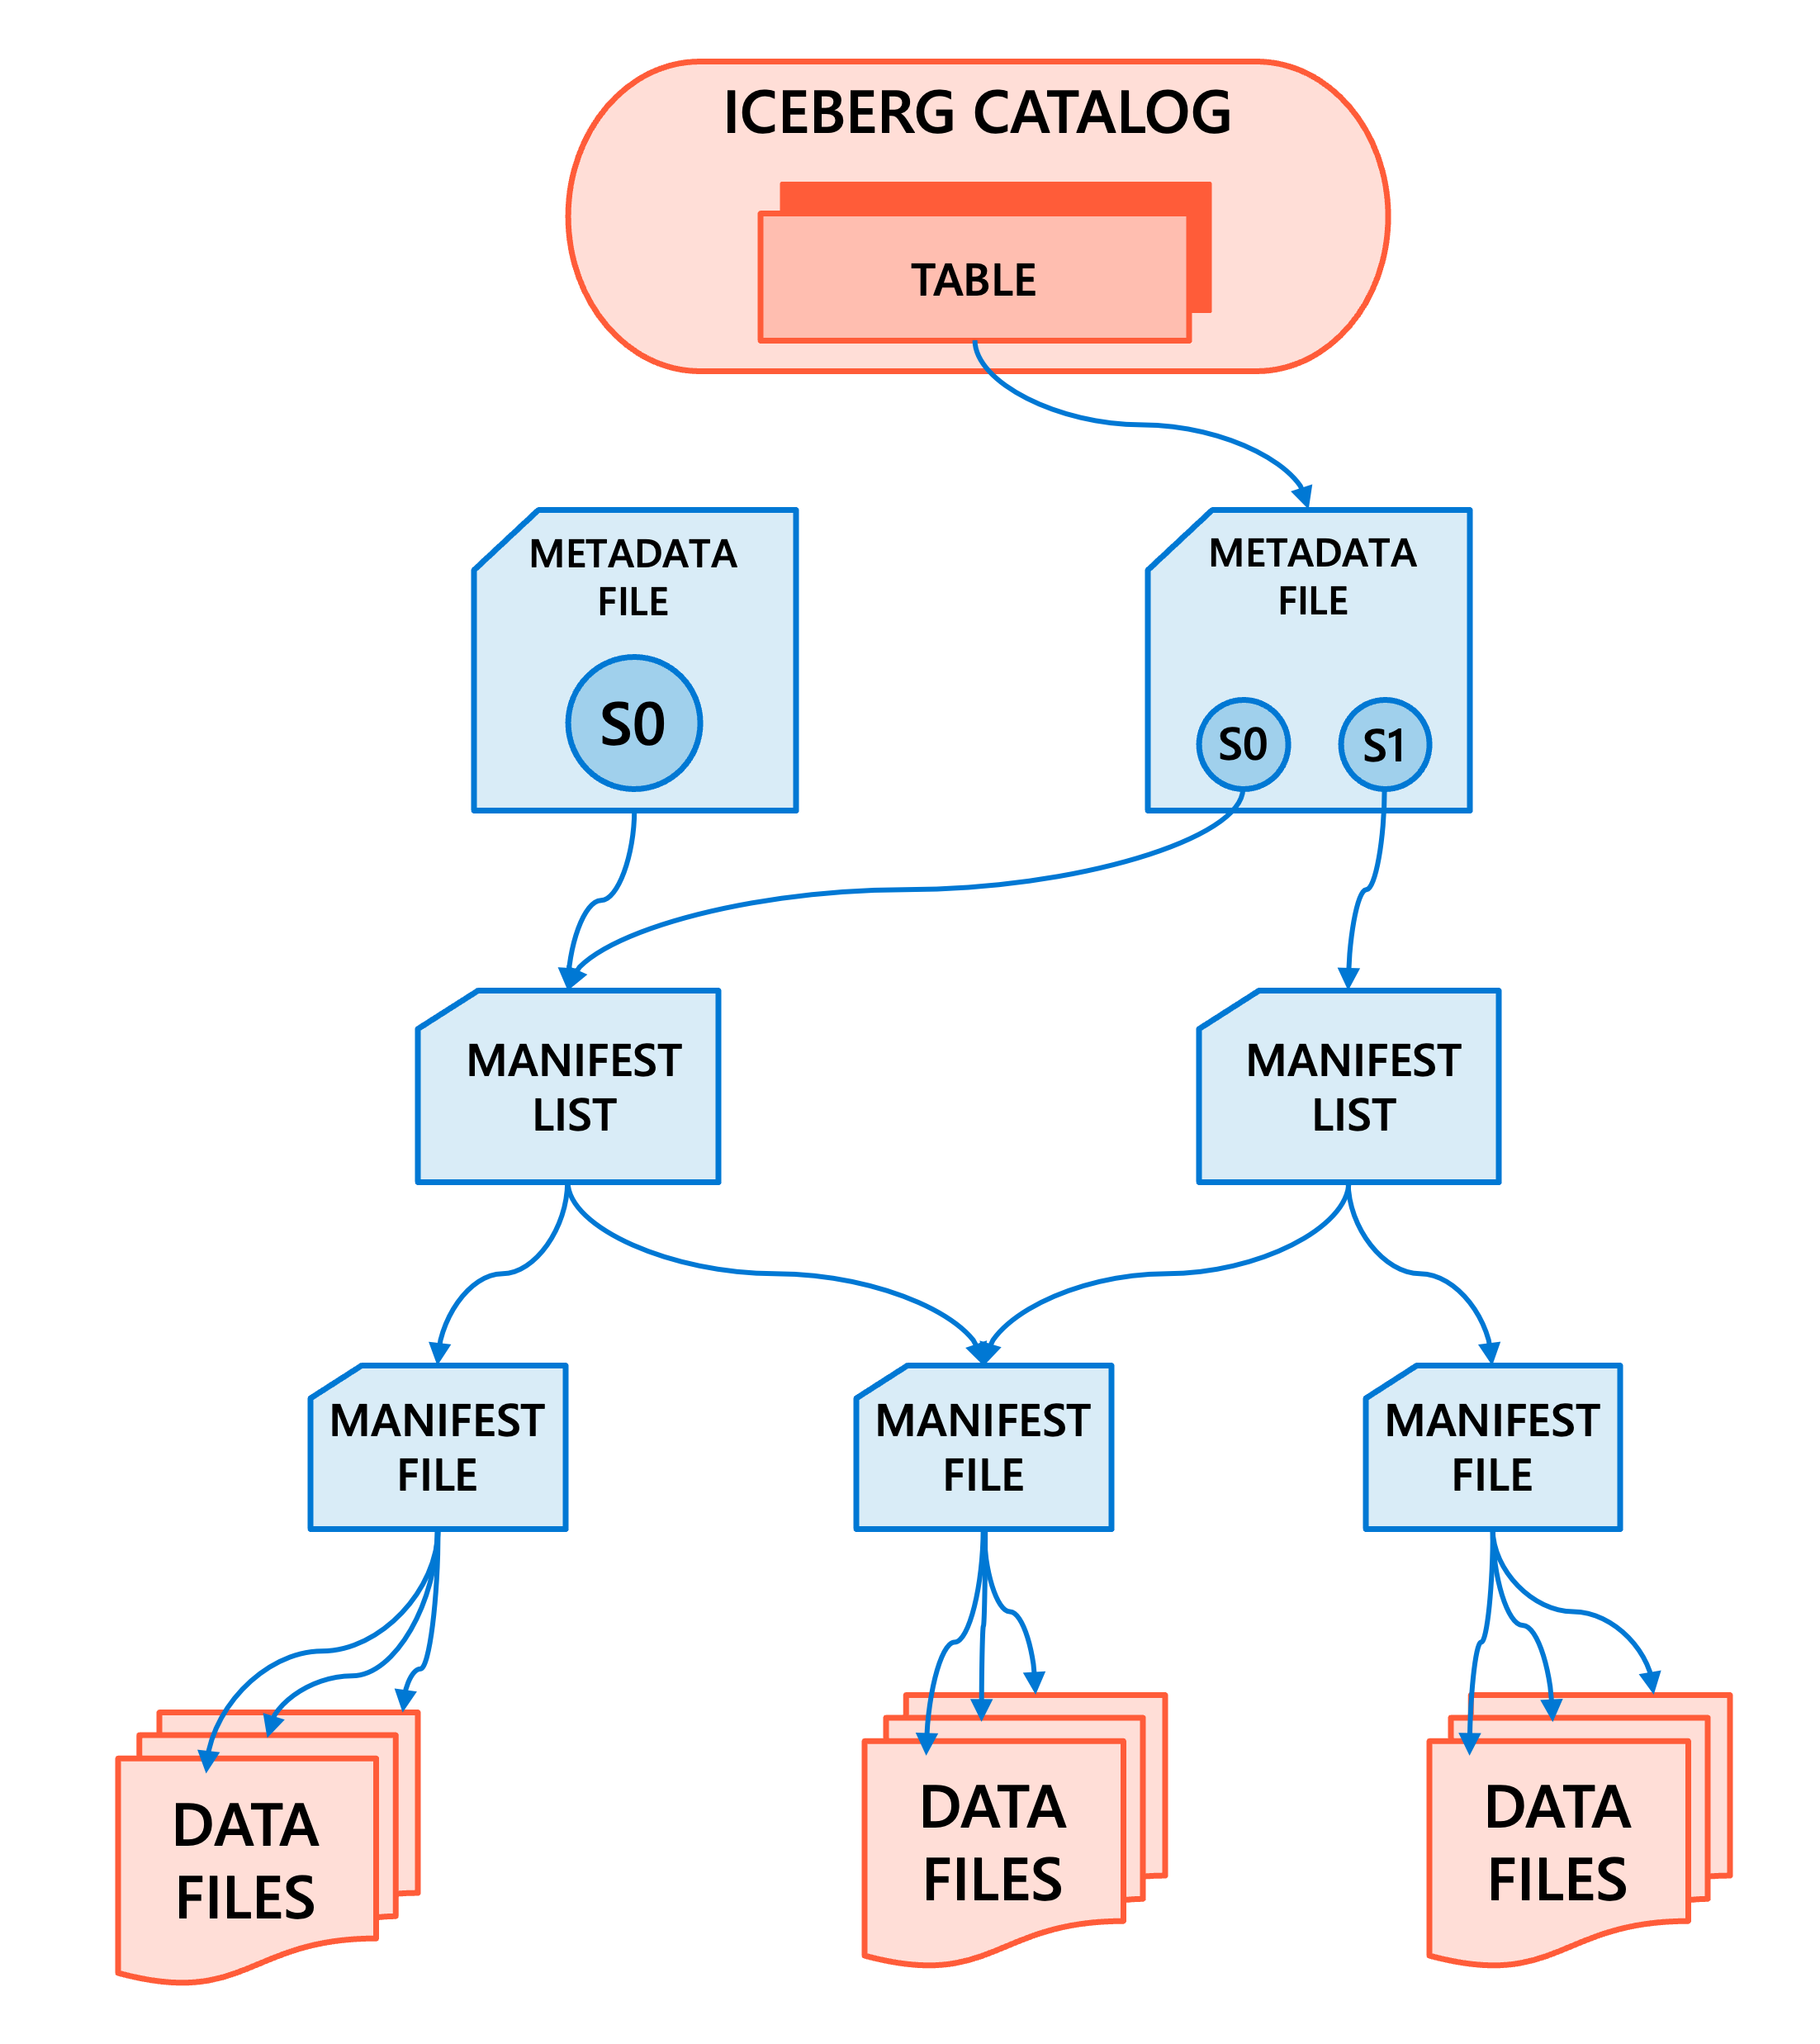
Głównym powodem wyboru Iceberg jest interoperacyjność. Iceberg jest powszechnie stosowany w ekosystemie danych, w tym na platformach takich jak Snowflake, Amazon Athena, Trino, Apache Spark i Apache Flink. Jeśli Organizacja uruchamia obciążenia na wielu platformach, które muszą odczytywać i zapisywać te same tabele, platforma Iceberg udostępnia wspólny format dla wszystkich platform.
Unity Catalog może bezpośrednio zarządzać tabelami Iceberg, co umożliwia usłudze Azure Databricks działanie jako katalog Iceberg dla silników zewnętrznych. Tabele Iceberg zarządzane przez inne katalogi, takie jak AWS Glue lub Snowflake Horizon Catalog, można również odczytywać przez połączenia z tabelami obcymi.
Rozważ górę lodową, gdy:
- Dane muszą być dostępne dla wielu aparatów przetwarzania poza usługą Azure Databricks.
- Twoja organizacja ustandaryzowała platformę Iceberg na potrzeby udostępniania danych międzyplatformowych.
- Integrujesz się z systemami, które nie obsługują usługi Delta Lake.
W przypadku obciążeń uruchamianych głównie w usłudze Azure Databricks usługa Delta Lake pozostaje zalecanym formatem ze względu na bardziej głębszą integrację i funkcje optymalizacji platformy.
Zastosowanie formatów opartych na wierszach
Pliki CSV i JSON pozostają prawidłowymi wyborami dla określonych scenariuszy, mimo że są one mniej wydajne w przypadku analizy na dużą skalę.
Użyj formatu CSV lub JSON, gdy:
- Dane z systemów zewnętrznych są odbierane w tych formatach jako początkowa strefa lądowania.
- Do debugowania lub szybkiej inspekcji potrzebne są dane czytelne dla człowieka.
- Integrujesz się z systemami, które obsługują tylko formaty tekstowe.
- Woluminy danych są na tyle małe, że różnice wydajności są niewielkie.
Do trwałego zapisywania danych analitycznych przekonwertuj przychodzące pliki CSV lub JSON na tabele Delta Lake podczas importu. Ta konwersja uzyskuje korzyści z wydajności magazynu kolumnowego, dodając jednocześnie gwarancje transakcyjne.
Stosowanie kryteriów decyzyjnych
Wybór formatu tabeli zależy od konkretnych wymagań. Zacznij od usługi Delta Lake jako domyślnego wyboru, a następnie oceń alternatywy tylko wtedy, gdy wymagają ich określone ograniczenia.
| Kwestie wymagające rozważenia | Jezioro Delta | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Wydajność analizy | Doskonałe | Doskonałe | Biedny |
| Transakcje ACID | Tak | Tak | Nie. |
| Podróż czasowa | Tak | Tak | Nie. |
| Integracja z usługą Azure Databricks | Głęboki | Wsparte | Basic |
| Zgodność międzyplatformowa | Rosnące | Szeroki | Universal |
| Zalecane do produkcji | Tak | Tak (jeśli wymagana jest interoperacyjność) | Brak (tylko strefa lądowania) |
Wybór zależy również od standardów organizacyjnych. Jeśli twój zespół architektury ustanowił konwencje dla formatów tabel, należy dostosować je do tych decyzji, aby zachować spójność na platformie danych.