Wybierz stopień szczegółowości dla kolumny lub tabeli na podstawie wymagań
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Stopień szczegółowości jest jednym z najważniejszych decyzji projektowych podejmowanych podczas tworzenia modelu danych. Definiuje poziom szczegółowości przechwyconych w tabelach i bezpośrednio wpływa na koszty magazynowania, wydajność zapytań i pytania analityczne, na które można odpowiedzieć. Jako inżynier danych zrozumienie stopnia szczegółowości ułatwia projektowanie tabel spełniających wymagania biznesowe przy zachowaniu wydajnych operacji.
W tej lekcji wyjaśniono, co oznacza stopień szczegółowości w kontekście modelowania wymiarowego i jak ocenić różne opcje szczegółowości na podstawie wymagań organizacji.
Zrozumieć, co reprezentuje szczegółowość
Stopień szczegółowości, czasami nazywany "ziarnem" , opisuje poziom szczegółowości reprezentowany przez każdy wiersz w tabeli. W tabeli faktów granularność określa, jakie zdarzenie biznesowe lub pomiary przechwytuje każdy wiersz. W tabeli wymiarów ziarno określa sposób, w jaki jednostki są przedstawiane i wersjonowane.
Rozważmy scenariusz danych czujnika IoT. Tabelę faktów można zaprojektować na różnych poziomach szczegółowości:
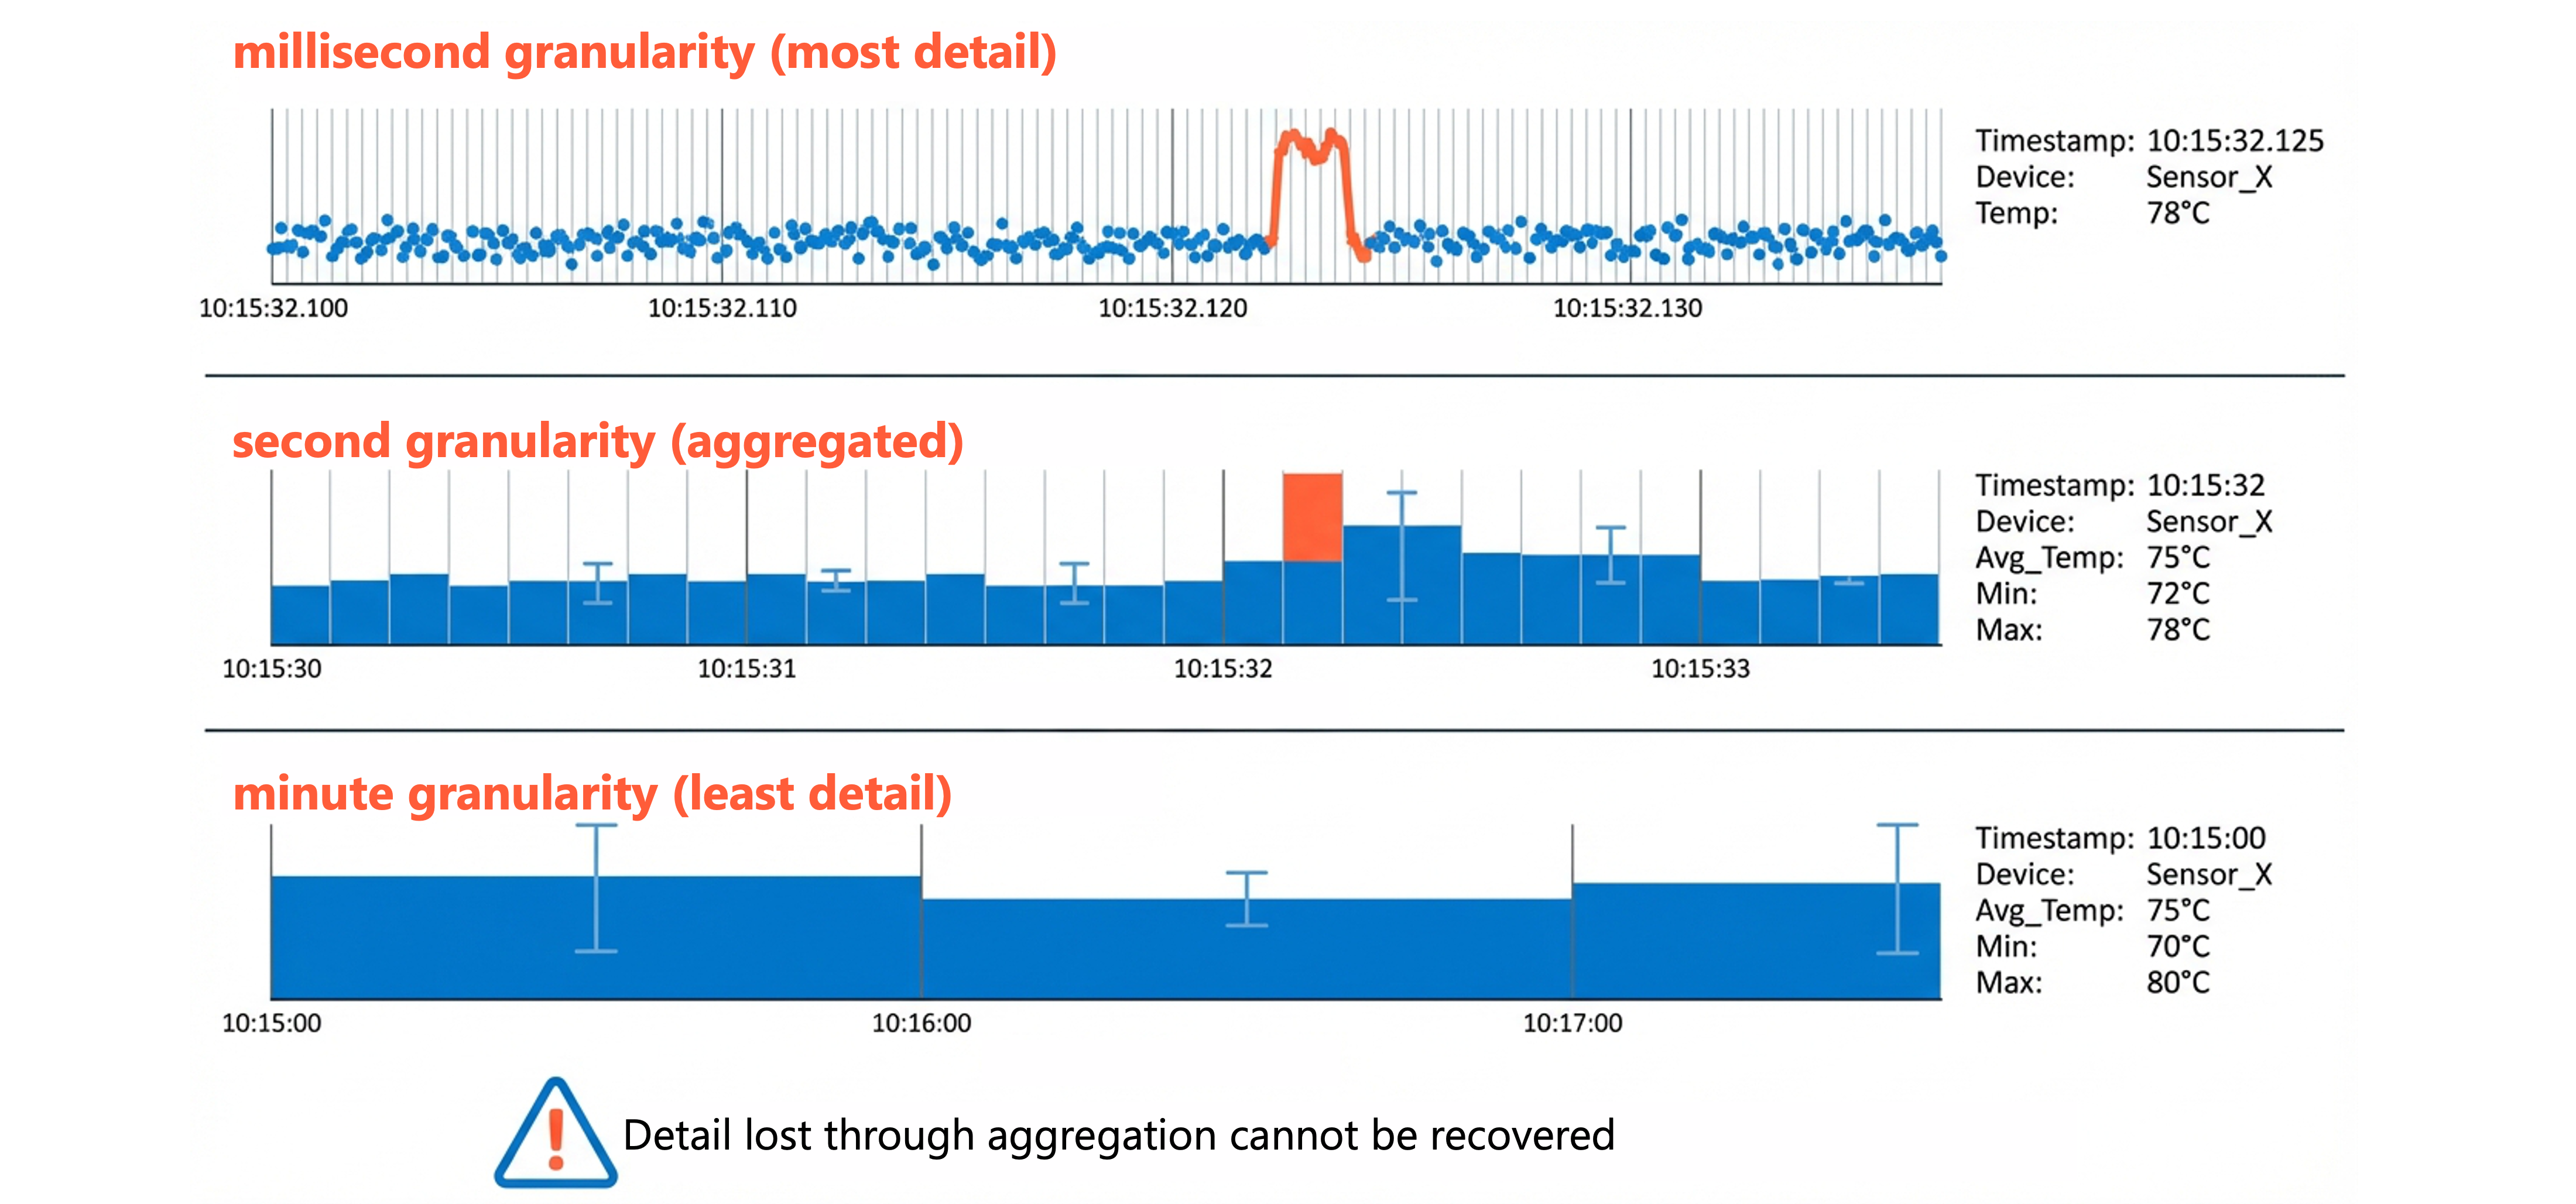
Stopień szczegółowości na poziomie milisekund: każdy wiersz reprezentuje pojedynczy odczyt czujnika przechwycony na poziomie milisekund. Przechwytuje to najbardziej szczegółowe informacje, w tym dokładne znaczniki czasu, wartości czujników i identyfikatory urządzeń dla każdego pomiaru.
Drugi zagregowany stopień szczegółowości: każdy wiersz reprezentuje średnią, minimalną lub maksymalną wartość czujnika dla urządzenia na sekundę. Poszczególne odczyty są podsumowane w statystykach na sekundę.
Zagregowany stopień szczegółowości minut: każdy wiersz reprezentuje zagregowane statystyki czujników dla urządzenia w ciągu całej minuty. Zapewnia to najmniejszą szczegółowość, ale wymaga najmniejszego miejsca do magazynowania.
Wybrane ziarno wpływa na wszystko podrzędne. Po utracie szczegółów za pomocą agregacjinie można go odzyskać. Jeśli tabela zagregowana minutowo pokazuje, że czujnik X miał średnią temperaturę 75°C w określonej minucie, nie można określić, które milisekundy miały skoki temperatury lub zidentyfikować dokładny moment wystąpienia anomalii.
Ocena czynników mających wpływ na decyzje dotyczące stopnia szczegółowości
Wybranie odpowiedniego stopnia szczegółowości wymaga zrównoważenia wielu konkurencyjnych problemów. Właściwy wybór zależy od konkretnego kontekstu biznesowego i ograniczeń technicznych.
Wymagania biznesowe napędzają ziarno
Pytania analityczne, na które organizacja musi odpowiedzieć, powinny być głównym czynnikiem określającym stopień szczegółowości. Zadaj sobie pytanie: jaki jest najbardziej szczegółowy poziom wymaganej analizy ?
Jeśli inżynierowie operacyjni muszą wykrywać anomalie sprzętu na poziomie milisekund, agregacje na minutę nie będą wystarczające. Jeśli zarząd potrzebuje jedynie podsumowań godzinowych dotyczących wykorzystania linii produkcyjnej, przechowywanie wszystkich odczytów czujników marnuje zasoby.
Rozważ następujące scenariusze:
| Wymagania biznesowe | Wymagana minimalna stopień szczegółowości |
|---|---|
| Wykrywanie anomalii drgań sprzętu w czasie rzeczywistym | Poziom zdarzeń na poziomie milisekund |
| Analizowanie trendów temperatury pod kątem konserwacji predykcyjnej | Drugi poziom agregacji |
| Monitorowanie godzinowego zużycia energii na urządzenie | Minutowy poziom agregacji |
| Raportowanie codziennych metryk produkcji według zakładu | Poziom agregacji godzinowej |
Wzorce zapytań kształtują wydajność
Sposób, w jaki użytkownicy wysyłają zapytania do danych, wpływa na optymalny stopień szczegółowości. Gdy zapytania zwykle filtrują i agregują do wyższych poziomów, przechowywanie nadmiernie precyzyjnych danych powoduje niepotrzebne obciążenie związane z przetwarzaniem. Każde zapytanie musi skanować i agregować więcej wierszy niż jest to konieczne.
Jednocześnie przechowywanie danych w zbyt grubym poziomie szczegółowości uniemożliwia użytkownikom przechodzenie do szczegółów w celu udzielenia odpowiedzi na szczegółowe pytania. Znalezienie równowagi wymaga zrozumienia zarówno bieżących, jak i przewidywanych wzorców zapytań.
Skumulowane koszty magazynowania i zasobów obliczeniowych
Dokładniejszy stopień szczegółowości oznacza więcej wierszy, co zwiększa koszty magazynowania. Zwiększa również koszty obliczeń , ponieważ zapytania muszą przetwarzać więcej danych. W usłudze Azure Databricks te koszty rosną z biegiem czasu, gdy gromadzą się dane historyczne.
Zakład produkcyjny z tysiącami czujników przechwytujących odczyty w milisekundach może generować miliardy wierszy dziennie z najlepszym stopniem szczegółowości. Agregowanie do statystyk na sekundę lub minutę może zmniejszyć liczbę wierszy o 99% lub więcej, co przekłada się bezpośrednio na obniżenie kosztów przechowywania i zapytań.
Wymagania dotyczące zgodności i inspekcji mają znaczenie
Wymogi regulacyjne czasami nakazują określone poziomy szczegółowości. Organizacje usług finansowych często muszą zachować szczegóły na poziomie transakcji na potrzeby inspekcji , niezależnie od kosztów magazynowania. Organizacje opieki zdrowotnej mogą wymagać śledzenia interakcji poszczególnych pacjentów ze względów zgodności.
Gdy zgodność wpływa na decyzję o szczegółowości, należy jasno udokumentować wymagania. Uzasadnienie to pomaga, gdy zainteresowane strony kwestionują, dlaczego przechowujesz więcej szczegółów aniżeli same potrzeby analityczne.
Stosowanie stopnia szczegółowości do tabel faktów
Tabele faktów korzystają najbardziej z starannych decyzji dotyczących szczegółowości, ponieważ zwykle zawierają one największe ilości danych. Ziarno tabeli faktów jest określane przez kombinację kluczy wymiarów.
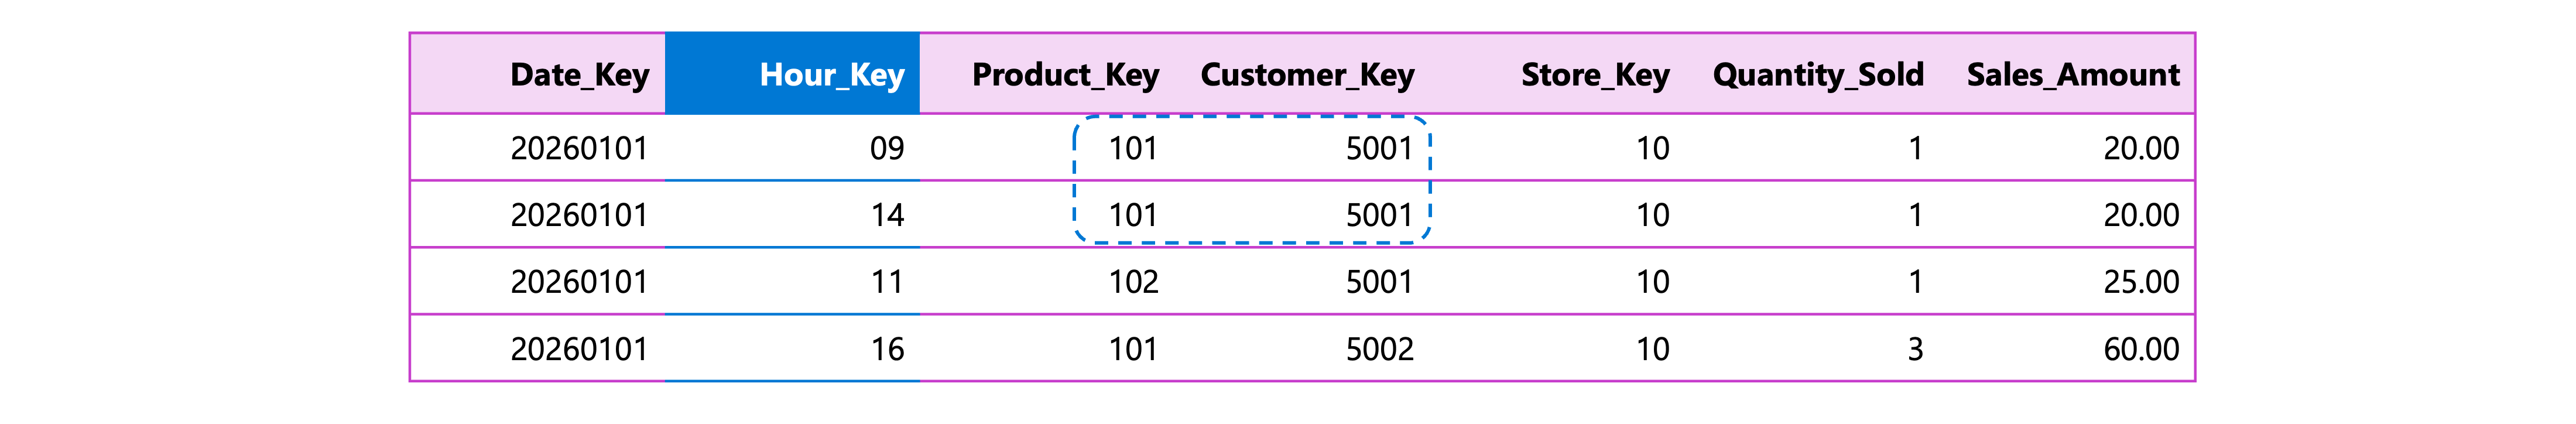
Tabela faktów sprzedaży z kluczami wymiarów dla daty, produktu, klienta i sklepu ma granularność "jeden wiersz na produkt na klienta na sklep dziennie". Każda unikatowa kombinacja tych wartości wymiarów tworzy odrębny wiersz. Dodanie klucza wymiaru czasu na poziomie godziny spowoduje zmianę poziomu szczegółowości na "jeden wiersz na produkt na klienta na sklep na godzinę", znacznie zwiększając liczbę wierszy.
Ważne
Zadeklaruj jawnie ziarno tabeli faktów przed dodaniem kolumn. Oświadczenie dotyczące ziarna służy jako kontrakt, który kieruje wszystkimi kolejnymi decyzjami projektowymi. Na przykład: "Ta tabela faktów zawiera jeden wiersz dla każdej pozycji w zamówieniu sprzedaży."
Podczas projektowania tabel faktów należy wziąć pod uwagę, czy potrzebujesz:
Atomowe ziarno: Najbardziej szczegółowy poziom uchwycony w systemie źródłowym. Wybór ziarna atomowego zapewnia maksymalną elastyczność analizy ponieważ zawsze można agregować dane, ale nigdy nie dezagregować.
Ziarno agregacji: wstępnie podsumowane dane na wyższym poziomie niż źródło. Tabele faktów zbiorczych zwiększają wydajność zapytań dla typowych wzorców analitycznych, ale ograniczają pytania, na które użytkownicy mogą odpowiedzieć.
Wiele organizacji utrzymuje zarówno tabele faktów atomowych, jak i tabele faktów agregatów, używając tych drugich jako optymalizacji wydajności przy jednoczesnym zachowaniu szczegółów atomowych na potrzeby analizy ad-hoc. W usłudze Azure Databricks zmaterializowane widoki mogą automatycznie obsługiwać te zagregowane tabele, odświeżając je w miarę zmian bazowych danych atomowych.
Zastosowanie granularności do tabel wymiarów
Tabele wymiarów mają również ziarno, choć działa inaczej niż ziarno tabeli faktów. Szczegółowość wymiaru określa sposób reprezentowania i wersjonowania jednostek biznesowych.
Dla wymiaru klienta możesz wybrać:
- Jeden wiersz na klienta: bieżący stan każdego klienta jest aktualizowany bezpośrednio przy zmianie atrybutów (typ SCD 1).
- Jeden wiersz na klienta na wersję: nowy wiersz dla każdej znaczącej zmiany, zachowując stany historyczne (typ SCD 2).
- Jeden wiersz na klienta w danym okresie: okresowe migawki przechwytujące atrybuty klienta w regularnych odstępach czasu.
Wybrane ziarno wymiaru musi być zgodne z ziarnem tabeli faktów. Jeśli tabela faktów śledzi poszczególne transakcje za pomocą kluczy zastępczych powiązanych z wymiarem klienta, poziom szczegółowości wymiaru klienta musi obsługiwać tę relację. Transakcja odwołująca się do wersji klienta oznaczonej jako 5 musi być w stanie znaleźć tę konkretną wersję w tabeli wymiarowej.
Bilansowanie kompromisów podczas wybierania stopnia szczegółowości
Żaden pojedynczy wybór stopnia szczegółowości nie jest powszechnie poprawny. Każda decyzja obejmuje kompromisy, które należy ocenić pod kątem konkretnych wymagań.
| Kwestie wymagające rozważenia | Stopień szczegółowości | Gruba stopień szczegółowości |
|---|---|---|
| Elastyczność analizy | Wysoki — może odpowiedzieć na szczegółowe pytania | Niski — ograniczony do analizy zagregowanej |
| Koszty magazynu | Wyższe — więcej wierszy do przechowywania | Niższe — mniej wierszy |
| Wydajność zapytania | Wolniejsze w przypadku zapytań agregowanych | Szybsze w przypadku typowych wzorców |
| Analiza historyczna | Obsługuje analizę punktu w czasie | Może utracić szczegóły historyczne |
| Obsługa zgodności | Lepsze w przypadku wymagań dotyczących inspekcji | Może nie spełniać przepisów |
Gdy nie masz pewności, rozpoczęcie od bardziej szczegółowego stopnia szczegółowości jest często bezpieczniejsze. Zawsze można tworzyć tabele agregujące później w celu optymalizacji wydajności, ale nie można odzyskać szczegółów , które nigdy nie zostały przechwycone. Jednak te wskazówki zakładają, że masz budżet i infrastrukturę, aby początkowo obsługiwać bardziej złożone magazynowanie.
Zrozumienie sposobu wybierania odpowiedniego stopnia szczegółowości umożliwia projektowanie modeli danych, które obsługują potrzeby analityczne organizacji podczas efektywnego zarządzania kosztami. Szczegóły implementacji dotyczące tworzenia i ładowania tabel na wybranym poziomie szczegółowości w usłudze Azure Databricks są omówione w kolejnych lekcjach.