Eksplorowanie przetwarzania danych analitycznych
Tip
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Przetwarzanie danych analitycznych zwykle używa systemów tylko do odczytu (lub głównie do odczytu), które przechowują ogromne ilości danych archiwalnych lub metryk biznesowych. Analiza może opierać się na migawce danych z określonego punktu w czasie lub na serii migawek.
Szczegółowe informacje dotyczące systemu przetwarzania analitycznego mogą się różnić między rozwiązaniami, ale typowa architektura analizy w skali przedsiębiorstwa wygląda następująco:
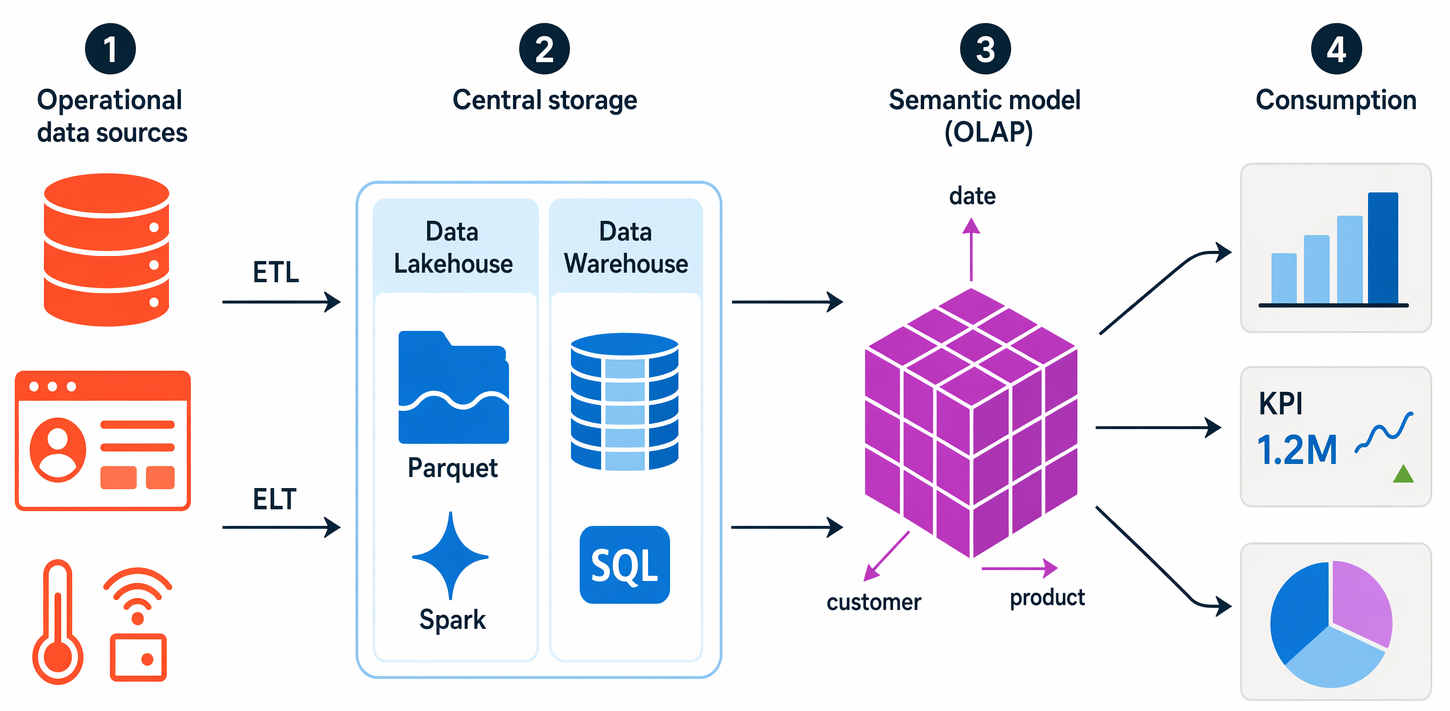
Dane operacyjne są ekstrahowane, przekształcane i ładowane (ETL) do jeziora danych na potrzeby analizy — albo najpierw ekstrahowane i ładowane, a przekształcenia są stosowane później, co stanowi wzorzec nazywany ELT, powszechny w nowoczesnych architekturach lakehouse.
Dane są ładowane do schematu tabelowego — zazwyczaj w architekturze typu data lakehouse z tabelarycznymi abstrakcjami opartymi na plikach w jeziorze danych lub w hurtowni danych z w pełni relacyjnym silnikiem SQL.
Dane w magazynie danych mogą być agregowane i ładowane do modelu OLAP — dziś częściej nazywanego modelem semantycznym (a historycznie kostką). Zagregowane wartości liczbowe (miary) z tabel faktów są obliczane dla przecięć wymiarów w tabelach wymiarów. Na przykład przychody ze sprzedaży mogą być sumowane według daty, klienta i produktu. Power BI semantyczne modele są typowym przykładem.
Dane w usłudze Data Lake, magazynie danych i modelu analitycznym mogą być odpytywane w celu tworzenia raportów, wizualizacji i pulpitów nawigacyjnych.
Jeziora danych są powszechne w scenariuszach przetwarzania analitycznego danych na dużą skalę, gdzie trzeba zbierać i analizować dużą ilość danych opartych na plikach.
Magazyny danych to ustalony sposób przechowywania danych w schemacie relacyjnym zoptymalizowanym pod kątem operacji odczytu — przede wszystkim zapytań obsługujących raportowanie i wizualizację danych.
Usługa Data Lakehouses to nowsza innowacja, która łączy elastyczny i skalowalny magazyn typu data lake z semantykami zapytań relacyjnych magazynu danych. Schemat tabeli może wymagać denormalizacji danych w źródle danych OLTP (wprowadzenie niektórych duplikacji w celu szybszego wykonywania zapytań).
Model OLAP (lub model semantyczny) to zagregowany typ magazynu danych zoptymalizowany pod kątem obciążeń analitycznych. Agregacje danych obejmują różne wymiary na różnych poziomach, co umożliwia przechodzenie w górę/w dół hierarchii w celu wyświetlania agregacji na wielu poziomach hierarchicznych; na przykład aby sprawdzić łączną sprzedaż według regionu, miasta lub dla pojedynczego adresu. Ponieważ dane są wstępnie agregowane, zapytania zwracające zawarte w nim podsumowania mogą być uruchamiane szybko.
Różne typy użytkowników mogą wykonywać prace analityczne danych na różnych etapach ogólnej architektury. Na przykład:
- Analitycy danych mogą pracować bezpośrednio z plikami danych w usłudze Data Lake, aby eksplorować i modelować dane.
- analitycy danych mogą wysyłać zapytania do tabel bezpośrednio w magazynie danych w celu tworzenia złożonych raportów i wizualizacji.
- Użytkownicy biznesowi mogą używać wstępnie zagregowanych danych w modelu analitycznym w postaci raportów lub pulpitów nawigacyjnych.
Nowoczesne platformy analityczne
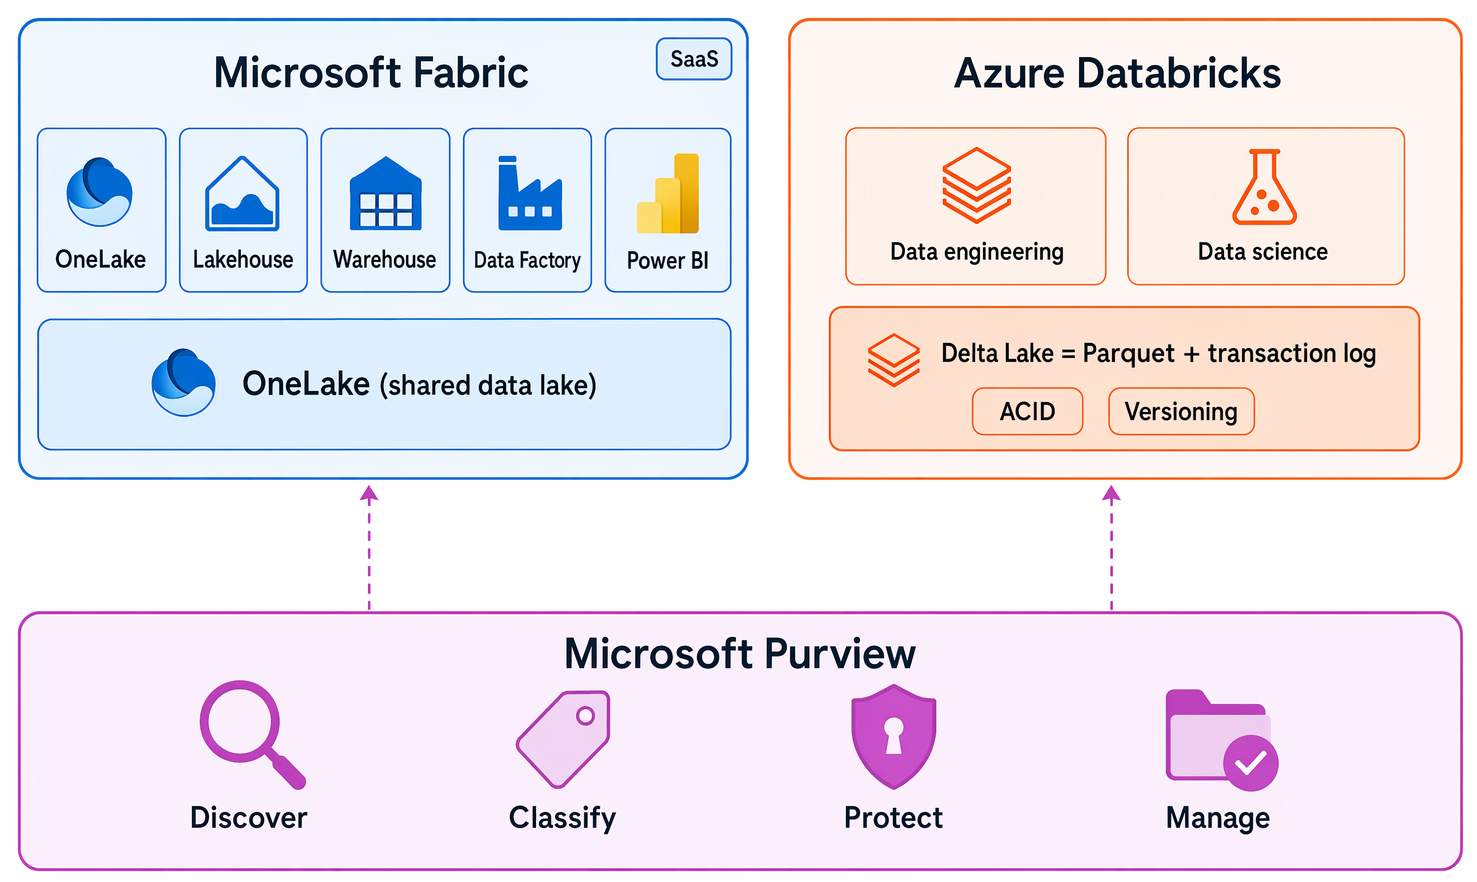
Microsoft udostępnia kilka usług zarządzanych, które obejmują pełny potok analityczny — od pozyskiwania danych pierwotnych do interaktywnych raportów. Dwie platformy "all-in-one" łączą większość tych funkcji w jednym obszarze roboczym. Microsoft Fabric i Azure Databricks to dwie platformy; trzecia usługa, Microsoft Purview, koncentruje się na zarządzaniu danymi we wszystkich źródłach. Nie musisz jeszcze znać żadnej z tych usług — poniższe opisy zapewniają ogólne poczucie tego, co robi każdy z nich.
Microsoft Fabric to ujednolicona platforma analityczna oprogramowania jako usługi (SaaS), która oferuje funkcje magazynu, inżynierii danych, magazynowania danych i raportowania w jednym obszarze roboczym. Azure Databricks to platforma analityczna w chmurze stworzona z myślą o inżynierii danych i nauce o danych na dużą skalę, używająca Delta Lake — Parquet oraz dziennika transakcji, który umożliwia przechowywanie wersji i transakcje ACID — jako domyślnego formatu przechowywania. Microsoft Purview zapewnia ujednolicone zabezpieczenia danych, ład i zgodność, pomagając wykrywać, klasyfikować, chronić i zarządzać danymi we wszystkich źródłach danych.
Organizowanie danych przy użyciu architektury medalonu
Powszechnym wzorcem organizacji danych w architekturze lakehouse jest architektura medallion, która wykorzystuje trzy warstwy:
- Brąz: nieprzetworzone dane pozyskane as-is z systemów źródłowych bez zastosowanych przekształceń, zachowując oryginalne rekordy do ponownego przetwarzania.
- Silver: oczyszczone i zgodne dane, z usuniętymi duplikatami i ustandaryzowanymi typami danych.
- Złoto: zagregowane dane gotowe do użytku biznesowego, modelowane na potrzeby konkretnych zastosowań raportowych i analitycznych.
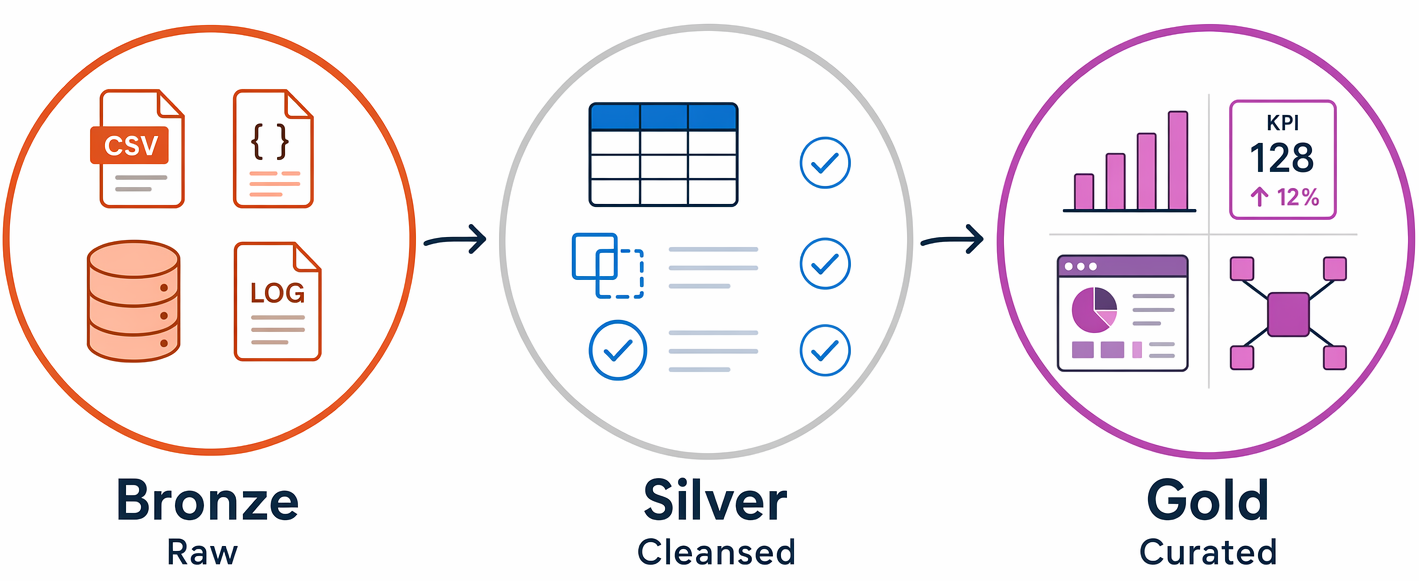
Zespoły stosują ten wzorzec, ponieważ wyznacza on wyraźne granice jakościowe na każdej warstwie, a jeśli wymagania się zmienią, dane można zawsze ponownie przetworzyć na podstawie oryginalnych rekordów warstwy Bronze.
Obie platformy obejmują asystentów sztucznej inteligencji, którzy umożliwiają pracę z danymi przy użyciu języka naturalnego: Fabric obejmuje Copilot, a Azure Databricks zawiera funkcje pomocnicze sztucznej inteligencji, takie jak Genie Code.