Implementowanie sprawdzania poprawności
Wskazówka
Aby uzyskać więcej szczegółów, zobacz kartę Tekst i obrazy .
Potoki danych często napotykają rekordy z brakującymi wartościami, zduplikowanymi identyfikatorami lub wartościami, które wykraczają poza dopuszczalne zakresy. Bez mechanizmów sprawdzania poprawności, te problemy z jakością danych rozprzestrzeniają się w dół strumienia danych, powodując nieprawidłowe analizy, nietrafione raporty i niewiarygodne decyzje biznesowe. Walidacja wychwytuje te problemy w momencie pozyskiwania danych, zapewniając, że przez potok przepływają tylko dane wysokiej jakości.
W tej lekcji dowiesz się, jak zaimplementować sprawdzanie poprawności pod kątem dopuszczalności wartości null, kardynalności danych i kontroli zakresu przy użyciu oczekiwań potoków usługi Lakeflow i ograniczeń tabeli usługi Delta Lake.
Omówienie metod walidacji w usłudze Azure Databricks
Usługa Azure Databricks udostępnia dwa podstawowe mechanizmy implementowania kontroli poprawności: oczekiwania dotyczące potoku i ograniczenia tabel. Każde podejście obsługuje różne scenariusze i oferuje różne możliwości.
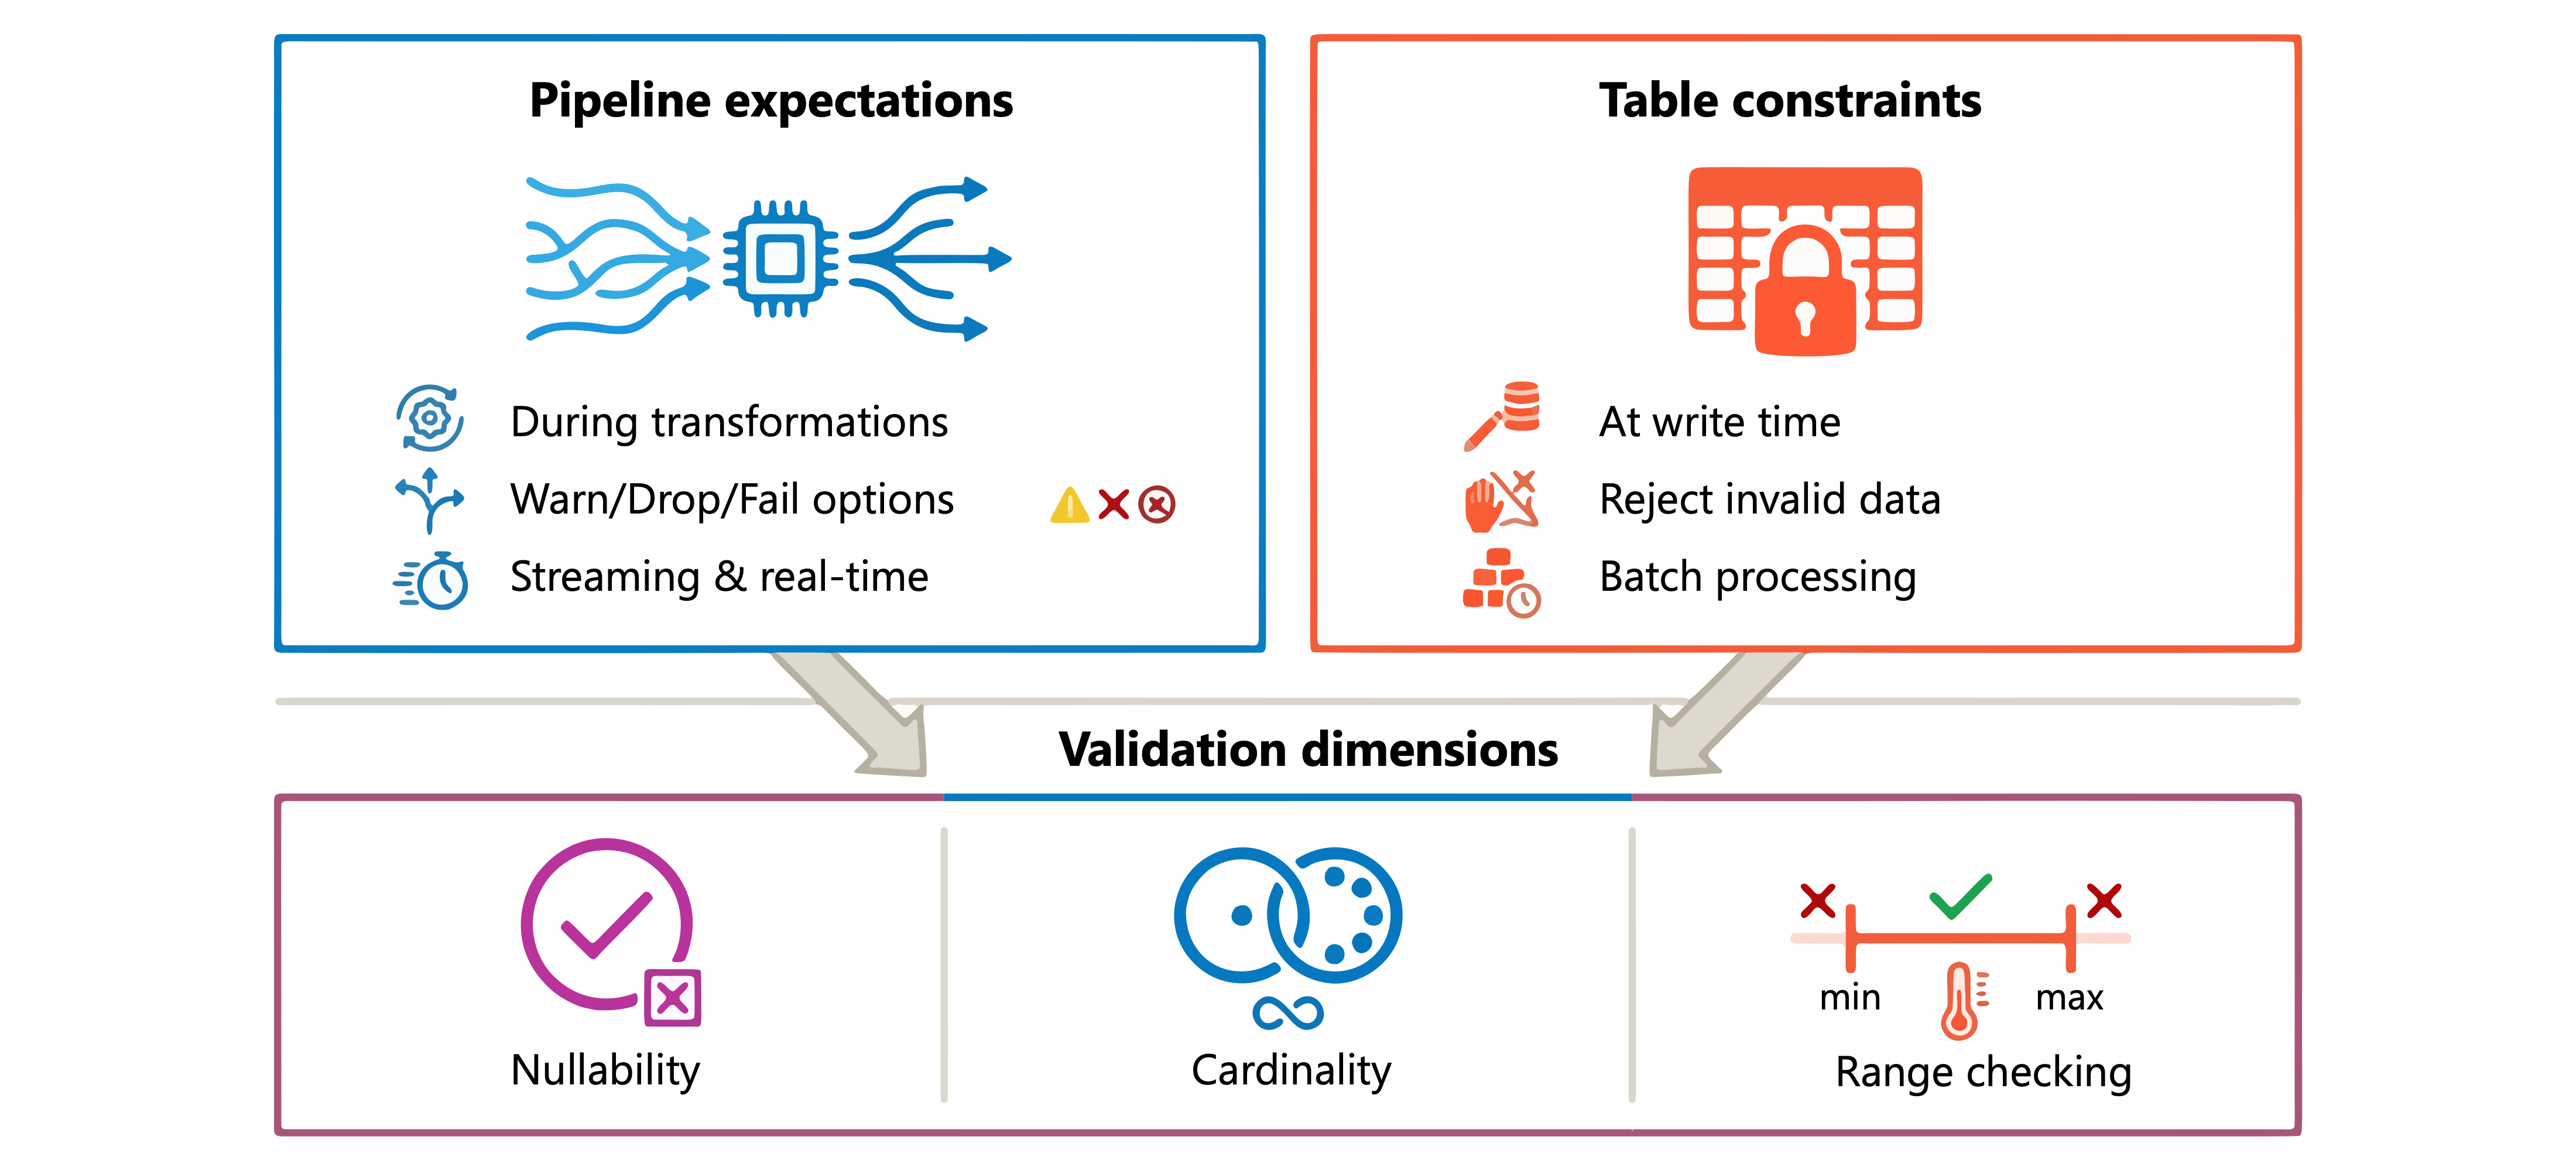
Oczekiwania w potoku stosują walidację podczas przekształcania danych w potokach usługi Lakeflow. Oczekiwania pozwalają na ostrzeganie, usuwanie nieprawidłowych rekordów lub przerwanie działania potoku w przypadku, gdy dane naruszają Twoje reguły. Takie podejście działa dobrze w przypadku tabel przesyłania strumieniowego i zmaterializowanych widoków, w których potrzebna jest kontrola jakości w czasie rzeczywistym.
Ograniczenia tabel wymuszają reguły bezpośrednio w tabelach Delta Lake. Ograniczenia odrzucają nieprawidłowe dane w czasie zapisu, co uniemożliwia wprowadzanie nieprawidłowych rekordów w tabelach. Takie podejście odpowiada przetwarzaniu wsadowemu oraz scenariuszom wymagającym rygorystycznych gwarancji integralności danych.
Dzięki tym podejściom można zweryfikować trzy kluczowe wymiary jakości danych: nullowalność (zapewnienie istnienia wymaganych wartości), kardynalność danych (weryfikowanie unikatowości tam, gdzie jest to oczekiwane) i sprawdzanie zakresu (potwierdzanie, że wartości mieszczą się w dopuszczalnych granicach).
Implementuj kontrolę wartości null
Walidacja nullowalności gwarantuje, że wymagane kolumny zawierają wartości. Rozważ tabelę klienta, w której email i customer_id zawsze musi mieć wartości. Możesz zaimplementować te sprawdzenia przy użyciu oczekiwań w przepływie.
Używając języka Python, dodaj dekoratory oczekiwań do definicji tabeli przesyłania strumieniowego:
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("valid_email", "email IS NOT NULL")
@dp.expect_or_drop("valid_customer_id", "customer_id IS NOT NULL")
def customers():
    return spark.readStream.table("raw.customers")
Ta sama walidacja w języku SQL używa klauzuli CONSTRAINT :
CREATE OR REFRESH STREAMING TABLE customers(
    CONSTRAINT valid_email EXPECT (email IS NOT NULL) ON VIOLATION DROP ROW,
    CONSTRAINT valid_customer_id EXPECT (customer_id IS NOT NULL) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.customers);
W przypadku tabel Delta Lake spoza potoków użyj NOT NULL ograniczeń w definicji tabeli:
CREATE TABLE customers (
    customer_id INT NOT NULL,
    email STRING NOT NULL,
    first_name STRING,
    last_name STRING
);
Możesz również dodać ograniczenia dotyczące wartości null do istniejących tabel.
ALTER TABLE customers ALTER COLUMN email SET NOT NULL;
Uwaga / Notatka
Przed dodaniem NOT NULL ograniczenia do istniejącej tabeli usługa Azure Databricks sprawdza, czy wszystkie istniejące wiersze spełniają ograniczenie. Operacja kończy się niepowodzeniem, jeśli w kolumnie istnieją jakiekolwiek wartości null.
Weryfikowanie kardynalności danych
Walidacja kardynalności zapewnia, że kolumny faktycznie zawierają unikatowe wartości. Ta kontrola jest niezbędna w przypadku kluczy podstawowych, identyfikatorów transakcji i innych pól, w których duplikaty wskazują problemy z jakością danych.
Oczekiwania potoku mogą weryfikować kardynalność, sprawdzając warunki wskazujące problemy z unikatowością. Możesz na przykład sprawdzić, czy numer ubezpieczenia społecznego jest wyświetlany tylko raz na osobę:
from pyspark.sql.window import Window
from pyspark.sql.functions import count

@dp.table
@dp.expect("unique_ssn_per_person", "ssn_count = 1")
def employees():
    df = spark.table("raw.employees")
    w = Window.partitionBy("ssn")
    return df.withColumn("ssn_count", count("*").over(w))
Aby uzyskać bardziej kompleksowe kontrole kardynalności, połącz oczekiwania z logiką agregacji w transformacji:
CREATE OR REFRESH MATERIALIZED VIEW order_validation AS
SELECT
    order_id,
    COUNT(*) as occurrence_count
FROM orders
GROUP BY order_id
HAVING COUNT(*) > 1;
Ten zmaterializowany widok identyfikuje wszelkie zduplikowane identyfikatory zamówień, co umożliwia przeprowadzenie analizy i rozwiązanie problemów związanych z kardynalnością.
Delta Lake obsługuje ograniczenia klucza podstawowego, które dokumentują oczekiwaną unikatowość, jednak są to tylko dodatkowe informacje i nie są one wymuszane.
CREATE TABLE orders (
    order_id INT NOT NULL,
    customer_id INT,
    order_date DATE,
    CONSTRAINT orders_pk PRIMARY KEY (order_id)
);
Wskazówka
Chociaż ograniczenia klucza podstawowego nie są wymuszane, ułatwiają optymalizację zapytań i dokumentowanie zamierzonej struktury modelu danych. Użyj reguł potoku przetwarzania, aby aktywnie zapewniać unikatowość.
Zastosuj sprawdzanie zakresu
Sprawdzanie poprawności zakresu potwierdza, że wartości liczbowe, daty i inne należą do dopuszczalnych granic. To sprawdzenie przechwytuje błędy wprowadzania danych, błędy systemowe i problemy z integracją, które generują wartości poza zakresem.
Zdefiniuj oczekiwania dotyczące zakresu przy użyciu operatorów porównania lub klauzuli BETWEEN :
@dp.table
@dp.expect_or_fail("valid_age", "age BETWEEN 0 AND 150")
@dp.expect_or_fail("valid_salary", "salary >= 0")
@dp.expect_or_fail("valid_hire_date", "hire_date <= current_date()")
def employees():
    return spark.readStream.table("raw.employees")
W programie SQL zastosuj te same kontrole zakresu:
CREATE OR REFRESH STREAMING TABLE transactions(
    CONSTRAINT valid_amount EXPECT (amount > 0) ON VIOLATION DROP ROW,
    CONSTRAINT valid_date EXPECT (transaction_date <= current_date()) ON VIOLATION DROP ROW,
    CONSTRAINT valid_quantity EXPECT (quantity BETWEEN 1 AND 10000) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.transactions);
W przypadku tabel Delta Lake użyj ograniczeń CHECK, aby wymusić zakresy w czasie zapisu:
ALTER TABLE employees ADD CONSTRAINT valid_age CHECK (age >= 18 AND age <= 120);
ALTER TABLE transactions ADD CONSTRAINT positive_amount CHECK (amount > 0);
Kontrole zakresu mogą również weryfikować reguły biznesowe, które łączą wiele warunków:
@dp.expect("valid_discount", """
    discount_percent >= 0
    AND discount_percent <= 100
    AND (discount_percent <= 50 OR customer_tier = 'PREMIUM')
""")
To oczekiwanie gwarantuje, że rabaty pozostają w granicach i wymuszają, że tylko klienci premium otrzymują rabaty powyżej 50%.
Wybierz działania dla niepowodzeń walidacji
Gdy walidacja zakończy się niepowodzeniem, wybierz, jak pipeline ma reagować. Każda akcja odpowiada różnym wymaganiom biznesowym i poziomom krytycznym danych.
| Akcja | Przypadek użycia | Zachowanie |
|---|---|---|
| Ostrzegaj (ustawienie domyślne) | Monitorowanie i analizy | Nieprawidłowe rekordy zapisywane do lokalizacji docelowej; metryki zarejestrowane |
| Zrzuć | Czyszczenie danych | Nieprawidłowe rekordy usunięte przed zapisem |
| Niepowodzenie | Krytyczna integralność danych | Potok został zatrzymany; transakcja została wycofana |
Użyj akcji ostrzegania , jeśli potrzebujesz wglądu w problemy z jakością danych bez blokowania przepływu danych:
@dp.expect("has_phone", "phone_number IS NOT NULL")
Użyj drop, gdy nieprawidłowe rekordy powinny być odfiltrowane bez powiadamiania:
@dp.expect_or_drop("complete_address", "street IS NOT NULL AND city IS NOT NULL")
Użyj fail, gdy integralność danych jest krytyczna i nieprawidłowe rekordy są niedopuszczalne:
@dp.expect_or_fail("valid_account_balance", "balance >= 0")
Metryki oczekiwań można wyświetlić w interfejsie użytkownika potoku, wybierając zestaw danych z oczekiwaniami i otwierając kartę Jakość danych . Te metryki pomagają monitorować współczynniki powodzenia weryfikacji i identyfikować systematyczne problemy z jakością danych.
Teraz, gdy już wiesz, jak zaimplementować kontrole walidacji, możesz zapewnić, że potoki danych spełniają standardy jakości dla nullowalności, kardynalności oraz zakresów wartości.