Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Crie e mantenha tabelas de pesquisa separadas para dados que os aplicativos usam frequentemente em consultas quando um armazenamento de dados não fornece índices secundários adequados. Essa abordagem melhora o desempenho de leitura evitando verificações de dados completas quando as consultas não usam a chave primária ou a chave de partição.
Contexto e problema
Muitos armazenamentos de dados organizam os dados de uma coleção de entidades usando a chave primária. Um aplicativo pode utilizar essa chave para localizar e recuperar dados. A figura a seguir mostra um exemplo de um repositório de dados que contém informações do cliente organizadas pela chave primária, id do cliente.
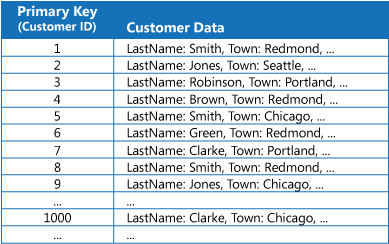
A imagem mostra uma tabela de duas colunas de registros do cliente. A primeira coluna, Chave Primária (ID do Cliente), contém os IDs do Cliente de 1 a 9, seguidos de reticências, do ID 1000 e de mais reticências. A segunda coluna, Dados do Cliente, contém dados do cliente compostos por um sobrenome e uma cidade, seguidos por reticências. Exemplos visíveis incluem o ID 1, que corresponde ao sobrenome Smith e à cidade de Redmond, e o ID 2, que corresponde ao sobrenome Jones e à cidade de Seattle. Outra linha mostra Smith em Chicago, e outra mostra Smith em Redmond. Mais uma linha mostra Jones em Chicago.
Embora a chave primária seja valiosa para consultas que buscam dados com base no valor dessa chave, um aplicativo que precisa recuperar dados com base em algum outro campo não pode usar a chave primária para essa consulta. No exemplo de clientes, um aplicativo não pode utilizar a chave primária da ID do cliente para recuperar clientes se consultar os dados unicamente ao referenciar o valor de algum outro atributo, como a cidade em que o cliente está localizado. Para executar uma consulta que faça referência apenas à cidade, o aplicativo pode ter que buscar e examinar cada registro do cliente, o que pode ser um processo lento.
Muitos sistema de gerenciamento de banco de dados relacional fornecem suporte a índices secundários. Um índice secundário é uma estrutura de dados separada organizada por um ou mais campos de chave não primários (secundários). Um índice secundário indica onde os dados de cada valor indexado são armazenados. Os itens em um índice secundário normalmente são classificados pelo valor das chaves secundárias para permitir uma pesquisa rápida de dados. O sistema de gerenciamento de banco de dados geralmente mantém esses índices automaticamente.
Os bancos de dados relacionais permitem que vários índices secundários ofereçam suporte a vários padrões de consulta. Por exemplo, em uma tabela Customers em um banco de dados relacional em que a ID do Cliente é a chave primária, é benéfico adicionar um índice secundário no campo Cidade se o aplicativo procurar frequentemente os clientes pela cidade em que residem.
Embora índices secundários sejam comuns em sistemas relacionais, nem todos os armazenamentos de dados fornecem um recurso equivalente. Alguns armazenamentos de dados não têm índices secundários, enquanto outros fornecem índices que não atendem aos requisitos de desempenho, particionamento ou consulta de uma carga de trabalho. Nesses casos, os aplicativos devem escolher entre verificações completas e gerenciamento manual de índice.
Solução
Crie uma tabela de índice que organize os dados por uma chave especificada. A seção a seguir descreve três estratégias comuns para estruturar uma tabela de índice. As duas seções subsequentes descrevem usos para tabelas de índice em cenários específicos.
Estratégias de estruturação padrão
As estratégias a seguir são comumente usadas para estruturar uma tabela de índice. Escolha uma estratégia com base no número de índices secundários exigidos pelo cenário e na natureza das consultas executadas pelo aplicativo.
Desnormalização completa
A desnormalização completa duplica os dados em cada tabela de índice, mas os organiza por chaves diferentes da chave primária. A figura a seguir mostra tabelas de índice que organizam as mesmas informações do cliente por Town e LastName.

Essa estratégia funciona bem para cargas de trabalho de leitura pesada nas quais os dados são alterados com pouca frequência. À medida que a taxa de atualização aumenta, manter cada cópia adiciona sobrecarga de processamento (consulte Complexidade de consistência). Para conjuntos de dados de alto volume, armazenar as cópias também pode exigir espaço significativo.
Índice normalizado
Uma tabela de índice normalizada organiza dados por chaves diferentes da chave primária. A tabela de índice normalizada faz referência aos dados originais usando a chave primária em vez de duplicar esses dados, conforme mostrado na figura a seguir. Os dados originais são chamados de tabela de fatos.
Tip
Aqui, a tabela de fatos significa a tabela de origem autoritativa referenciada por um índice. Isso não implica um modelo de dados dimensional.

Essa técnica economiza espaço e reduz a sobrecarga da manutenção de dados duplicados. A desvantagem é que um aplicativo precisa executar duas operações de pesquisa para localizar dados usando uma chave secundária. O aplicativo precisa encontrar a chave primária para os dados na tabela de índice e, em seguida, usar a chave primária para pesquisar os dados na tabela de fatos.
Desnormalização parcial
A desnormalização parcial cria tabelas de índice que duplicam campos recuperados com frequência e são organizadas por chaves diferentes da chave primária. A tabela de fatos é referenciada para acessar campos acessados com menos frequência. A figura a seguir mostra como os dados acessados com frequência são duplicados em cada tabela de índice.

Essa estratégia equilibra as duas primeiras abordagens. Você pode recuperar rapidamente dados para consultas comuns usando uma única pesquisa, enquanto a sobrecarga de espaço e manutenção não é tão significativa quanto duplicar todo o conjunto de dados.
Chaves compostas
Alguns aplicativos frequentemente consultam dados especificando uma combinação de valores, por exemplo, "Localizar todos os clientes que residem em Redmond e que têm um sobrenome de Smith". Nessa situação, crie chaves de índice com base em vários atributos, como os atributos Town e LastName nesse caso.
Use uma codificação que preserva os limites dos componentes para que combinações de valores diferentes não possam produzir a mesma chave. Se as consultas dependerem da ordem de chave, verifique também se a codificação preserva a ordem de classificação necessária sob as regras de ordenação de chave do repositório de dados.
A figura a seguir mostra uma tabela de índice baseada em chaves compostas. As chaves são classificadas por Town e, em seguida, por LastName para registros que têm o mesmo valor para Town.
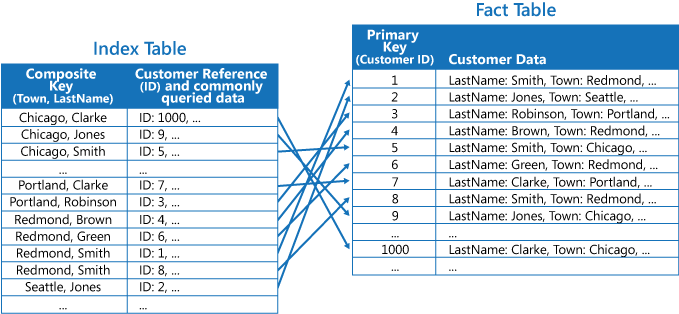
O diagrama contém uma tabela de índice à esquerda e uma tabela de fatos à direita. A tabela de fatos organiza os dados do cliente pela chave primária, ID do cliente. Cada linha de Dados do Cliente contém um sobrenome do cliente, uma cidade e uma reticências indicando outros dados. A tabela de índice é organizada por uma chave composta que combina Town e LastName. Sua segunda coluna, Referência do cliente (ID) e dados comumente consultados, contém uma ID de cliente e reticências. As setas se estendem das linhas da tabela de índice para a tabela de fatos, com cada seta apontando para a linha ID do Cliente referenciada por essa entrada de índice. As setas de cruzamento ilustram que as entradas ordenadas pela chave composta podem referenciar linhas de clientes em diferentes posições na tabela de fatos.
Tabelas de índice sobre dados fragmentados
As tabelas de índice podem acelerar as operações de consulta em relação aos dados fragmentados. Elas são especialmente úteis quando a chave de fragmento é hash. A figura a seguir mostra um exemplo em que a chave de fragmento é um hash da ID do Cliente. A tabela de índice organiza entradas por valores não hash, Town e LastName e armazena a chave de fragmento de hash correspondente com cada entrada.
Essa configuração oferece suporte a consultas por intervalo e ordenadas nos valores sem hash, ao mesmo tempo em que fornece as informações de roteamento necessárias para recuperar cada registro do shard correto. Por exemplo, uma consulta como "Localizar todos os clientes que residem em Redmond" pode localizar os itens correspondentes em um bloco contíguo na tabela de índice. Em seguida, o aplicativo segue as referências aos dados do cliente usando as chaves de fragmento armazenadas na tabela de índice.

Problemas e considerações
Considere os seguintes pontos ao decidir como implementar esse padrão:
Sobrecarga de manutenção. A manutenção de índices secundários pode adicionar sobrecarga significativa. Analise e entenda as consultas que seu aplicativo usa. Crie tabelas de índice somente quando for provável usá-las regularmente. Não crie tabelas de índice especulativas para dar suporte a consultas que um aplicativo não executa ou executa apenas ocasionalmente. À medida que o número de padrões de consulta aumenta, o número de tabelas de índice aumenta e cada uma adiciona uma área de superfície operacional para monitorar, manter e depurar. Avalie o benefício da consulta de cada tabela de índice em relação ao custo operacional de manutenção de outra estrutura de dados derivada. Examine periodicamente as tabelas de índice existentes para identificar e remover as que não estão mais sendo consultadas.
Custo de armazenamento e taxa de transferência. A duplicação de dados em uma tabela de índice aumenta os custos de armazenamento proporcionalmente ao número de tabelas de índice e ao tamanho dos campos copiados. Manter várias cópias de dados também adiciona esforço. Cada operação de gravação em uma tabela de índice consome capacidade de throughput, como transações contabilizadas nos limites da conta de armazenamento no Armazenamento de Tabelas do Azure ou unidades de solicitação no Azure Cosmos DB. O custo não se limita ao armazenamento, estendendo-se também ao throughput de gravação.
Penalidade de dupla consulta. A implementação de uma tabela de índice como uma estrutura normalizada que faz referência aos dados originais requer um aplicativo para executar duas operações de pesquisa para localizar dados. A primeira operação pesquisa a tabela de índice para recuperar a chave primária e a segunda utiliza a chave primária para buscar os dados.
Complexidade da consistência. Se um sistema incorporar várias tabelas de índice em conjuntos de dados grandes, manter a consistência entre tabelas de índice e os dados originais poderá ser difícil. Se os dados de origem e as entradas de índice não puderem ser atualizados na mesma transação, projete o aplicativo em torno de um modelo de consistência eventual. Registre cada alteração na origem de forma persistente antes de confirmar a gravação. Por exemplo, consuma um feed de alterações do banco de dados, use o padrão Transactional Outbox para registrar um registro na outbox na mesma transação da alteração de origem ou coloque um comando na fila antes de alterar os dados de origem. Na abordagem baseada em comandos, use um worker para processar o comando e atualizar os dados de origem e seus índices. Não atualize os dados de origem e publique independentemente uma mensagem de atualização de índice, pois uma falha entre essas operações pode deixar o índice obsoleto.
Projete o consumidor assíncrono como idempotente, pois a entrega e as repetições de mensagens podem fazer com que a mesma atualização seja executada mais de uma vez. As atualizações do mesmo registro de origem também podem chegar fora de ordem. Inclua uma versão de origem ou um número de sequência em cada atualização de índice e aplique uma atualização somente se ela for mais recente que a versão no índice. Para exclusões, mantenha um marcador de exclusão versionado ou uma marca d’água alta equivalente para que uma atualização antiga atrasada não possa recriar a entrada excluída do índice. Durante o intervalo entre a gravação de dados de origem e a atualização de índice assíncrono, as consultas na tabela de índice podem retornar referências obsoletas a registros que foram atualizados ou excluídos nos dados de origem e podem omitir registros adicionados recentemente.
Particionando tabelas de índice. As tabelas de índice podem ser particionadas ou fragmentadas, o que adiciona complexidade ao roteamento de consultas e requer que a estratégia de particionamento se alinhe aos padrões de consulta que o índice foi projetado para atender.
Quando usar esse padrão
Use esse padrão quando um aplicativo frequentemente precisa recuperar dados usando uma chave diferente da chave primária (ou fragmento) e o armazenamento de dados não dá suporte nativo a índices secundários ou seus índices nativos não atendem aos requisitos de consulta, particionamento ou desempenho da carga de trabalho.
Esse padrão pode não ser adequado quando:
Os dados forem voláteis. Os dados são alterados com tanta frequência que a taxa de gravação excede a taxa na qual as tabelas de índice podem ser atualizadas de forma assíncrona. A janela de defasagem continua aumentando até que o índice fique permanentemente desatualizado, tornando-o ineficaz e fazendo com que a sobrecarga de armazenamento e vazão para manter a tabela de índice seja superior a qualquer economia obtida nas consultas.
Você tem chaves não discriminadoras. Um campo selecionado como a chave secundária de uma tabela de índice não é descritivo e pode ter apenas um pequeno conjunto de valores (por exemplo, um campo booliano que registra se um item está ativo). A tabela de índice incorre em custo total de armazenamento e taxa de transferência, mas fornece seletividade mínima de consulta.
Os valores de dados têm uma distribuição distorcida. O saldo dos valores de dados de um campo selecionado como a chave secundária de uma tabela de índice é altamente distorcido. Por exemplo, se 90% dos registros contiverem o mesmo valor em um campo, criar e manter uma tabela de índice para pesquisar dados com base nesse campo poderá criar mais sobrecarga do que verificar sequencialmente os dados. No entanto, se as consultas forem direcionadas com frequência a valores que estão nos 10% restantes, esse índice ainda poderá ser útil.
Design de carga de trabalho
Um arquiteto deve avaliar como usar o padrão de Tabela de Índice no projeto da carga de trabalho para atender às metas e aos princípios abordados nos pilares do Azure Well-Architected Framework. A tabela a seguir fornece diretrizes sobre como esse padrão dá suporte às metas de cada pilar.
| Pilar | Como esse padrão apoia os objetivos do pilar |
|---|---|
| A confiabilidade ajuda sua carga de trabalho a cumprir suas metas de resiliência e recuperação criando redundância e preservando a funcionalidade durante falhas. | A manutenção de índice assíncrono pode impedir que falhas temporárias de atualização de índice bloqueiem gravações de dados de origem. O processamento idempotente, o tratamento de mensagens mortas, o monitoramento e a reconciliação ajudam a restaurar a consistência do índice após falhas. - RE:07 Autopreservação - RE:10 Monitoramento |
| A Eficiência de Desempenho ajuda sua carga de trabalho a atender com eficiência às demandas por meio de otimizações no dimensionamento, nos dados e no código. | As tabelas de índice ajudam a habilitar pesquisas rápidas em campos de chave não primárias sem a necessidade de verificações de dados completas. Para armazenamentos de dados particionados, as tabelas de índice podem organizar entradas por valores sem hash para oferecer suporte a consultas de intervalo e de ordenação que a chave de shard, por si só, não consegue atender com eficiência. - PE:05 Dimensionamento e particionamento - PE:08 Performance de Dados |
Assim como acontece com qualquer decisão de design, se esse padrão introduzir compensações dentro de um pilar, considere-as em relação às metas dos outros pilares.
Example
Considere um aplicativo que armazena informações sobre filmes. Suponha que o catálogo seja grande e com predominância de leitura, que cada filme tenha um gênero primário, que as consultas por ator sejam frequentes, que os dados do elenco mudem com pouca frequência e que um pequeno atraso na indexação seja aceitável. O Armazenamento de Tabelas armazena cada entidade como um conjunto estruturado de propriedades nomeadas. Cada entidade inclui um PartitionKey, um RowKeye um carimbo de data/hora e entidades na mesma tabela podem ter diferentes conjuntos de propriedades.
O Armazenamento de Tabelas usa uma chave primária composta que consiste em PartitionKey e RowKey. O PartitionKey valor determina a partição na qual uma entidade é armazenada. Em uma partição, o RowKey valor identifica exclusivamente uma entidade. O Armazenamento de Tabelas é otimizado para consultas que especificam ambas as chaves ou buscam um intervalo contíguo de valores de chave de linha em uma partição.
Tip
O Table Storage oferece suporte a atualizações transacionais de entidades na mesma tabela e na mesma partição por meio de transações de grupo de entidades. Uma transação não pode abranger uma tabela de fatos e uma tabela de índice separada. Para atualizar uma entidade de fato e entidades de índice atomicamente, armazene-as na mesma tabela com o mesmo PartitionKey. As transações de grupo de entidades são limitadas a 100 entidades por lote com uma carga máxima de 4 MiB.
Para este exemplo, crie uma tabela Azure com partições para cada gênero usando um identificador de gênero codificado como a chave de partição e um identificador de filme estável e exclusivo como a chave de linha. Armazene os nomes do gênero e do filme como propriedades. A figura a seguir usa nomes legíveis no lugar de identificadores para tornar o exemplo mais fácil de seguir.

Essa abordagem é menos efetiva se o aplicativo também precisar consultar filmes por ator principal. Nesse caso, crie uma tabela Azure separada que atua como uma tabela de índice. Use um identificador de ator estável codificado como chave de partição e o identificador do filme como chave de linha. Armazene nomes de atores e filmes como propriedades. A figura a seguir usa nomes legíveis no lugar de identificadores. Se um filme estrela mais de um ator, o mesmo filme ocorre em várias partições.
A figura a seguir mostra a tabela de índices de atores.

Passo a passo do design
A tabela de filmes usa o gênero como sua chave de partição, o que significa que as consultas filtradas por gênero são executadas com eficiência como verificações de partição em intervalos de chaves de linha contíguos. No entanto, o Armazenamento de Tabelas oferece suporte apenas a um único índice clusterizado em PartitionKey e RowKey. Ele não tem índices secundários. Uma consulta como "localizar todos os filmes estrelados por um ator específico" requer uma verificação de tabela completa em cada partição de gênero, o que é caro em escala.
A tabela de índice do ator aborda essa limitação revertendo o padrão de acesso. Cada identificador de ator se torna uma chave de partição e cada identificador de filme se torna uma chave de linha, de modo que as consultas baseadas em ator são resolvidas como pesquisas de partição eficientes. Como cada partição contém apenas os filmes de um ator, a consulta retorna um intervalo contíguo de entidades sem a verificação de dados não relacionados.
Como as entradas de filme e ator usam tabelas e chaves de partição separadas, essas entradas não podem compartilhar uma transação de grupo de entidades. Mantenha o índice de atores por meio de um mecanismo durável de captura assíncrona de alterações e projete a aplicação para tolerar uma breve defasagem nas consultas.
A tabela de índice aplica a desnormalização parcial: cada entrada duplica campos comumente acessados (como os nomes de outros atores) para que as consultas mais frequentes possam ser respondidas apenas da tabela de índice com uma única pesquisa. Para campos acessados com menos frequência, a entrada inclui a chave de partição de gênero da tabela original de filmes, permitindo uma consulta pontual direcionada na partição de gênero para obter o registro completo. Esse design equilibra a velocidade da consulta em relação ao custo de armazenamento e à sobrecarga de manutenção.
Próximas Etapas
As diretrizes de design de consulta do Armazenamento de Tabelas descrevem padrões de índice secundário que usam
PartitionKeyeRowKey, incluindo abordagens para armazenar entradas de índice na mesma partição ou em partições separadas.Estratégias de particionamento de dados explicam como selecionar chaves de partição e linha com base em padrões de consulta, distribuição de dados, requisitos de transação e metas de escalabilidade.
As estratégias de arquitetura para otimizar o desempenho de dados fornecem diretrizes para avaliar padrões de consulta, índices, partições e requisitos de monitoramento.
Os níveis de consistência em Azure Cosmos DB descrevem os modelos de consistência relevantes quando você mantém tabelas de índice em Azure Cosmos DB.
Recursos relacionados
Os seguintes padrões também serão relevantes durante a implementação desse padrão:
Padrão de Fragmentação. O padrão da tabela de índice é frequentemente utilizado em conjunto com dados compartilhados usando fragmentos. O padrão sharding descreve como dividir um armazenamento de dados em um conjunto de fragmentos.
Padrão de Exibição Materializada. Em vez de indexar dados para dar suporte a consultas que resumem dados, pode ser mais apropriado criar uma exibição materializada dos dados. Esse padrão descreve como gerar visões pré-populadas dos dados para dar suporte a consultas de resumo eficientes.
Padrão de caixa de saída transacional. Use o padrão de Caixa de Saída Transacional para ajudar a publicar alterações para manutenção de índice assíncrono de forma confiável quando os dados de origem e as entradas de índice não puderem ser atualizados em uma transação.