Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
A execução de consulta adaptável (AQE) é a reotimização de consulta que ocorre durante a execução de consulta.
Antes de uma consulta ser executada, o otimizador escolhe um plano de consulta com base nas estimativas do tamanho dos dados. Essas estimativas podem estar erradas se as estatísticas das tabelas estiverem ausentes ou obsoletas, se os dados estiverem enviesados ou para etapas posteriores de uma consulta complexa. Um plano baseado em estimativas erradas pode usar uma estratégia de junção lenta, criar tarefas pequenas demais após um shuffle ou criar algumas tarefas superdimensionadas que atrasam toda a etapa. O AQE resolve esses problemas reotimizando o plano enquanto a consulta é executada, com base no tamanho real dos dados.
Ao final de cada troca de embaralhamento ou broadcast, o Azure Databricks apresenta estatísticas precisas para os dados produzidos até então. O AQE usa essas estatísticas para escolher uma estratégia física melhor, escolher um número e tamanho ideais de partições pós-shuffle ou aplicar otimizações que, de outra forma, exigem hints de consulta, como o manejo de joins com skew.
O AQE está habilitado por padrão. Você não precisa mudar suas consultas para se beneficiar disso. Verifique se o AQE mudou um plano de consulta ao solucionar problemas de uma consulta lenta. Ajuste as configurações do AQE apenas quando as configurações padrão não combinarem com sua carga de trabalho. Veja planos de consulta e configuração.
Capacidades
O AQE possui quatro principais características:
- Altera dinamicamente a junção de mesclagem de classificação na junção hash de difusão.
- Une partições dinamicamente (combine partições pequenas em partições de tamanho razoável) após a troca em ordem aleatória. Tarefas muito pequenas têm pior taxa de transferência de E/S e tendem a sofrer mais com sobrecarga de agendamento e sobrecarga de instalação de tarefas. A combinação de pequenas tarefas salva recursos e melhora a taxa de transferência do cluster.
- Processa dinamicamente a distorção em classificar junção de mesclagem e junção hash aleatória dividindo (e replicando se necessário) tarefas distorcidas em tarefas de tamanho quase uniforme.
- Detecta e propaga dinamicamente relações vazias, que são partes de uma consulta que não retornam linhas.
Consultas suportadas
AQE se aplica a consultas que atendem a ambas as condições:
- A consulta não é uma consulta de streaming.
- A consulta contém pelo menos um exchange (geralmente de um join, agregado ou janela), pelo menos uma subconsulta, ou ambos.
O AQE re-otimiza todas as consultas suportadas, mas o resultado pode ser o mesmo plano que o otimizador compilou antes da consulta ser executada. Para verificar se o AQE alterou o plano de uma consulta, veja Planos de consulta.
Planos de consultas
As consultas aplicadas à AQE contêm um ou mais nós AdaptiveSparkPlan, geralmente como o nó raiz de cada consulta principal ou subconsulta. Cada AdaptiveSparkPlan nó possui uma isFinalPlan flag. flag está false antes e durante a execução da consulta, e muda para true quando a consulta termina.
Para visualizar um plano de consulta, use a interface do Spark, DataFrame.explain(), ou SQL EXPLAIN. Cada um mostra informações diferentes sobre como a AQE muda o plano.
Interface do usuário do Spark
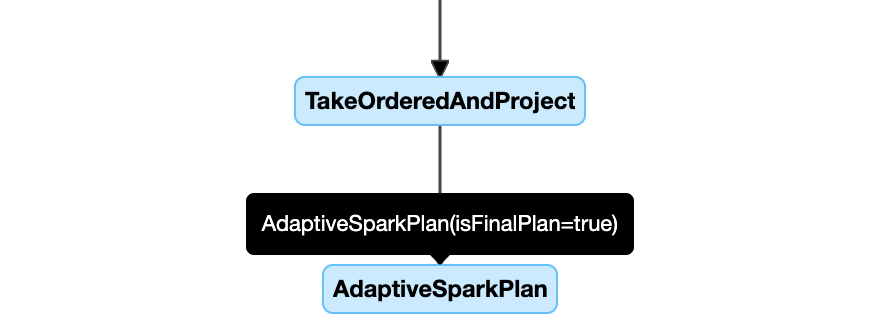
O diagrama do plano de consulta na interface do Spark mostra o plano mais recente e as atualizações conforme a consulta é executada. Os nós que já rodaram e têm métricas não mudam. Os nós que ainda não foram executados podem mudar à medida que o AQE reotimiza o plano.
Este exemplo mostra um diagrama de plano de consulta:
DataFrame.explain()
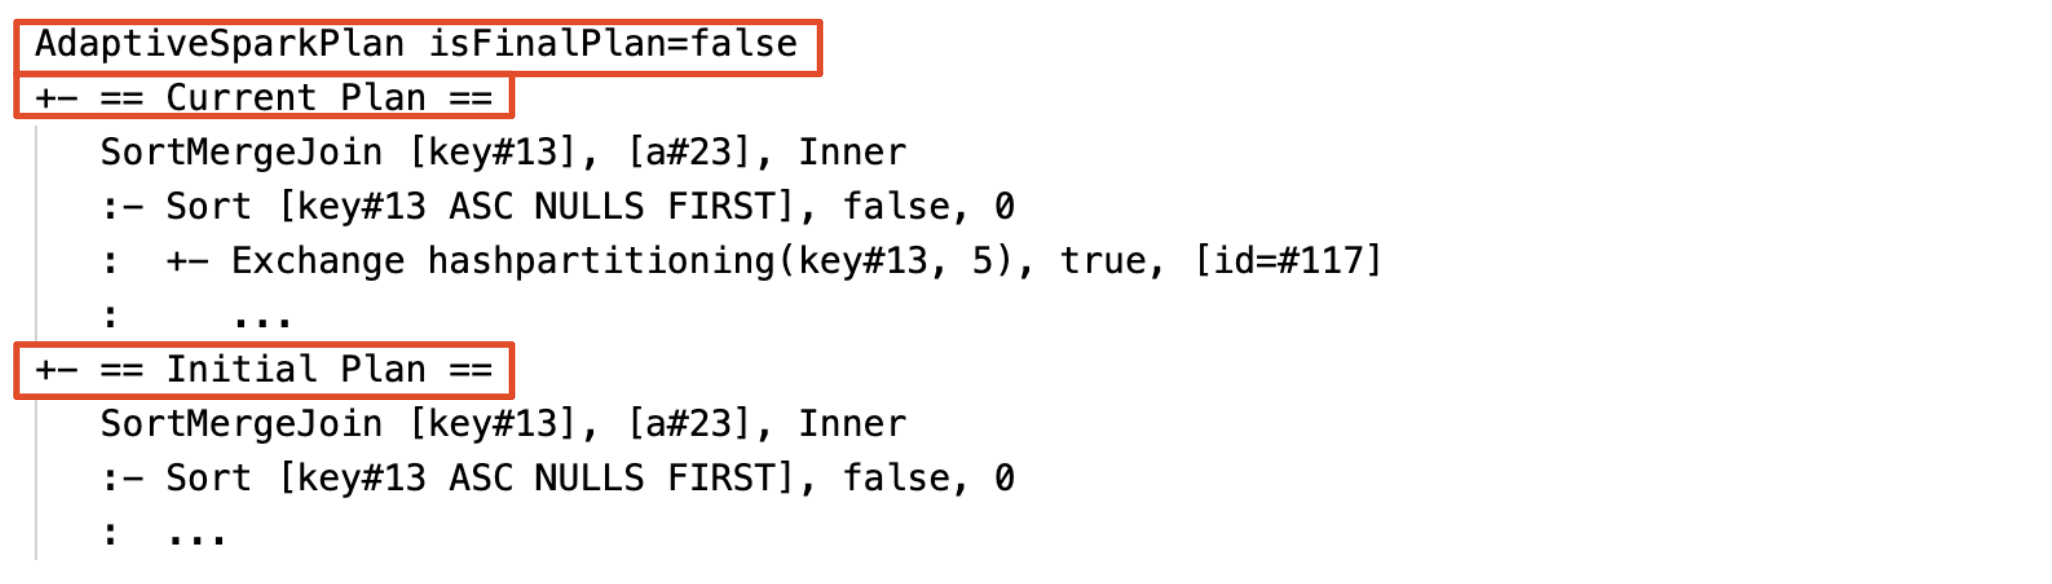
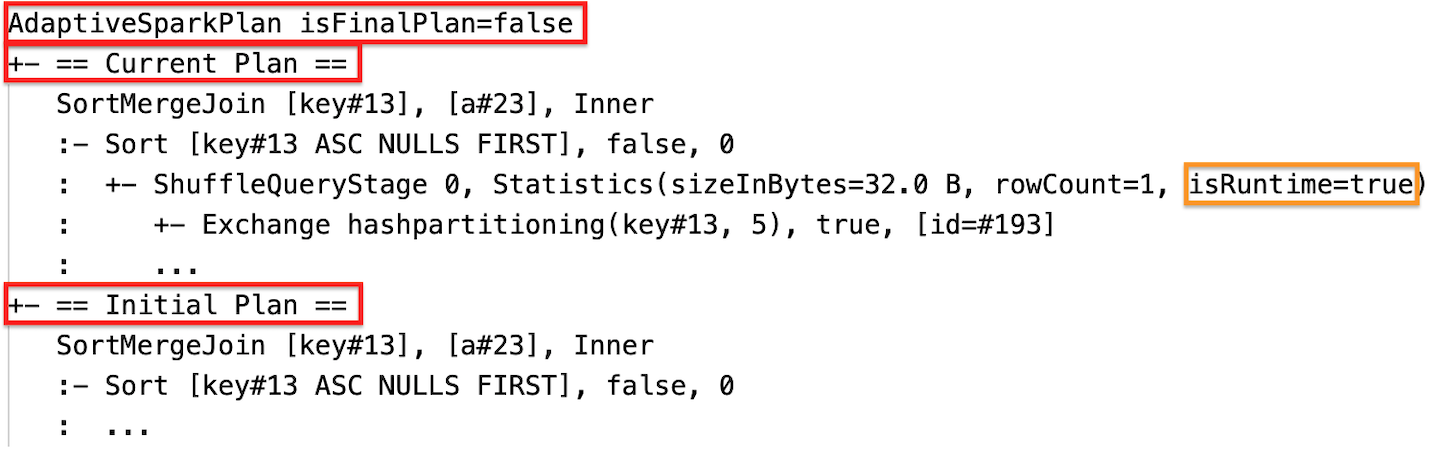
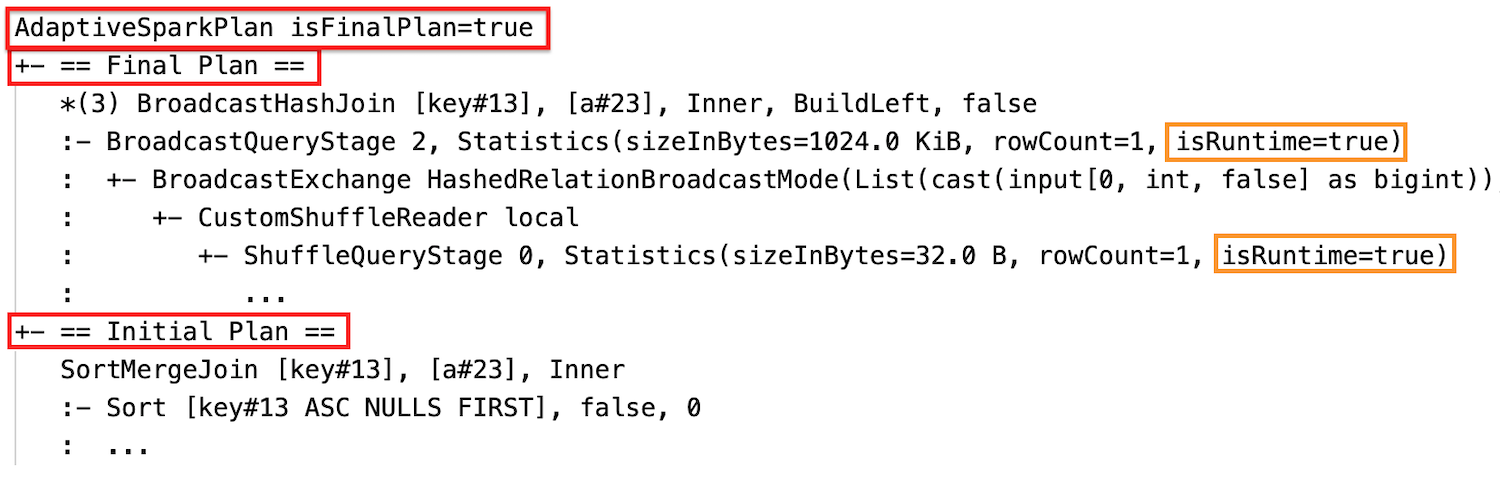
DataFrame.explain() mostra dois planos em cada AdaptiveSparkPlan nó: o plano inicial, antes de o AQE aplicar quaisquer otimizações, e o plano atual. O plano atual muda conforme a consulta é executada e se torna o plano final quando a consulta termina.
A saída inclui estatísticas de dados para cada etapa de embaralhamento e broadcast. As estatísticas dependem de a etapa ter sido executada:
- Antes e durante a execução da etapa,
isRuntimeéfalsee as estatísticas são estimativas em tempo de compilação. Por exemplo,Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Após a execução do estágio,
isRuntimeétruee as estatísticas são medições de tempo de execução. Por exemplo,Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Essas capturas de tela mostram DataFrame.explain() a saída antes, durante e após a execução:
Antes da execução
Durante a execução
Após a execução
SQL EXPLAIN
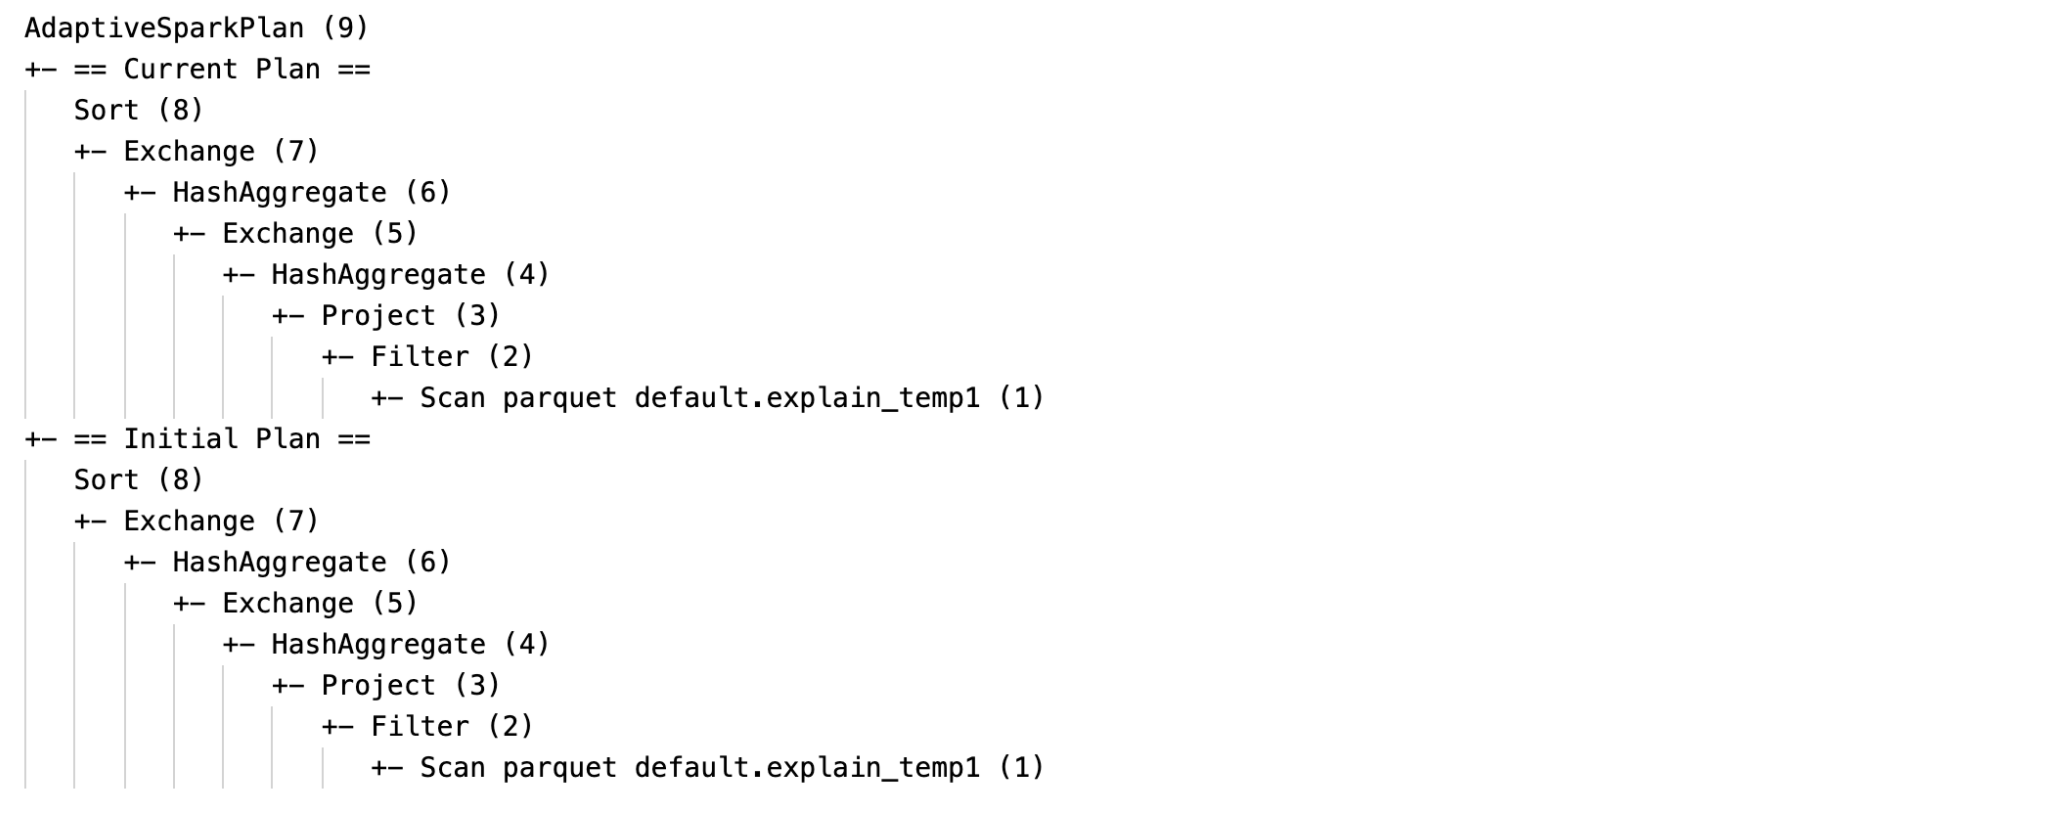
SQL EXPLAIN não executa a consulta, então o AQE não pode reotimizá-la. O resultado mostra apenas o plano inicial, que pode diferir do plano que a AQE executa.
Este exemplo mostra SQL EXPLAIN a saída:
Identificar otimizações aplicadas em um plano de consulta
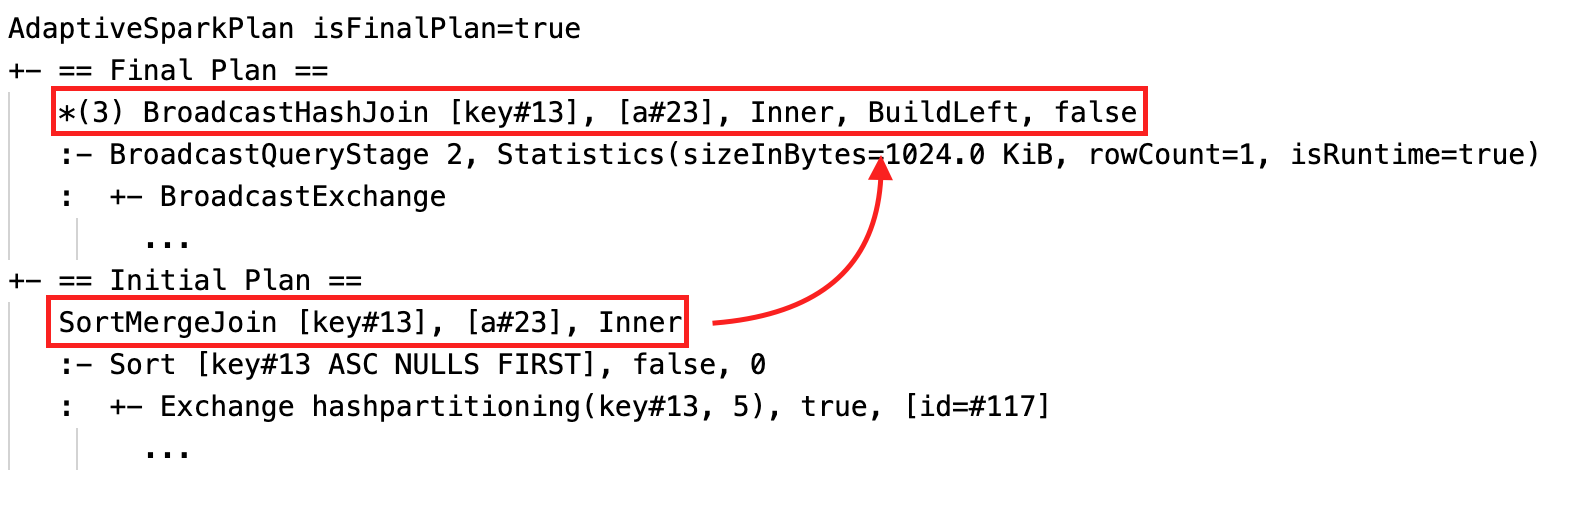
Quando o AQE aplica uma otimização, o plano de consulta muda. Para identificar quais otimizações tiveram efeito, compare o plano atual ou final com o plano inicial. Cada otimização altera o plano de uma maneira específica:
Alteração da estratégia de junção. O plano atual ou final tem um nó físico de junção diferente do plano inicial.
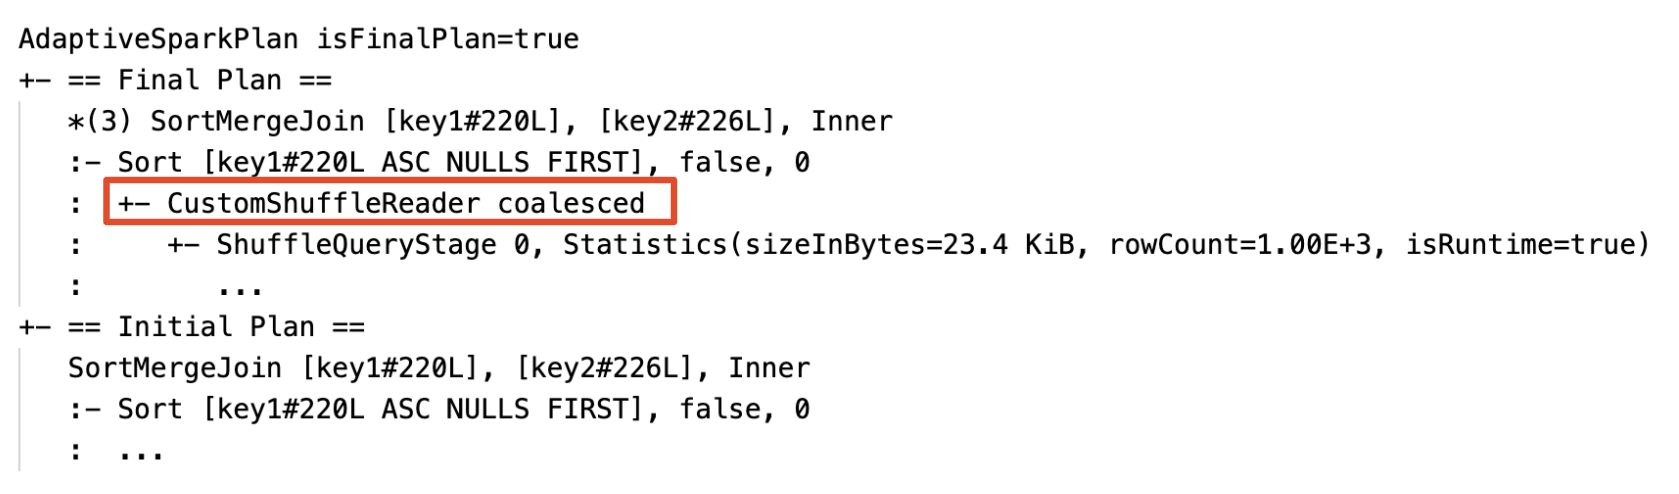
Coalescência de partições. O plano contém um nó
CustomShuffleReadercom a propriedadeCoalesced.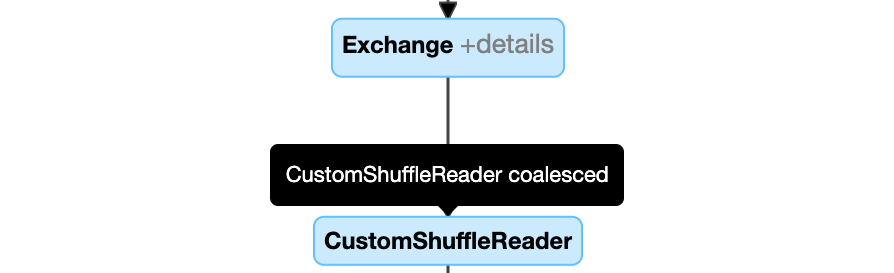
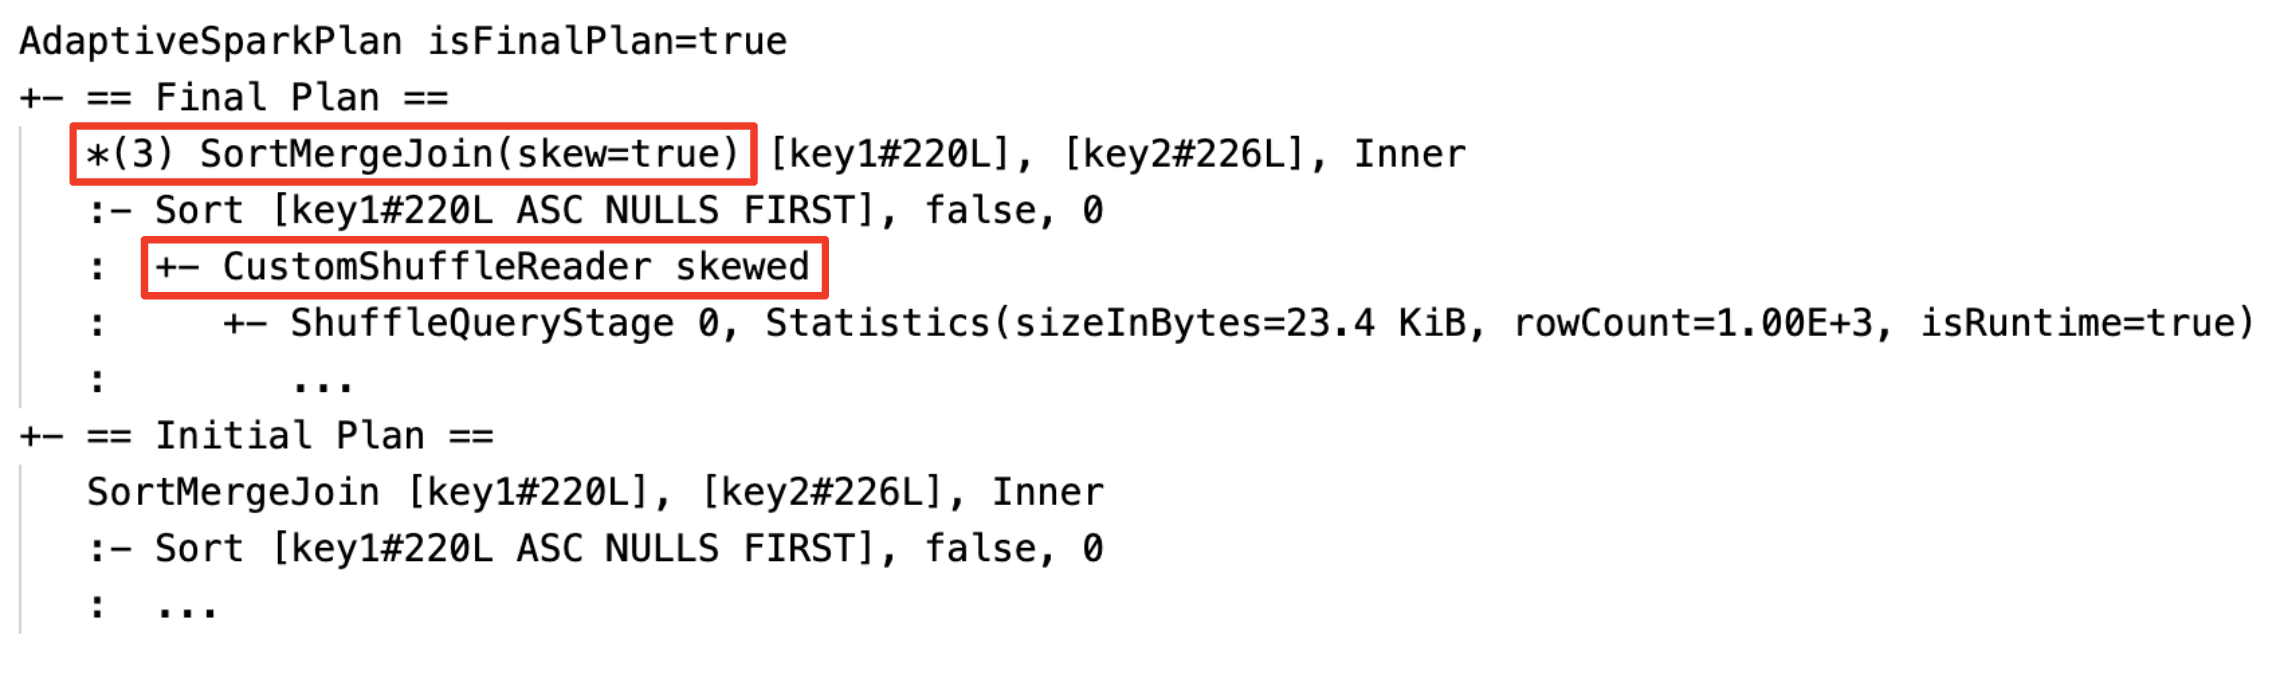
Manuseio de junção de distorção. O plano contém um nó
SortMergeJoincom o campoisSkewdefinido comotrue.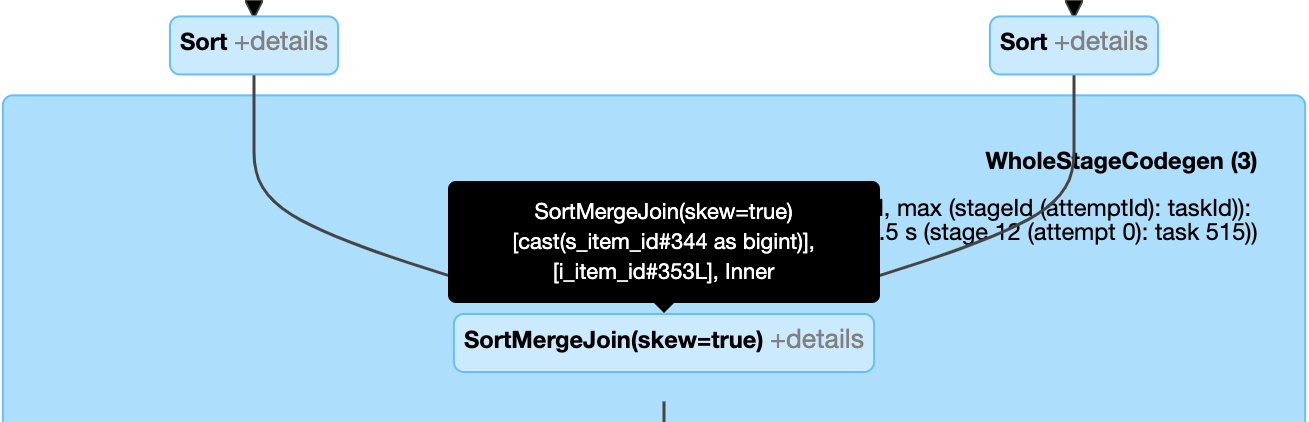
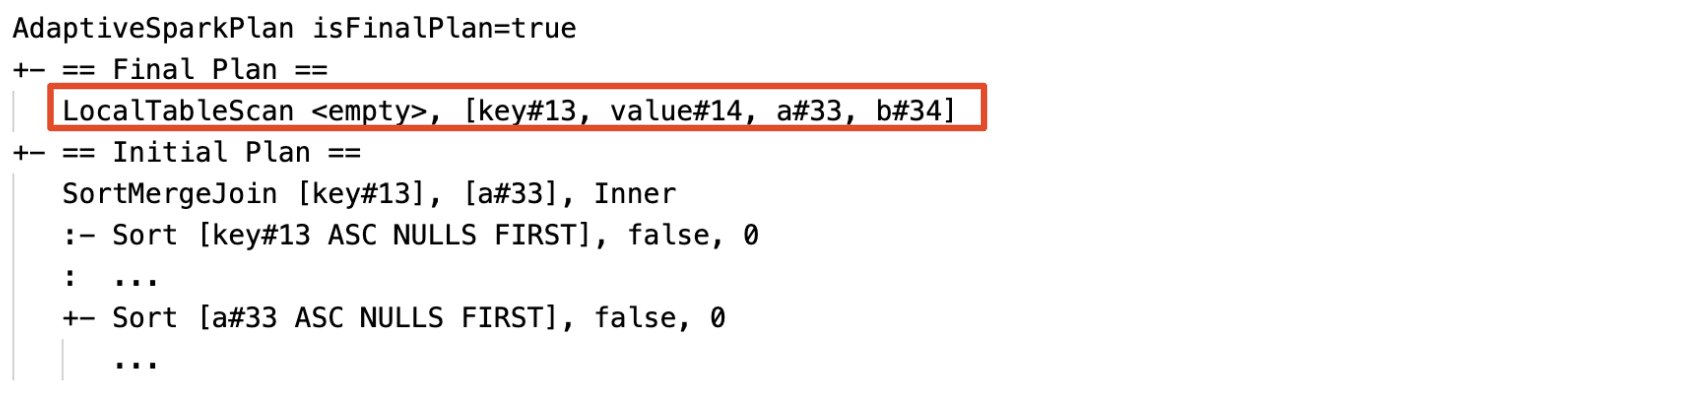
Propagação de relação vazia. Um
LocalTableScannó com campo de relação vazio substitui parte ou todo o plano.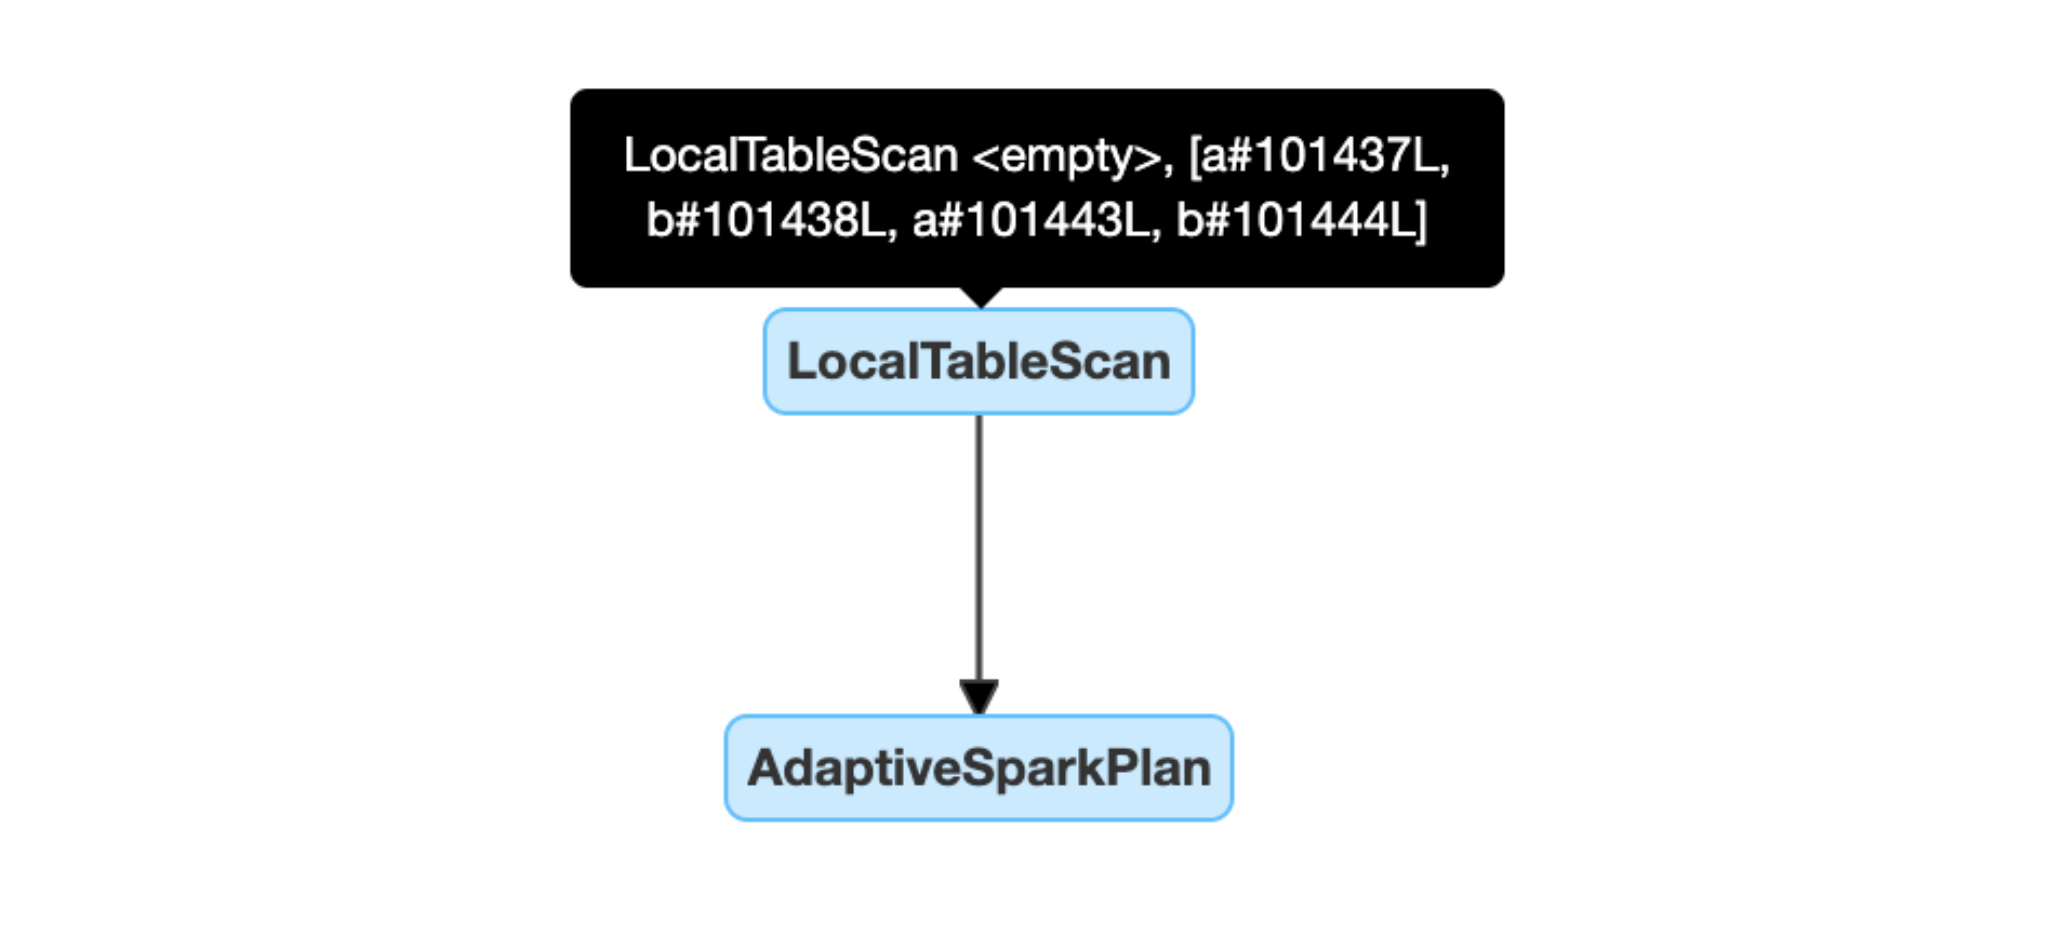
Configuração
Essas propriedades de configuração do Apache Spark controlam o AQE. A maioria das cargas de trabalho não precisa mudar as configurações padrão.
Habilitar o AQE e ajustar otimizações individuais
Use estas propriedades para ativar ou desativar o AQE e para ajustar o shuffle auto-otimizado, a alternância para broadcast join e a propagação de relações vazias:
| Propriedade | Tipo | Default | Descrição |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Ativa ou desativa a execução adaptativa de consultas. |
spark.sql.shuffle.partitions |
Integer |
200 |
O número padrão de partições a serem usadas ao embaralhar dados para junções ou agregações. Defina como auto para habilitar o embaralhamento automático otimizado, que define esse número com base no plano de consulta e no tamanho dos dados de entrada da consulta.Para Streaming Estruturado, você não pode alterar esse valor entre reinicios de consulta a partir do mesmo ponto de verificação. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
O limiar de tamanho para mudar uma junção sort-merge para uma junção de broadcast hash em tempo de execução. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Ativa ou desativa a propagação dinâmica de relações vazias. |
Unir partições dinamicamente
| Propriedade | Tipo | Default | Descrição |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Liga ou desliga a coalescência de partições. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
O tamanho do destino após a união. As partições coalescidas têm tamanho próximo deste, mas não maior do que esse tamanho. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
O tamanho mínimo das partições após a coalescagem. Partições coalescidas não são menores que esse tamanho. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
Duas vezes o número de núcleos de cluster | O número mínimo de partições após a coalescagem. Não defina essa propriedade, porque defini-la sobrescreve spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Manipular dinamicamente a junção de distorção
| Propriedade | Tipo | Default | Descrição |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Ativa ou desativa o processamento de junção de distorção. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
O multiplicador para o tamanho mediano da partição que uma partição deve exceder para ser considerada desbalanceada. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
O tamanho mínimo que uma partição deve exceder para que seja considerada desbalanceada. |
AQE trata uma partição como enviesada apenas quando ambas as condições são verdadeiras: (partition size > skewedPartitionFactor * median partition size) e (partition size > skewedPartitionThresholdInBytes).
Perguntas frequentes (FAQ)
Por que a AQE não transmitiu uma pequena tabela de junção?
Se a tabela for menor que spark.databricks.adaptive.autoBroadcastJoinThreshold mas a AQE não a transmite, verifique estas causas:
- O tipo de junção não suporta broadcast. Alguns tipos de junção não conseguem fazer broadcast de um dos lados. Por exemplo, o AQE não pode propagar o lado esquerdo de um
LEFT OUTER JOIN. - A tabela possui muitas partições vazias. A maioria das tarefas na junção sort-merge termina rapidamente, ou o tratamento de skew join otimiza a junção. O AQE não altera uma sort merge join para uma broadcast hash join se a porcentagem de partições não vazias for menor que
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
Devo ainda usar um Broadcast Join Hint com o AQE ativado?
Sim, se você conhece bem sua consulta. Uma junção broadcast que o otimizador planeja antes da consulta ser executada geralmente tem um desempenho melhor do que uma que o AQE planeja em tempo de execução. O AQE pode não mudar para uma junção de broadcast até depois de embaralhar ambos os lados da junção, que é quando aprende os tamanhos reais das tabelas.
O AQE respeita as dicas de consulta (query hints) da mesma forma que a otimização estática, e ainda aplica as otimizações dinâmicas que não são afetadas por essas dicas.
Devo usar a dica de skew join ou o manejo de skew join do AQE?
Use o tratamento de skew join do AQE. É automático e geralmente tem um desempenho melhor que o hint de skew join.
Por que a AQE não reordenou meus joins?
O AQE não reordena as junções em tempo de execução. Para melhorar a ordem de junção, colete estatísticas de tabela para que o otimizador baseado em custos possa escolher um plano melhor. Veja Otimizador baseado em custo.
Por que o AQE não detectou minha distorção de dados?
O AQE trata uma partição como desbalanceada apenas quando ambas as condições são verdadeiras:
- A partição é maior que
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(padrão256MB). - A partição é maior do que
spark.sql.adaptive.skewJoin.skewedPartitionFactor(valor padrão:5) vezes o tamanho mediano da partição.
O AQE também lida com skew apenas em joins baseados em embaralhamento, que são joins sort-merge e joins hash com shuffle. Ele nunca otimiza o skew nas junções de broadcast. Para joins baseados em embaralhamento, o tipo de join determina qual lado o AQE pode otimizar:
| Tipo de junção | Inclinação otimizada no lado esquerdo | Inclinação otimizada no lado direito |
|---|---|---|
INNER |
Sim | Sim |
CROSS |
Sim | Sim |
LEFT OUTER |
Sim | Não |
RIGHT OUTER |
Não | Sim |
LEFT SEMI |
Sim | Não |
LEFT ANTI |
Sim | Não |
FULL OUTER |
Não | Não |
Legado
O Spark 1.6 introduziu um recurso chamado execução adaptativa, mas o AQE no Spark 3.0 é um recurso diferente. A execução adaptativa do Spark 1.6 apenas une partições dinamicamente. AQE é um framework que planeja e replaneja consultas com base em estatísticas de tempo de execução, e suporta todas as otimizações desta página.