Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Aplica-se a: SQL ServerBanco de Dados SQL do AzureInstância Gerenciada de SQL do AzureBanco de dados SQL no Microsoft Fabric
O Mecanismo de Banco de Dados do SQL Server processa consultas em diversas arquiteturas de armazenamento de dados, como tabelas locais, particionadas e distribuídas entre vários servidores. As seções a seguir abordam como o Mecanismo de Banco de Dados processa consultas e otimiza a reutilização de consultas por meio do cache do plano de execução.
Os exemplos de código neste artigo usam o AdventureWorks2025, AdventureWorksDW2025, ou AdventureWorksLT2025 banco de dados de exemplo, que você pode baixar do repositório GitHub do Azure Data SQL Samples Repository.
Modos de execução
O Mecanismo de Banco de Dados do SQL Server pode processar instruções Transact-SQL (T-SQL) usando dois modos de processamento distintos:
- Execução em modo de linha
- Execução em modo de lote
Execução em modo de linha
Execução em modo linha é um método de processamento de consultas usado com tabelas e índices de rowstore, onde os dados são armazenados em formato de linha. Quando uma consulta é executada e acessa dados em tabelas e índices de rowstore, os operadores da árvore de execução e os operadores filhos leem cada linha necessária, em todas as colunas especificadas no esquema do objeto. A partir de cada linha lida, o Mecanismo de Banco de Dados então recupera as colunas necessárias para o conjunto de resultados, conforme referenciado por uma SELECT instrução, JOIN predicado ou predicado de filtro.
Observação
A execução em modo linha é muito eficiente para cenários OLTP, mas pode ser menos eficiente ao escanear grandes volumes de dados, por exemplo, em cenários de Data Warehousing.
Execução em modo de lote
A execução em modo batch é um método de processamento de consultas que processa múltiplas linhas juntas (daí o termo batch). Cada coluna em um lote é armazenada como um vetor em uma área separada da memória, de modo que o processamento em modo de lote é baseado em vetor. O processamento em modo lote também utiliza algoritmos otimizados para conjuntos avançados de instruções e aumento do throughput de memória em processadores modernos.
A execução em modo batch foi originalmente integrada e otimizada em torno do formato de armazenamento columnstore. A partir do SQL Server 2019 (15.x) e no Banco de Dados SQL do Azure, a execução em modo batch não exige índices de column store. Para saber mais, confira Modo de lote em rowstore.
O processamento em modo de lote opera nos dados compactados quando possível e elimina o operador de troca usado pela execução em modo de linha. O resultado é um melhor paralelismo e um desempenho mais rápido.
Quando uma consulta é executada em modo batch e acessa dados em índices de column store, os operadores da árvore de execução e os operadores filhos leem múltiplas linhas juntas em segmentos de coluna. O Mecanismo de Banco de Dados lê apenas as colunas necessárias para o resultado, conforme referenciado por uma SELECT instrução, JOIN predicado ou predicado de filtro. Para mais informações sobre índices columnstore, veja Arquitetura de Índice Columnstore.
Observação
A execução em modo batch é muito eficiente para cenários de data warehousing, onde pode ler e agregar grandes quantidades de dados.
Processamento de instruções SQL
Processar uma única instrução T-SQL é a forma mais básica pela qual o Mecanismo de Banco de Dados executa as instruções T-SQL. Os passos a seguir ilustram o processo básico processando uma única SELECT instrução que faz referência apenas a tabelas base locais (sem views ou tabelas remotas).
Precedência de operador lógico
Quando você usa mais de um operador lógico em uma instrução, NOT é avaliado primeiro, depois AND e, por fim, OR. Operadores aritméticos e bit a bit são tratados antes dos operadores lógicos. Para obter mais informações, consulte Precedência de operador.
No exemplo a seguir, a condição de cor se aplica ao modelo de produto 21, e não ao modelo de produto 20, pois AND tem precedência sobre OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Usar parênteses, mesmo quando não são obrigatórias, pode melhorar a legibilidade das consultas e reduzir a chance de cometer um erro devido à precedência do operador. O exemplo a seguir é mais legível que o anterior e tem o mesmo significado.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Você pode alterar o significado da consulta adicionando parênteses para forçar a avaliação de OR primeiro. A consulta a seguir só encontra produtos nos modelos 20 e 21 que são vermelhos.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Otimizar instruções SELECT
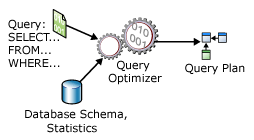
Uma instrução SELECT não é processual; ela não determina as etapas exatas que o servidor de banco de dados deve usar para recuperar os dados solicitados. Esse comportamento declarativo significa que o servidor de banco de dados deve analisar a instrução e o banco de dados para determinar a forma mais eficiente de extrair os dados solicitados. Esse processo é chamado de otimização do plano de consulta. O componente que realiza essa tarefa é o Otimizador de Consultas. A entrada do Otimizador de Consultas consiste na consulta, o esquema do banco de dados (definições de objetos) e as estatísticas dos objetos. A saída do Otimizador de Consultas é um plano de execução de consulta, às vezes chamado de plano de consulta ou plano de execução. O conteúdo de um plano de execução é descrito com mais detalhes em Cache e reutilização de plano de execução.
O diagrama a seguir ilustra as entradas e saídas do Query Optimizer durante a otimização de uma única instrução SELECT:
Uma instrução SELECT define apenas:
- O formato do conjunto de resultados. Isso é especificado principalmente na lista de seleção. Porém, outras cláusulas como
ORDER BYeGROUP BYtambém afetam a forma final do conjunto de resultados. - As tabelas que contêm os dados de origem. Isso é especificado na cláusula
FROM. - A forma pela qual as tabelas estão logicamente relacionadas à finalidade da instrução
SELECT. Isso é definido na expressão join, que pode aparecer naWHEREcláusula ou em umaONcláusula apósFROM. - As condições que as linhas das tabelas de origem devem satisfazer para serem qualificadas para a instrução
SELECT. Essas são especificadas nas cláusulasWHEREeHAVING.
Um plano de execução de consulta define:
A sequência em que as tabelas de origem são acessadas.
Normalmente, o servidor de banco de dados pode acessar as tabelas base em várias sequências para construir o conjunto de resultados. Por exemplo, se a instrução
SELECTfizesse referência a três tabelas, o servidor de banco de dados poderia acessarTableAprimeiro, usar os dados deTableApara extrair as linhas correspondentes deTableBe usar os dados deTableBpara extrair dados deTableC. As outras sequências em que o servidor de banco de dados poderia acessar as tabelas são:TableC,TableB,TableA, ou
TableB,TableA,TableC, ou
TableB,TableC,TableA, ou
TableCTableA,TableBOs métodos usados para extrair dados de cada tabela.
Geralmente, há métodos diferentes para acessar os dados em cada tabela. Se forem necessárias apenas algumas linhas com valores de chave específicos, o servidor de banco de dados pode rapidamente consultar linhas ou escanear um pequeno intervalo de índice. Se todas as linhas da tabela forem necessárias, o servidor de banco de dados pode, em vez disso, escanear toda a tabela ou todo o índice. Se todas as linhas de uma tabela forem necessárias, mas houver um índice cujas colunas-chave estejam em um
ORDER BY, realizar uma varredura de índice em vez de uma varredura de tabela pode evitar uma ordenação separada do conjunto de resultados. Se uma tabela for muito pequena, varreduras completas podem ser o método mais eficiente para quase todo o acesso à tabela.Os métodos usados para computar cálculos e como filtrar, agregar e classificar dados de cada tabela.
À medida que os dados são acessados a partir de tabelas, diferentes métodos realizam cálculos sobre dados, como cálculos de valores escalares, e agregam e ordenam os dados conforme definido no texto da consulta. Por exemplo, ao usar uma cláusula
GROUP BYou uma cláusulaORDER BY, e como filtrar dados, por exemplo, ao usar uma cláusulaWHEREou uma cláusulaHAVING.
O processo de selecionar um plano de execução de muitos planos possíveis é chamado de otimização. O Otimizador de Consulta é um dos componentes mais importantes do Mecanismo de Banco de Dados. Embora o Otimizador de Consultas use alguma sobrecarga para analisar a consulta e selecionar um plano, esse custo geralmente é compensado várias vezes quando o Otimizador de Consultas escolhe um plano de execução eficiente. Por exemplo, duas empresas de construção podem oferecer projetos idênticos para uma casa. Se uma empresa dedica alguns dias no início para planejar como construir a casa, e a outra começa a construir sem planejamento, provavelmente a empresa que dedica tempo para planejar o projeto termina primeiro.
O Otimizador de Consultas é um otimizador baseado em custo. Cada plano de execução possível tem um custo associado em termos de quantidade de recursos de computação usados. O otimizador de consulta deve analisar os possíveis planos e escolher o que tenha o menor custo estimado. Algumas declarações complexas têm milhares de possíveis planos de execução. Nesses casos, o Otimizador de Consulta não analisa todas as combinações possíveis. Em vez disso, usa algoritmos complexos para encontrar um plano de execução que tenha um custo razoavelmente próximo do custo mínimo possível.
O Otimizador de Consultas não necessariamente escolhe o plano de execução com o menor custo estimado. Ele encontra um plano com um custo estimado razoável dentro do tempo disponível para otimização. Um plano de execução paralelo pode usar mais recursos do que um plano serial, reduzindo o tempo estimado decorrido.
O SQL Server Query Optimizer baseia-se em estatísticas ao estimar os custos de recursos de diferentes métodos para extrair informações de uma tabela ou índice. As estatísticas são mantidas para colunas e índices, e contêm informações sobre a densidade1 dos dados subjacentes. Essas informações indicam a seletividade dos valores em um índice ou coluna específica. Por exemplo, em uma tabela que representa carros, muitos carros têm o mesmo fabricante, mas cada carro tem um VIN (número de identificação de veículo) exclusivo. Um índice no VIN é mais seletivo que um índice no fabricante, porque o VIN tem densidade menor que o fabricante. Se as estatísticas de índice não forem atuais, o otimizador de consulta poderá não fazer a melhor escolha para o estado atual da tabela. Para saber mais sobre densidades, confira Estatísticas.
1 A densidade define a distribuição de valores únicos que existem nos dados ou o número médio de valores duplicados para uma determinada coluna. Conforme a densidade diminui, aumenta a seletividade de um valor.
O Query Optimizer é importante porque permite que o servidor de banco de dados se ajuste dinamicamente às condições mutáveis do banco de dados, sem precisar de intervenção de um desenvolvedor ou administrador de banco de dados. Esse recurso permite que os desenvolvedores se concentrem em descrever o resultado final da consulta. Eles podem confiar no Otimizador de Consultas para construir um plano de execução eficiente para o estado do banco de dados toda vez que o plano de consulta de uma instrução for otimizado.
Observação
O SQL Server Management Studio tem três opções para exibir planos de execução:
- O Plano de Execução Estimado, que é o plano compilado, conforme produzido pelo Otimizador de Consultas.
- O Plano de Execução Real, que é o mesmo que o plano compilado mais seu contexto de execução. Esse contexto inclui informações de tempo de execução disponíveis após a conclusão da execução, como avisos de execução, ou em versões mais recentes do Mecanismo de Banco de Dados, o tempo decorrido e o tempo de CPU usado durante a execução.
- As Estatísticas de Consulta Dinâmica, que são o mesmo que o plano compilado, mais o contexto de execução. Esse contexto inclui informações de tempo de execução durante o progresso da execução e é atualizado a cada segundo. Informações em tempo de execução incluem, por exemplo, o número real de linhas que passam pelos operadores.
Processar uma instrução SELECT
O Mecanismo de Banco de Dados processa uma única SELECT instrução seguindo estes passos:
- O analisador examina a instrução
SELECTe a divide em unidades lógicas, como palavras-chave, expressões, operadores e identificadores. - Uma árvore de consulta, às vezes chamada de árvore de sequência, é construída descrevendo os passos lógicos necessários para transformar os dados de origem no formato exigido pelo conjunto de resultados.
- O Otimizador de Consultas analisa diferentes formas de acessar as tabelas de origem. Ele seleciona a série de etapas que retorna os resultados mais rapidamente, usando menos recursos. Ele atualiza a árvore de consultas para registrar exatamente essa série de etapas. A versão final, otimizada da árvore de consulta é chamada de plano de execução.
- O motor relacional começa a executar o plano. À medida que processa etapas que precisam de dados das tabelas base, solicita os conjuntos de linhas necessários do mecanismo de armazenamento.
- O mecanismo relacional processa os dados retornados do mecanismo de armazenamento no formato definido para o conjunto de resultados e retorna o conjunto de resultados ao cliente.
Dobramento constante e avaliação de expressão
O mecanismo de banco de dados avalia algumas expressões constantes antecipadamente para aprimorar o desempenho de consulta. Essa técnica de otimização usada pelo Otimizador de Consultas visa simplificar expressões em tempo de compilação, e não em tempo de execução. Envolve avaliar expressões constantes durante a compilação de consulta para que o plano de execução resultante seja mais eficiente. Esse processo é chamado de constant folding. Uma constante é um literal T-SQL, como 3, 'ABC', '2025-12-31', 1.0e3, ou 0x12345678. Por exemplo, veja esta consulta:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Aqui, 30 * 12 é uma expressão constante. O Mecanismo de Banco de Dados avalia essa expressão durante a compilação e pode reescrever internamente a consulta como:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Expressões dobráveis
O Mecanismo de Banco de Dados utiliza folding constante com os seguintes tipos de expressões:
- Expressões aritméticas, como
1 + 1e5 / 3 * 2, que contêm apenas constantes. - Expressões lógicas, como
1 = 1e1 > 2 AND 3 > 4, que contêm apenas constantes. - Funções embutidas que o Mecanismo de Banco de Dados considera passíveis de folding, incluindo
CASTeCONVERT. Geralmente, uma função intrínseca é passível de folding se for função apenas de suas entradas e não de outras informações contextuais, comoSETopções, configurações de idioma, opções de banco de dados e chaves de criptografia. Funções não determinísticas não são dobráveis. Funções internas determinísticas são dobráveis, com algumas exceções. - Métodos determinísticos de tipos CLR definidos pelo usuário e funções CLR determinísticas definidas pelo usuário com valor escalar. Para saber mais, veja Dobra constante para funções e métodos de CLR definidos pelo usuário.
Observação
Há uma exceção para tipos de objeto grandes. Se o tipo de saída do processo de folding for um tipo de objeto grande (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json ou xml), o Mecanismo de Banco de Dados não reduz a expressão.
Expressões não dobráveis
Todos os outros tipos de expressão são não dobráveis. Especificamente, os tipos seguintes de expressões não são dobráveis:
- Expressões não constantes, cujo resultado depende do valor de uma coluna.
- Expressões cujos resultados dependem de um variável local ou parâmetro, como
@x. - Funções não determinísticas.
- Funções T-SQL definidas pelo usuário.
- Expressões cujos resultados dependem de configurações de idioma.
- Expressões cujos resultados dependem das opções
SET. - Expressões cujos resultados dependem de opções de configuração do servidor.
Exemplos de expressões de constantes dobráveis e não desdobráveis
Considere a consulta a seguir:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Se a opção do banco de dados PARAMETERIZATION não estiver definida para FORCED para esta consulta, a expressão 117.00 + 1000.00 é avaliada e substituída por seu resultado, 1117.00, antes que a consulta seja compilada. Os benefícios dessa dobra constante incluem:
- A expressão não precisa ser avaliada repetidamente em tempo de execução.
- O valor da expressão após sua avaliação é usado pelo Otimizador de Consultas para estimar o tamanho do conjunto de resultados da parte da consulta
TotalDue > 117.00 + 1000.00.
Por outro lado, se dbo.f é uma função escalar definida pelo usuário, a expressão dbo.f(100) não é simplificada, porque o Mecanismo de Banco de Dados não simplifica expressões que envolvem funções definidas pelo usuário, mesmo que sejam determinísticas. Para mais informações sobre parametrização, veja Parametrização forçada.
Avaliação de expressão
Além disso, algumas expressões que não são constantes desdobráveis, mas cujos argumentos são conhecidos no tempo de compilação, sejam esses argumentos parâmetros ou constantes, são avaliadas pelo avaliador de tamanho do conjunto de resultados (cardinalidade) que é parte do otimizador durante a otimização.
Especificamente, serão avaliados as seguintes funções internas e operadores especiais em tempo de compilação se todas as suas entradas forem conhecidas: UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CAST e CONVERT. Os seguintes operadores também serão avaliados em tempo de compilação se todas as suas entradas forem conhecidas:
- Operadores aritméticos:
+,-,*,/, unário- - Operadores lógicos:
AND,OR,NOT - Operadores de comparação:
IS NULL,<>,LIKE,>=,<=,>,<,IS NOT NULL
Nenhuma outra função ou operador será avaliada pelo Otimizador de Consulta durante a estimativa de cardinalidade.
Exemplos de avaliação de expressões em tempo de compilação
Considere este procedimento armazenado:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Durante a otimização da instrução SELECT no procedimento, o Otimizador de Consulta tenta avaliar a cardinalidade esperada do conjunto de resultados para a condição OrderDate > @d + 1. A expressão @d + 1 não é dobrada constantemente, porque @d é um parâmetro. Entretanto, no momento da otimização, o valor do parâmetro é conhecido. Esse valor permite que o Otimizador de Consultas estime com precisão o tamanho do conjunto de resultados, o que ajuda a selecionar um bom plano de consulta.
Agora considere um exemplo semelhante ao anterior, exceto que uma variável @d2 local substitui @d + 1 na consulta e a expressão é avaliada em uma SET instrução em vez de na consulta.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Quando a SELECT instrução em MyProc2 é otimizada no Mecanismo de Banco de Dados, o valor de @d2 não é conhecido. Portanto, o Otimizador de Consultas usa uma estimativa padrão para a seletividade de OrderDate > @d2 (neste caso, 30 por cento).
Processar outras declarações
Os passos básicos para processar uma SELECT instrução se aplicam a outras instruções T-SQL como INSERT, UPDATE, e DELETE. As instruções UPDATE e DELETE devem ter como alvo o conjunto de linhas a serem modificadas ou excluídas. O processo de identificação dessas linhas é o mesmo processo usado para identificar as linhas de origem que contribuem para o conjunto de resultados de uma instrução SELECT . Ambas as instruções UPDATE e INSERT podem conter instruções SELECT integradas que fornecem os valores de dados a serem atualizados ou inseridos.
Mesmo instruções de Linguagem de Definição de Dados (DDL), como CREATE PROCEDURE ou ALTER TABLE, resolvem para uma série de operações relacionais nas tabelas de catálogo do sistema e, às vezes, (como ALTER TABLE ADD COLUMN) contra as tabelas de dados.
Tabelas de trabalho
O mecanismo relacional pode precisar construir uma tabela de trabalho para realizar uma operação lógica especificada em uma instrução T-SQL. As tabelas de trabalho são tabelas internas que armazenam resultados intermediários. As tabelas de trabalho são geradas para determinadas consultas GROUP BY, ORDER BYou UNION . Por exemplo, se uma ORDER BY cláusula faz referência a colunas que não são cobertas por nenhum índice, o motor relacional pode precisar gerar uma tabela de trabalho para ordenar o conjunto de resultados na ordem solicitada. Algumas vezes as tabelas de trabalho também são usadas como spools que mantêm temporariamente o resultado da execução de uma parte de um plano de consulta. As mesas de trabalho são criadas em tempdb e depois removidas automaticamente quando não são mais necessárias.
Resolução de exibição
O processador de consultas do Mecanismo de Banco de Dados trata as exibições indexadas e não indexadas de forma diferente:
- O banco de dados armazena as linhas de uma visualização indexada no mesmo formato de uma tabela. Se o Otimizador de Consultas decidir usar uma visualização indexada em um plano de consulta, ele trata a visualização indexada da mesma forma que uma tabela base.
- Somente a definição de uma exibição não indexada é armazenada, e não as linhas da exibição. O Query Optimizer incorpora a lógica da definição de view no plano de execução que constrói para a instrução T-SQL que faz referência à view não indexada.
A lógica que o Otimizador de Consultas usa para decidir quando usar uma visualização indexada é semelhante à lógica que ele usa para decidir quando usar um índice em uma tabela. Se os dados na visualização indexada cobrirem total ou parte da instrução T-SQL, e o Otimizador de Consultas determinar que um índice na visualização é o caminho de acesso de baixo custo, ele escolhe o índice independentemente de a consulta referenciar a visualização pelo nome.
Quando uma instrução T-SQL referencia uma exibição não indexada, o analisador e o otimizador de consulta analisam a origem da instrução T-SQL e a exibição. Depois, as resolvem em um único plano de execução. A instrução T-SQL e a view não têm planos separados.
Por exemplo, considere a seguinte exibição:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Com base nessa visão, ambas essas instruções T-SQL realizam as mesmas operações nas tabelas base e produzem os mesmos resultados:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
O recurso Showplan do SQL Server Management Studio (SSMS) mostra que o motor relacional constrói o mesmo plano de execução para ambas as SELECT instruções.
Usar dicas com exibições
Se você colocar dicas em views em uma consulta, elas podem entrar em conflito com outras dicas descobertas quando a view se expande para acessar suas tabelas base. Quando esse conflito ocorre, a consulta retorna um erro. Por exemplo, considere a seguinte exibição que contém uma dica de tabela em sua definição:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Agora suponha que você insira esta consulta:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
A consulta falha porque a dica SERIALIZABLE na visualização Person.AddrState se propaga para as tabelas Person.Address e Person.StateProvince na visualização quando ela é expandida. No entanto, a expansão da exibição também revela a dica NOLOCK em Person.Address. Como há conflito das dicas SERIALIZABLE e NOLOCK , a consulta resultante está incorreta.
As dicas de tabela PAGLOCK, NOLOCK, ROWLOCK, TABLOCK e TABLOCKX entram em conflito umas com as outras, assim como as dicas de tabela HOLDLOCK, NOLOCK, READCOMMITTED, REPEATABLEREAD e SERIALIZABLE.
As dicas podem ser propagadas pelos níveis de exibições aninhadas. Por exemplo, suponha que uma consulta aplique a dica HOLDLOCK em uma visualização v1. Quando v1 é expandido, você percebe que essa view v2 faz parte de sua definição. A definição dev2 inclui uma dica NOLOCK em uma de suas tabelas base. Mas essa tabela também herda a dica HOLDLOCK da consulta na exibição v1. Como há conflito nas dicas NOLOCK e HOLDLOCK, há falha na consulta.
Quando você usa a dica FORCE ORDER em uma consulta que contém uma view, a posição da view no construto ordenado determina a ordem de junção das tabelas dentro da view. Por exemplo, a seguinte consulta faz a seleção a partir de três tabelas e uma exibição:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
E View1 é definido conforme mostrado no exemplo a seguir:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
A ordem de junção no plano de consulta é Table1, Table2, TableA, TableB, Table3.
Resolver índices em exibições
Como em qualquer índice, o Mecanismo de Banco de Dados escolhe usar uma visualização indexada em seu plano de consulta somente se o Otimizador de Consultas considerar benéfico fazê-lo.
Você pode criar visualizações indexadas em qualquer edição do Mecanismo de Banco de Dados. Em algumas edições, o Query Optimizer considera automaticamente a exibição indexada, enquanto em outras edições você precisa usar a dica de tabela NOEXPAND. O uso automático de uma visualização indexada pelo Otimizador de Consultas é suportado apenas em edições específicas do SQL Server.
Observação
O Banco de Dados SQL do Azure e a Instância Gerenciada de SQL do Azure oferecem suporte ao uso automático de exibições indexadas sem a necessidade de especificar a dica NOEXPAND.
O Query Optimizer utiliza uma exibição indexada quando as seguintes condições são atendidas:
- Estas opções de sessão são definidas como
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- A
NUMERIC_ROUNDABORTopção de sessão está definida comoOFF. - O Otimizador de Consultas encontra uma correspondência entre as colunas do índice da visualização e os elementos da consulta, tais como:
- Predicados de condição de busca na
WHEREcláusula - Operações de união
- Funções de agregação
- Cláusulas
GROUP BY - Referências de tabela
- Predicados de condição de busca na
- O custo estimado do uso do índice é o custo mais baixo de qualquer mecanismo de acesso considerado pelo otimizador de consulta.
- Toda tabela referenciada na consulta (diretamente ou ao expandir uma exibição para acessar suas tabelas subjacentes) que corresponde a uma referência de tabela na exibição indexada deve ter o mesmo conjunto de dicas aplicado na consulta.
Observação
As dicas READCOMMITTED e READCOMMITTEDLOCK são sempre consideradas dicas diferentes nesse contexto, independentemente do nível de isolamento da transação atual.
Diferentemente dos requisitos das opções SET e dicas de tabela, essas são as mesmas regras que o otimizador de consulta usa para determinar se um índice de tabela abrange uma consulta. Você não precisa especificar mais nada na consulta para que uma visualização indexada seja usada.
Uma consulta não precisa fazer referência explícita a uma exibição indexada na cláusula FROM para que o Otimizador de Consulta use a exibição indexada. Se a consulta tiver referências a colunas nas tabelas base, que também estão presentes na exibição indexada, e o otimizador de consulta estimar que o uso da exibição indexada fornecerá o menor custo de mecanismo de acesso, o otimizador de consulta escolherá a exibição indexada, semelhante ao modo pelo qual escolhe índices de tabela base quando eles não são referenciados diretamente em uma consulta. O otimizador de consulta pode escolher a exibição quando ela contém colunas que não são referenciadas pela consulta, contanto que a exibição ofereça a opção de menor custo para cobrir uma ou mais das colunas especificadas na consulta.
O otimizador de consulta trata uma exibição indexada referenciada na cláusula FROM como uma exibição padrão. O otimizador de consulta expande a definição da exibição da consulta no início do processo de otimização. Depois, a correspondência da exibição indexada é executada. A exibição indexada pode ser usada no plano de execução final selecionado pelo Otimizador de Consulta ou, em vez disso, o plano pode materializar os dados necessários da exibição acessando as tabelas base referenciadas pela exibição. O Otimizador de Consulta escolhe a alternativa de menor custo.
Usar dicas com exibições indexadas
Você pode evitar que os índices de exibições sejam usados para uma consulta usando a dica de consulta EXPAND VIEWS . Ou, então, pode usar a dica de tabela NOEXPAND para forçar o uso de um índice para uma exibição indexada especificada na cláusula FROM de uma consulta. Porém, deve deixar o otimizador de consulta determinar dinamicamente os melhores métodos de acesso a serem usados para cada consulta. Limite seu uso de EXPAND e NOEXPAND a casos específicos em que os testes têm mostrado que melhoram o desempenho consideravelmente.
A opção
EXPAND VIEWSespecifica que o otimizador de consulta não usa nenhum índice de exibição para a consulta inteira.Quando você especifica
NOEXPANDpara uma visualização, o Otimizador de Consultas considera usar quaisquer índices definidos na visualização.NOEXPANDespecificado com a cláusula opcionalINDEX()força o Otimizador de Consulta a usar os índices especificados. Você pode especificarNOEXPANDapenas para um modo de exibição indexado e não pode especificá-lo para um modo de exibição que não está indexado. O uso automático de uma visualização indexada pelo Otimizador de Consultas é suportado apenas em edições específicas do SQL Server.Observação
O Banco de Dados SQL do Azure e a Instância Gerenciada de SQL do Azure oferecem suporte ao uso automático de exibições indexadas sem a necessidade de especificar a dica
NOEXPAND.
Quando NOEXPAND ou EXPAND VIEWS não é especificado em uma consulta que contém uma exibição, a exibição é expandida para acessar as tabelas subjacentes. Se a consulta que compõe a exibição tiver quaisquer dicas de tabela, as dicas serão propagadas às tabelas subjacentes. (Esse processo é explicado com mais detalhes em Resolução de exibição.) Contanto que o conjunto de dicas existente nas tabelas subjacentes da exibição sejam idênticos, a consulta será elegível para ser correspondida a uma exibição indexada. Na maioria das vezes, essas dicas coincidem entre si, porque são herdadas diretamente da view. No entanto, se a consulta referenciar tabelas em vez de exibições e as dicas aplicadas diretamente nessas tabelas não forem idênticas, a consulta não será elegível para correspondência com uma exibição indexada. Se as dicas INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCK ou XLOCK forem aplicadas às tabelas referenciadas na consulta depois da expansão da exibição, a consulta não será elegível para a correspondência da exibição indexada.
Se uma dica de tabela na forma de referências INDEX ( index_val [ ,...n] ) for uma exibição em uma consulta e você também não especificar a dica NOEXPAND, a dica de índice será ignorada. Para especificar o uso de um determinado índice, use NOEXPAND.
Geralmente, quando o Otimizador de Consulta corresponde uma exibição indexada a uma consulta, ele aplica as dicas especificadas nas tabelas ou exibições da consulta diretamente à exibição indexada. Se o Otimizador de Consulta optar por não usar uma exibição indexada, ele propagará qualquer dica diretamente às tabelas referenciadas na exibição. Para obter mais informações, consulte Resolução de exibição. Essa propagação não se aplica a dicas de junção. Elas são aplicadas somente em sua posição original na consulta. O Otimizador de Consultas não considera dicas de junção ao combinar consultas com visualizações indexadas. Se um plano de consulta usa uma exibição indexada que corresponde a parte de uma consulta que contém uma dica de junção, a dica de junção não é usada no plano.
Não são permitidas pistas nas definições de exibições indexadas. O Mecanismo de Banco de Dados ignora dicas de consulta dentro das definições de visualização indexada ao mantê-las ou ao executar consultas que utilizam visualizações indexadas.
Para obter mais informações, consulte Dicas de Tabela.
Solucionar visões particionadas distribuídas
O processador de consultas do Mecanismo de Banco de Dados otimiza o desempenho de visualizações particionadas distribuídas. O aspecto mais importante de desempenho de exibição particionada distribuída é minimizar a quantidade de dados transferida entre servidores membro.
O Mecanismo de Banco de Dados constrói planos inteligentes e dinâmicos que fazem uso eficiente de consultas distribuídas para acessar dados de tabelas membro remotas:
- O Processador de Consultas usa o OLE DB primeiro para recuperar as definições de restrição de verificação de cada tabela de membro. Esse método permite ao processador de consultas mapear a distribuição de valores da chave entre as tabelas de membro.
- O Processador de Consultas compara os intervalos de chaves especificados em uma cláusula de instrução
WHERET-SQL com o mapa que mostra como as linhas são distribuídas nas tabelas membro. O processador de consultas então constrói um plano de execução de consultas que utiliza consultas distribuídas para recuperar apenas aquelas linhas remotas necessárias para completar a instrução T-SQL. O plano de execução também é criado de forma que qualquer acesso a tabelas de membro remoto, tanto para dados quanto para metadados, seja adiado até as informações serem exigidas.
Por exemplo, considere um sistema em que uma tabela Customers é particionada entre Server1 (CustomerID de 1 até 3299999), Server2 (CustomerID de 3300000 até 6599999) e Server3 (CustomerID de 6600000 até 9999999).
Considere o plano de execução criado para esta consulta executada em Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
O plano de execução para esta consulta extrai as linhas com valores da chave CustomerID de 3200000 até 3299999 da tabela de membro local, e emite uma consulta distribuída para recuperar as linhas com valores da chave de 3300000 até 3400000 do Server2.
O Mecanismo de Banco de Dados Query Processor também pode construir lógica dinâmica em planos de execução de consultas para instruções T-SQL, nas quais os valores-chave não são conhecidos quando o plano deve ser construído. Por exemplo, considere este procedimento armazenado:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
O Mecanismo de Banco de Dados não consegue prever qual valor de chave é fornecido pelo @CustomerIDParameter parâmetro toda vez que o procedimento é executado. Como o valor da chave não pode ser previsto, o processador de consulta também não pode prever qual tabela de membros deve acessar. Para lidar com esse caso, o Mecanismo de Banco de Dados constrói um plano de execução que possui lógica condicional, chamada filtros dinâmicos, para controlar qual tabela membro é acessada, com base no valor do parâmetro de entrada. Assumindo que o GetCustomer procedimento armazenado foi executado no Server1, a lógica do plano de execução pode ser representada conforme mostrado na seguinte saída:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
O Mecanismo de Banco de Dados às vezes constrói esse tipo de plano de execução dinâmica até mesmo para consultas que não são parametrizadas. O Otimizador de Consulta pode parametrizar uma consulta para que o plano de execução possa ser reutilizado. Se o Otimizador de Consultas parametriza uma consulta referenciando uma exibição particionada, o Otimizador de Consultas não pode mais assumir que as linhas necessárias vêm de uma tabela base especificada. Depois, ele precisa usar filtros dinâmicos no plano de execução.
Procedimento armazenado e execução de gatilho
O Mecanismo de Banco de Dados armazena apenas o código-fonte para procedimentos armazenados e gatilhos. Quando um procedimento armazenado ou disparador é executado primeiro, a origem é compilada em um plano de execução. Se o procedimento armazenado ou o disparador for executado novamente antes de o plano de execução envelhecer na memória, o mecanismo relacional detectará o plano existente e o reutilizará. Se o plano envelhecer fora da memória, um plano novo será criado. Esse processo é semelhante ao que o Mecanismo de Banco de Dados segue para todas as instruções T-SQL. A principal vantagem de desempenho que procedimentos armazenados e triggers têm no Mecanismo de Banco de Dados em comparação com lotes de T-SQL dinâmico é que suas instruções T-SQL são sempre as mesmas. Portanto, o mecanismo relacional as corresponde facilmente com qualquer plano de execução existente. Os planos de procedimentos armazenados e gatilhos são reutilizados facilmente.
O plano de execução de procedimentos armazenados e disparadores é executado separadamente do plano de execução do lote que chama o procedimento armazenado ou aciona o disparador. Essa separação permite uma maior reutilização dos planos de execução de procedimentos armazenados e de gatilhos.
Cache e reutilização do plano de execução
O Mecanismo de Banco de Dados usa memória para armazenar tanto planos de execução quanto buffers de dados. A porcentagem de memória alocada a planos de execução ou buffers de dados é ajustada dinamicamente, dependendo do estado do sistema. A parte da memória que armazena planos de execução é chamada de cache de planos.
Repositórios de cache de planos
O cache de planos tem dois repositórios para todos os planos compilados:
- O armazenamento de cache dos Planos de Objetos (OBJCP), para planos relacionados a objetos persistentes, como procedimentos armazenados, funções e gatilhos.
- O repositório de cache (SQLCP) de Planos do SQL, para os planos relacionados a consultas parametrizadas automaticamente, dinâmicas ou preparadas.
A consulta a seguir fornece informações sobre o uso de memória desses dois armazenamentos de cache:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
O cache de planos tem dois armazenamentos adicionais que não armazenam planos:
- O repositório de cache (PHDR) Árvores Associadas, para as estruturas de dados usadas durante a compilação do plano para exibições, restrições e padrões. Essas estruturas são conhecidas como bound trees ou algebrizer trees.
- Cache store (XPROC) de Procedimentos Armazenados Estendidos, para procedimentos de sistema predefinidos, como sp_executesql ou xp_cmdshell. Esses procedimentos armazenados usam uma DLL em vez de instruções T-SQL. A estrutura em cache contém apenas o nome da função e o nome da DLL onde o procedimento é implementado.
Componentes do plano de execução
Planos de execução do Mecanismo de Banco de Dados possuem os seguintes componentes principais:
Plano compilado (ou plano de consulta)
O plano de consulta produzido pelo processo de compilação é basicamente uma estrutura de dados reentrante somente leitura, usada por qualquer número de usuários. Ele armazena informações sobre:
Os operadores físicos que implementam a operação descrita pelos operadores lógicos.
A ordem desses operadores, que determina a ordem na qual os dados são acessados, filtrados e agregados.
O número de linhas estimadas que fluem pelos operadores.
Observação
O plano de consulta também armazena informações sobre os objetos estatísticos usados para a Estimativa de Cardinalidade.
Quais objetos de suporte precisam ser criados, como tabelas de trabalho ou arquivos de trabalho no
tempdb.
O plano de consulta não armazena nenhum contexto do usuário ou informação de tempo de execução. O Mecanismo de Banco de Dados determina o número de threads de trabalho cada vez que recupera um plano do cache do plano. Um plano paralelo em cache também pode rodar em série.
Contexto de execução
Cada usuário que executa a consulta atualmente possui uma estrutura de dados que armazena os dados específicos para sua execução, como valores de parâmetros. Essa estrutura de dados é chamada de contexto de execução. As estruturas de dados do contexto de execução são reutilizadas, mas seu conteúdo não. Se outro usuário executar a mesma consulta, as estruturas de dados serão reinicializadas com o contexto para o novo usuário.
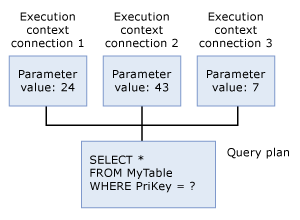
Reutilizar planos para instruções idênticas
Quando o Mecanismo de Banco de Dados executa qualquer instrução T-SQL, ele primeiro procura no cache de planos para verificar se existe um plano de execução existente para a mesma instrução T-SQL. A instrução T-SQL se qualifica como existente se ela literalmente corresponde a uma instrução T-SQL já executada anteriormente com um plano em cache, caractere por caractere. O Mecanismo de Banco de Dados reutiliza qualquer plano existente que encontrar, economizando a sobrecarga de recompilar a instrução T-SQL. Se não existir um plano de execução, o Mecanismo de Banco de Dados gera um novo plano de execução para a consulta.
Observação
O cache do plano não persiste planos de execução para algumas instruções T-SQL, como instruções de operação em massa rodando em rowstore ou instruções contendo literais grandes de string. Esses planos existem apenas enquanto a consulta está em execução.
O Mecanismo de Banco de Dados utiliza um algoritmo eficiente para encontrar quaisquer planos de execução existentes para qualquer instrução T-SQL específica. Na maioria dos sistemas, a pequena quantidade de recursos que essa varredura consome é menor do que os recursos economizados ao reutilizar planos existentes em vez de compilar todas as instruções T-SQL.
Os algoritmos para combinar novas instruções T-SQL com planos de execução existentes e não utilizados no cache do plano exigem que todas as referências a objetos sejam totalmente qualificadas. Por exemplo, suponha que Person seja o esquema padrão para o usuário que executa as seguintes instruções SELECT. Embora este exemplo não exija que você especifique o nome completo da tabela Person para a execução, isso significa que a segunda instrução não corresponde a um plano existente, mas a terceira instrução corresponde:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Alterar qualquer uma das seguintes SET opções para uma determinada execução afeta a capacidade de reutilizar planos, porque o Mecanismo de Banco de Dados realiza constant folding e essas opções afetam os resultados dessas expressões:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Armazenar vários planos em cache para a mesma consulta
As consultas e os planos de execução são exclusivamente identificáveis no Mecanismo de Banco de Dados, de maneira semelhante a uma impressão digital:
- O hash do plano de consulta é um valor de hash binário calculado no plano de execução para determinada consulta e usado para identificar exclusivamente os planos de execução semelhantes.
- O hash da consulta é um valor de hash binário calculado no texto T-SQL de uma consulta, e é usado para identificar consultas de forma única.
Você pode recuperar um plano compilado do cache do plano usando um handle de plano. Esse identificador transitório permanece constante apenas enquanto o plano permanece no cache. O identificador do plano é um valor de hash derivado do plano compilado do lote inteiro. O handle do plano para um plano compilado permanece o mesmo, mesmo que uma ou mais instruções do lote sejam recompiladas.
Observação
Se você compilar um plano para um lote em vez de uma única instrução, pode usar o handle do plano e os deslocamentos da instrução para obter o plano para instruções individuais no lote.
O sys.dm_exec_requests DMV contém as colunas statement_start_offset e statement_end_offset de cada registro. Essas colunas referem-se à instrução que está sendo executada no momento de um lote ou objeto persistido que também está em execução. Para obter mais informações, confira sys.dm_exec_requests.
O sys.dm_exec_query_stats DMV também contém essas colunas para cada registro. Essas colunas referem-se à posição de uma instrução dentro de um lote ou de um objeto persistido. Para saber mais, consulte sys.dm_exec_query_stats.
O texto real do T-SQL de um lote é armazenado em um espaço de memória separado do cache do plano, chamado cache SQL Manager (SQLMGR). Você pode recuperar o texto T-SQL de um plano compilado do cache do SQL Manager usando um handle SQL. Esse identificador transitório permanece constante apenas enquanto pelo menos um plano que o referencia permanece no cache do plano. O handle SQL é um valor de hash derivado de todo o texto do lote, e é garantido que é único para cada lote.
Observação
Como um plano compilado, o texto do T-SQL é armazenado para cada lote, incluindo os comentários. O handle SQL contém o hash MD5 de todo o texto do lote e tem garantia de ser único para cada lote.
A consulta a seguir fornece informações sobre o uso de memória para o cache SQL Manager:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Existe uma relação de um para muitos entre um handle SQL e os handles de plano. Essa condição ocorre quando a chave de cache para os planos compilados é diferente. Essa diferença pode ocorrer devido à mudança nas SET opções entre duas execuções do mesmo lote.
Considere o seguinte procedimento armazenado:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Verifique o que você pode encontrar no cache do plano usando a seguinte consulta:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Veja a seguir o conjunto de resultados.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Agora execute o procedimento armazenado com um parâmetro diferente, sem outras alterações no contexto de execução:
EXECUTE usp_SalesByCustomer 8;
GO
Verifique novamente o que você encontra no cache do plano. Veja a seguir o conjunto de resultados.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Note que o usecounts valor aumenta para 2, o que significa que o mesmo plano em cache é reutilizado sem alterações, porque as estruturas de dados do contexto de execução são reutilizadas. Agora mude a SET ANSI_DEFAULTS opção e execute o procedimento armazenado usando o mesmo parâmetro.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Verifique novamente o que você pode encontrar no cache do plano. Veja a seguir o conjunto de resultados.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Observe que agora há duas entradas na saída da DMV sys.dm_exec_cached_plans:
- A
usecountscoluna mostra o valor1no primeiro registro. Esse valor representa o plano executado uma vez comSET ANSI_DEFAULTS OFF. - A
usecountscoluna mostra o valor2no segundo registro. Esse valor representa o plano executado comSET ANSI_DEFAULTS ON, porque o plano foi executado duas vezes. - Os
memory_object_addressdiferentes referem-se a uma entrada diferente de plano de execução no cache de planos. No entanto, o valor desql_handleé o mesmo para as duas entradas, porque elas se referem ao mesmo lote.- A execução com
ANSI_DEFAULTSdefinido paraOFFtem um novoplan_handle, e está disponível para reutilização para chamadas que têm o mesmo conjunto deSETopções. O novo identificador de plano é necessário porque o contexto de execução foi reinicializado devido a opçõesSETalteradas. Mas essa mudança não desencadeia uma recompilação: ambas as entradas se referem ao mesmo plano e consulta, como evidenciado pelos mesmos valores dequery_plan_hashequery_hash.
- A execução com
Essa situação significa que você tem duas entradas de plano no cache correspondentes ao mesmo lote. Isso ressalta a importância de garantir que as opções SET que afetam o cache de plano sejam as mesmas quando as mesmas consultas são executadas repetidamente. Essa abordagem otimiza a reutilização do plano e mantém o tamanho do cache do plano no mínimo exigido.
Dica
Uma armadilha comum é que clientes diferentes podem ter valores padrão diferentes para as SET opções. Por exemplo, uma conexão feita via SQL Server Management Studio define QUOTED_IDENTIFIER automaticamente para ON, enquanto SQLCMD define QUOTED_IDENTIFIER para OFF. Executar as mesmas consultas a partir desses dois clientes resulta em múltiplos planos (como descrito no exemplo anterior).
Remover planos de execução do cache de planos
Os planos de execução ficam no cache do plano enquanto houver memória suficiente para armazená-los. Quando existe pressão de memória, o Mecanismo de Banco de Dados do SQL Server utiliza uma abordagem baseada em custos para decidir quais planos de execução remover do cache do plano. Para tomar uma decisão baseada em custo, o Mecanismo de Banco de Dados do SQL Server aumenta e diminui uma variável de custo atual para cada plano de execução com base nos seguintes fatores.
Quando um processo usuário insere um plano de execução no cache, o processo do usuário define o custo atual igual ao custo original da compilação da consulta. Para planos de execução ad hoc, o processo do usuário define o custo atual como zero. Depois disso, cada vez que um processo de usuário faz referência a um plano de execução, ele reseta o custo atual para o custo original de compilação. Para planos de execução ad hoc, o processo do usuário aumenta o custo atual. Para todos os planos, o valor máximo do custo atual é o custo de compilação original.
Quando existe pressão de memória, o Mecanismo de Banco de Dados do SQL Server remove planos de execução do cache de planos. Para determinar quais planos remover, o Mecanismo de Banco de Dados do SQL Server examina repetidamente o estado de cada plano de execução e remove planos quando o custo atual for igual a zero. Um plano de execução com custo atual zero não é removido automaticamente quando existe pressão de memória. Ele só é removido quando o Mecanismo de Banco de Dados do SQL Server examina o plano e o custo atual é zero. Ao examinar um plano de execução, o Mecanismo de Banco de Dados do SQL Server impulsiona o custo atual em direção a zero ao reduzir o custo atual se uma consulta não estiver usando o plano no momento.
O Mecanismo de Banco de Dados do SQL Server continua examinando os planos de execução até remover planos suficientes para satisfazer os requisitos de memória. Embora haja pressão de memória, o custo de um plano de execução pode ser aumentado e reduzido mais de uma vez. Quando a pressão de memória não existe mais, o Mecanismo de Banco de Dados do SQL Server para de diminuir o custo corrente dos planos de execução não utilizados. Todos os planos de execução permanecem no cache do plano, mesmo que seu custo seja zero.
O Mecanismo de Banco de Dados do SQL Server usa o monitor de recursos e os threads de trabalho do usuário para liberar memória do cache do plano em resposta à pressão de memória. O monitor de recursos e as threads de trabalhadores usuários podem examinar simultaneamente planos para diminuir o custo atual de cada plano de execução não utilizado. O monitor de recursos remove planos de execução do cache de planos quando há pressão de memória global. Ele libera memória para aplicar políticas para a memória do sistema, a memória do processo, a memória do pool de recursos e o tamanho máximo de todos os caches.
O tamanho máximo de todos os caches é uma função do tamanho do pool de buffers que não pode exceder a memória máxima do servidor. Para mais informações sobre como configurar a memória máxima do servidor, veja a max server memory configuração em sp_configure.
Os threads de trabalho do usuário removem planos de execução do cache de planos quando há pressão de memória de cache único. Eles aplicam políticas para o tamanho máximo de cada cache individual e o número máximo de entradas em cada cache.
Os exemplos a seguir ilustram quais planos de execução são removidos do cache de planos:
- Um plano de execução é referenciado frequentemente para que seu custo nunca seja zerado. O plano permanece no cache do plano e não é removido a menos que haja pressão de memória e o custo atual seja zero.
- Um plano de execução ad hoc é inserido e não é referenciado novamente até que exista pressão de memória. Como os planos ad hoc são inicializados com custo atual zero, quando o Mecanismo de Banco de Dados do SQL Server examina o plano de execução, ele vê o custo corrente zero e remove o plano do cache do plano. O plano de execução ad hoc permanece no cache do plano com custo atual zero quando a pressão de memória não existe.
Para remover manualmente um único plano ou todos os planos do cache, use DBCC FREEPROCCACHE. Você também pode usar o DBCC FREESYSTEMCACHE para limpar qualquer cache, incluindo o cache do plano. SQL Server 2016 (13.x) e versões posteriores, use ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE para limpar o cache de procedimentos (plan) do banco de dados no escopo.
Uma mudança em algumas configurações de configuração por meio do sp_configure e reconfigure também causa a remoção de planos do cache de planos. Encontre a lista dessas definições de configuração na seção Comentários do artigo DBCC FREEPROCCACHE. Quando você faz essa alteração de configuração, a seguinte mensagem informativa é escrita no registro de erros:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Recompilar planos de execução
Certas alterações em um banco de dados podem tornar um plano de execução ineficiente ou inválido. O Mecanismo de Banco de Dados detecta essas mudanças e marca o plano como inválido. Um novo plano de execução deve, em seguida, ser recompilado para a próxima conexão que executar a consulta. Condições que invalidam um plano incluem:
- Alterações em uma tabela ou visualização referenciada pela consulta (
ALTER TABLEeALTER VIEW). - Mudanças em um único procedimento eliminariam todos os planos desse procedimento do cache (
ALTER PROCEDURE). - Alterações em quaisquer índices usadas pelo plano de execução.
- Atualizações nas estatísticas usadas pelo plano de execução, sejam elas geradas explicitamente por uma instrução como
UPDATE STATISTICSou geradas automaticamente. - Cancelando um índice usado pelo plano de execução.
- Uma chamada explícita para
sp_recompile. - Números grandes de alterações para chaves (gerados por instruções
INSERTouDELETEde outros usuários que modificam a tabela referenciada pela consulta). - Para tabelas com gatilhos, caso o número de linhas nas tabelas inseridas ou excluídas aumente significativamente.
- Executar um procedimento armazenado usando a
WITH RECOMPILEopção.
A maioria das recompilações é necessária tanto para correção da instrução quanto para obter planos de execução de consultas potencialmente mais rápidos.
Quando uma instrução dentro de um lote desencadeia a recompilação, apenas essa instrução é recompilada, não todo o lote. Essa regra se aplica independentemente de o lote ser enviado por meio de um procedimento armazenado, gatilho, lote ad hoc ou instrução preparada.
A recompilação em nível de instrução beneficia o desempenho porque, na maioria dos casos, um pequeno número de instruções causa recompilações e suas penalidades associadas, em termos de tempo de CPU e bloqueios. Essas penalidades são, portanto, evitadas para as outras declarações do lote que não precisam ser recompiladas.
O evento estendido (XEvent) sql_statement_recompile relata recompilações no nível da instrução. Esse XEvent ocorre quando uma recompilação no nível da instrução é exigida por qualquer tipo de lote. Esse requisito inclui procedimentos armazenados, gatilhos, lotes ad hoc e consultas. Os lotes podem ser enviados por várias interfaces, incluindo sp_executesql, SQL dinâmico, métodos Prepare ou métodos Execute.
A recompile_cause coluna de sql_statement_recompile XEvent contém um código inteiro que indica o motivo da recompilação. A lista a seguir contém os possíveis motivos:
- Opções de cursor alteradas
- Compilação adiada
- Permissão alterada
FOR BROWSE -
OPTION (RECOMPILE)solicitado - Liberação do plano parametrizado
- Alteração da exibição particionada
- Alteração do plano que afeta a versão do banco de dados
- Ambiente de notificação de consulta alterado
- Plano do Repositório de Consultas ausente
- Falha da imposição do plano do Repositório de Consultas
- Alteração da política de imposição do plano do Repositório de Consultas
- Conjunto de linhas remoto alterado
- Esquema alterado
-
SETopção alterada - Estatísticas alteradas
- Alteração da tabela temporária
Observação
Quando você define a AUTO_UPDATE_STATISTICS opção do banco de dados para ON, consultas são recompiladas quando elas têm como alvo tabelas ou visões indexadas cujas estatísticas são atualizadas ou cujas cardinalidades mudam significativamente desde a última execução. Esse comportamento se aplica a tabelas padrão definidas pelo usuário, tabelas temporárias e tabelas inseridas e excluídas criadas por disparadores de DML.
Definir AUTO_UPDATE_STATISTICS como OFF interrompe essas recompilações, mas estatísticas desatualizadas geralmente degradam o desempenho das consultas mais do que as recompilações. Para mais informações, veja a opção AUTO_UPDATE_STATISTICS . As tabelas inseridas e excluídas dos gatilhos DML INSTEAD OF são criadas em tempdb, então seguem a AUTO_UPDATE_STATISTICS configuração de tempdb.
Use parâmetros explícitos para o reuso de planos
O uso de parâmetros, incluindo parâmetros nomeados em aplicações ADO.NET e marcadores de parâmetros em aplicações OLE DB e ODBC, pode aumentar a reutilização de planos de execução.
Aviso
Sempre valide entrada de usuário testando tipo, comprimento, formato e intervalo. Para obter mais informações, consulte SQL Injection.
A única diferença entre as duas instruções SELECT a seguir são os valores comparados na cláusula WHERE :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
A única diferença entre os planos de execução dessas consultas é o valor armazenado para a comparação com a coluna ProductSubcategoryID . Embora o objetivo seja que o Mecanismo de Banco de Dados sempre reconheça que as instruções geram essencialmente o mesmo plano e reutilize os planos, o Mecanismo de Banco de Dados às vezes não detecta essa semelhança em instruções T-SQL complexas.
Separar constantes da instrução T-SQL usando parâmetros ajuda o motor relacional a reconhecer planos duplicados. Use parâmetros dos seguintes modos:
No T-SQL, use
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Esse método é recomendado para scripts T-SQL, stored procedures ou triggers que geram instruções SQL dinamicamente.
ADO.NET com
SqlClientusa parâmetros nomeados, como@Parm. OLE DB e ODBC usam marcadores de parâmetro. Marcadores de parâmetros são pontos de interrogação (?) que substituem uma constante em uma instrução SQL e estão vinculados a uma variável do programa. Por exemplo, você faria o seguinte em um aplicativo de ODBC:Use
SQLBindParameterpara vincular uma variável inteira ao primeiro marcador de parâmetro em uma instrução SQL.Coloque o valor inteiro na variável.
Execute a instrução, especificando o marcador de parâmetro (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
O SQL Server Native Client OLE DB Provider e o driver ODBC do SQL Server Native Client usam
sp_executesqlpara enviar instruções ao SQL Server quando marcadores de parâmetros são usados em aplicações.Escreva procedimentos armazenados, que usam parâmetros por design.
Se você não incorporar parâmetros explicitamente no design das suas aplicações, também pode contar com o Query Optimizer para parametrizar automaticamente certas consultas usando o comportamento padrão da parametrização simples. Outra opção é forçar o Otimizador de Consulta a considerar a parametrização de todas as consultas no banco de dados, configuração a opção PARAMETERIZATION da instrução ALTER DATABASE como FORCED.
Parametrização simples
No Mecanismo de Banco de Dados, usar parâmetros ou marcadores de parâmetros em instruções T-SQL aumenta a capacidade do motor relacional de combinar novas instruções T-SQL com planos de execução existentes, previamente compilados.
Aviso
Sempre valide entrada de usuário testando tipo, comprimento, formato e intervalo. Para obter mais informações, consulte SQL Injection.
Se uma instrução T-SQL for executada sem parâmetros, o Mecanismo de Banco de Dados parametriza a instrução internamente para aumentar a possibilidade de fazê-la corresponder a um plano de execução existente. Esse processo é chamado de parametrização. O padrão é a parametrização simples, e você pode ativar a parametrização forçada para um banco de dados.
Considere esta declaração:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Você pode especificar o valor 1 no final da instrução como um parâmetro. O motor relacional constrói o plano de execução para esse lote como se você especificasse um parâmetro no lugar do valor 1. Por causa dessa parametrização simples, o Mecanismo de Banco de Dados reconhece que as duas instruções seguintes geram essencialmente o mesmo plano de execução e reutiliza o primeiro plano para a segunda instrução:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Ao processar instruções complexas em T-SQL, o motor relacional pode ter dificuldade em determinar quais expressões podem ser parametrizadas. Para aumentar a capacidade do motor relacional de corresponder instruções complexas T-SQL a planos de execução existentes e não utilizados, especifique explicitamente os parâmetros usando sp_executesql ou marcadores de parâmetro.
Observação
Ao usar os operadores aritméticos +, -, *, /, or % para executar conversão implícita ou explícita de valores constantes int, smallint, tinyint ou bigint para os tipos de dados float, real, decimal ou numérico, o Mecanismo de Banco de Dados aplica regras específicas para calcular o tipo e a precisão dos resultados da expressão. Essas regras diferem, dependendo se a consulta é parametrizada. Portanto, as expressões semelhantes em consultas podem, em alguns casos, produzir resultados diferentes.
No comportamento padrão de parametrização simples, o Mecanismo de Banco de Dados parametriza uma classe relativamente pequena de consultas. No entanto, você pode especificar que todas as consultas de um banco de dados sejam parametrizadas, sujeitas a determinadas limitações, configurando a opção PARAMETERIZATION do comando ALTER DATABASE para FORCED. Essa mudança pode melhorar o desempenho de bancos de dados que apresentam altos volumes de consultas simultâneas ao reduzir a frequência das compilações de consultas.
Alternativamente, você pode especificar que, uma consulta única e quaisquer outras que sejam sintaticamente equivalentes e apenas diferem nos valores de parâmetro, sejam parametrizadas.
Dica
Quando você usa uma solução de mapeamento objeto-relacional (ORM), como o Entity Framework (EF), consultas de aplicação como árvores manuais de consulta LINQ ou certas consultas SQL brutas podem não ser parametrizadas. Essa limitação impacta a reutilização do plano e a capacidade de rastrear consultas na Repositório de Consultas. Para saber mais, confira Parametrização e cache de consultas do EF e Consultas de SQL bruto do EF.
Parametrização forçada
Você também pode substituir o comportamento padrão da parametrização simples do Mecanismo de Banco de Dados especificando que todas as instruções SELECT, INSERT, UPDATE e DELETE em um banco de dados tenham parâmetros e sejam sujeitas a determinadas limitações. Ative a parametrização forçada definindo a PARAMETERIZATION opção como FORCED na ALTER DATABASE instrução. A parametrização forçada pode melhorar o desempenho de alguns bancos de dados reduzindo a frequência de compilações e recompilações de consulta. Os bancos de dados que podem se beneficiar da parametrização forçada geralmente são aqueles em que há suporte a grandes volumes de consultas simultâneas de origens tais como aplicativos de ponto-de-venda.
Quando você define a opção PARAMETERIZATION para FORCED, qualquer valor literal que apareça em uma instrução SELECT, INSERT, UPDATE ou DELETE, enviado em qualquer forma, é convertido em um parâmetro durante a compilação da consulta. As exceções são literais presentes nas seguintes construções de consulta:
- Instruções
INSERT...EXECUTE. - Instruções nos corpos de procedimentos armazenados, gatilhos ou funções definidas pelo usuário. O Mecanismo de Banco de Dados já reutiliza planos de consulta para essas rotinas.
- Instruções preparadas que já foram parametrizadas no aplicativo cliente.
- Instruções que contêm chamadas do método XQuery, onde o método é exibido em um contexto em que seus argumentos normalmente seriam parametrizados, como uma cláusula
WHERE. Se o método for exibido em um contexto em que seus argumentos não serão parametrizados, o restante da instrução será parametrizado. - Instruções dentro de um cursor T-SQL. (As instruções
SELECTsão parametrizadas em cursores de API.) - Construções de consulta obsoletas.
- Qualquer instrução executada no contexto de
ANSI_PADDINGouANSI_NULLSdefinida comoOFF. - Instruções que contêm mais de 2.097 literais elegíveis para parametrização.
- Instruções que fazem referência a variáveis, como
WHERE T.col2 >= @bb. - Instruções que contêm a dica de consulta
RECOMPILE. - Declarações que contêm uma cláusula
COMPUTE. - Declarações que contêm uma cláusula
WHERE CURRENT OF.
As seguintes cláusulas de consulta não são parametrizadas. Nesses casos, somente as cláusulas não são parametrizadas. Outras cláusulas dentro da mesma consulta podem ser elegíveis para parametrização forçada.
- A
<select_list>de qualquer instruçãoSELECT. Essa lista inclui as listasSELECTde subconsultas e listasSELECTdentro de instruçõesINSERT. - Instruções
SELECTde subconsulta exibidas dentro de uma instruçãoIF. - As cláusulas
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOouFOR XMLde uma consulta. - Argumentos, diretos ou como subexpressões, para
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXMLou qualquer operadorFULLTEXT. - Os argumentos pattern e escape_character de uma cláusula
LIKE. - O argumento style de uma cláusula
CONVERT. - Constantes inteiras dentro de uma cláusula
IDENTITY. - Constantes especificadas usando a sintaxe da extensão ODBC.
- Expressões de constantes desdobráveis que são argumentos dos operadores
+,-,*,/e%. Ao considerar a elegibilidade para parametrização forçada, o Mecanismo de Banco de Dados considera uma expressão como sendo passível de constant folding quando qualquer uma das seguintes condições é verdadeira:- Nenhuma coluna, variável ou subconsulta aparece na expressão.
- A expressão contém uma cláusula
CASE.
- Argumentos para as cláusulas de dica de consulta, incluindo o argumento number_of_rows da
FASTdica de consulta, o argumento number_of_processors daMAXDOPdica de consulta e o argumento número daMAXRECURSIONdica de consulta.
A parametrização ocorre no nível de instruções individuais do T-SQL. Em outras palavras, instruções individuais em um lote são parametrizadas. Após a compilação, uma consulta parametrizada é executada no contexto do lote em que foi originalmente submetida. Se um plano de execução para uma consulta estiver armazenado em cache, você pode determinar se a consulta foi parametrizada referenciando a coluna sql da visualização de gerenciamento dinâmico sys.syscacheobjects. Se uma consulta for parametrizada, os nomes e tipos de dados dos parâmetros vêm antes do texto do lote submetido nesta coluna, como (@1 TINYINT).
Observação
Os nomes de parâmetro são arbitrários. Usuários ou aplicativos não devem depender de uma ordem específica de nomeação. Além disso, os seguintes itens podem ser alterados entre as versões do SQL Server e atualizações cumulativas (CUs): nomes de parâmetros, a escolha de literais parametrizados e o espaçamento no texto parametrizado.
Tipos de dados de parâmetros
Quando o Mecanismo de Banco de Dados parametriza literais, os parâmetros são convertidos para os seguintes tipos de dados:
- Literais inteiros cujo tamanho, de outra forma, caberia no tipo de dados int são parametrizados como int. Literais inteiros maiores que fazem parte de predicados que envolvem qualquer operador de comparação (incluindo
<,<=,=,!=,>,ANY,!>,ALL,BETWEEN,<>,!<,SOME,>=eIN) são parametrizados como numeric(38,0). Literais maiores que não fazem parte de predicados que envolvem operadores de comparação parametrizam para numeric cuja precisão é apenas grande o suficiente para suportar seu tamanho e cuja escala é 0. - Literais numéricos de ponto fixo que não fazem parte de predicados que envolvem operadores de comparação parametrizados em numeric, cuja precisão é 38 e cuja escala é grande o suficiente para oferecer suporte ao seu tamanho. Literais numéricos de ponto fixo que não fazem parte de predicados que envolvem operadores de comparação são parametrizados como numeric, cuja precisão e escala são apenas grandes o suficiente para suportar seu tamanho.
- Literais numéricos em ponto flutuante parametrizam para float(53).
- Literais de string não-Unicode parametrizam varchar(8000) se o literal se encaixa dentro de 8.000 caracteres, e varchar(max) se for maior que 8.000 caracteres.
- Os literais de string Unicode parametrizam nvarchar(4000) se o literal se encaixa em 4.000 caracteres Unicode, e para nvarchar(max) se for maior que 4.000 caracteres.
- Literais binários parametrizam para varbinary(8000) se o literal estiver dentro de 8.000 bytes. Se for maior que 8.000 bytes, ele é convertido para varbinary(max).
- Literais de moeda parametrizados em money.
Diretrizes para uso da parametrização forçada
Considere os seguintes pontos ao definir a PARAMETERIZATION opção para FORCED:
- A parametrização forçada altera as constantes literais em uma consulta para parâmetros ao compilar uma consulta. Portanto, o otimizador de consulta pode escolher planos subótimos para consultas. Em especial, é menos provável que o otimizador de consultas efetue uma correspondência entre uma consulta e uma exibição indexada ou um índice em uma coluna computada. Além disso, ele pode escolher planos com qualidade inferior para consultas inseridas em tabelas particionadas e exibições particionadas distribuídas. Não use parametrização forçada para ambientes que dependem muito de visualizações indexadas e índices em colunas computadas. Geralmente, apenas profissionais experientes em banco de dados devem usar a
PARAMETERIZATION FORCEDopção após verificar que ela não afeta negativamente o desempenho. - As consultas distribuídas que referenciam mais de um banco de dados são elegíveis para parametrização forçada, contanto que a opção
PARAMETERIZATIONseja definida comoFORCEDno banco de dados cujo contexto está sendo executado pela consulta. - A definição da opção
PARAMETERIZATIONcomoFORCEDlibera todos os planos de consulta do cache de plano de um banco de dados, menos os que estão sendo compilados, recompilados ou em execução. Os planos para consultas que estão compilando ou rodando durante a mudança de configuração são parametrizados na próxima execução da consulta. - Configurar a
PARAMETERIZATIONopção é uma operação online que não exige bloqueios exclusivos em nível de banco de dados. - A configuração atual da opção
PARAMETERIZATIONé preservada ao anexar novamente ou restaurar um banco de dados.
Você pode substituir o comportamento da parametrização forçada especificando que a parametrização simples seja tentada em uma única consulta e em quaisquer outras consultas que sejam sintaticamente equivalentes, mas difiram apenas em seus valores de parâmetro. Reciprocamente, pode-se especificar a tentativa da parametrização forçada em apenas um conjunto de consultas sintaticamente equivalentes, mesmo se a parametrização forçada estiver desabilitada no banco de dados. Use guias de plano para esse propósito.
Observação
Quando a opção PARAMETERIZATION é definida como FORCED, o relatório de mensagens de erro pode ser diferente de quando a opção PARAMETERIZATION está configurada para SIMPLE: podem ser relatadas várias mensagens de erro na parametrização forçada, em que poucas mensagens seriam informadas na parametrização simples, e o número de linhas nas quais ocorrem erros pode ser relatado incorretamente.
Quando a parametrização forçada estiver habilitada, a parametrização simples ainda poderá acontecer. Por exemplo, a consulta a seguir não pode ser parametrizada de acordo com as regras de parametrização forçada:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Porém, ela pode ser parametrizada de acordo com as regras de parametrização simples. Quando se tenta usar a parametrização forçada, mas ela falha, há uma tentativa subsequente de parametrização simples.
Preparar instruções SQL
O Mecanismo de Banco de Dados suporta a preparação de instruções T-SQL antes da execução. Se uma aplicação precisar executar uma instrução T-SQL várias vezes, ela pode usar a API do banco de dados para:
- Preparar a instrução uma vez. Essa etapa compila a instrução T-SQL em um plano de execução.
- Execute o plano de execução pré-compilado toda vez que precisar executar a instrução. Essa abordagem impede a recompilação da instrução T-SQL em cada execução após a primeira vez. A preparação e a execução de instruções são controladas por funções e métodos de API. O SQL Server Native Client OLE DB Provider e o driver ODBC do SQL Server Native Client suportam o modelo prepare/execute para executar instruções T-SQL. Em uma solicitação de preparação, o provedor ou o driver envia a instrução ao SQL Server com uma solicitação para preparar a instrução. O Mecanismo de Banco de Dados compila um plano de execução e retorna um handle desse plano ao provedor ou driver. Em uma solicitação de execução, o provedor ou o driver envia ao servidor uma solicitação para executar o plano associado ao identificador.
Instruções preparadas não podem criar objetos temporários no Mecanismo de Banco de Dados. As instruções preparadas não podem fazer referência aos procedimentos armazenados do sistema que criam objetos temporários, como tabelas temporárias. Esses procedimentos devem ser executados diretamente.
O uso excessivo do modelo preparar/executar pode degradar o desempenho. Se uma instrução for executada apenas uma vez, a execução direta requer apenas uma ida e volta na rede até o servidor. Preparar e executar uma instrução T-SQL executada apenas uma vez requer uma rodada adicional de comunicação pela rede: uma viagem para preparar a instrução e outra para executá-la.
A preparação de uma instrução é mais eficaz se forem utilizados marcadores de parâmetro. Por exemplo, supondo que a um aplicativo seja pedido ocasionalmente a recuperação de informações de produto do banco de dados de exemplo AdventureWorksLT2025 . Existem duas maneiras que o aplicativo pode realizar essa tarefa.
Usando a primeira abordagem, a aplicação pode executar uma consulta separada para cada produto solicitado:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Usando a segunda abordagem, a aplicação executa as seguintes operações:
Prepara uma instrução que contém um marcador de parâmetro (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Associa uma variável de programa ao marcador de parâmetro.
Sempre que as informações do produto são necessárias, atribui o valor da chave à variável vinculada e executa a instrução.
A segunda abordagem é mais eficiente se a instrução for executada mais de três vezes.
No Mecanismo de Banco de Dados, o modelo preparar/executar não tem vantagem significativa de desempenho em relação à execução direta, devido à forma como o Mecanismo de Banco de Dados reutiliza planos de execução. O Mecanismo de Banco de Dados possui algoritmos eficientes para combinar instruções T-SQL atuais com planos de execução gerados para execuções anteriores da mesma instrução T-SQL. Se uma aplicação executar uma instrução T-SQL com marcadores de parâmetros várias vezes, o Mecanismo de Banco de Dados reutiliza o plano de execução da primeira execução para a segunda e subsequentes execuções (a menos que o plano expire do cache de planos). O modelo de preparação/execução ainda possui estes benefícios:
- Encontrar um plano de execução por meio de um handle identificador é mais eficiente do que os algoritmos usados para associar uma instrução T-SQL a planos de execução existentes.
- A aplicação pode controlar quando o plano de execução é criado e quando ele é reutilizado.
- O modelo de preparação/execução é portátil para outros bancos de dados, inclusive para versões anteriores do SQL Server.
Sensibilidade de parâmetros
Sensibilidade aos parâmetros, também conhecida como sniffing de parâmetros, refere-se a um processo em que o Mecanismo de Banco de Dados sniffa os valores atuais dos parâmetros durante a compilação ou recompilação, e os encaminha para o Query Optimizer para potencialmente ajudar a gerar planos de execução de consulta mais eficientes.
Valores de parâmetro são detectados durante a compilação ou recompilação para os seguintes tipos de lotes:
- Procedimentos armazenados
- Consultas enviadas por meio de
sp_executesql - Consultas preparadas
Para mais informações sobre a resolução de problemas de sniffing de parâmetros, veja:
- Investigue e resolva problemas de sensibilidade de parâmetros
- Use parâmetros explícitos para o reuso de planos
- Otimização do plano sensível a parâmetros
- Resolver problemas de consultas com planos de execução sensíveis a parâmetros no Banco de Dados SQL do Azure
- Solucionar problemas de consultas com problemas de plano de execução de consulta sensível a parâmetros na Instância Gerenciada de SQL do Azure
Quando uma consulta no Mecanismo de Banco de Dados usa a dica OPTION (RECOMPILE), o Otimizador de Consulta transforma os parâmetros e as variáveis locais em constantes de tempo de compilação que podem ser tratadas como constantes e reduzidas a literais. Durante a compilação, o otimizador conhece e pode usar os valores atuais de tempo de execução dos parâmetros e variáveis locais conforme eles existem imediatamente antes dessa instrução. O hint OPTION (RECOMPILE) permite que o otimizador gere um plano de consulta mais otimizado, adaptado aos valores específicos, e aproveite os melhores índices subjacentes em tempo de execução. Para os parâmetros, esse processo não se refere aos valores passados originalmente para o lote ou procedimento armazenado, mas aos seus valores no momento da recompilação. Esses valores podem ser modificados dentro do procedimento antes de chegar à instrução que inclui RECOMPILE. Esse comportamento pode melhorar o desempenho de consultas com dados de entrada altamente variáveis ou distorcidos, ao custo de compilar a consulta toda vez que ela é executada. Esse custo pode ser alto. Evite usar a RECOMPILE dica sem avaliar seu impacto em toda a carga de trabalho.
Variáveis locais e estimativas de cardinalidade
Quando uma consulta usa variáveis locais, o Mecanismo de Banco de Dados não consegue detectar seus valores em tempo de compilação, então ele estima a cardinalidade usando estatísticas ou heurísticas disponíveis. Se houver estatísticas, ela normalmente usa o valor de Toda Densidade (também conhecido como densidade média) do histograma estatístico para estimar quantas linhas correspondem ao predicado. No entanto, se não houver estatísticas disponíveis para a coluna, o Mecanismo de Banco de Dados recorre a estimativas heurísticas, como assumir 10% de seletividade para predicados de igualdade e 30% para desigualdades e intervalos. Essas estimativas podem levar a planos de execução menos precisos. Aqui está um exemplo de uma consulta que usa uma variável local.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
Nesse caso, o Mecanismo de Banco de Dados não usa o valor 100 para otimizar a consulta. Ele usa uma estimativa geral.
Processamento paralelo de consultas
O Mecanismo de Banco de Dados fornece consultas paralelas para otimizar a execução de consultas e operações de índice para computadores que possuem mais de um microprocessador (CPU). Como o Mecanismo de Banco de Dados pode realizar uma consulta ou operação de índice em paralelo usando vários threads de trabalhadores do sistema operacional, a operação é concluída rápida e eficientemente.
Durante a otimização de consultas, o Mecanismo de Banco de Dados busca consultas ou operações de índice que possam se beneficiar da execução paralela. Para essas consultas, o Mecanismo de Banco de Dados insere operadores de troca no plano de execução da consulta para preparar a consulta para execução paralela. Um operador de troca é um operador em um plano de execução de consulta que fornece gerenciamento de processo, redistribuição de dados e controle de fluxo. O operador de troca inclui como subtipos os operadores lógicos Distribute Streams, Repartition Streams e Gather Streams, dos quais um ou mais podem aparecer na saída do Showplan de um plano de consulta para uma consulta paralela.
Importante
Certos construtos impedem a capacidade do Mecanismo de Banco de Dados de usar paralelismo em todo o plano de execução, ou em partes do plano de execução.
Os constructos que inibem o paralelismo incluem:
| Constructo | Descrição |
|---|---|
| UDFs escalares | Para mais informações sobre funções escalares definidas pelo usuário, veja Criar Funções definidas pelo Usuário. A partir do SQL Server 2019 (15.x), o Mecanismo de Banco de Dados do SQL Server pode embutir essas funções inline e desbloquear o uso do paralelismo durante o processamento de consultas. Para obter mais informações sobre o inlining do UDF escalar, consulte Processamento inteligente de consultas em bancos de dados SQL. |
| Consulta remota | Para mais informações sobre Consulta Remota, veja Referência do operador do plano de exibição lógico e físico. |
| Cursores dinâmicos | Para mais informações sobre cursores, veja DECLARE CURSOR. |
| Consultas recursivas | Para mais informações sobre recursão, veja Diretrizes para Definir e Usar Expressões de Tabelas Comuns Recursivas e Recursão em T-SQL. |
| Funções com valor de tabela de várias instruções (MSTVFs) | Para mais informações sobre MSTVFs, veja Criar funções definidas pelo usuário (Mecanismo de Banco de Dados). |
Palavra-chave TOP |
Para obter mais informações, confira TOP. |
Um plano de execução de consulta pode conter o atributo NonParallelPlanReason no elemento QueryPlan, que descreve por que o paralelismo não foi usado. Os valores para esse atributo incluem:
| NonParallelPlanReason Value | Descrição |
|---|---|
MaxDOPSetToOne |
Grau máximo de paralelismo definido a 1. |
EstimatedDOPIsOne |
O grau estimado de paralelismo é 1. |
NoParallelWithRemoteQuery |
O paralelismo não é compatível com consultas remotas. |
NoParallelDynamicCursor |
Não há suporte para planos paralelos em cursores dinâmicos. |
NoParallelFastForwardCursor |
Não há suporte para planos paralelos em cursores de avanço rápido. |
NoParallelCursorFetchByBookmark |
Não há suporte para planos paralelos em cursores que buscam por indicador. |
NoParallelCreateIndexInNonEnterpriseEdition |
Não há suporte para criação de índice paralelo na edição não empresarial. |
NoParallelPlansInDesktopOrExpressEdition |
Não há suporte para planos paralelos nas edições Desktop e Express. |
NonParallelizableIntrinsicFunction |
A consulta está fazendo referência a uma função intrínseca não paralelizável. |
CLRUserDefinedFunctionRequiresDataAccess |
Não há suporte para paralelismo em uma UDF CLR que requer acesso a dados. |
TSQLUserDefinedFunctionsNotParallelizable |
A consulta está fazendo referência a uma função definida pelo usuário T-SQL que não era paralelizável. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
As transações de variável de tabela não dão suporte a transações aninhadas paralelas. |
DMLQueryReturnsOutputToClient |
A consulta DML retorna a saída ao cliente e não é paralelizável. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
A combinação de planos serial e paralelo sem suporte para um único build de índice online. |
CouldNotGenerateValidParallelPlan |
Falha ao verificar o plano paralelo; realizando failback para serial. |
NoParallelForMemoryOptimizedTables |
Não há suporte para paralelismo em tabelas OLTP in-memory referenciadas. |
NoParallelForDmlOnMemoryOptimizedTable |
Não há suporte para paralelismo em DML em uma tabela OLTP in-memory. |
NoParallelForNativelyCompiledModule |
Não há suporte para paralelismo em módulos compilados nativamente referenciados. |
NoRangesResumableCreate |
Falha na geração de intervalo para uma operação de criação retomável. |
Depois que os operadores de troca são inseridos, o resultado é um plano de execução da consulta paralela. Um plano de execução de consulta paralela pode usar mais de um thread de trabalho. Um plano de execução em série, usado por uma consulta não paralela (em série), usa só um thread de trabalho para sua execução. O número real de threads de trabalho usados por uma consulta paralela é determinado na inicialização da execução do plano de consulta e depende da complexidade do plano e do grau de paralelismo.
Grau de paralelismo (DOP) especifica o número máximo de processadores que podem ser usados para executar uma tarefa paralela. O DOP não indica o número total de threads de trabalho usadas por uma consulta. O limite de DOP é definido por tarefa. Não é um limite por solicitação ou por consulta. Isso significa que, durante uma execução de consulta paralela, uma solicitação única pode gerar várias tarefas que são atribuídas a um agendador. Mais processadores do que o especificado pelo MAXDOP podem ser usados simultaneamente em qualquer ponto da execução da consulta, quando diferentes tarefas são executadas simultaneamente. Para obter mais informações, consulte o guia de arquitetura de threads e tarefas.
O Otimizador de Consultas não utiliza um plano de execução paralelo para uma consulta se qualquer uma das seguintes condições for verdadeira:
O plano de execução serial é trivial, ou não ultrapassa o limite de custo para definição de paralelismo.
O plano de execução serial tem um custo total estimado de subárvore menor do que qualquer plano paralelo de execução explorado pelo otimizador.
A consulta contém operadores escalares ou relacionais que não podem ser executados em paralelo. Certos operadores podem fazer com que uma seção do plano de consulta seja executada no modo em série ou que todo o plano seja executado no modo em série.
Observação
O custo total estimado da subárvore de um plano paralelo pode ser menor do que o limite de custo estabelecido para a paralelização. Em outras palavras, isso indica que o custo total estimado da subárvore do plano serial o excedeu e o plano de consulta com o menor custo total estimado de subárvores foi escolhido.
Grau de Paralelismo (DOP)
O mecanismo de banco de dados detecta automaticamente o melhor grau de paralelismo para cada instância de uma execução de consulta paralela ou operação de linguagem de definição de dados (DDL) de índice. Ele determina esse valor com base nos seguintes critérios:
Se o SQL Server estiver sendo executado em um computador que tenha mais de um microprocessador ou mais de uma CPU, como um computador SMP (multiprocessamento simétrico). Apenas computadores que têm mais de uma CPU podem usar consultas paralelas.
Se há threads de trabalho suficientes disponíveis. Cada operação de consulta ou de criação de índice exige um determinado número de threads de trabalho para serem executadas. A execução de um plano paralelo exige mais threads de trabalho que um plano serial e o número de threads de trabalho exigidos aumenta conforme o grau de paralelismo. Quando o requisito de thread de trabalho do plano paralelo para um grau específico de paralelismo não pode ser satisfeito, o Mecanismo de Banco de Dados do SQL Server automaticamente diminui o grau de paralelismo, ou executa o plano paralelo em série.
O tipo de operação de consulta ou de índice executada. As operações de índice que criam ou reconstroem um índice, ou descartam um índice cluster e as consultas que usam ciclos de CPU frequentemente são as melhores opções para um plano paralelo. Por exemplo, junções de tabelas grandes, agregações grandes e classificação de conjuntos de resultados grandes são boas alternativas. Consultas básicas, frequentemente encontradas em aplicações de processamento de transações, fazem com que a coordenação extra necessária para executar uma consulta em paralelo supere o potencial aumento de desempenho. Para distinguir entre consultas que se beneficiam do paralelismo e aquelas que não se beneficiam, o Mecanismo de Banco de Dados do SQL Server compara o custo estimado de execução da consulta ou operação de índice com o limite de custo do valor de paralelismo. Os usuários podem alterar o valor padrão de
5usando sp_configure se testes adequados encontrarem que um valor diferente é mais adequado para a carga de trabalho em execução.Se houver um número suficiente de linhas para processar. Se o Otimizador de Consulta determinar que o número de linhas for muito baixo, ele não introduzirá operadores de troca para distribuir as linhas. Assim, os operadores serão executados em série. A execução dos operadores em um plano serial evita cenários em que os custos de inicialização, distribuição e coordenação excedem os ganhos alcançados pela execução paralela de operadores.
Se as estatísticas atuais estiverem disponíveis. Se o maior grau de paralelismo não for possível, os graus mais baixos serão considerados antes que o plano paralelo seja abandonado. Por exemplo, quando você cria um índice clusterizado em uma exibição, as estatísticas não poderão ser avaliadas porque o índice clusterizado ainda não existirá. Nesse caso, o Mecanismo de Banco de Dados do SQL Server não poderá fornecer o mais alto grau de paralelismo para a operação de índice. Porém, alguns operadores, como de classificação e verificação, ainda poderão se beneficiar da execução paralela.
Observação
As operações de índice paralelas somente estão disponíveis nas edições Enterprise, Developer e Evaluation do SQL Server.
No tempo de execução, o Mecanismo de Banco de Dados do SQL Server determina se a carga de trabalho do sistema atual e as informações de configuração descritas anteriormente permitem a execução paralela. Se a execução paralela for garantida, o Mecanismo de Banco de Dados do SQL Server determinará o número ideal de threads de trabalho e distribuirá a execução do plano paralelo entre esses threads de trabalho. Quando uma operação de consulta ou índice for iniciada executando em threads de trabalho múltiplos para execução paralela, o mesmo número de threads de trabalho será usado até que a operação seja concluída. O Mecanismo de Banco de Dados do Microsoft SQL Server examina novamente o número ideal de decisões de thread de trabalho sempre que um plano de execução é recuperado do cache do plano. Por exemplo, uma execução de um plano paralelo em cache pode ser executada em série, uma execução posterior do mesmo plano pode usar três threads de trabalho, e uma terceira execução pode usar quatro threads de trabalho.
Os operadores Update e Delete em um plano de execução de consulta paralela são executados em série, mas a cláusula WHERE de uma instrução UPDATE ou DELETE pode ser executada em paralelo. As alterações de dados reais são, depois, aplicadas em série ao banco de dados.
A partir do nível de compatibilidade de banco de dados 110, a instrução SELECT ... INTO pode ser executada em paralelo. Outras formas de operadores de insert funcionam da mesma forma descrita em versões anteriores.
A partir do nível de compatibilidade de banco de dados 130, a instrução INSERT ... SELECT pode ser executada em paralelo ao inserir em heaps ou índices clustered columnstore (CCI), e ao usar a dica TABLOCK. Inserções em tabelas temporárias locais (identificadas pelo # prefixo) e tabelas temporárias globais (identificadas por ## prefixos) também são habilitadas para paralelismo usando a TABLOCK dica. Para obter mais informações, consulte INSERT.
Cursores estáticos e controlados por conjunto de chaves podem ser populados por planos de execução paralelos. Porém, o comportamento dos cursores dinâmicos só pode ser fornecido por meio da execução consecutiva. O otimizador de consulta sempre gera um plano de execução consecutivo para uma consulta que faz parte de um cursor dinâmico.
Sobrescrever graus de paralelismo
O grau de paralelismo define o número de processadores a serem usados na execução do plano paralelo. Você pode definir essa configuração em vários níveis:
Nível de servidor, usando a opção de configuração do servidor grau máximo de paralelismo (
MAXDOP).Aplica-se a: SQL Server
O SQL Server 2019 (15.x) introduziu recomendações automáticas para definir a opção de configuração do servidor
MAXDOPdurante o processo de instalação. A interface do usuário de configuração permite que você aceite as configurações recomendadas ou insira um valor próprio. Para saber mais, veja a página Configuração do Mecanismo de Banco de Dados – MaxDOP.Nível de carga de trabalho, usando a
MAX_DOPopção de configuração do grupo de carga de trabalho Resource Governor.Aplica-se a: SQL Server
Nível de banco de dados, usando a
MAXDOPconfiguração com escopo de banco de dados.Aplica-se a: SQL Server, Banco de Dados SQL do Azure e Instância Gerenciada de SQL do Azure
Nível de instrução de consulta ou índice, usando
MAXDOPdica de consulta ouMAXDOPopção de índice. Por exemplo, você pode usar aMAXDOPopção para controlar, aumentando ou reduzindo, o número de processadores dedicados a uma operação de índice online. Dessa forma, você pode equilibrar os recursos usados por uma operação de índice com os dos usuários simultâneos.Aplica-se a: SQL Server, Banco de Dados SQL do Azure e Instância Gerenciada de SQL do Azure
Definir a max degree of parallelism opção como 0 (padrão) permite que o Mecanismo de Banco de Dados use todos os processadores disponíveis até um máximo de 64 processadores em uma execução paralela do plano. Embora o Mecanismo de Banco de Dados defina uma meta de execução de 64 processadores lógicos quando a MAXDOP opção está definida para 0, você pode definir manualmente um valor diferente, se necessário. Definir MAXDOP para 0 em consultas e índices permite que o Mecanismo de Banco de Dados use todos os processadores disponíveis até um máximo de 64 processadores para as consultas ou índices dados em uma execução de plano paralelo.
MAXDOP não é um valor imposto para todas as consultas paralelas, mas sim um alvo provisório para todas as consultas elegíveis para paralelismo. Isso significa que, se não houver threads de trabalho disponíveis suficientes no runtime, uma consulta poderá ser executada com um grau menor de paralelismo que a opção da configuração de servidor MAXDOP.
Dica
Para obter mais informações, consulte recomendações do MAXDOP para obter diretrizes sobre como configurar MAXDOP no nível de servidor, banco de dados, consulta ou dica.
Exemplo de consulta paralela
A consulta a seguir conta o número de ordens emitidas em um trimestre específico, iniciando no dia 1º de abril de 2024, e no qual pelo menos um item de linha da ordem foi recebido pelo cliente depois da data confirmada. Essa consulta lista a contagem de tais ordens agrupadas por cada prioridade de ordem e classificada em ordem de prioridade crescente.
Esse exemplo usa nomes teóricos de tabela e de coluna.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Suponha que os índices a seguir estão definidos nas tabelas lineitem e orders:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Aqui há um possível plano paralelo gerado para a consulta mostrada anteriormente:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
A ilustração a seguir mostra um plano de consulta executado com um grau de paralelismo igual a 4 e envolvendo uma junção de duas tabelas.
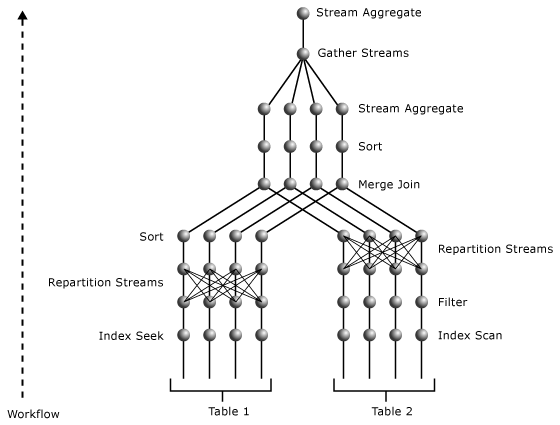
O plano paralelo contém três operadores de paralelismo. O operador Index Seek do índice o_datkey_ptr e o operador Index Scan do índice l_order_dates_idx são executados em paralelo. Esse processo produz diversos fluxos exclusivos, que podem ser determinados a partir dos operadores de paralelismo mais próximos situados acima dos operadores Index Scan e Index Seek, respectivamente. Ambos os operadores estão reparticionando o tipo de troca. Eles reembaralham os dados entre os fluxos e produzem o mesmo número de fluxos em sua saída que têm em sua entrada. Esse número de fluxos é igual ao grau de paralelismo.
O operador de paralelismo acima do l_order_dates_idx operador Index Scan reparticiona seus fluxos de entrada usando o valor de L_ORDERKEY como chave. Desse modo, os mesmos valores de L_ORDERKEY terminam no mesmo fluxo de saída. Ao mesmo tempo, os fluxos de saída mantêm a ordem na coluna L_ORDERKEY para atender o requisito de entrada do operador Merge Join.
O operador de paralelismo acima do operador Busca de Índice reparticiona seus fluxos de entrada usando o valor de O_ORDERKEY. Como sua entrada não está ordenada nos valores da coluna O_ORDERKEY e essa coluna é a coluna de junção no operador Merge Join, o operador Sort entre os operadores de paralelismo e Merge Join garante que a entrada seja ordenada para o operador Merge Join nas colunas de junção. O operador Sort, assim como o operador Merge Join, é executado em paralelo.
O operador de paralelismo superior reúne resultados de vários fluxos em um único fluxo. As agregações parciais executadas pelo operador Stream Aggregate abaixo do operador de paralelismo são acumuladas em um único valor SUM de cada valor diferente de O_ORDERPRIORITY no operador Stream Aggregate acima do operador de paralelismo. Como esse plano possui dois segmentos de troca, com grau de paralelismo igual a 4, ele usa oito threads de trabalho.
Para mais informações sobre os operadores usados neste exemplo, veja a referência de operadores de showplan lógico e físico.
Operações de índice paralelo
Planos de consulta para operações de índice que criam ou reconstruem um índice, ou que eliminam um índice clusterizado, podem suportar operações paralelas e multithread em computadores que possuem múltiplos processadores.
Observação
Operações de índice paralelo estão disponíveis apenas na edição Enterprise.
O Mecanismo de Banco de Dados usa os mesmos algoritmos para determinar o grau de paralelismo (o número total de threads de trabalho separadas a serem executadas) para operações de índice assim como para outras consultas. A opção de configuração de servidor grau máximo de paralelismo define o grau máximo de paralelismo para uma operação de índice. Você pode sobrescrever o valor max degree of parallelism para operações individuais de índice definindo a opção de índice MAXDOP nas CREATE INDEX instruções, ALTER INDEX, DROP INDEX e ALTER TABLE.
Quando o Mecanismo de Banco de Dados do SQL Server constrói um plano de execução de índice, o número de operações paralelas é definido para o valor mais baixo entre esses valores:
- O número de processadores, ou CPUs, no computador.
- O número especificado na opção de configuração do servidor
max degree of parallelism. - O número de CPUs que não estão acima de um limite de trabalho executado para threads de trabalho do SQL Server.
Por exemplo, em um computador que possui oito CPUs, mas onde max degree of parallelism está definido como 6, a operação de índice usa no máximo seis threads de trabalho paralelos. Se cinco das CPUs no computador excederem o limite de trabalho do SQL Server quando um plano de execução de índice for criado, o plano de execução especificará somente três threads de trabalho paralelos.
As principais fases de uma operação de índice paralelo incluem:
- Um thread de trabalho coordenador que examina a tabela de forma rápida e aleatória para calcular a distribuição das chaves do índice. O thread de trabalho coordenador estabelece os limites de chave que criam um número de intervalos de chave igual ao grau de operações paralelas, em que cada intervalo de chave é calculado para cobrir números semelhantes de linhas. Por exemplo, se houver quatro milhões de linhas na tabela e o grau de paralelismo for 4, a thread de trabalho coordenadora determina os valores-chave que delimitam quatro conjuntos de linhas com 1 milhão de linhas em cada conjunto. Se a thread de trabalho coordenadora não conseguir estabelecer intervalos de chaves suficientes para usar todas as CPUs, ela reduz o grau de paralelismo de acordo.
- O thread de trabalho coordenador despacha um número de threads de trabalho igual para o grau de operações paralelas e espera que esses threads de trabalho concluam o trabalho deles. Cada thread de trabalho examina a tabela base usando um filtro que recupera apenas as linhas com valores de chave dentro do intervalo atribuído ao thread de trabalho. Cada thread de trabalho cria uma estrutura de índice para as linhas em seu intervalo de chave. No caso de um índice particionado, cada thread de trabalho cria um número especificado de partições. Não são compartilhadas partições entre threads de trabalho.
- Após a conclusão de todas as threads de trabalho paralelas, a thread de trabalho coordenadora conecta as subunidades de índice em um único índice. Essa fase só se aplica a operações de índice offline.
As instruções CREATE TABLE ou ALTER TABLE individuais podem ter várias restrições que exigem a criação de um índice. Essas operações de criação de vários índices são executadas em série, embora cada operação de criação de índice individual possa ser uma operação paralela em um computador com várias CPUs.
Arquitetura de consulta distribuída
O Mecanismo de Banco de Dados suporta dois métodos para referenciar fontes de dados heterogêneas do OLE DB em instruções T-SQL:
Nomes de servidor vinculado
Use os procedimentos armazenados do sistema
sp_addlinkedserveresp_addlinkedsrvloginpara fornecer um nome de servidor a uma fonte de dados OLE DB. Você pode referenciar objetos nesses servidores vinculados em instruções T-SQL com nomes de quatro partes. Por exemplo, se um nome de servidor vinculado doDeptSQLSrvrfor definido em relação a outra instância do SQL Server, a seguinte instrução faz referência a uma tabela naquele servidor.SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;Você também pode especificar o nome do servidor vinculado em uma instrução
OPENQUERYpara abrir um conjunto de linhas a partir da fonte de dados do OLE DB. Você pode então referenciar esse conjunto de linhas como uma tabela em instruções T-SQL.Nomes de conector ad hoc
Para referências pouco frequentes a uma fonte de dados, especifique as funções
OPENROWSETouOPENDATASOURCEcom as informações necessárias para se conectar ao servidor vinculado. Você pode então referenciar o conjunto de linhas da mesma forma que referencia uma tabela em instruções T-SQL:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
O Mecanismo de Banco de Dados usa o OLE DB para se comunicar entre o motor relacional e o motor de armazenamento. O motor relacional divide cada instrução T-SQL em uma série de operações sobre os conjuntos básicos de linhas do OLE DB que o mecanismo de armazenamento abre a partir das tabelas base. Esse processo significa que o motor relacional também pode abrir rowsets OLE DB básicos em qualquer fonte de dados OLE DB.
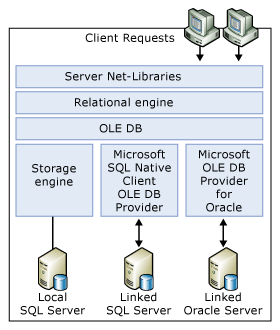
O mecanismo relacional usa a API (interface de programação de aplicativo) do OLE DB para abrir os conjuntos de linhas em servidores vinculados, buscar as linhas e gerenciar as transações.
Para cada fonte de dados OLE DB acessada como um servidor vinculado, o servidor rodando SQL Server deve ter um provedor OLE DB. O conjunto de operações T-SQL que você pode usar contra uma fonte de dados específica do OLE DB depende das capacidades do provedor do OLE DB.
Para cada instância do SQL Server, os membros da função de servidor fixa sysadmin podem habilitar ou desabilitar o uso de nomes de conectores ad hoc para um provedor OLE DB usando a propriedade DisallowAdhocAccess do SQL Server. Quando você habilita o acesso ad hoc, qualquer usuário logado nessa instância pode executar instruções T-SQL contendo nomes de conectores ad hoc, referenciando qualquer fonte de dados na rede que o provedor OLE DB possa acessar. Para controlar o acesso às fontes de dados, membros da função de servidor fixa sysadmin podem desabilitar o acesso ad hoc para aquele provedor OLE DB, limitando assim os usuários apenas àquelas fontes de dados referenciadas por nomes de servidor vinculado definidos pelos administradores. Por padrão, o acesso ad hoc é habilitado para o provedor OLE DB do SQL Server e desabilitado para todos os outros provedores OLE DB.
Consultas distribuídas podem permitir que os usuários acessem outra fonte de dados (por exemplo, arquivos, fontes de dados não relacionais como Active Directory, entre outras) usando o contexto de segurança da conta Windows sob a qual o serviço SQL Server está rodando. O SQL Server representa o login de forma adequada para logins do Windows. No entanto, essa personificação não é possível para logins do SQL Server. Essa limitação pode potencialmente permitir que um usuário de consulta distribuída acesse outra fonte de dados para a qual não tem permissões, mas a conta sob a qual o serviço SQL Server está rodando possui permissões. Use sp_addlinkedsrvlogin para definir os logons específicos autorizados para acessar o servidor vinculado correspondente. Esse controle não está disponível para nomes ad hoc, então tenha cautela ao habilitar um provedor OLE DB para acesso ad hoc.
Quando possível, o Mecanismo de Banco de Dados envia operações relacionais como junções, restrições, projeções, classificações e operações de agrupar por para a fonte de dados OLE DB. O Mecanismo de Banco de Dados não usa o padrão para verificar a tabela base no SQL Server e executar as próprias operações relacionais. O Mecanismo de Banco de Dados consulta o provedor OLE DB para determinar o nível de gramática SQL que ele suporta e, com base nessas informações, envia o maior número possível de operações relacionais para o provedor.
O Mecanismo de Banco de Dados especifica um mecanismo para que um provedor OLE DB retorne estatísticas que indicam como os valores-chave são distribuídos dentro da fonte de dados OLE DB. Esse mecanismo permite que o Mecanismo de Banco de Dados Query Optimizer analise melhor o padrão de dados na fonte de dados em relação aos requisitos de cada instrução T-SQL, aumentando a capacidade do Query Optimizer de gerar planos de execução ótimos.
Processamento de consultas em tabelas e índices particionados
O Mecanismo de Banco de Dados suporta processamento de consultas conscientes de partições para tabelas e índices particionados. Esta seção descreve como o processador de consultas lida com objetos particionados, como interpretar planos de execução que envolvem particionamento e as melhores práticas para melhorar o desempenho das consultas em objetos particionados.
Observação
Tabelas e índices particionados são suportados na edição SQL Server Standard, a partir do SQL Server 2016 (13.x) com o Service Pack 1.
Nova operação de busca com reconhecimento de partição
No Mecanismo de Banco de Dados, o processador de consultas vê internamente uma tabela particionada como um índice multicoluna com PartitionID como coluna inicial.
PartitionID é uma coluna computada oculta, usada internamente para representar o ID da partição que contém uma linha específica. Por exemplo, suponha que a tabela T, definida como T(a, b, c), seja particionada na coluna a, e tenha um índice agrupado na coluna b. Essa tabela particionada é tratada como uma tabela não particionada com o esquema T(PartitionID, a, b, c) e um índice agrupado na chave composta (PartitionID, b). Essa representação permite que o Otimizador de Consultas realize operações de busca baseadas em PartitionID em qualquer tabela ou índice particionado.
Agora a eliminação de partição está concluída na operação de busca.
Além disso, o Otimizador de Consultas é estendido para que uma operação de busca ou varredura com uma condição possa ser feita em PartitionID (como a coluna inicial lógica) e possivelmente em outras colunas de chave de índice. O processador de consulta então realiza uma busca de segundo nível, com uma condição diferente, em uma ou mais colunas adicionais, para cada valor distinto que atenda à qualificação para a operação de busca de primeiro nível. Essa operação, chamada de partition skip scan, permite que o Otimizador de Consultas realize uma operação de busca ou varredura baseada em uma condição para determinar as partições a serem acessadas, e uma operação de busca de índice de segundo nível dentro desse operador para retornar linhas dessas partições que atendam a uma condição diferente. Por exemplo, considere a consulta abaixo.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Para este exemplo, suponha que a tabela T, definida como T(a, b, c), seja particionada na coluna a, e tenha um índice agrupado na coluna b. A seguinte função de partição define os limites de partição para a tabela T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Para solucionar a consulta, o processador de consulta realiza uma operação de busca de primeiro nível para encontrar todas as partições que contenham linhas que atendam à condição T.a < 10. Essa operação identifica as partições a serem acessadas. Dentro de cada partição identificada, o processador então realiza uma busca de segundo nível no índice clusterizado na coluna b para encontrar as linhas que atendem à condição T.b = 2 e T.a < 10.
A ilustração a seguir é uma representação lógica da operação de varredura com salto de partição. Ela mostra a tabela T com dados nas colunas a e b. As partições são numeradas de 1 a 4 com os limites de partição mostrados por linhas verticais tracejadas. Uma operação de busca de primeiro nível para as partições (não mostrada na ilustração) determina que as partições 1, 2 e 3 atendem à condição de busca implícita pelo particionamento definido para a tabela e o predicado na coluna a (T.a < 10). O caminho percorrido pela busca do segundo nível é ilustrado pela linha curva. Essencialmente, a operação busca em cada uma dessas partições linhas que atendem à condição b = 2. O custo total da operação é o mesmo de três buscas de índice separadas.
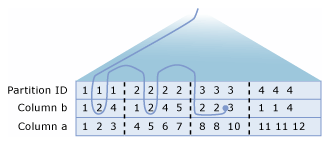
Exibir informações sobre particionamento em planos de execução de consultas
Analise os planos de execução das consultas em tabelas e índices particionados usando as instruções T-SQL SETSET SHOWPLAN_XML ou SET STATISTICS XML, ou usando a saída gráfica do plano de execução no SSMS. Por exemplo, você pode exibir o plano de execução em tempo de compilação selecionando Exibir Plano de Execução Estimado na barra de ferramentas do Editor de Consultas e o plano de execução em tempo de execução selecionando Incluir Plano de Execução Real.
Usando essas ferramentas, você pode encontrar as seguintes informações:
- As operações como varreduras, buscas, inserções, atualizações, mesclas e exclusão que acessam tabelas ou índices particionados.
- As partições acessadas pela consulta. Por exemplo, planos de execução em tempo de execução incluem a contagem total de partições acessadas e os intervalos de partições contíguas acessadas.
- Quando uma operação de varredura de salto de partição é usada em uma operação de busca ou varredura para recuperar dados de uma ou mais partições.
Aprimoramentos das informações sobre partições
O Mecanismo de Banco de Dados fornece informações aprimoradas de particionamento tanto para planos de execução em tempo de compilação quanto em tempo de execução. Agora, os planos de execução fornecem as seguintes informações:
- Um atributo opcional
Partitionedque indica que um operador, como buscar, varrer, inserir, atualizar, mesclar ou excluir, é executado em uma tabela particionada. - Um novo elemento
SeekPredicateNewcom um subelementoSeekKeysque incluiPartitionIDcomo a coluna de chave de índice à esquerda e as condições de filtro que especificam buscas de intervalo emPartitionID. A presença de doisSeekKeyssubelementos indica uma varredura de salto de partição emPartitionID. - Informações resumidas que fornecem uma contagem total das partições acessadas. Essas informações só estão disponíveis em planos de tempo de execução.
Para demonstrar como essas informações são exibidas tanto na saída do plano de execução gráfica quanto na saída do XML Showplan, considere a seguinte consulta na tabela particionada fact_sales. Esta consulta atualiza dados em duas partições.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
A ilustração a seguir mostra as propriedades do operador Clustered Index Seek no plano de execução de runtime dessa consulta. Para ver a definição da fact_sales tabela e a definição da partição, veja Exemplo.
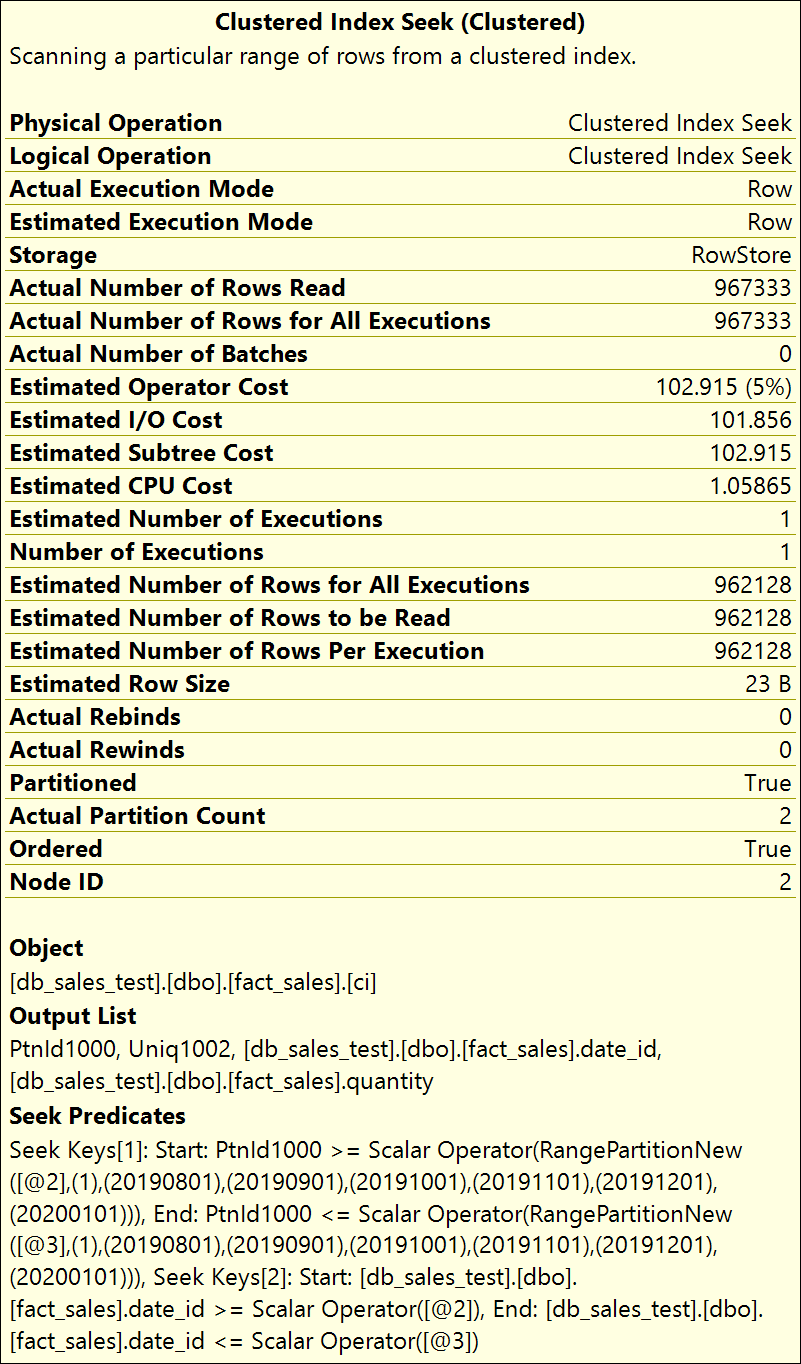
Atributo particionado
Quando um operador como Index Seek é executado em uma tabela ou índice particionado, o atributo Partitioned aparece no plano de tempo de compilação e em tempo de execução e é definido como True (1). O atributo não aparece quando está definido como False (0).
O atributo Partitioned pode ser exibido nos seguintes operadores físicos e lógicos:
- Verificação de Tabela
- Verificação de Índice
- Pesquisa de Índice
- Inserir
- Atualizar
- Excluir
- Mesclar
Como mostrado na ilustração anterior, esse atributo aparece nas propriedades do operador no qual está definido. Na saída do XML Showplan, esse atributo aparece como Partitioned="1" no nó RelOp do operador em que está definido.
Novo predicado de busca
Na saída do XML Showplan, o SeekPredicateNew elemento aparece no operador em que está definido. Ele pode conter até duas ocorrências de subelemento SeekKeys. O primeiro item SeekKeys especifica a operação de busca de primeiro nível no nível da ID da partição do índice lógico. Ou seja, essa operação de busca determina as partições que devem ser acessadas para satisfazer as condições da consulta. O segundo SeekKeys item especifica a busca de segundo nível que ocorre em cada partição identificada na busca de primeiro nível.
Informações resumidas sobre partições
Nos planos de execução ao vivo, as informações resumidas sobre partições fornecem uma contagem das partições acessadas e a identificação das partições reais acessadas. É possível usar essas informações para verificar se as partições corretas são acessadas na consulta e se todas as outras partições são eliminadas do exame.
As informações a seguir são fornecidas: Actual Partition Counte Partitions Accessed.
Actual Partition Count é o número total de partições acessadas pela consulta.
Partitions Accessed, na saída do Showplan XML, é a informação resumida da partição que aparece no novo RuntimePartitionSummary elemento no RelOp nó do operador em que está definida. O exemplo a seguir demonstra o conteúdo do elemento RuntimePartitionSummary , indicando que é acessado o total de duas partições (partições 2 e 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Exiba informações de partição usando outros métodos de showplan
Os métodos Showplan SHOWPLAN_ALL, SHOWPLAN_TEXT e STATISTICS PROFILE não relatam as informações de partição descritas neste artigo, com a seguinte exceção. Como parte do predicado SEEK , as partições a serem acessadas são identificadas por um predicado de intervalo na coluna computada representando a ID da partição. A exemplo a seguir mostra o predicado SEEK para um operador Clustered Index Seek . As partições 2 e 3 são acessadas e o operador de busca filtra as linhas que atendem à condição date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpretar planos de execução para heaps particionados
Um heap particionado é tratado como um índice lógico na ID da partição. Em um plano de execução, a eliminação de partições em um heap particionado é representada como um Table Scan operador com um SEEK predicado sobre o ID da partição. O exemplo a seguir mostra as informações do Showplan fornecidas:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpretar planos de execução para junções colocalizadas
Uma colocação de junção pode ocorrer quando duas tabelas são particionadas usando a mesma função de particionamento ou função equivalente e as colunas de particionamento de ambos os lados da junção são especificadas na condição de junção da consulta. O otimizador de consulta pode gerar um plano em que as partições de cada uma das tabelas que tenham IDs de partição iguais sejam unidas separadamente. As junções colocadas podem ser mais rápidas que as junções não colocadas porque podem exigir menos memória e tempo de processamento. O Otimizador de Consulta escolhe um plano não colocado ou colocado com base em estimativas de custo.
Em um plano colocado, a junção Nested Loops lê uma ou mais partições de índice e tabela unidas a partir da parte interna. Os números dos operadores Constant Scan representam os números de partições.
Quando planos paralelos para junções colocadas são gerados para tabelas ou índices particionados, um operador Parallelism é exibido entre os operadores de junção Constant Scan e Nested Loops. Nesse caso, cada um dos vários threads de trabalho da parte externa da junção lê e trabalha em uma partição diferente.
A ilustração a seguir demonstra um plano de consulta paralelo para uma junção colocada.
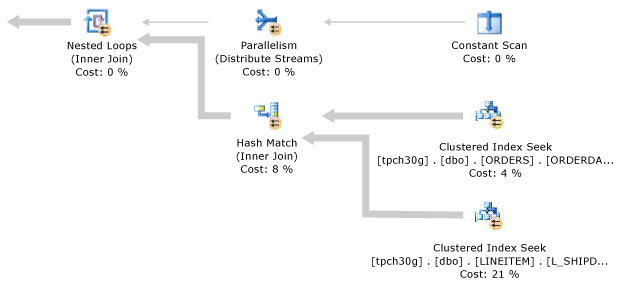
Estratégias de execução de consulta paralela para objetos particionados
O processador de consulta usa uma estratégia de execução paralela para consultas selecionadas a partir de objetos particionados. Como parte da estratégia de execução, o processador de consulta determina as partições de tabela necessárias para a consulta e a proporção de threads de trabalho a serem alocados para cada partição. Na maioria dos casos, o processador de consulta aloca um número igual ou aproximado de threads de trabalho para cada partição e executa a consulta paralelamente por meio das partições. Os parágrafos a seguir explicam a alocação de thread de trabalho com mais detalhes.
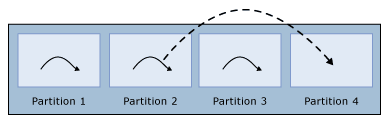
Se o número de threads de trabalho é menor que o número de partições, o processador de consulta atribui cada thread de trabalho a uma partição diferente, inicialmente, mantendo uma ou mais partições sem um thread de trabalho atribuído. Quando uma thread de trabalho termina de executar em uma partição, o processador de consulta a atribui à próxima partição até que cada partição receba uma única thread de trabalho. Essa atribuição é o único caso em que o processador de consulta realoca threads de trabalho para outras partições.
Mostra o thread de trabalho reatribuído após a conclusão. Se o número de threads de trabalho é igual ao número de partições, o processador de consulta atribui um thread de trabalho para cada partição. Quando um thread de trabalho é concluído, ele não é realocado para outra partição.
Se o número de threads de trabalho é maior que o número de partições, o processador de consulta aloca um número igual de threads de trabalho para cada partição. Se o número de threads worker não for um múltiplo exato do número de partições, o processador de consulta aloca um thread worker extra para algumas partições para usar todos os threads de trabalho disponíveis. Se houver apenas uma partição, todas as threads de trabalho são atribuídas a essa partição. No diagrama a seguir, há quatro partições e 14 threads de trabalho. Cada partição tem três threads de trabalho atribuídos, e duas partições têm uma thread de trabalho extra, totalizando 14 atribuições de threads de trabalho. Quando um thread de trabalho é concluído, ele não é reatribuído para outra partição.
Embora os exemplos anteriores sugiram uma forma direta de alocar threads de trabalho, a estratégia real é mais complexa e leva em conta outras variáveis que ocorrem durante a execução da consulta. Por exemplo, se a tabela for particionada e tiver um índice agrupado na coluna A e uma consulta tiver o predicado WHERE A IN (13, 17, 25), o processador de consulta aloca uma ou mais threads de trabalho para cada um desses três valores de busca (A = 13, A = 17 e A = 25) em vez de cada partição da tabela. Só é necessário executar a consulta nas partições que contêm esses valores, e se todos esses predicados de busca estiverem na mesma partição de tabela, todos os threads de trabalho são atribuídos à mesma partição de tabela.
Para pegar outro exemplo, suponha que a tabela tenha quatro partições em coluna A com pontos de fronteira (10, 20, 30), um índice em uma coluna B, e a consulta tenha uma cláusula WHERE B IN (50, 100, 150)de predicado . Como as partições de tabela são baseadas nos valores de A, os valores de B podem ocorrer em qualquer uma das partições de tabela. Assim, o processador de consulta busca cada um dos três valores de B (50, 100, 150) em cada uma das quatro partições de tabela. O processador de consultas atribui threads de trabalho proporcionalmente para que possa executar cada uma dessas 12 varreduras de consulta em paralelo.
Partições de tabela baseadas em coluna A |
Busca coluna B em cada partição de tabela |
|---|---|
Partição da Tabela 1: A < 10 |
B = 50
B = 100, B = 150 |
Partição da Tabela 2: A >= 10 AND A < 20 |
B = 50
B = 100, B = 150 |
Partição da Tabela 3: A >= 20 AND A < 30 |
B = 50
B = 100, B = 150 |
Partição da Tabela 4: A >= 30 |
B = 50
B = 100, B = 150 |
Práticas recomendadas
Para melhorar o desempenho das consultas que acessam uma grande quantidade de dados de grandes tabelas e índices particionados, siga estas melhores práticas:
Distribuir cada partição em muitos discos. Essa abordagem é especialmente relevante ao usar discos rígidos mecânicos.
Quando possível, use um servidor com memória principal suficiente para acomodar partições acessadas com frequência, ou todas as partições na memória, para reduzir o custo de E/S.
Se os dados que você consulta não caberem na memória, comprima as tabelas e índices para reduzir o custo de E/S.
Usar um servidor com processadores rápidos e o máximo possível de núcleos de processador, para se beneficiar da capacidade de processamento de consultas paralelas.
Verificar se o servidor tem largura de banda suficiente do controlador de E/S.
Criar um índice clusterizado em todas as tabelas particionadas grandes para beneficiar-se de otimizações de exames da árvore B.
Ao carregar dados em massa em tabelas particionadas, siga as recomendações de melhores práticas no white paper, Guia de Desempenho de Carregamento de Dados.
Exemplo
O exemplo a seguir cria um banco de dados de teste que contém uma única tabela com sete partições. Para visualizar informações de particionamento tanto para planos de compilação quanto de tempo de execução, use as ferramentas descritas em Exibir informações de particionamento em planos de execução de consultas ao executar as consultas neste exemplo.
Observação
Este exemplo insere mais de 1 milhão de linhas na tabela. A execução deste exemplo pode demorar vários minutos, dependendo de seu hardware. Antes de executar este exemplo, verifique se há mais de 1.5 GB de espaço em disco disponível.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Conteúdo relacionado
- Referência de operadores lógicos e físicos do plano de execução
- Visão geral de eventos estendidos
- Melhores práticas para monitorar cargas de trabalho com o Repositório de Consultas
- Estimativa de cardinalidade (SQL Server)
- Processamento inteligente de consultas em bancos de dados SQL
- Precedência dos operadores (Transact-SQL)
- Visão geral do plano de execução
- Central de desempenho do Mecanismo de Banco de Dados do SQL Server e do Banco de Dados SQL do Azure