Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Este artigo faz parte de uma série. Comece com a visão geral.
Se as verificações de cluster que você executou na etapa anterior estiverem limpas, verifique a integridade dos nós de trabalho do Serviço Kubernetes do Azure (AKS). Siga os seis passos deste artigo para verificar o estado dos nós, determinar a razão pela qual um nó não está em bom estado e resolver o problema.
Observação
Antes de iniciar a triagem manual, verifique se a reparação automática dos nós do AKS já está a tentar efetuar a remediação. O AKS reinicia automaticamente, recria a imagem e, por fim, reimplementa qualquer nó que permaneça no estado NotReady durante mais de cinco minutos. A plataforma emite eventos Kubernetes a partir da aks-auto-repair fonte para cada etapa de remediação, incluindo NodeRebootStart, NodeReimageStart, NodeRedeployStart, e os respetivos eventos finais. Se um nó entrou recentemente em ou saiu de reparação automática, tenha esse facto em conta na sua investigação. Para falhas de reparação, consulte Resolução de problemas de erros de autoreparação de nós.
Etapa 1: Verifique a integridade dos nós de trabalho
Vários fatores podem contribuir para nós com problemas num cluster AKS. Uma razão comum é a quebra de comunicação entre o plano de controle e os nós. Essa falha de comunicação geralmente é causada por configurações incorretas nas regras de roteamento e firewall.
Quando configura o seu cluster AKS para encaminhamento definido pelo utilizador, deve configurar caminhos de saída através de um dispositivo virtual de rede (NVA) ou de um firewall, como um firewall Azure. Para resolver um problema de má configuração, configure o firewall para permitir as portas necessárias e os nomes de domínio totalmente qualificados (FQDNs) de acordo com as orientações de tráfego de saída do AKS.
Outra razão para nós não íntegros pode ser recursos inadequados de computação, memória ou armazenamento que criam pressões kubelet. Nesses casos, a ampliação dos recursos pode efetivamente resolver o problema.
Em um cluster AKS privado, problemas de resolução do Sistema de Nomes de Domínio (DNS) podem causar problemas de comunicação entre o plano de controle e os nós. Você deve verificar se o nome DNS do servidor de API do Kubernetes é resolvido para o endereço IP privado do servidor de API. A configuração incorreta de um servidor DNS personalizado é uma causa comum de falhas de resolução de DNS. Se você usar servidores DNS personalizados, certifique-se de especificá-los corretamente como servidores DNS na rede virtual onde os nós são provisionados. Confirme também que o servidor de API privado AKS pode ser resolvido através do servidor DNS personalizado.
Depois de resolver estes potenciais problemas relacionados com a comunicação do plano de controlo e resolução DNS, pode resolver eficazmente os problemas de saúde dos nós dentro do seu cluster AKS.
Você pode avaliar a integridade de seus nós usando um dos seguintes métodos.
AKS Diagnosticar e Resolver Problemas
Diagnosticar e Resolver Problemas no portal do Azure executa detetores com reconhecimento do cluster no seu cluster e apresenta as conclusões e as ações recomendadas. Utilize-o como o seu primeiro recurso para a triagem do estado dos nós, porque apresenta problemas conhecidos, como pressão no kubelet, eventos programados, problemas de conectividade e falhas na obtenção de imagens, sem necessidade de executar consultas.
- No portal do Azure, vá para o cluster AKS.
- No painel de navegação, selecione Diagnosticar e resolver problemas.
- Selecione uma categoria como Node Health ou Cluster Insights para visualizar os problemas detetados e os próximos passos recomendados.
Azure Copilot para AKS
Azure Copilot executa diagnósticos AKS em resposta a prompts em linguagem natural e resume os resultados. Pedidos como "Como verificar a saúde do nó do AKS?" ou "diagnosticar a saúde dos nós do meu cluster AKS" fazem com que o Copilot execute os detetores relevantes no cluster de destino e devolva ligações para orientações adicionais. O Copilot também pode implementar ferramentas de diagnóstico como o AKS Periscope e o CanIPull no cluster quando solicitado.
Eventos do Kubernetes
Os eventos Kubernetes captam alterações no ciclo de vida de nós, pods e outros objetos. Eventos provenientes de fontes como aks-auto-repair, node-problem-detector, kubelet, e o escalonador são o sinal mais direto de um problema ao nível do nó.
Execute o seguinte comando para listar eventos a nível de cluster ordenados por tempo:
kubectl get events --all-namespaces --sort-by='.lastTimestamp'
Para ver os eventos de um nó específico, execute:
kubectl describe node <node-name>
Também pode visualizar eventos no portal Azure em Recursos>Kubernetes Eventos. O Kubernetes mantém os eventos por uma hora por defeito. Para reter eventos por mais tempo, ativa insights do Container. Os eventos podem então ser consultados na tabela KubeEvents no espaço de trabalho do Log Analytics associado, e pode criar alertas com base nos mesmos utilizando alertas de registo do Azure Monitor.
Visualização de saúde dos contentores no Azure Monitor
Para visualizar a integridade de nós, pods de usuário e pods de sistema no seu cluster AKS, siga estas etapas:
- No portal do Azure, aceda a Azure Monitor.
- Na seção Informações do painel de navegação, selecione Contêineres.
- Selecione Clusters monitorados para obter uma lista dos clusters AKS que estão sendo monitorados.
- Escolha um cluster AKS na lista para visualizar a integridade dos nós, pods de usuário e pods de sistema.

Visualização de nós AKS
Para garantir que todos os nós no cluster AKS estejam no estado pronto, siga estas etapas:
- No portal do Azure, vá para o cluster AKS.
- Na seção Configurações do painel de navegação, selecione Pools de nós.
- Selecione Nós.
- Verifique se todos os nós estão no estado de prontidão.

Monitorização em cluster com Prometheus e Grafana
Se você implantou o Prometheus e o Grafana em seu cluster AKS, poderá usar o Painel de Detalhes do Cluster K8 para obter informações. Este painel mostra métricas de cluster Prometheus e apresenta informações vitais, como uso de CPU, uso de memória, atividade de rede e uso do sistema de arquivos. Ele também mostra estatísticas detalhadas para pods individuais, contêineres e serviços systemd .
No painel, selecione Condições do Nó para ver as métricas sobre a integridade e o desempenho do cluster. Pode monitorizar nós que possam ter problemas, como problemas de agendamento, de rede, sobrecarga de disco, sobrecarga de memória, sobrecarga de PID ou falta de espaço em disco. Monitorize estas métricas para que possa identificar e resolver proativamente quaisquer problemas potenciais que afetem a disponibilidade e o desempenho do seu cluster AKS.

Serviço gerido do Azure Monitor para Prometheus e Azure Managed Grafana
Você pode usar painéis pré-criados para visualizar e analisar as métricas do Prometheus. Para isso, configure o seu cluster AKS para recolher métricas Prometheus no serviço gerido Azure Monitor para Prometheus e ligue o seu espaço de trabalho Azure Monitor a um Azure Managed Grafana. Esses painéis fornecem uma visão abrangente do desempenho e da integridade do cluster Kubernetes.
Os painéis são provisionados na instância especificada do Azure Managed Grafana na pasta Managed Prometheus . Os dashboards incluem:
- Kubernetes / Recursos de computação / Cluster
- Kubernetes / Recursos de computação / Namespace (Pods)
- Kubernetes / Recursos de Computação / Nó (Pods)
- Kubernetes / Recursos de computação / Pod
- Kubernetes / Recursos de computação / Namespace (cargas de trabalho)
- Kubernetes / Recursos de computação / Carga de trabalho
- Kubernetes / Kubelet
- Node Exporter / Método USE / Nó
- Node Exporter / Nós
- Kubernetes / Recursos de computação / Cluster (Windows)
- Kubernetes / Recursos de computação / Namespace (Windows)
- Kubernetes / Recursos de computação / Pod (Windows)
- Kubernetes / Método USE / Cluster (Windows)
- Kubernetes / Método USE / Nó (Windows)
Esses painéis integrados são amplamente utilizados na comunidade de código aberto para monitorar clusters Kubernetes com Prometheus e Grafana. Use esses painéis para ver métricas, como uso de recursos, integridade do pod e atividade de rede. Você também pode criar painéis personalizados que são adaptados às suas necessidades de monitoramento. Os dashboards ajudam-no a monitorizar e analisar eficazmente as métricas Prometheus no seu cluster AKS, o que lhe permite otimizar o desempenho, resolver problemas e garantir o funcionamento fluido das suas cargas de trabalho Kubernetes.
Você pode usar o painel Kubernetes / Recursos de computação / Nó (Pods) para ver as métricas dos nós do agente Linux. Você pode visualizar o uso da CPU, a cota da CPU, o uso da memória e a cota de memória para cada pod.

Se o cluster incluir nós de agente do Windows, você poderá usar o painel Kubernetes / Método USE / Nó (Windows) para visualizar as métricas do Prometheus coletadas desses nós. Este painel fornece uma visão abrangente do consumo de recursos e do desempenho dos nós Windows no seu cluster.
Aproveite esses painéis dedicados para que você possa monitorar e analisar métricas importantes relacionadas à CPU, memória e outros recursos nos nós de agente Linux e Windows. Essa visibilidade permite identificar possíveis gargalos, otimizar a alocação de recursos e garantir uma operação eficiente em todo o cluster AKS.
Etapa 2: Verificar a conectividade do plano de controle e do nó de trabalho
Se os nós de trabalho estiverem em bom estado, examine a conectividade entre o plano de controlo gerido do AKS e os nós de trabalho do cluster. O modelo de conectividade depende se o seu cluster utiliza ou não a Integração VNet do API Server:
Com API Server VNet Integration (recomendado para novos clusters). O servidor API é projetado numa sub-rede delegada na sua rede virtual atrás de um balanceador de carga interno. O tráfego entre o nó e o servidor da API permanece na rede privada, e não é necessário qualquer túnel. O Konnectivity continua a ser implementado quando o cluster utiliza o Azure CNI (Container Networking Interface) Overlay ou o Bring Your Own CNI (BYO CNI), porque o servidor API precisa de um túnel para alcançar IPs pod que não são diretamente roteáveis. Com o Azure CNI (incluindo atribuição dinâmica de IP pod), o Konnectivity não é implementado de todo.
Sem integração de VNet com servidor API. O AKS implementa um túnel Konnectivity (anteriormente apiserver-network-proxy) protegido com TLS mútuo para transportar todo o tráfego entre o servidor API gerido e os nós e pods do cluster.
Para confirmar qual o modelo que o seu cluster utiliza, execute:
az aks show --name <aks-name> --resource-group <resource-group-name> --query "apiServerAccessProfile.enableVnetIntegration" --output tsv
Se enableVnetIntegration for true e kubectl get deployment konnectivity-agent -n kube-system --no-headers não devolver nenhum pod, este passo não se aplica: o seu cluster não usa Konnectivity. Valide diretamente a conectividade entre nós e pods, utilizando os comandos kubectl e seguindo os passos nslookup no Passo 3.
Se o Konnectivity estiver presente, certifique-se de que todas as regras de rede e FQDNs estão em conformidade com as regras de rede do Azure necessárias e utilize a ferramenta de linha de comandos kubectl para verificar o túnel.
Para garantir que os pods do agente Konnectivity funcionem corretamente, execute o seguinte comando:
kubectl get deploy konnectivity-agent -n kube-system
Certifique-se de que os pods estão em um estado pronto.
Se houver um problema com a conectividade entre o plano de controlo e os nós de trabalho, estabeleça a conectividade depois de garantir que o tráfego de saída exigido pelas regras obrigatórias do AKS é permitido.
Execute o seguinte comando para reiniciar os konnectivity-agent pods:
kubectl rollout restart deploy konnectivity-agent -n kube-system
Se o reiniciar dos pods não corrigir o problema de conexão, verifique os logs em busca de anomalias. Execute o seguinte comando para visualizar os logs dos pods konnectivity-agent:
kubectl logs -l app=konnectivity-agent -n kube-system --tail=50
Os logs devem mostrar a seguinte saída:
I1012 12:27:43.521795       1 options.go:102] AgentCert set to "/certs/client.crt".
I1012 12:27:43.521831       1 options.go:103] AgentKey set to "/certs/client.key".
I1012 12:27:43.521834       1 options.go:104] CACert set to "/certs/ca.crt".
I1012 12:27:43.521837       1 options.go:105] ProxyServerHost set to "sethaks-47983508.hcp.switzerlandnorth.azmk8s.io".
I1012 12:27:43.521841       1 options.go:106] ProxyServerPort set to 443.
I1012 12:27:43.521844       1 options.go:107] ALPNProtos set to [konnectivity].
I1012 12:27:43.521851       1 options.go:108] HealthServerHost set to
I1012 12:27:43.521948       1 options.go:109] HealthServerPort set to 8082.
I1012 12:27:43.521956       1 options.go:110] AdminServerPort set to 8094.
I1012 12:27:43.521959       1 options.go:111] EnableProfiling set to false.
I1012 12:27:43.521962       1 options.go:112] EnableContentionProfiling set to false.
I1012 12:27:43.521965       1 options.go:113] AgentID set to b7f3182c-995e-4364-aa0a-d569084244e4.
I1012 12:27:43.521967       1 options.go:114] SyncInterval set to 1s.
I1012 12:27:43.521972       1 options.go:115] ProbeInterval set to 1s.
I1012 12:27:43.521980       1 options.go:116] SyncIntervalCap set to 10s.
I1012 12:27:43.522020       1 options.go:117] Keepalive time set to 30s.
I1012 12:27:43.522042       1 options.go:118] ServiceAccountTokenPath set to "".
I1012 12:27:43.522059       1 options.go:119] AgentIdentifiers set to .
I1012 12:27:43.522083       1 options.go:120] WarnOnChannelLimit set to false.
I1012 12:27:43.522104       1 options.go:121] SyncForever set to false.
I1012 12:27:43.567902       1 client.go:255] "Connect to" server="e9df3653-9bd4-4b09-b1a7-261f6104f5d0"
Você também pode pesquisar os logs do contentor no serviço de registo e monitorização para os recuperar. Para um exemplo que pesquise erros de conectividade do Konnectivity, consulte Consultar registos das Informações do Contentor.
Execute a seguinte consulta para recuperar os logs:
ContainerLogV2
| where _ResourceId =~ "/subscriptions/<subscription-ID>/resourceGroups/<resource-group-name>/providers/Microsoft.ContainerService/managedClusters/<cluster-ID>" // Use the IDs and names of your resources for these values.
| where ContainerName has "konnectivity-agent"
| project LogSource,LogMessage, TimeGenerated, Computer, PodName, ContainerName, ContainerId
| order by TimeGenerated desc
| limit 200
Execute a seguinte consulta para pesquisar logs de contêiner para qualquer pod com falha em um namespace específico:
let KubePodInv = KubePodInventory
    | where TimeGenerated >= startTime and TimeGenerated < endTime
    | where _ResourceId =~ "<cluster-resource-ID>" // Use your resource ID for this value.
    | where Namespace == "<pod-namespace>" // Use your target namespace for this value.
    | where PodStatus == "Failed"
    | extend ContainerId = ContainerID
    | summarize arg_max(TimeGenerated, *)  by  ContainerId, PodStatus, ContainerStatus
    | project ContainerId, PodStatus, ContainerStatus;

    KubePodInv
    | join
    (
        ContainerLogV2
    | where TimeGenerated >= startTime and TimeGenerated < endTime
    | where PodNamespace == "<pod-namespace>" //update with target namespace
    ) on ContainerId
    | project TimeGenerated, PodName, PodStatus, ContainerName, ContainerId, ContainerStatus, LogMessage, LogSource
Se não conseguires obter os logs usando consultas ou a ferramenta kubectl, usa kubectl debug para te ligares ao nó. Este exemplo inspeciona o pod konnectivity-agent depois de estabelecer ligação ao nó:
kubectl get pods -n kube-system -o wide | grep konnectivity-agent
kubectl debug node/<node-name> -it --image=mcr.microsoft.com/azurelinux/busybox:1.37
Depois de estabelecer ligação ao nó através do pod de depuração, execute os seguintes comandos:
chroot /host
crictl ps | grep konnectivity
crictl logs <konnectivity-container-id>
nslookup <api-server_fqdn>
Etapa 3: Validar a resolução de DNS ao restringir a saída
A resolução de DNS é um aspeto crucial do seu cluster AKS. Se a resolução DNS não estiver funcionando corretamente, isso pode causar erros de plano de controle ou falhas de extração de imagem de contêiner. Para garantir que a resolução DNS para o servidor de API do Kubernetes esteja funcionando corretamente, siga estas etapas:
Execute o comando kubectl exec para abrir um shell de comando no contêiner que está sendo executado no pod.
kubectl exec --stdin --tty your-pod --namespace <namespace-name> -- /bin/bashVerifica se a ferramenta nslookup ou dig está instalada no contentor.
Se nenhuma das ferramentas estiver instalada no pod, execute o seguinte comando para criar um pod utilitário no mesmo namespace.
kubectl run -i --tty busybox --image=mcr.microsoft.com/azurelinux/busybox:1.36 --namespace <namespace-name> --rm=true -- shVocê pode recuperar o endereço do servidor de API na página de visão geral do cluster AKS no portal do Azure ou executar o seguinte comando.
az aks show --name <aks-name> --resource-group <resource-group-name> --query fqdn --output tsvExecute o seguinte comando para tentar resolver o servidor API AKS. Para obter mais informações, consulte Solucionar problemas de falhas na resolução de DNS dentro do pod, mas não no nó de trabalho.
nslookup myaks-47983508.hcp.westeurope.azmk8s.ioVerifique o servidor DNS upstream do pod para determinar se a resolução DNS está funcionando corretamente. Por exemplo, para DNS do Azure, execute o
nslookupcomando:nslookup microsoft.com 168.63.129.16Se os passos anteriores não permitirem tirar conclusões, ligue-se a um dos nós de trabalho e tente efetuar a resolução de DNS a partir desse nó. Esta etapa ajuda a identificar se o problema está relacionado ao AKS ou à configuração de rede.
Se a resolução de DNS for bem-sucedida a partir do nó, mas não do pod, o problema pode estar relacionado ao DNS do Kubernetes. Para conhecer os passos para diagnosticar a resolução de DNS do pod, consulte a seção de Solução de problemas de falhas de resolução de DNS.
Se a resolução DNS falhar a partir do nó de rede, revise a configuração de rede para garantir que os caminhos e portas de roteamento apropriados estejam abertos para facilitar a resolução DNS.
Etapa 4: Verificar se há erros de kubelet
Verifique a condição do processo kubelet que está a ser executado em cada nó de trabalho e certifique-se de que não está sobrecarregado. A pressão potencial pode pertencer à CPU, memória ou armazenamento. Para verificar o estado dos kubelets de nós individuais, pode usar um dos seguintes métodos.
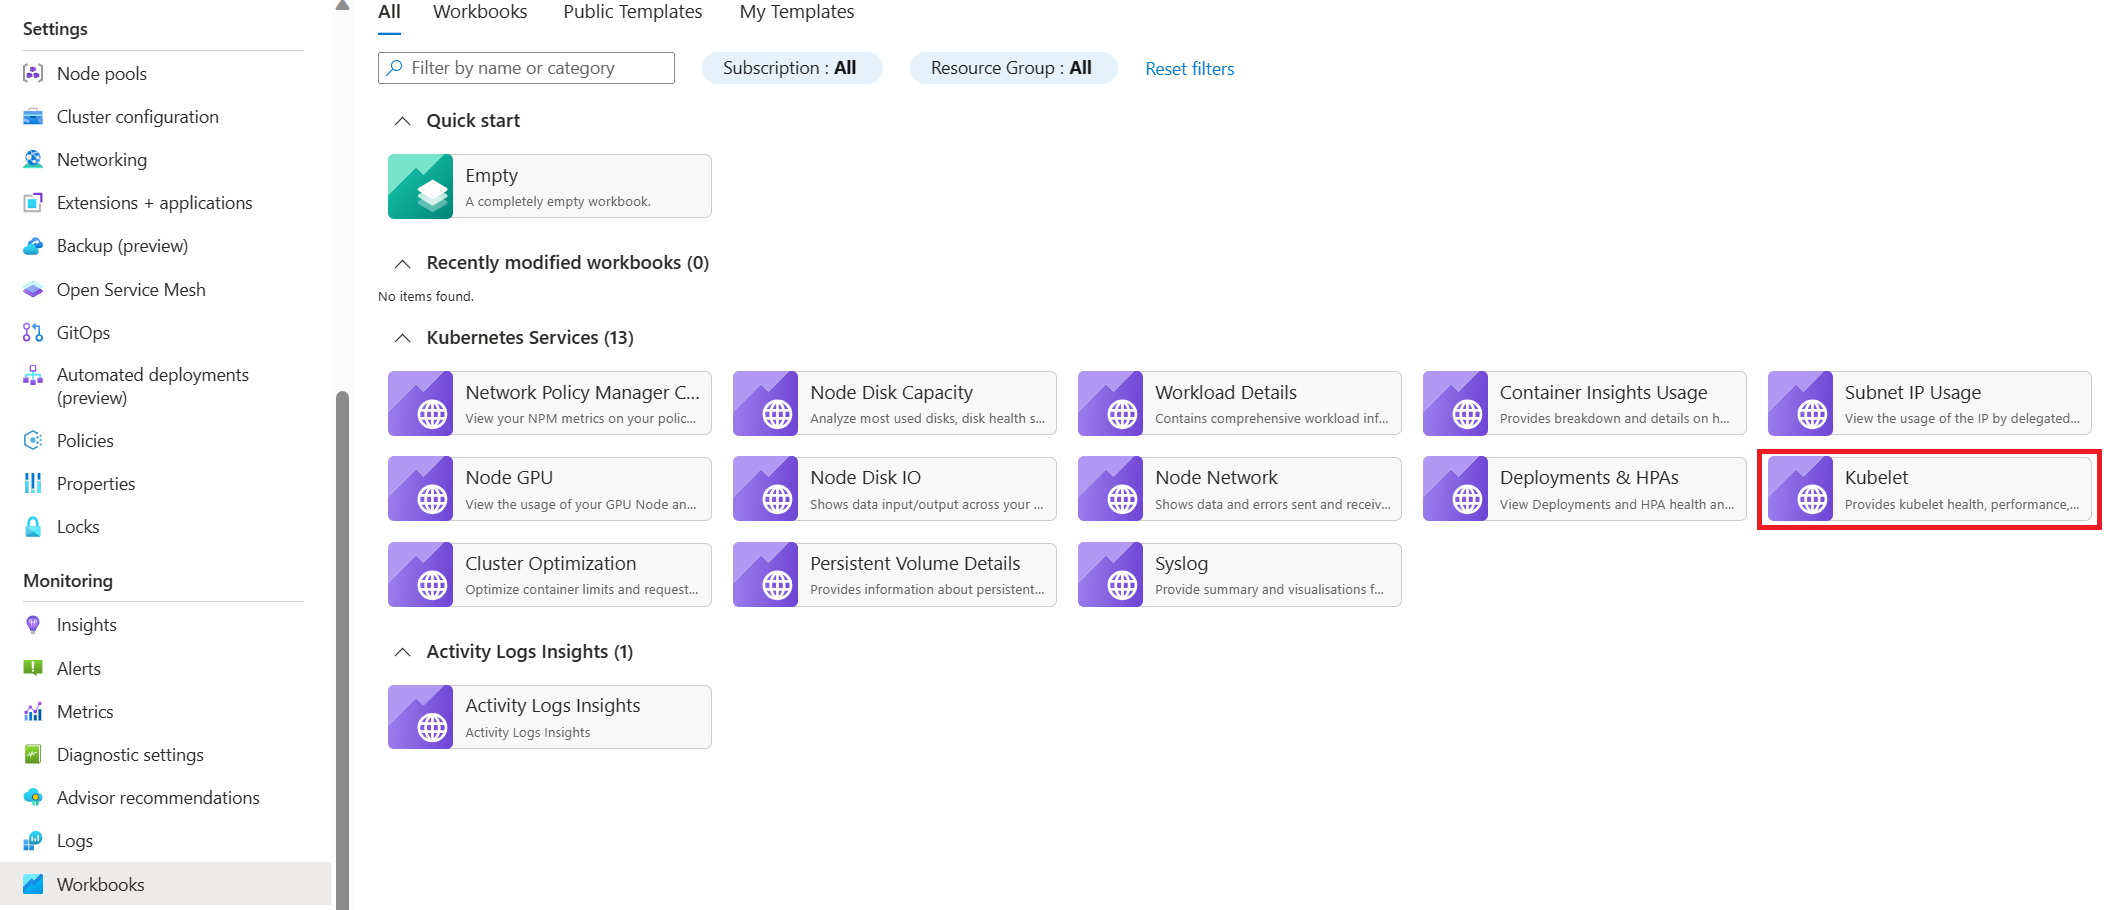
Pasta de trabalho do kubelet do AKS
Para garantir que os kubelets do nó do agente funcionem corretamente, siga estas etapas:
Aceda ao cluster do AKS no portal do Azure.
Na seção Monitoramento do painel de navegação, selecione Pastas de trabalho.
Selecione o livro de trabalho Kubelet.
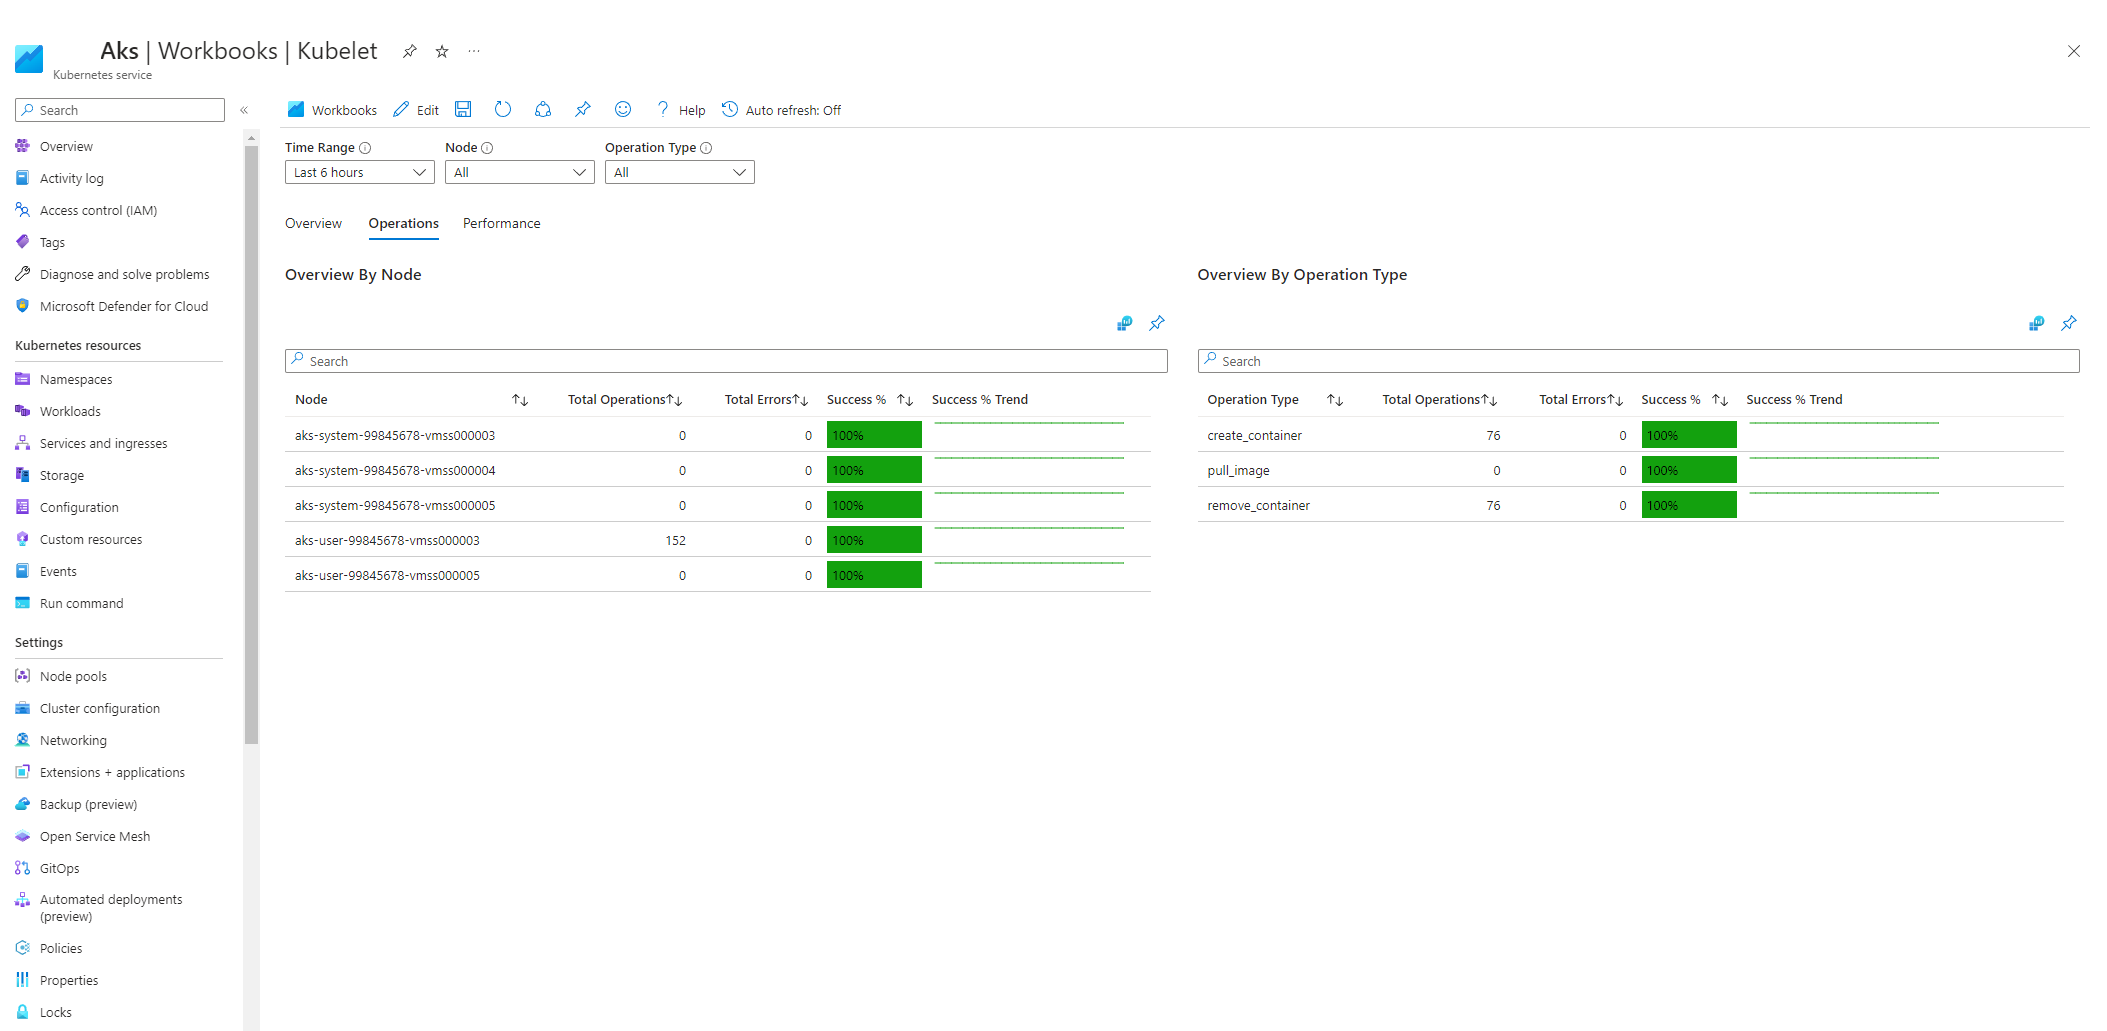
Selecione Operações e certifique-se de que as operações de todos os nós de processamento estão concluídas.


Monitorização em cluster com Prometheus e Grafana
Se implementou o Prometheus e o Grafana no seu cluster AKS, pode utilizar o dashboard Kubernetes / Kubelet para obter informações sobre a saúde e o desempenho dos kubelets de cada nó.

Serviço gerido do Azure Monitor para Prometheus e Azure Managed Grafana
Você pode usar o painel pré-construído do Kubernetes / Kubelet para visualizar e analisar as métricas do Prometheus para os kubelets do nó de trabalho. Para configurar este painel, configure o seu cluster AKS para recolher métricas Prometheus no serviço gerido Azure Monitor para Prometheus, e ligue o seu espaço de trabalho Azure Monitor a um espaço de trabalho Azure Managed Grafana.

A pressão aumenta quando um kubelet reinicia e causa um comportamento esporádico e imprevisível. Certifique-se de que a contagem de erros não aumenta continuamente. Um erro ocasional é aceitável, mas um aumento constante indica um problema subjacente que deve investigar e resolver.
Etapa 5: Use a ferramenta NPD (detetor de problemas do nó) para verificar a integridade do nó
O NPD é um daemon do Kubernetes que deteta e reporta problemas ao nível do nó. O AKS instala e ativa o NPD nos nós Linux por predefinição, através da extensão Linux do AKS, pelo que não é necessária qualquer configuração adicional. Para obter detalhes, consulte NPD em nós do AKS.
O NPD reporta duas categorias de sinais:
Condições do nó. Estados persistentes anexados ao
Nodeobjeto, comoKernelDeadlock,ReadonlyFilesystem,FilesystemCorruptionProblem,KubeletProblem,ContainerRuntimeProblem, eVMEventScheduled. O escalonador Kubernetes utiliza estas condições para evitar colocar novos pods em nós que reportem problemas.Eventos. Ocorrências discretas e com limite temporal como
OOMKilling,TaskHung,DNSProblem,KernelOops,EgressBlocked, , e notificações de eventos agendados (FreezeScheduled,RebootScheduled,RedeployScheduled,TerminateScheduled, ePreemptScheduled).
Visualizar as condições do nó usando kubectl describe node <node-name>. Veja eventos emitidos por NPD usando kubectl get events --field-selector source=node-problem-detector. Estes eventos também fluem através do pipeline de eventos Kubernetes descrito no passo 1, por isso qualquer retenção ou alerta que configure aí aplica-se à saída NPD.
Métricas de Prometheus a partir do NPD
O NPD expõe uma problem_gauge métrica através da porta 20257 de cada nó. Quando este endpoint é recolhido pelo serviço gerido do Azure Monitor para Prometheus, pode criar painéis e alertas sobre as condições dos nós em toda a frota. Consulte NPD nos nós AKS para obter um exemplo de configuração de recolha.
Monitorização da saúde da GPU
Para conjuntos de nós com GPUs, o AKS estende o NPD com detetores específicos de GPU. A NPD reporta condições como XIDErrors, NVLinkStatusInactive, IBLinkFlapping, GPUClockThrottling, GPUMissing, e UnhealthyNvidiaDevicePlugin. Podes combinar estas condições com a problem_gauge métrica para detetar GPUs com falhas antes de as cargas de treino ou inferência se degradarem. Para mais detalhes, veja monitorização da saúde da GPU.
Passo 6: Verifique a condição do nó DiskPressure
O kubelet define a condição do nó DiskPressure como True quando o espaço disponível em disco ou o número de inodes de um nó fica abaixo do limiar de evicção. Também contamina o nó com node.kubernetes.io/disk-pressure:NoSchedule, expulsa pods para recuperar espaço e impede o agendador de colocar novos pods no nó até que a condição seja resolvida.
Para verificar DiskPressure num único nó, execute o seguinte comando:
kubectl describe node <node-name>
Veja a Conditions secção. Um nó saudável indica DiskPressure: False.
Para verificar DiskPressure em todos os nós ao mesmo tempo, execute este comando:
kubectl get nodes -o jsonpath='{range .items[*]}{.metadata.name}{"\t"}{.status.conditions[?(@.type=="DiskPressure")].status}{"\n"}{end}'
O kubelet avalia dois sistemas de ficheiros de forma independente:
-
nodefs. O sistema de ficheiros raiz que armazena o estado do kubelet, os registos de contentores e os volumes emptyDir. -
imagefs. O sistema de ficheiros que contém imagens de contentores e camadas de contentores graváveis. No AKS,imagefsé o mesmo volume quenodefs, a menos que configure um armazenamento de imagens separado.
Para os limiares predefinidos de remoção, consulte remoção devido à pressão no nó.
Para resolver DiskPressure:
Identifica o que está a consumir o disco. Usa
kubectldebug para te ligares ao nó, depois executadf -hedu -sh /var/lib/* /var/log/*. Os elementos mais comuns incluem registos dos contentores em/var/log/containers, as imagens dos contentores mantidas pelo runtime dos contentores e os volumes emptyDir.Se uma carga de trabalho for a causa, fixe a aplicação para limitar a utilização do disco em vez de aumentar a capacidade. Por exemplo, limitar o volume dos registos, enviar os registos para fora do nó através de um sidecar, ou mover grandes conjuntos de dados de trabalho para um volume persistente.
Se o conjunto de trabalho legítimo exceder a capacidade do disco do sistema operativo, aumente o tamanho do disco do sistema operativo no pool de nós. Não podes alterar o tamanho do disco do sistema operativo de um pool de nós já existente. Crie um novo pool de nós com um
--node-osdisk-sizemaior, ou com um SKU de VM maior ao utilizar discos efémeros do sistema operativo; em seguida, migre as cargas de trabalho concluindo o procedimento Redimensionar pools de nós no AKS antes de eliminar o pool original.
Passo 7: Verifique as operações de E/S do disco por segundo (IOPS) para throttling
Para garantir que as IOPS não estejam sendo limitadas e afetando serviços e cargas de trabalho dentro do cluster AKS, você pode usar um dos seguintes métodos.
Livro de trabalho de I/O de disco do nó AKS
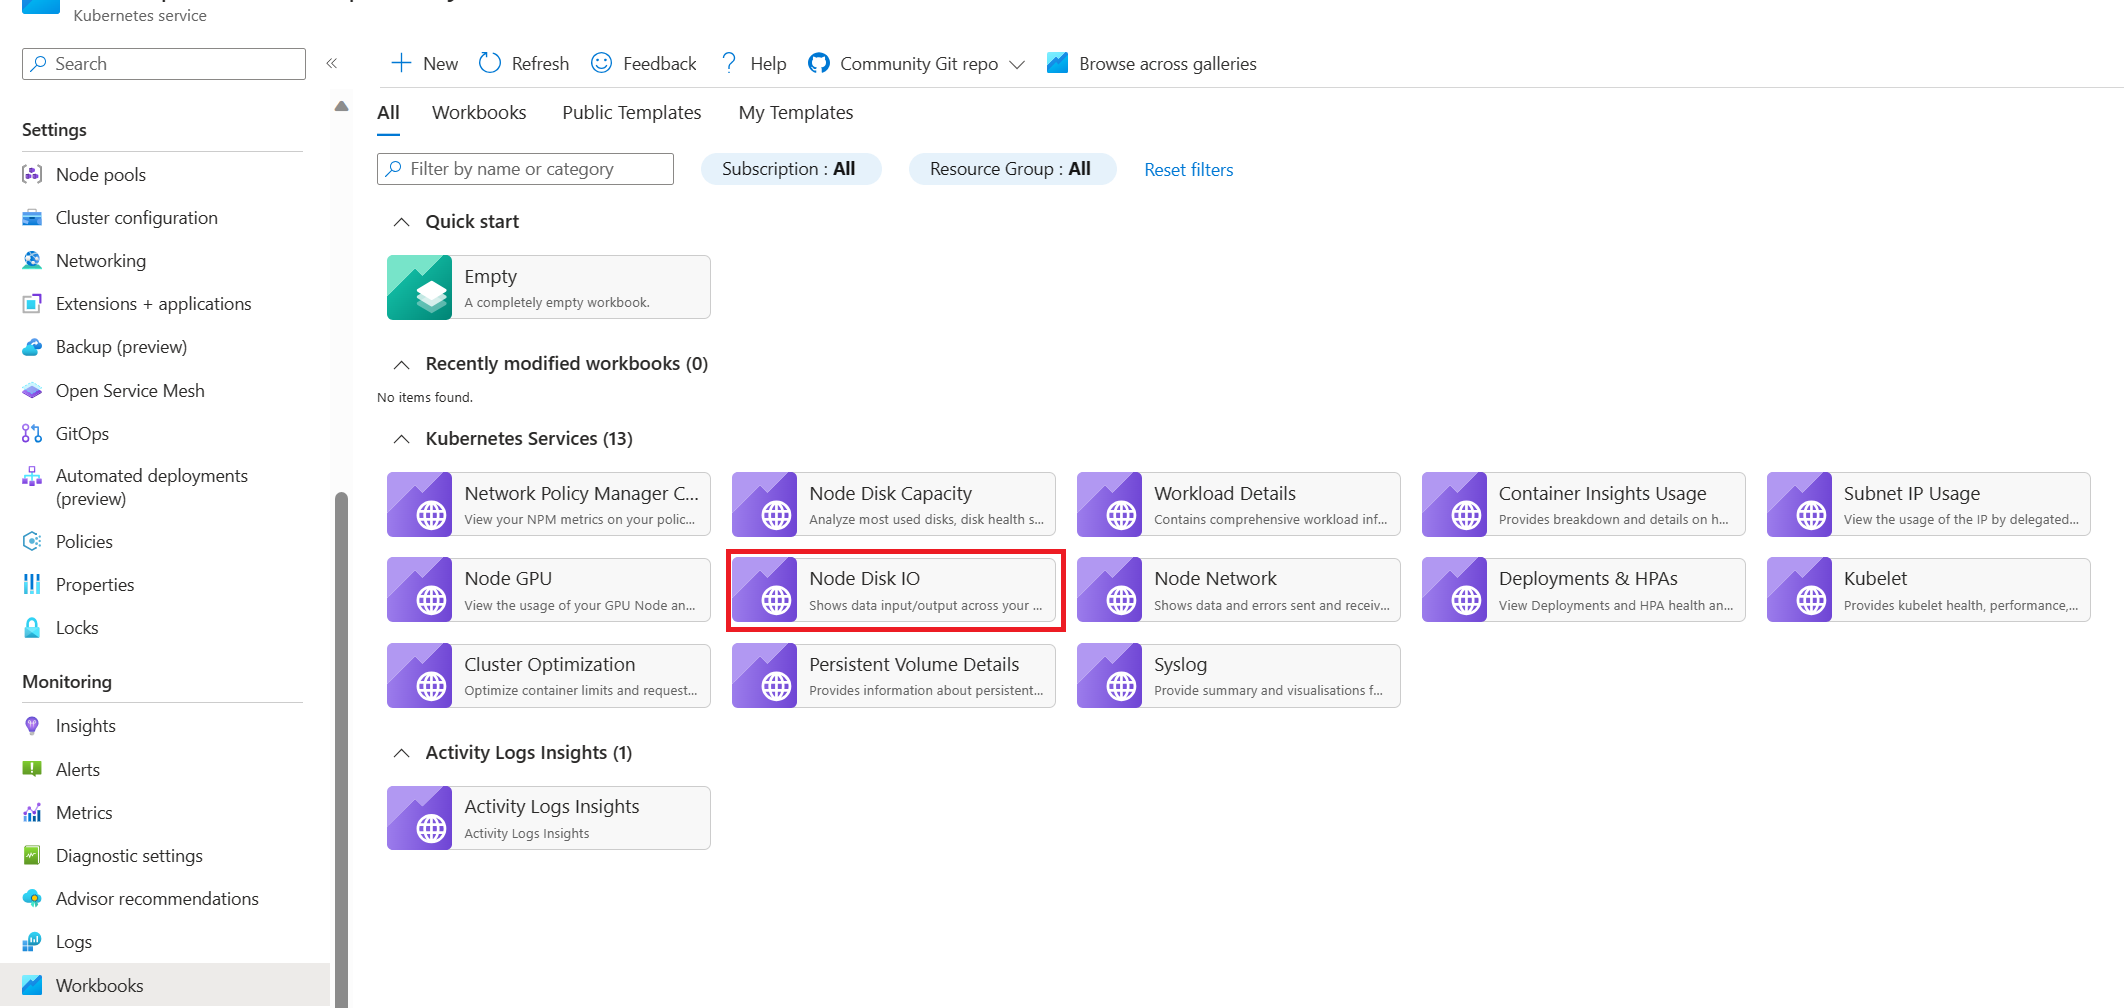
Para monitorar as métricas relacionadas à E/S de disco dos nós de trabalho no cluster AKS, você pode usar a pasta de trabalho de E/S do disco do nó . Siga estas etapas para acessar a pasta de trabalho:
Aceda ao cluster do AKS no portal do Azure.
Na seção Monitoramento do painel de navegação, selecione Pastas de trabalho.
Selecione o workbook Node Disk IO.
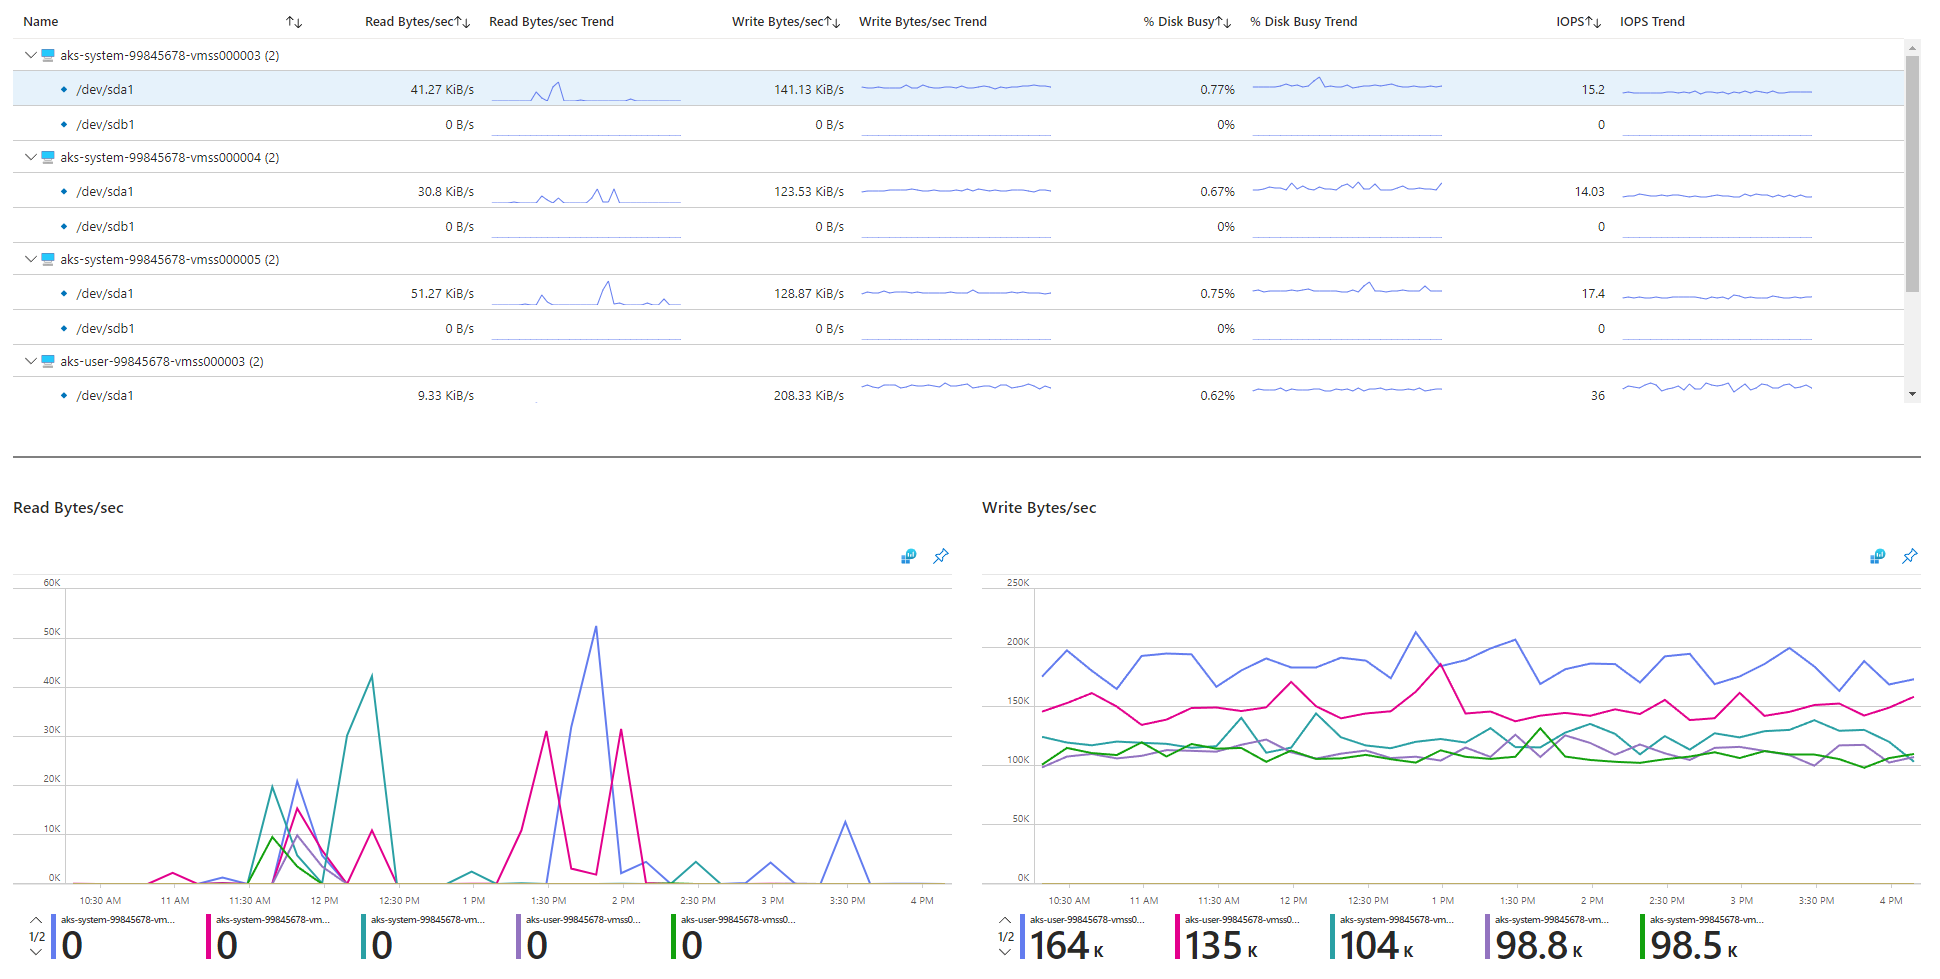
Analise as métricas relacionadas a E/S.


Monitorização em cluster com Prometheus e Grafana
Se implementaste o Prometheus e o Grafana no teu cluster AKS, podes usar o dashboard USE Method / Node para obter informações sobre a E/S do disco dos nós de trabalho do cluster.

Serviço gerido do Azure Monitor para Prometheus e Azure Managed Grafana
Você pode usar o painel pré-construído Node Exporter / Nodes para visualizar e analisar métricas relacionadas à E/S de disco dos nós de trabalho. Para isso, configure o seu cluster AKS para recolher métricas Prometheus no serviço gerido Azure Monitor para Prometheus e ligue o seu espaço de trabalho Azure Monitor a um Azure Managed Grafana.

IOPS e discos do Azure
Os dispositivos de armazenamento físico têm limitações inerentes em termos de largura de banda e do número máximo de operações de arquivo que podem manipular. Os discos do Azure são usados para armazenar o sistema operacional executado em nós AKS. Os discos estão sujeitos às mesmas restrições de armazenamento físico que o sistema operacional.
Considere o conceito de taxa de transferência. Você pode multiplicar o tamanho médio de E/S pelas IOPS para determinar a taxa de transferência em megabytes por segundo (MBps). Tamanhos de E/S maiores se traduzem em IOPS mais baixas devido à taxa de transferência fixa do disco.
Quando uma carga de trabalho ultrapassa os limites máximos de serviço IOPS atribuídos aos discos do Azure, o cluster pode deixar de responder e entrar em um estado de espera de E/S. Em sistemas baseados em Linux, muitos componentes são tratados como ficheiros, como sockets de rede, CNI, o tempo de execução do contentor e outros serviços que dependem de I/O de rede. Consequentemente, se o disco não puder ser lido, a falha se estende a todos esses arquivos.
Vários eventos e cenários podem provocar a limitação de IOPS, incluindo:
Um número substancial de contentores que são executados nos nós, porque as operações de E/S do runtime do contentor partilham o disco do sistema operativo.
Ferramentas personalizadas ou não Microsoft que são usadas para segurança, monitorização e registo, que podem gerar operações adicionais de I/O no disco do sistema operativo.
Eventos de transferência em caso de falha de nó e trabalhos periódicos que intensificam a carga de trabalho ou dimensionam o número de instâncias. Este aumento da carga aumenta a probabilidade de ocorrências de limitação, podendo fazer com que todos os nós transitem para um estado não pronto até que as operações de E/S terminem.
Contribuidores
A Microsoft mantém este artigo. Os seguintes colaboradores escreveram este artigo.
Principais autores:
- Paolo Salvatori | Engenheiro Principal de Clientes
- Francis Simy Nazareth | Especialista Técnico Sénior
Outros contribuidores:
- Sam Cogan | Arquiteto Sénior de Soluções Cloud
Para ver perfis não públicos do LinkedIn, faça login no LinkedIn.