Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Azure NetApp Files
Microsoft Fabric
Pesquisa de IA do Azure
Microsoft Foundry
Azure Machine Learning
Ideias de soluções
Este artigo descreve uma ideia de solução. O seu arquiteto de nuvem pode usar estas diretrizes para ajudar a visualizar os componentes principais de uma implementação típica desta arquitetura. Use este artigo como ponto de partida para conceber uma solução bem arquitetada que se alinhe com os requisitos específicos da sua carga de trabalho.
Esta ideia de solução descreve como a API Azure NetApp Files Object REST ajuda as organizações a utilizar dados de ficheiros empresariais existentes para análise e IA sem antes de os copiar para um object store separado. As aplicações compatíveis com Amazon S3 podem suportar pesquisa de documentos e análise assistida por IA, enquanto os fluxos de trabalho existentes de NFS e SMB continuam a aceder a esses dados. Evitar uma cópia separada dos dados de origem pode reduzir o tempo para integrar cargas de trabalho analíticas, reduzir custos de armazenamento duplicado e eliminar os pipelines de sincronização que as equipas normalmente construiriam, monitorizariam, diagnosticariam e resolveriam problemas. Menos repositórios de dados de origem também significam menos cópias para governar e proteger. Esta abordagem suporta a modernização incremental sem exigir que as organizações substituam as suas aplicações baseadas em ficheiros existentes.
Architecture
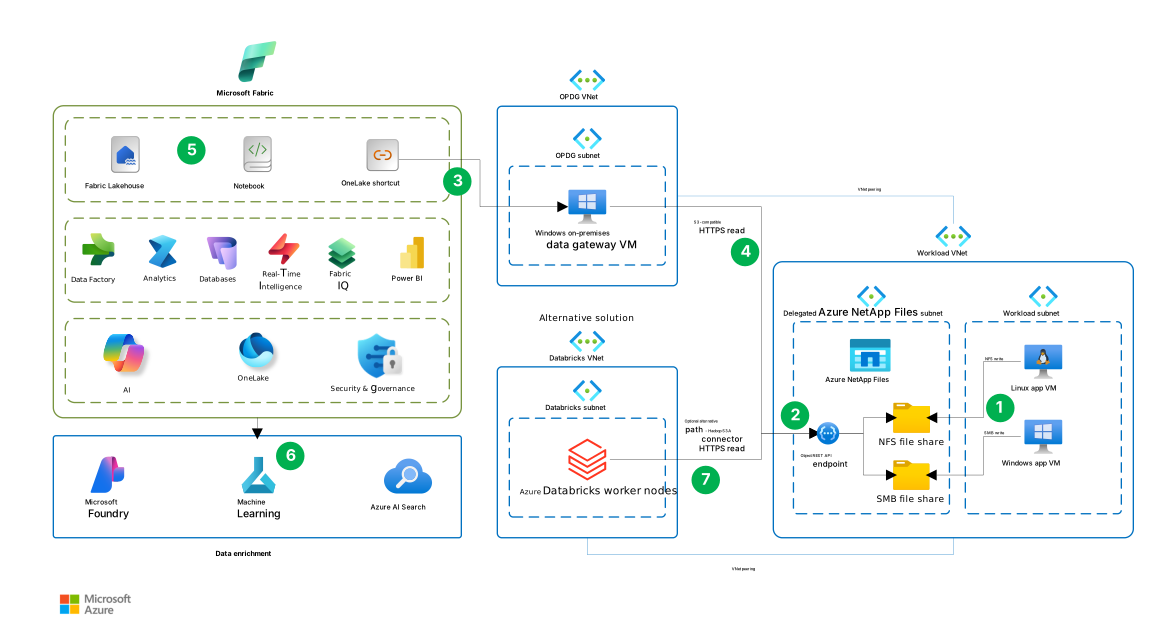
Esta arquitetura foca-se na integração do Microsoft Fabric com o Azure NetApp Files através da API Object REST. O diagrama também mostra o Azure Databricks como um consumidor analítico alternativo dos mesmos dados do Azure NetApp Files. Não precisa de instalar ambas as plataformas. As aplicações existentes continuam a aceder aos dados através do NFS ou SMB, dependendo da configuração do volume e dos requisitos do cliente.
O Azure Databricks compute acede ao endpoint Azure NetApp Files Object REST API através de pedidos compatíveis com S3, utilizando o conector Hadoop S3A. Este caminho alternativo de análise não utiliza o gateway de dados local nem o Microsoft OneLake.
Os serviços de IA a jusante no diagrama são ilustrativos. A respetiva integração de ingestão de dados não é mostrada.
Descarregue um ficheiro Visio desta arquitetura.
Fluxo de dados
As interações numeradas seguintes descrevem o diagrama de arquitetura. Os passos 1 a 5 descrevem o caminho principal do Microsoft Fabric. O Passo 6 representa o enriquecimento opcional posterior dos dados. O Passo 7 é um percurso alternativo de analytics, não uma continuação do fluxo Fabric. As setas rotuladas como HTTPS read mostram pedidos em direção ao endpoint da API REST do Objeto; os dados solicitados retornam ao consumidor.
As aplicações escrevem dados em ficheiros. Na sub-rede Workload, a VM da aplicação Linux escreve na partilha de ficheiros NFS, e a VM da aplicação Windows escreve na partilha de ficheiros SMB. O Azure NetApp Files aloja as duas partilhas na subrede delegada.
A API Object REST expõe os dados do ficheiro. O endpoint na sub-rede Delegated ANF fornece acesso compatível com S3 a diretórios configurados nos volumes Azure NetApp Files. As ligações do endpoint para as partilhas NFS e SMB representam o acesso aos dados existentes, não uma cópia para um armazenamento de objetos separado.
O Fabric acede aos dados através de um atalho do OneLake. O atalho faz referência aos dados do Azure NetApp Files através de uma ligação que utiliza a VM do gateway de dados local do Windows na sub-rede OPDG (on-premises data gateway). O atalho OneLake está ligado a este gateway.
O gateway lê a partir da API Object REST. O gateway utiliza o peering entre o VNet OPDG e o Workload VNet para chegar ao endpoint. O caminho de leitura HTTPS compatível com S3 liga o gateway ao endpoint, que acede aos dados do ficheiro referenciado para o Fabric. Para os requisitos de ligação, veja Conectar OneLake a um volume Azure NetApp Files.
Fabric processa e analisa os dados. As cargas de trabalho Fabric suportadas consomem os dados através do atalho. Por exemplo, os notebooks leem os ficheiros referenciados e escrevem resultados derivados em tabelas lakehouse para análise e relatórios do Power BI. A caixa Fabric no diagrama mostra estas capacidades de processamento e análise.
Serviços opcionais subsequentes enriquecem os dados. A seta abaixo do Fabric leva ao grupo de enriquecimento de dados, que contém Microsoft Foundry, Azure Machine Learning e Pesquisa de IA do Azure. Esta etapa representa o processamento posterior opcional. O diagrama não mostra a ingestão nem a orquestração necessárias para interligar estes serviços, e o atalho do OneLake não estabelece essas integrações.
Alternativamente, o Azure Databricks lê diretamente os dados do ficheiro. Os nós worker na sub-rede Databricks utilizam o conector Hadoop S3A para enviar pedidos de leitura HTTPS para o mesmo ponto final da API REST de Objetos através das redes virtuais peered. Este caminho substitui o caminho de acesso e processamento do Fabric nos passos 3 a 5. Não passa pelo gateway de dados local nem pelo OneLake.
Escolha o local do atalho com base na forma como pretende utilizar os dados:
- Tabelas Delta compatíveis existentes. Crie um atalho de tabela na secção Tables do lakehouse, direcionado para a tabela Delta completa, incluindo o seu registo de transações. O Fabric reconhece o destino como uma tabela que pode ser consultada através do Spark e do ponto final de análise SQL, enquanto os dados de origem permanecem no Azure NetApp Files.
- Ficheiros para acesso direto ou processamento. Crie atalhos na secção Ficheiros do lakehouse. As cargas de trabalho compatíveis podem ler ficheiros Parquet, CSV e JSON independentes, além de documentos, sem primeiro copiar os ficheiros de origem para o OneLake. Quando a análise a jusante requer tabelas lakehouse, transforme ou carregue os dados de origem em tabelas Delta derivadas no OneLake.
Ficheiros Parquet independentes não são automaticamente tabelas Delta. Um atalho em Ficheiros não regista automaticamente o seu alvo como uma tabela. Para mais informações, veja Onde colocar atalhos num lakehouse.
Components
Os seguintes componentes suportam a arquitetura centrada no Fabric e a alternativa opcional do Azure Databricks.
Azure NetApp Files é um serviço de armazenamento de ficheiros totalmente gerido, baseado na tecnologia NetApp. Nesta arquitetura, esta armazena o conjunto de dados empresarial e fornece acesso via NFS, SMB e acesso a objetos compatível com S3 através da API REST de objetos. Também oferece capacidades de snapshots e replicação.
A Azure NetApp Files Object REST API expõe os dados de ficheiros já existentes através de uma interface compatível com S3. Nesta arquitetura, permite que aplicações de análise e IA compatíveis acedam aos dados sem primeiro criar uma cópia separada no armazenamento de objetos. A interface suporta um subconjunto das operações do Amazon S3. Confirme que as operações suportadas cumprem os requisitos da sua aplicação antes de escolher esta integração.
Microsoft Fabric é uma plataforma de analítica que unifica a movimentação de dados, o processamento de dados, a ingestão de dados, a transformação, o processamento de fluxos de dados com o Real-Time Intelligence e a criação de relatórios. Nesta arquitetura, fornece a plataforma de análise para processar e analisar dados do Azure NetApp Files através de atalhos OneLake.
O OneLake é o lago de dados lógico unificado para o Fabric. Nesta arquitetura, os atalhos OneLake tornam os dados referenciados do Azure NetApp Files disponíveis para cargas de trabalho Fabric suportadas.
O Rede Virtual do Azure fornece conectividade privada entre os recursos do Azure nesta arquitetura. O peering de rede virtual permite que a máquina virtual gateway e os recursos de computação opcionais do Azure Databricks acedam ao ponto final da API REST de Objetos do Azure NetApp Files.
Um gateway de dados on-premises liga os atalhos OneLake ao endpoint bucket do Azure NetApp Files. Apesar do nome, nesta arquitetura, o gateway funciona em modo padrão numa máquina virtual Azure com um sistema operativo Windows suportado. Escolha uma imagem que cumpra os requisitos de instalação do gateway. As instalações do Server Core e os contentores do Windows não são suportados. O gateway inicia ligações de saída através do Azure Relay para comunicar com o Fabric. Não são necessárias ligações de entrada do Fabric. Configure o seu firewall ou proxy para permitir os endpoints de saída descritos em Ajustar as definições de comunicação para o gateway de dados local.
Azure Databricks é uma plataforma alternativa de análise opcional para cargas de trabalho em engenharia de dados e aprendizagem automática. Os seus jobs Spark utilizam o conector Hadoop S3A configurado para o endpoint da API REST do Object, para aceder ao conjunto de dados Azure NetApp Files em vez de usar o caminho de integração Fabric.
Alternatives
Essa arquitetura inclui vários componentes que você pode substituir por outros serviços ou abordagens do Azure, dependendo dos requisitos funcionais e não funcionais da sua carga de trabalho. Considere as seguintes alternativas e as suas desvantagens.
Armazenamento
Considere os requisitos do protocolo das aplicações e o desempenho medido ao escolher entre Armazenamento de Blobs do Azure e Azure NetApp Files:
Escolha Armazenamento de Blobs quando os clientes puderem usar a API REST do Armazenamento de Blobs ou o NFS 3.0 e não precisarem de SMB ou NFS 4.1. Ambas as interfaces podem aceder aos mesmos dados. O caminho de acesso NFS 3.0 do Armazenamento de Blobs está otimizado para cargas de trabalho sequenciais de alta taxa de transferência e muita leitura, onde a taxa de transferência importa mais do que a baixa latência.
Escolha Azure NetApp Files quando aplicações e cargas de trabalho analíticas precisarem de aceder aos mesmos ficheiros através do SMB ou NFS 4.1 e da API Object REST compatível com S3, ou quando aplicações de ficheiros requerem E/S aleatória de baixa latência. Para dados já disponíveis no Azure NetApp Files, a API Object REST adiciona acesso à análise sem migrar aplicações ou dados de origem.
Para qualquer uma das opções, meça a latência de ponta a ponta e o débito sob carga concorrente da aplicação de origem e de analítica. O desempenho do NFS ou SMB não determina o desempenho da API REST de Objetos nem o desempenho do Fabric, por isso teste o caminho de acesso pretendido face aos requisitos da carga de trabalho. Compare os custos totais, incluindo alterações de aplicação, migração e qualquer duplicação e sincronização contínuas. Para uma comparação de protocolo e carga de trabalho, consulte Comparar serviços de armazenamento Azure.
Integration
Os jobs do Azure Databricks podem usar o conector Hadoop S3A para ler dados do Azure NetApp Files através da API Object REST, sem OneLake ou o gateway de dados local. Configure a confiança TLS e as credenciais armazenadas de forma segura, e valide as operações de escrita necessárias antes de recorrer ao write-back. Se precisares de scripts de inicialização, usa scripts com alcance de cluster armazenados em volumes do Unity Catalog em computação suportada, seguindo as orientações atuais do Azure Databricks para o init-script.
Detalhes do cenário
Use este padrão quando o mesmo conjunto de dados tiver de servir aplicações que esperam um sistema de ficheiros montado e serviços de análise ou IA que esperam uma interface de objetos compatível com S3.
Aplicações a correr em máquinas virtuais ou em contentores podem continuar a usar o Azure NetApp Files através de NFS ou SMB. Por exemplo, podem usar código de acesso a ficheiros existente, partilhas montadas e estruturas de diretórios. A API REST do Azure NetApp Files Object mapeia o diretório raiz ou um subdiretório de um volume para um bucket compatível com S3, para que os clientes de objetos compatíveis possam aceder aos mesmos ficheiros subjacentes.
Esta abordagem é útil quando se pretende adicionar capacidades de análise ou IA a cargas de trabalho baseadas em ficheiros existentes sem alterar as aplicações de origem para usar armazenamento de objetos. Fluxos de trabalho a jusante ainda podem criar dados derivados, como conjuntos de dados transformados, índices, embeddings e caches, conforme necessário.
Quando clientes de ficheiros e objetos acedem aos mesmos dados, tenha em conta diferenças de identidade, permissões, bloqueio e requisitos de consistência da aplicação. Defina como os produtores sinalizam que um ficheiro ou lote está completo antes de os consumidores do objeto o processarem. Os produtores devem terminar de escrever e fechar os ficheiros antes de sinalizar prontidão e deixar esses ficheiros inalterados enquanto os consumidores os processam. Teste esta passagem para escritas interrompidas e repetições de processamento.
Os modelos de identidade e autorização também diferem entre métodos de acesso. As permissões originais de ficheiro por utilizador não são automaticamente transferidas para o Fabric. Configurar permissões Fabric para os consumidores pretendidos e garantir que a identidade usada pela Object REST API tem acesso apenas aos dados de origem necessários. Para obter mais informações, consulte Security.
Mapeie os diretórios para buckets separados quando os consumidores necessitam de diferentes níveis de acesso. A classificação dos dados, retenção, autorização a jusante e governação dos dados derivados continuam a ser da responsabilidade da carga de trabalho. Para mais informações, veja Criar um bucket.
Potenciais casos de utilização
Esta arquitetura pode suportar cargas de trabalho que precisam de analisar dados estruturados ou não estruturados já armazenados no Azure NetApp Files. Os exemplos seguintes ilustram diferentes formas como o Fabric pode consumir esses dados.
Processamento de documentos
As aplicações podem guardar documentos, imagens ou outros ficheiros não estruturados no Azure NetApp Files usando NFS ou SMB. Um notebook do Fabric pode ler ficheiros concluídos usando um atalho do OneLake e enviar o seu conteúdo para um serviço de processamento de documentos, como o Azure Document Intelligence, para extração. Armazene os dados estruturados resultantes em tabelas lakehouse para validação, análise e reporte.
Para orientações sobre integração, consulte Document Intelligence integration through SynapseML.
Análise de dados
As aplicações podem escrever dados estruturados, como ficheiros CSV ou Parquet, numa partilha Azure NetApp Files. Os cadernos do Fabric podem ler ficheiros finalizados usando o atalho do OneLake, combiná-los com outros dados do lakehouse e escrever resultados derivados em tabelas do lakehouse.
Este padrão pode suportar cenários como análise de engenharia e qualidade, análise de dados de sensores e relatórios operacionais sem exigir que as aplicações de origem alterem a forma como armazenam os seus ficheiros.
Para conjuntos de dados Delta compatíveis existentes, crie um atalho OneLake na secção Tables do lakehouse que tenha como alvo a tabela Delta completa, incluindo o seu registo de transações. O Fabric pode então reconhecer o destino como uma tabela, e os dados de origem podem permanecer no Azure NetApp Files. Para mais informações, veja Onde colocar atalhos num lakehouse.
Pesquisa e recuperação por IA
Documentos armazenados no Azure NetApp Files também podem servir como conteúdo fonte para cargas de trabalho de IA. Por exemplo, um fluxo de trabalho de processamento pode ler documentos através do atalho OneLake e usá-los para construir um índice Pesquisa de IA do Azure para geração aumentada por recuperação (RAG).
O índice de pesquisa e quaisquer embeddings são dados derivados e são armazenados separadamente dos ficheiros de origem. Desenhe o fluxo de trabalho para manter o conteúdo indexado sincronizado com atualizações da origem, renomeações e eliminações. Aplique também os controlos de acesso adequados ao recuperar conteúdo indexado, porque as permissões originais SMB e NFS não se tornam automaticamente permissões de pesquisa por utilizador.
O mesmo padrão pode ser estendido a outras cargas de trabalho de IA. Por exemplo, os notebooks Fabric podem preparar conjuntos de dados a partir de ficheiros fonte e armazenar os dados preparados no OneLake para consumo pelo Azure Machine Learning. Para opções de integração e limitações, veja Integrar OneLake com Azure Machine Learning.
Considerations
Essas considerações implementam os pilares do Azure Well-Architected Framework, que é um conjunto de princípios orientadores que você pode usar para melhorar a qualidade de uma carga de trabalho. Para obter mais informações, consulte Well-Architected Framework. Para orientações adicionais, consulte recomendações da Well-Architected Framework para Azure NetApp Files.
Reliability
A confiabilidade ajuda a garantir que seu aplicativo possa cumprir os compromissos que você assume com seus clientes. Para obter mais informações, consulte Lista de verificação de revisão de design para confiabilidade.
O Azure NetApp Files corre numa frota bare-metal tolerante a falhas alimentada por ONTAP e fornece um SLA de alta disponibilidade. Para proteção adicional contra interrupções de zona de disponibilidade ou regionais, pode opcionalmente configurar replicação entre zonas ou regiões diferentes. Esta replicação é assíncrona e requer um failover iniciado pelo cliente para o volume de destino. Escolha a opção de replicação e agende de acordo com os objetivos de recuperação da sua carga de trabalho. Para mais informações, consulte Azure NetApp Files Reliability.
Partilhar um único conjunto de dados também torna a disponibilidade de armazenamento uma dependência comum para aplicações de acesso a ficheiros e análises. Estas capacidades de armazenamento não estabelecem a disponibilidade de ponta a ponta para o gateway, pipeline de indexação ou aplicações consumidoras. Alinhar os objetivos de recuperação com toda a carga de trabalho, incluindo o gateway, processamento a jusante e dados derivados.
Uma única máquina virtual gateway é um ponto único de falha para o caminho de integração do Fabric. Para cargas de trabalho críticas para o negócio, implemente pelo menos dois membros de gateway em máquinas virtuais separadas num cluster de gateway. Garantir que todos os membros conseguem aceder ao endpoint da Object REST API e estabelecer as ligações de saída necessárias. Teste o comportamento da carga de trabalho quando um membro do gateway fica indisponível.
- A recuperação de ficheiros e volumes é suportada através de instantâneos eficientes em termos de espaço, de um determinado momento. Teams podem restaurar um ficheiro individual, reverter um volume completo ou criar um novo volume a partir de um ponto de recuperação após eliminação acidental, corrupção ou um processo de análise falhado. Para as operações de recuperação disponíveis, consulte proteção de dados baseada em snapshots do Azure NetApp Files.
Segurança
A segurança fornece garantias contra ataques deliberados e o uso indevido de seus valiosos dados e sistemas. Para obter mais informações, consulte Lista de verificação para revisão de design de segurança.
Manter menos cópias de dados de origem pode reduzir o número de repositórios a proteger. O Azure NetApp Files encripta os dados em repouso, e a API REST de Objetos utiliza TLS para proteger os dados em trânsito. As permissões de acesso a ficheiros dependem do protocolo:
Os clientes SMB e NFS continuam a utilizar os seus modelos existentes de autenticação e autorização. As listas de controlo de acesso (ACLs) NTFS existentes, as permissões NFS e as regras de mapeamento de identidades mantêm-se em vigor para esses clientes.
Os clientes da API REST de objetos autenticam-se usando uma chave de acesso S3. As permissões bucket definem se o cliente tem acesso apenas de leitura ou de leitura-escrita dentro do diretório mapeado. Os pedidos de objetos não incluem a identidade do utilizador SMB, NFS ou downstream individual. O Azure NetApp Files executa todas as operações de objeto como a identidade do sistema de ficheiros configurada e personificada do bucket. As permissões de ficheiros existentes e as ACLs são avaliadas apenas em relação a essa identidade.
A identidade do sistema de ficheiros representada é um ID de utilizador (UID) e um ID de grupo (GID) para volumes NFS, ou uma conta de utilizador para volumes SMB. Volumes de protocolo duplo utilizam o tipo de identidade que corresponde ao seu estilo de segurança configurado. Esta identidade determina as permissões de acesso a ficheiros. A chave de acesso do S3 autentica o cliente de objetos. Para mais informações, consulte Segurança e permissões da API REST do Objeto.
Um atalho compatível com OneLake S3 autentica-se ao bucket usando um ID de chave de acesso e uma chave de acesso secreta. As ACLs NTFS de origem, permissões NFS e identidades individuais dos proprietários de ficheiros não são copiadas nem mapeadas para o OneLake. Os utilizadores do Fabric são autorizados através das permissões do OneLake e do Fabric. Eles só podem aceder ao conteúdo disponibilizado através do atalho por meio do bucket e da identidade por ele representada, mas o OneLake não impõe as permissões originais por utilizador ao nível do ficheiro. OAuth, principais de serviço e RoleArn baseados no Microsoft Entra não são suportados para este tipo de atalho.
Por exemplo, um utilizador do Fabric poderá conseguir ler um documento através do atalho, mesmo quando a sua conta SMB pessoal não o consegue ler diretamente, se as permissões do Fabric permitirem o acesso e a identidade representada do bucket puder ler o documento. Antes de expor um diretório, verifique se o público pretendido da Fabric está autorizado a aceder ao seu conteúdo.
Configure a identidade imitada do bucket apenas com as permissões de origem que a carga de trabalho exige. Restringir o acesso ao atalho e ao lakehouse. Utilize o fluxo de trabalho de certificados e o armazenamento de credenciais baseados em Azure Key Vault para gerir certificados TLS e chaves de acesso S3. Definir e testar um procedimento de rotação que coordene alterações de certificados e credenciais com atualizações às ligações Fabric e outros consumidores. Gerar novas credenciais de bucket invalida imediatamente o par existente, por isso planeie interrupções enquanto atualiza os consumidores e verifica o acesso após a rotação.
Se usar um certificado TLS autoassinado, certifique-se de que cada host do gateway confia nesse certificado. Para mais informações, consulte pré-requisitos do gateway OneLake.
A segurança e a conformidade dependem da configuração do armazenamento, do acesso e dos serviços subsequentes. Inclua o processamento a jusante e dados derivados no seu âmbito de governação e conformidade. Requisitos como o RGPD e a HIPAA aplicam-se a toda a carga de trabalho, quando aplicável. Para mais informações, consulte Segurança e permissões da API REST de Objetos e Criar um atalho compatível com Amazon S3 no OneLake.
Otimização de Custos
A Otimização de Custos concentra-se em formas de reduzir despesas desnecessárias e melhorar a eficiência operacional. Para obter mais informações, consulte Lista de verificação de revisão de projeto para Otimização de custos.
Evitar uma cópia separada dos dados de origem pode reduzir os custos de armazenamento duplicado e de sincronização. Compare estas poupanças com os custos de capacidade e desempenho do Azure NetApp Files, da capacidade de computação do gateway, da capacidade do Fabric e do processamento e armazenamento subsequentes.
Esta estimativa de preços de exemplo inclui um conjunto de capacidade Azure NetApp Files Standard de 1 TiB, uma máquina virtual Windows D8s_v5 para o gateway de dados no local, dois discos geridos P10 de 128 GiB, um gateway NAT com um endereço IP público e processamento de dados de saída, capacidade Fabric F2 e 100 GB de armazenamento nativo do OneLake.
A configuração de gateway único não é de alta disponibilidade. Custos opcionais de pesquisa por IA, serviços de embedding e Azure Databricks são excluídos. Ajuste os recursos aos requisitos de capacidade, rede e disponibilidade da sua carga de trabalho.
Acesso esporádico: Organize os blocos de dados inativos por níveis, incluindo dados de instantâneo, para armazenamento de menor custo, mantendo o acesso a ficheiros e objetos. Avalie as cobranças de recuperação, a latência e as alterações específicas da taxa de transferência ao nível do serviço em relação ao padrão de acesso da carga de trabalho.
Níveis de serviço e redimensionamento: Escolha um nível de serviço Azure NetApp Files que corresponda à capacidade e aos requisitos de rendimento do conjunto de dados. O nível de serviço Flexível permite-lhe aprovisionar a capacidade e o débito processado do pool de forma independente. Reveja a capacidade e a taxa de processamento do conjunto faturável à medida que a procura varia, para evitar o sobredimensionamento persistente.
Excelência Operacional
A Excelência Operacional abrange os processos operacionais que implantam um aplicativo e o mantêm em execução na produção. Para obter mais informações, consulte Lista de verificação de revisão de design para excelência operacional.
Os atalhos OneLake reduzem a complexidade operacional ao evitar um pipeline que mantém uma cópia separada dos dados fonte para análise. Sem um pipeline de cópias separado, as equipas não precisam de agendar trabalhos de cópia, recuperar de falhas de transferência ou conciliar dados de origem e copiados como parte das operações rotineiras.
As equipas de aplicação de origem e de análise devem coordenar alterações e respostas a incidentes para o conjunto de dados partilhado Azure NetApp Files. Definir a atribuição de responsabilidades pela monitorização, falhas de processamento e gestão de credenciais e certificados da API REST Object.
Monitorize o armazenamento, gateway e desempenho do Fabric para identificar restrições e ajustar a capacidade ou o rendimento:
Use o Azure Monitor para acompanhar o débito de leitura e escrita em volume, IOPS de leitura e escrita, outros IOPS, latência média de leitura e escrita, consumo de capacidade e o indicador de limite de débito atingido. Alerta sobre aumentos sustentados de latência, limitações repetidas de QoS e limiares de capacidade em vez de picos isolados; As métricas do Azure NetApp Files são agregadas ao longo de intervalos e a latência de armazenamento não inclui todos os componentes REST do lado do cliente.
Correlacione métricas de armazenamento com medições do lado do cliente, como percentis de latência de pedidos, tamanho do objeto, concorrência, tentativas, códigos de estado HTTP, CPU, memória e throughput da rede. Ao fazê-lo, distingue-se um limite de débito de volume de um cliente de computação subdimensionado, definições ineficientes do SDK, sobrecarga de objetos pequenos ou distância de rede.
Monitorize a CPU, a memória, o espaço disponível em disco e o débito de rede de cada máquina virtual de gateway, juntamente com os erros do gateway e os tempos de conclusão da carga de trabalho. Configure alertas para situações de pressão sustentada sobre os recursos e pouco espaço em disco, com base nos limiares estabelecidos durante testes representativos de carga de trabalho. Utilize registos de diagnóstico do gateway ao resolver erros ou acessos lentos. Monitorize a máquina virtual e a rede em separado, porque os diagnósticos do gateway não fornecem cobertura completa da infraestrutura.
Monitorize a utilização da capacidade do Fabric e a limitação com a aplicação Fabric Capacity Metrics. Configure as notificações de utilização de capacidade para os administradores responsáveis. Correlacione o uso de capacidade com medições de gateway e armazenamento para identificar se os atrasos se originam no acesso à fonte ou no processamento Fabric antes de alterar a capacidade.
Eficiência de desempenho
A Eficiência de Desempenho refere-se à capacidade da sua carga de trabalho de escalar para atender às demandas dos usuários de forma eficiente. Para obter mais informações, consulte Lista de verificação de revisão de projeto para eficiência de desempenho.
O Azure NetApp Files pode suportar tanto aplicações NFS ou SMB sensíveis à latência como consumidores de analytics ou IA compatíveis com S3 que utilizam o mesmo conjunto de dados. Manter os dados de origem num único volume pode eliminar a etapa de cópia que, de outra forma, atrasaria a indexação, o treino ou o processamento em lote e consumiria largura de banda do cliente, da rede e do sistema de armazenamento de destino.
A latência de armazenamento sub-milissegundos nos níveis de serviço suportados do Azure NetApp Files é mais diretamente relevante para cargas de trabalho NFS e SMB. Não garante latência de ponta a ponta para pedidos da HTTPS Object REST API. Teste o desempenho do caminho de acesso compatível com S3 com objetos representativos e níveis de concorrência representativos antes de definir uma meta de latência.
Dimensionamento de armazenamento: Taxa de processamento de tamanho para a procura combinada de aplicações de ficheiros e consumidores de objetos. A QoS automática liga o débito de volume à quota de volume. O QoS manual permite uma alocação separada dentro do orçamento de débito do pool. Avalie as cargas de trabalho representativas antes de ajustar o desempenho.
Dimensionamento do gateway: Dimensione as máquinas virtuais do gateway para a procura combinada de cargas de trabalho que acedam ao Azure NetApp Files através dos atalhos OneLake. Utilize as orientações de dimensionamento e expansão do gateway como ponto de partida. Valide o dimensionamento com volumes de dados representativos e acesso concorrente por meio dos atalhos. Meça o throughput do CPU, memória e rede do gateway, juntamente com os tempos de conclusão da carga de trabalho, para determinar se deve aumentar os recursos da máquina virtual ou adicionar membros do gateway.
Dimensionamento da capacidade do Fabric: Dimensione a capacidade do Fabric para a carga de trabalho combinada de processamento e relatórios, incluindo o Power BI. Siga as orientações do guia de planeamento de capacidade do Fabric para estimar a capacidade inicial, faça testes com um projeto-piloto representativo e ajuste a capacidade com base na utilização medida e no estrangulamento observado.
Coloque o cálculo próximo do volume, dimensione adequadamente a rede do cliente e teste com a carga de trabalho real. Aumentar o paralelismo e usar pedidos suficientemente grandes para análises sequenciais, mas limitar a concorrência quando a latência ou os erros aumentam. Para NFS ou SMB, valide a montagem, o protocolo e as definições da aplicação. No caso de REST, verifique o suporte para as operações da API exigidas pelo cliente e teste a reutilização da ligação, o comportamento de carregamento, as novas tentativas e a listagem de objetos.
Validar o throughput e a latência de ponta a ponta sob carga simultânea, e equilibrar a procura analítica com os requisitos de desempenho da aplicação fonte.
Contributors
A Microsoft mantém este artigo. Os seguintes colaboradores escreveram este artigo.
Principais autores:
- Dan Jackson | Arquiteto de Soluções Cloud, NetApp
- Anthony Mashford | Arquiteto de Soluções de Nuvem, NetApp
- Daniel Söderholm | Engenheiro Sénior de Soluções, Plataformas Cloud + IA, Microsoft
Outros contribuidores:
- Heather Grandy | Engenheira Sénior de Soluções, Plataformas de Dados, Microsoft
Para ver perfis não públicos do LinkedIn, faça login no LinkedIn.
Passos seguintes
- Introdução à API REST de objetos para o Azure NetApp Files
- Conecte OneLake a um volume Azure NetApp Files
- Scripts de inicialização no Azure Databricks
- Integre o OneLake com Azure Machine Learning